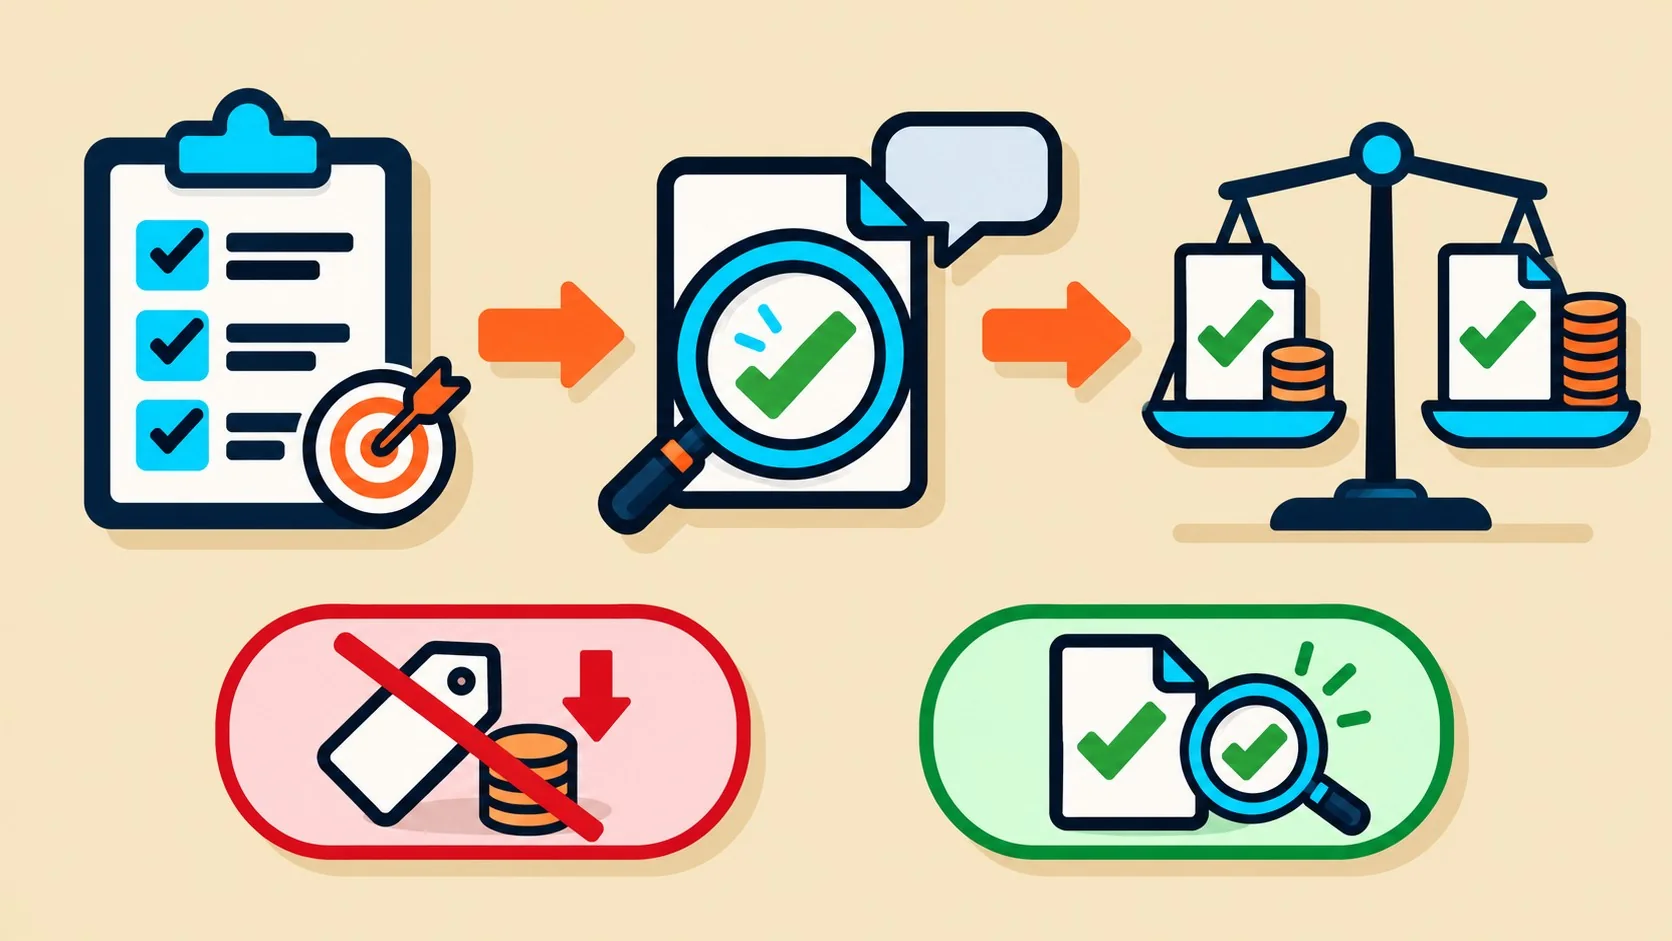
En pocas palabras: El modelo correcto se elige definiendo primero qué es una tarea completada (ejemplo: un reporte con el total exacto en USD), armando entre 20 y 50 casos de prueba basados en los requisitos reales, y midiendo el éxito del sistema completo —modelo, instrucciones y herramientas— antes de comparar el costo entre candidatos.
Elegir el modelo de IA correcto para tu app no depende del benchmark público más alto, sino de medir si la tarea se completa bien dentro del flujo real de tu producto. Primero éxito, después costo.
La evaluación de modelos de IA para aplicaciones es el proceso de definir qué significa una tarea completada con éxito, armar un conjunto de casos de prueba basados en los requisitos reales de la función, y medir cuántas veces el sistema completo (modelo, instrucciones, herramientas y código de la aplicación) llega a ese resultado antes de comparar precios entre candidatos.
En este artículo:
- En 30 segundos
- ¿Por qué elegir el modelo de IA más barato puede salirte caro?
- ¿Qué limitaciones tienen los benchmarks públicos como HELM?
- ¿Qué se evalúa realmente: el modelo o el agente completo?
- ¿Cómo se convierten los requisitos de una función en casos de evaluación medibles?
- ¿Qué tres métodos existen para calificar resultados antes de comparar costos?
- Errores comunes al elegir y evaluar un modelo de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Dos modelos pueden devolver el mismo mensaje de chat y generar archivos con datos distintos: en el ejemplo del artículo de referencia, un total salió en USD 360 y el otro en USD 370.
- Los benchmarks públicos como HELM de Stanford sirven para armar una lista corta de candidatos, no como prueba de aceptación final de una función.
- Lo que hay que evaluar es modelo más instrucciones más definiciones de herramientas más retrieval más código de la aplicación, según marca la guía de Anthropic sobre evaluación de agentes.
- Un dataset inicial de 20 a 50 casos revisados a mano alcanza para detectar problemas grandes, aunque no certifica que el sistema aguante producción.
- El paper MT-Bench documenta sesgos de posición, verbosidad y auto-mejora en jueces automáticos, por eso conviene calibrarlos con revisión humana antes de confiar en ellos.
¿Por qué elegir el modelo de IA más barato puede salirte caro?
Elegir el modelo con el token más barato sin medir el resultado final puede terminar costándote más en soporte, reclamos y confianza perdida que lo que ahorrás en la factura de API.
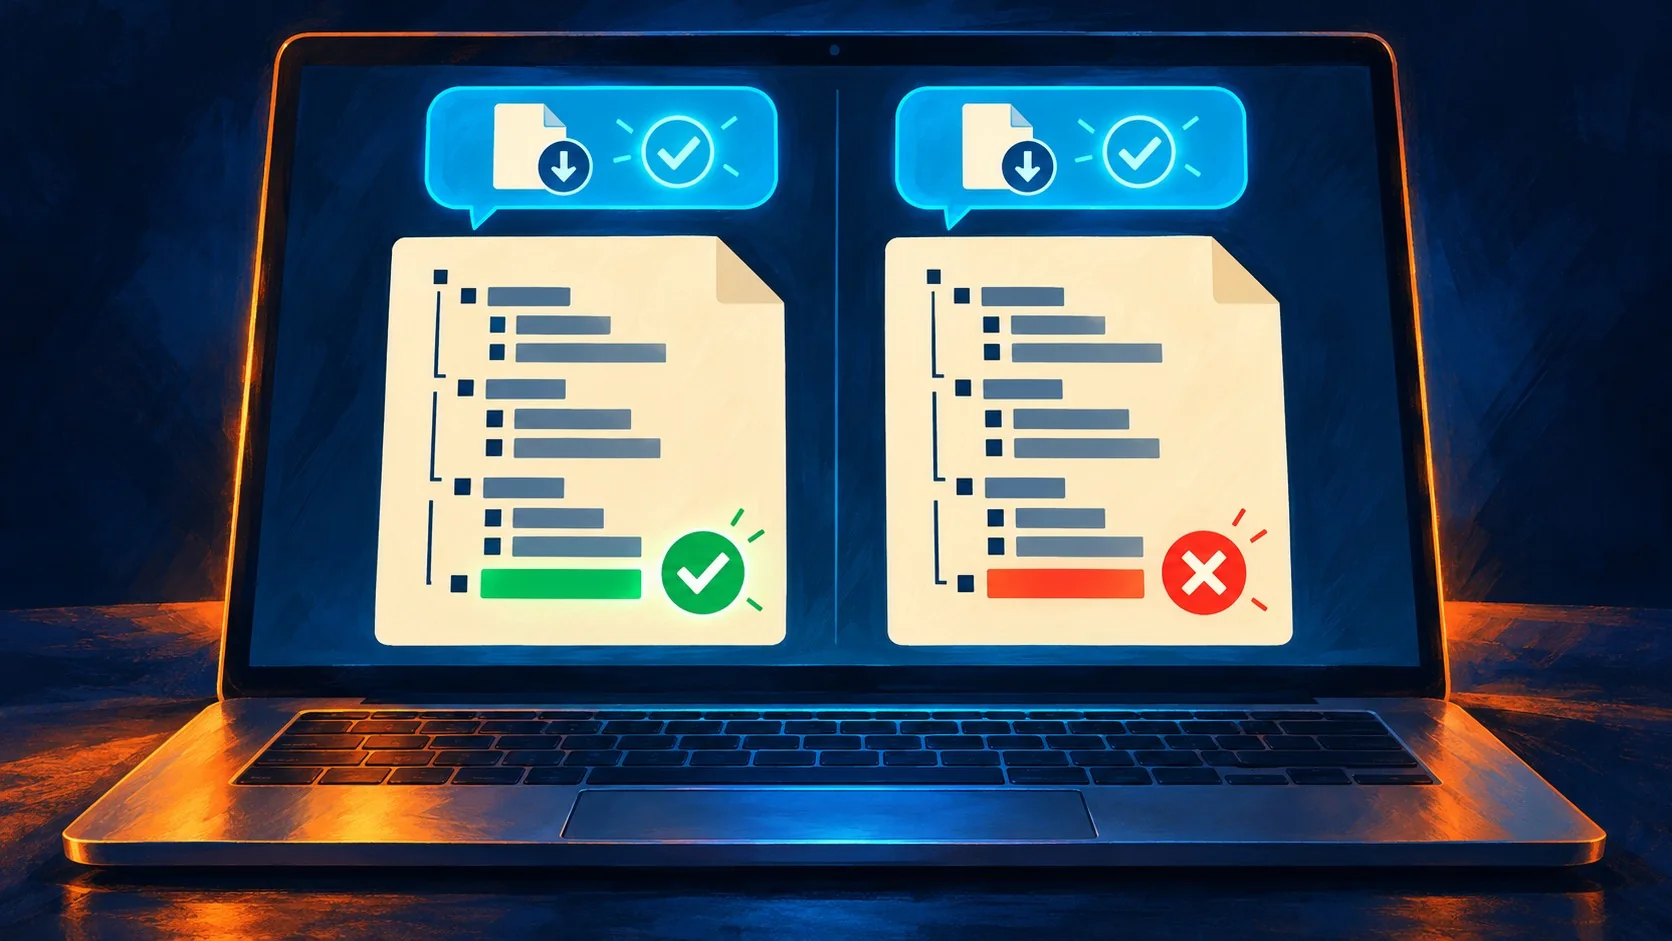
Ponele que armás un chat para que los usuarios pregunten por sus documentos y generen reportes descargables. Le pedís: “buscá mis gastos del primer trimestre en el storage conectado y armá un JSON descargable con un renglón por mes, en dólares, con el total”. Dos modelos te devuelven exactamente la misma frase de cierre, algo como “tu reporte está listo, aquí el link de descarga”. Los dos archivos abren bien. Los dos tienen los montos mensuales correctos. Pero uno suma USD 360 de total y el otro USD 370, según el ejemplo que describe el artículo original sobre selección de modelos.
Si solo comparás el mensaje de chat, el resultado es un empate. Si abrís el archivo, encontrás la falla real. Lo explicamos a fondo en comparar Claude Sonnet y Opus en detalle.
Ahí está el punto de partida para cómo elegir modelo de IA: definir qué pinta tiene una tarea completada, medir con qué frecuencia tu aplicación llega a eso, y recién ahí comparar cuánto cuesta lograrlo.
¿Qué limitaciones tienen los benchmarks públicos como HELM?
Los benchmarks públicos sirven para armar una lista corta de candidatos, no para certificar que un modelo funciona bien en tu aplicación específica. Un puntaje de conocimiento general no te dice si ese modelo elige la tool de storage correcta, se recupera de un link vencido y produce una planilla sin errores dentro del loop de tools de tu app.
HELM, el proyecto de Stanford, propone un enfoque multi-escenario y multi-métrica para evaluar modelos. La idea vale como principio general: mirar varias capacidades y sus trade-offs en vez de tratar un solo número como descripción completa de un modelo.
Para armar esa lista corta, conviene fijarse en cosas bien concretas: soporte de tool calling en el proveedor y SDK que usás, contexto suficiente para conversaciones largas con documentos recuperados, las modalidades de entrada que necesitás (si tus usuarios suben imágenes o PDFs escaneados), una opción de despliegue acorde a tus requisitos operativos, y precio y latencia plausibles para el tráfico esperado. Con esos filtros ya tenés dos o tres candidatos para probar en el flujo real, no veinte.
¿Qué se evalúa realmente: el modelo o el agente completo?
Lo que se evalúa nunca es el modelo solo: es el modelo más las instrucciones, las definiciones de herramientas, el retrieval y el código de tu aplicación trabajando juntos. Un modelo no tiene acceso nativo al storage de tus usuarios, eso lo da tu aplicación a través de tools. En entender cómo funcionan los modelos de lenguaje profundizamos sobre esto.
La guía de Anthropic sobre cómo escribir tools efectivas para agentes hace esta distinción explícita: una evaluación de agente mide al modelo y al harness que lo rodea trabajando como unidad. Generar un archivo puede significar llamar a un constructor de reportes determinístico, ejecutar código en un sandbox, o devolver datos estructurados que tu backend convierte en archivo. Son implementaciones distintas, con fallas y costos distintos.
¿Y si cambiás solo el modelo sin tocar el harness? Puede que el resultado cambie igual, para bien o para mal, porque el modelo nuevo interpreta las mismas instrucciones de otra forma. Por eso comparar modelos “en el vacío” dice poco: hay que probarlos dentro del mismo flujo de tools que va a correr en producción.
¿Cómo se convierten los requisitos de una función en casos de evaluación medibles?
Convertir requisitos en casos medibles arranca definiendo el éxito antes de correr ningún candidato, con criterios concretos que un script o una rúbrica puedan chequear, no con una sensación de “la respuesta suena bien”.
Para el ejemplo de los gastos trimestrales, el fixture tiene tres montos mensuales (enero USD 120, febrero USD 80, marzo USD 160) y un total esperado de USD 360. Esos números van en el dataset de evaluación, nunca en el prompt del candidato como respuesta regalada.
El dataset conviene armarlo con casos variados, no solo el camino feliz:
| Caso | Situación | Resultado esperado |
|---|---|---|
| Exportación normal | Un documento de gastos que coincide | Reporte correcto y descargable |
| Documento ambiguo | Dos archivos plausibles del trimestre | Preguntar cuál archivo usar |
| Trimestre faltante | El storage solo tiene datos del Q2 | Explicar que no se encontró el Q1, sin inventar |
| Falla del storage | La herramienta de lectura devuelve timeout | Reportar la falla, no afirmar que el export salió bien |
Vale testear también cuándo una tool no debería activarse. Un modelo que busca en la web cada vez que le preguntan algo puede dar bien en tareas de investigación mientras suma latencia y costo innecesarios en el resto. Relacionado: conocer qué puede hacer Sora.
Arrancar con 20 a 50 casos revisados a mano es un punto de partida razonable para encontrar problemas grandes, no una prueba de confiabilidad de producción. Conviene además separar dos grupos a medida que el dataset crece: los casos de desarrollo, que inspeccionás mientras ajustás prompts y tools, y los casos reservados, que usás solo para la comparación final sin tocarlos de nuevo.
¿Qué tres métodos existen para calificar resultados antes de comparar costos?
Hay tres formas de calificar un resultado y conviene combinarlas, no pedirle a una sola que haga todo el trabajo: código para hechos verificables, rúbrica para respuestas con varias formas válidas, y revisión humana para calibrar al juez automático.
El primer método usa código. Para una tarea de generación de archivos, hay que descargar el artefacto real por el camino que usa el usuario de prueba e inspeccionar su contenido. Un mensaje que dice “ya creé el archivo” no es evidencia de que el archivo exista. El grader del caso de gastos, armado en C#, deserializa el JSON descargado, valida que la moneda sea USD, que los meses y montos coincidan con el fixture y que el total sea correcto. Candidate A pasa, Candidate B falla porque el total da 370 en vez de 360 (spoiler: ese es justo el error que el mensaje de chat no delataba).
El segundo método usa una rúbrica, para preguntas con varias respuestas válidas. Pedirle al modelo que resuma una política de reembolsos en tres bullets y diga si una compra de hace 40 días califica no tiene una única respuesta textual correcta. Comparar strings exactos rechazaría paráfrasis perfectamente buenas. Lo que funciona es chequear la cantidad de bullets por código y calificar las afirmaciones de hecho contra el documento recuperado: ¿cada afirmación está respaldada por la fuente?, ¿la respuesta aplica la política al caso de los 40 días?, ¿identifica lo que falta en vez de inventar una decisión? Complementá con ver cómo se comparan en auditorías de código.
El tercer método calibra al juez automático con revisión humana. Un juez basado en LLM es otro componente falible. El paper Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena documenta sesgo de posición, sesgo de verbosidad, sesgo de auto-mejora y límites de razonamiento en estos jueces, aunque también muestra que jueces fuertes como GPT-4 llegan a más del 80% de acuerdo con preferencias humanas en los escenarios estudiados por los autores. Eso no significa que cualquier juez vaya a estar de acuerdo con tus usuarios en cualquier tarea: antes de confiar en uno, hay que hacer que gente del dominio etiquete una muestra y comparar con lo que dice el juez, prestando atención sobre todo a los casos donde el juez aprueba algo que un humano rechazaría.
Errores comunes al elegir y evaluar un modelo de IA
- Comparar solo el texto del chat. El mensaje final puede ser idéntico entre dos candidatos mientras el archivo, la base de datos o el efecto real de la tarea difiere.
- Usar el benchmark público como aceptación final. Un puntaje de conocimiento general no mide si el modelo usa bien las tools de tu aplicación específica.
- Exigir una secuencia exacta de tool calls. Si existen varios caminos legítimos para llegar al mismo resultado, conviene chequear el estado final y no una sola ruta imaginada de antemano.
- Confiar en el juez LLM sin calibrarlo. Sin una muestra revisada por humanos, un juez automático puede aprobar respuestas que un usuario real rechazaría, sobre todo por sesgo de verbosidad.
- Sobreajustar contra los mismos casos de testeo. Si siempre ajustás el prompt contra el mismo dataset, terminás optimizando para el examen y no para producción; de ahí la importancia de guardar casos reservados.
Preguntas Frecuentes
¿Cómo se elige el modelo de IA correcto para una aplicación?
Se elige definiendo primero qué significa una tarea completada con éxito dentro de tu flujo específico, armando una lista corta de candidatos con los benchmarks públicos y probándolos contra casos reales de tu aplicación. Recién con esos resultados en mano se compara el costo entre los que pasaron la evaluación.
¿Por qué no alcanza con los benchmarks públicos para elegir un modelo?
No alcanzan porque miden conocimiento general o capacidades aisladas, no cómo un modelo se comporta con tus tools, tu retrieval y tu código específico. Sirven para armar una lista corta de candidatos, no como test de aceptación final de una función.
¿Cómo se mide si una tarea de IA fue exitosa?
Se mide con una combinación de código que verifica hechos concretos (como el contenido real de un archivo descargado), rúbricas para respuestas con varias formas válidas, y revisión humana que calibra al juez automático. Un mensaje de chat correcto no es evidencia suficiente si no se inspecciona el resultado real de la tarea.
¿Qué diferencia hay entre evaluar el modelo y evaluar el agente completo?
Evaluar el modelo solo mide su conocimiento o razonamiento aislado. Evaluar el agente completo mide el modelo junto con las instrucciones, las definiciones de herramientas, el retrieval y el código de la aplicación trabajando como un sistema único, que es lo que realmente determina si una tarea se completa bien en producción.
¿Cómo comparar el costo entre modelos de IA que tienen resultados similares?
Se compara recién después de confirmar que ambos modelos pasan el mismo conjunto de casos de evaluación con una tasa de éxito similar en tu aplicación real. Comparar precio por token antes de ese paso no sirve de mucho si uno de los dos modelos falla silenciosamente en tareas que importan.
Conclusión
El criterio de cómo elegir modelo de IA que propone el artículo original es simple de enunciar y bastante más laborioso de aplicar: primero definís el éxito de la tarea con casos concretos, después medís con qué frecuencia tu aplicación lo logra, y solo ahí comparás costo. Subís el modelo nuevo, lo probás en un par de conversaciones sueltas, parece funcionar bien, lo dejás correr en producción y después aparece un usuario con un reporte mal sumado que nadie detectó porque todos miraron el chat y nadie abrió el archivo.
Como criterio práctico de verificación, antes de reemplazar un modelo en producción conviene correr el mismo set de casos reservados contra el candidato viejo y el nuevo, con grader de código donde se pueda y rúbrica donde no, y recién ahí decidir si el ahorro en tokens justifica el cambio. Esto es una propuesta editorial para ordenar el proceso, no un método que hayamos ejecutado nosotros ni algo que la fuente original haya probado con datos propios publicados.
Fuentes
- Choosing the right AI model for your app: measure task success, then compare cost – artículo original con el caso de los reportes de gastos
- HELM de Stanford – benchmark multi-escenario para evaluación de modelos
- Writing effective tools for AI agents – guía de Anthropic sobre evaluación de agentes y tools
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena – paper sobre sesgos en jueces LLM