En pocas palabras: Alibaba Cloud Smart Studio es una plataforma comercial de MaaS presentada en la Conferencia Apsara 2026, con arquitectura de inferencia hasta 505% más rápida que los frameworks estándar de código abierto en el mismo hardware, sumando gateway, facturación y consolas white-label listos para vender capacidad de GPU como servicio.
Ponele que tenés un cluster de GPUs parado, con capacidad de sobra, y la idea de venderla como servicio de inferencia. Bajás vLLM, lo configurás, anda bárbaro en pruebas. ¿Y después? Ahí es donde Alibaba Cloud Smart Studio entra en la conversación: la empresa presentó esta plataforma comercial de Model-as-a-Service (MaaS) en la Conferencia Apsara 2026, con una arquitectura de inferencia que, según el propio fabricante, rinde hasta un 505% más que los frameworks estándar de código abierto en el mismo hardware, de acuerdo con el anuncio oficial recogido por Computer Weekly.
En este artículo:
- En 30 segundos
- ¿Qué es un MaaS y por qué no es lo mismo que un motor de inferencia?
- ¿Qué combina Alibaba Cloud Smart Studio en su plataforma?
- ¿Por qué armar un MaaS propio sobre vLLM, SGLang o TGI es más difícil de lo que parece?
- ¿En qué se diferencian en la práctica, capacidad por capacidad?
- BYO-GPU y BYO-Key: los dos caminos de monetización, con un ejemplo hipotético
- Criterios para decidir entre plataforma comercial y framework open source
- Qué implica esta comparación para equipos que quieren vender APIs de IA
- Qué está confirmado y qué no
- Errores comunes al evaluar un MaaS
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Alibaba Cloud lanzó Smart Studio en la Conferencia Apsara 2026, con rendimiento hasta 505% superior a frameworks open source en el mismo hardware (dato propio de Alibaba).
- vLLM, SGLang y TGI resuelven la inferencia, no el negocio: falta gateway, facturación multi-tenant y consolas de cliente para vender la capacidad como servicio.
- Smart Studio ofrece dos caminos de monetización: BYO-GPU (correr modelos propios) y BYO-Key (revender APIs de terceros con margen).
- Alibaba Cloud opera 107 zonas de disponibilidad en 31 regiones y sumará Turquía, Finlandia y Países Bajos en los próximos 12 meses.
- Smart Fusion, otro lanzamiento de Apsara 2026, combina múltiples modelos y reduce el gasto en tokens en aproximadamente 50%.
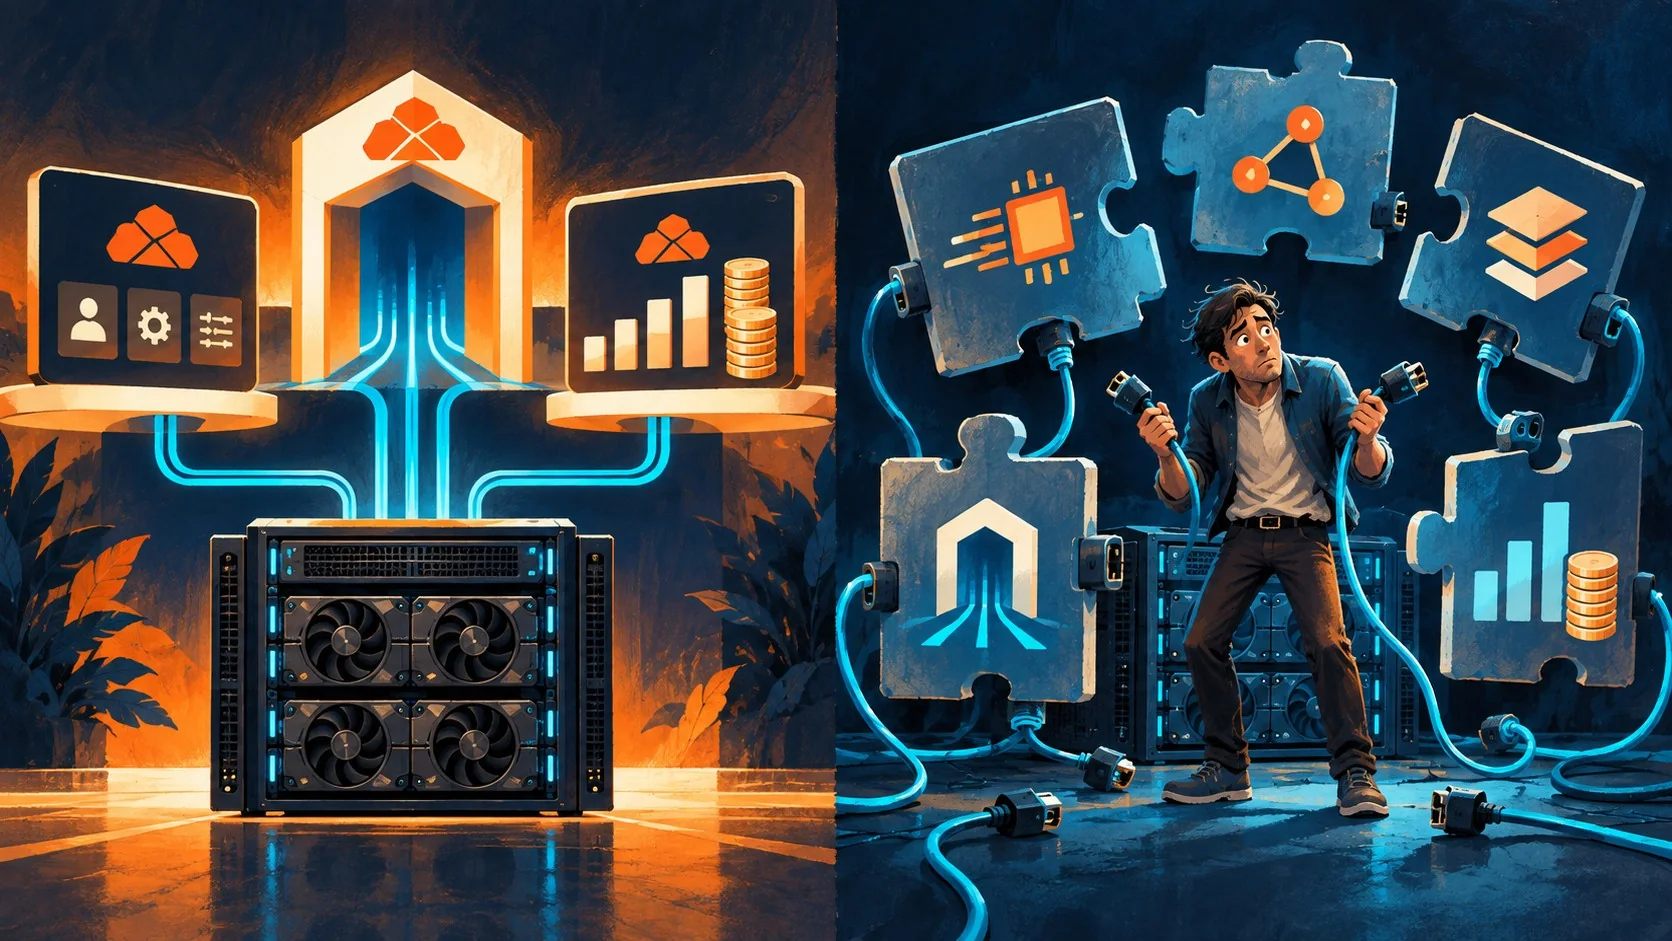
Dicho simple: Smart Studio es el paquete completo para transformar GPU ociosa en un negocio de API que factura por token, bajo marca propia, según la documentación técnica publicada por el equipo de Smart Studio. La diferencia con montar esto a mano no está en el motor que sirve el modelo, sino en todo lo que hay que construir alrededor para que un cliente externo pueda pagar por eso con confianza.
Si alguna vez armaste un endpoint de inferencia con vLLM o TGI, sabés que levantar el servidor es la parte fácil. Lo que viene después (auth, límites de uso, facturación, panel para el cliente) es otro mundo.
¿Qué es un MaaS y por qué no es lo mismo que un motor de inferencia?
Conviene separar dos capas que suelen confundirse. Una cosa es el motor de inferencia (vLLM, SGLang, TGI): el software que carga el modelo en la GPU y contesta requests. Otra cosa, más arriba en el stack, es el negocio que se construye encima de ese motor para cobrarle a terceros por usarlo: quién puede entrar, cuánto consumió, cuánto le toca pagar y dónde ve ese consumo. A esa segunda capa es a la que se llama Model-as-a-Service, o MaaS.
La fuente de Smart Studio plantea esa misma distinción: los frameworks open source sirven el modelo vía API, pero convertir eso en un servicio comercial todavía exige sumar un gateway, políticas de acceso por cliente y una capa de operaciones de negocio. Dicho de otra forma: tener un motor rápido no te da un producto vendible. Te da la mitad del camino. Confundir ambas capas —pensar que “ya tengo el modelo corriendo, lo demás es trámite”— es el error de cálculo más común al arrancar un proyecto así.
¿Qué combina Alibaba Cloud Smart Studio en su plataforma?
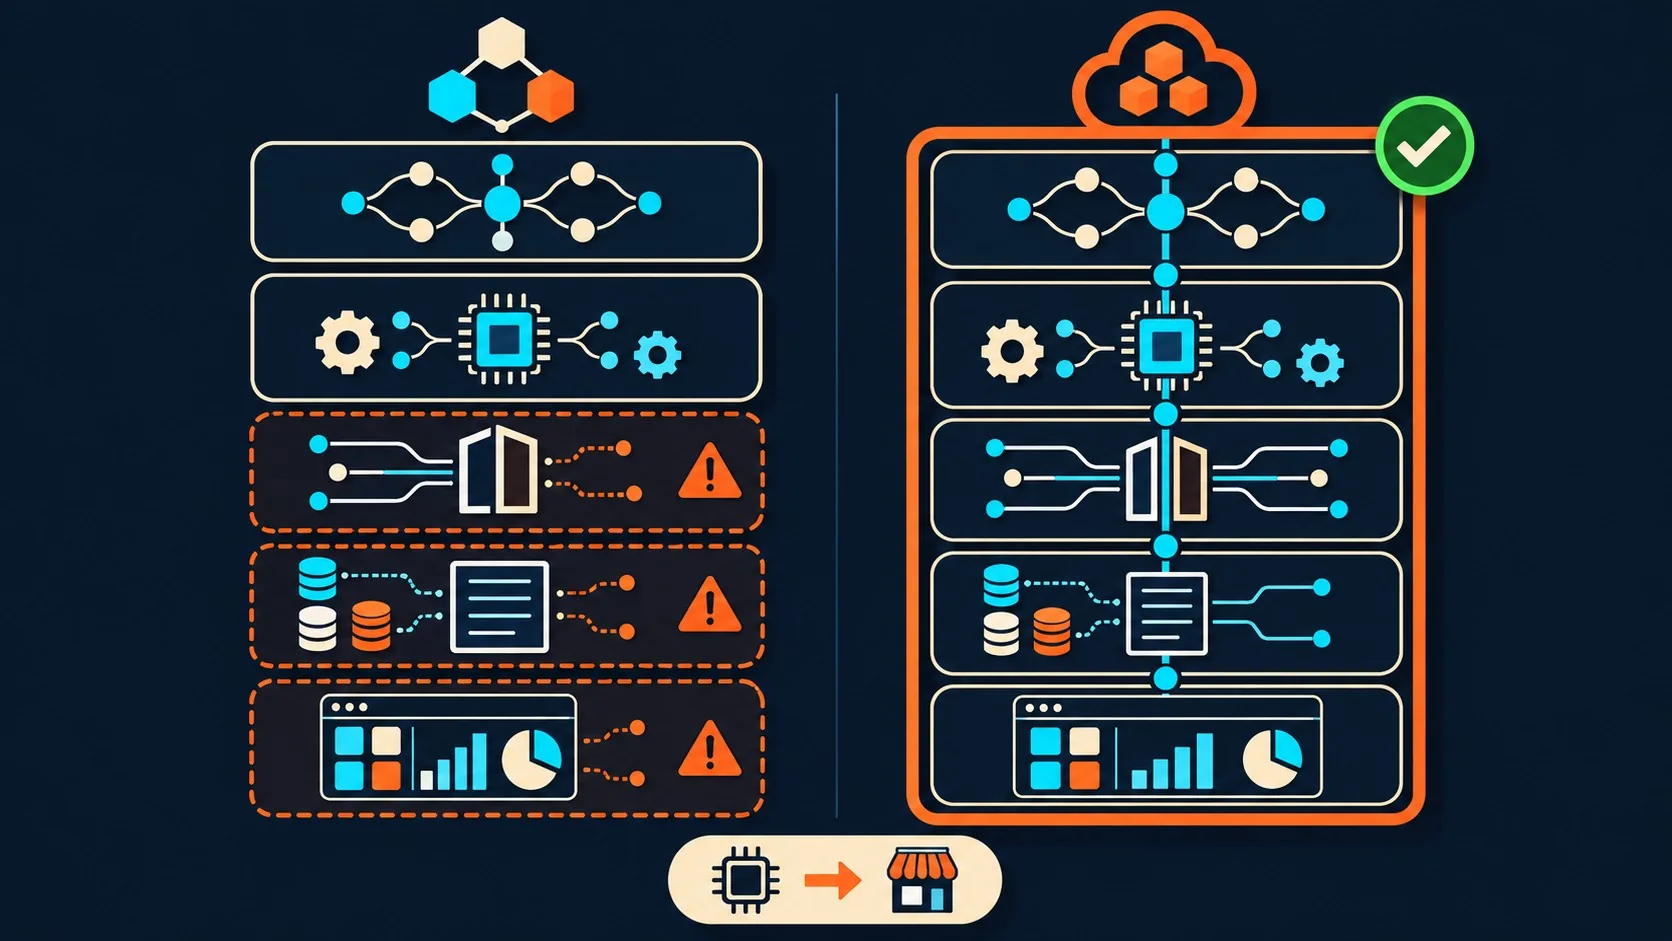
Smart Studio integra en un solo producto la gestión de clusters y modelos, inferencia optimizada, gateway de API y facturación multi-tenant, según detalla la fuente oficial. La idea es que un operador de GPU no tenga que integrar cinco sistemas distintos para vender tokens. Tema relacionado: modelos open source que compiten por una fracción del costo.
- Gestión de clusters y modelos: administración centralizada de los recursos de GPU y de qué modelos corren sobre ellos.
- Inferencia optimizada: Smart Studio ajusta de forma continua los modelos open source más usados a medida que se suman a la plataforma, buscando mejor TPS, menor latencia y menor TTFT.
- Gateway de API compatible con OpenAI: autenticación incorporada y límites de uso por cliente, sin que el equipo tenga que construir esa capa desde cero.
- Métricas y facturación multi-tenant: registros de uso por cliente y por modelo, control de precios y límites, y vistas de facturación listas para operar.
- Consolas white-label: paneles de usuario y de administrador que la empresa puede ofrecer bajo su propia marca, sin desarrollarlos internamente.
Ese último punto (las consolas white-label) es el que más tiempo de desarrollo suele ahorrar, porque construir un panel de cliente decente, con historial de uso y facturación visible, no es trivial.
¿Por qué armar un MaaS propio sobre vLLM, SGLang o TGI es más difícil de lo que parece?
El costo oculto no está en desplegar cada componente por separado, sino en lograr que funcionen como un servicio único y confiable de cara al cliente. Eso es lo que marca la fuente de Smart Studio como el verdadero desafío de un MaaS self-built.
Pensalo en la práctica: subís el modelo, lo probás en local, anda perfecto, lo mandás a producción y ahí aparecen los problemas reales, porque hay que alinear el acceso, el uso y la facturación entre el gateway, el servicio de inferencia y el sistema de cuentas, contabilizar los requests fallidos o reintentados, manejar los streams que se cortan a mitad de respuesta y bancarse la concurrencia sin que la facturación se desincronice del consumo real. Y el trabajo no termina con el lanzamiento: cualquier cambio en el modelo, en el engine de inferencia, en el entorno CUDA, en el gateway o en las reglas de pricing puede romper algo, así que el equipo que opera esto tiene que seguir testeando, monitoreando y reconciliando uso después de salir a producción.
¿Y qué pasa si nadie se ocupa de ese mantenimiento continuo? Exacto: la facturación se desalinea del consumo real y el cliente termina reclamando un cobro que no entiende. Relacionado: guía completa sobre las herramientas generativas de OpenAI.
¿En qué se diferencian en la práctica, capacidad por capacidad?
Más allá del detalle técnico de cada fila, lo que separa a ambos enfoques se puede resumir en una sola pregunta por capacidad: ¿esto ya viene armado, o lo tenés que construir vos? La tabla siguiente toma esa lógica como criterio de lectura, a partir de lo que detalla la documentación de Smart Studio.
| Capacidad | Smart Studio | Stack open source | Qué significa en la práctica |
|---|---|---|---|
| Optimización de inferencia | Ajuste continuo de modelos populares a medida que se suman a la plataforma (TPS, latencia, TTFT) | Hay que configurar y tunear según GPU y workload; algunos frameworks como SGLang ofrecen KV-cache reuse y P/D disaggregation | Con open source, el tuning es tarea tuya y recurrente cada vez que cambia el modelo o la GPU. |
| Acceso y gobierno de API | Gateway compatible con OpenAI, con autenticación y rate limits por cliente ya incorporados | Hay que conectar las APIs de inferencia con políticas de gateway y cuentas de cliente | Sin esto, cualquier cliente externo puede saturar tu servicio sin límite por cuenta. |
| Pricing, billing y metering | Registros de uso por cliente y modelo, control de precios y límites, vistas de facturación | No viene un sistema de facturación comercial; hay que construir o integrar metering, pricing y pagos | Acá está el grueso del trabajo de ingeniería que no se ve hasta que falta. |
| Experiencia white-label | Consolas de usuario y admin listas para usar bajo marca propia | Hay que construir o integrar paneles de cliente y administración | Es lo primero que ve el cliente final; sin panel propio, vendés una API sin cara. |
Vale la aclaración: un paper académico de Saicharan Kolluru, publicado en arXiv, hace justamente un análisis comparativo de rendimiento entre vLLM y HuggingFace TGI como sistemas de serving, sin entrar en la capa comercial que agrega una plataforma como Smart Studio.
BYO-GPU y BYO-Key: los dos caminos de monetización, con un ejemplo hipotético
Smart Studio habilita dos modelos de negocio para monetizar capacidad de cómputo, que se pueden usar por separado o combinados, según ese artículo técnico:
- BYO-GPU (GPU Monetization): la empresa corre modelos en su propia infraestructura de GPU, sea para uso interno o para vender servicios de modelo a clientes externos.
- BYO-Key (Router Monetization): la empresa revende modelos de Model Studio a precios competitivos, o fija su propio precio sobre APIs de modelos de terceros y se queda con el margen de reventa.
La diferencia práctica entre ambos es dónde queda el riesgo de infraestructura. Para que quede más claro, pensemos en un ejemplo hipotético (no corresponde a ningún caso real documentado en las fuentes): una pyme de desarrollo de software, llamémosla “Estudio Ficticio SA”, tiene un cluster de GPUs comprado para entrenar sus propios modelos, que queda ocioso buena parte del mes. Si elige la vía BYO-GPU, factura por uso de ese hardware propio a clientes que necesitan inferencia, y el margen depende de qué tan lleno mantenga el cluster; si lo tiene parado la mitad del tiempo, el costo fijo de la GPU corre igual. Si en cambio elige BYO-Key, no toca hardware: pone su marca sobre una API de terceros y se queda con la diferencia entre lo que paga por el acceso mayorista y lo que cobra al cliente final; el riesgo ahí es de margen, no de infraestructura, pero tampoco controla la disponibilidad del proveedor de base. Un negocio real podría combinar ambas rutas: usar BYO-GPU para los clientes que necesitan baja latencia y GPU dedicada, y BYO-Key para completar catálogo con modelos que no le conviene alojar.
Criterios para decidir entre plataforma comercial y framework open source
Antes de elegir un camino, conviene chequear estos puntos contra el caso propio:
- ¿Vas a facturarle a terceros o es uso interno? Si no hay cliente externo pagando por token, la capa comercial completa de un MaaS es gasto innecesario.
- ¿Ya tenés billing y gateway funcionando? Si la empresa ya resolvió esa capa para otro producto, sumar solo el motor de inferencia (vLLM, SGLang, TGI) puede alcanzar.
- ¿Cuánto tráfico concurrente esperás? A mayor concurrencia y streams largos, más pesa el problema de reconciliar uso y facturación en tiempo real, que es justo lo que una plataforma empaquetada resuelve de entrada.
- ¿Tenés equipo para mantenimiento continuo? Cada cambio de modelo, CUDA o pricing exige testing y monitoreo post-lanzamiento. Si no hay quién lo haga, construir a mano es más riesgo del que parece al inicio.
- ¿El benchmark que te muestran viene validado por un tercero? Cifras como el 505% de mejora son autorreportadas por el fabricante; sirven como referencia, no como garantía contractual.
Esto no es poco relevante para equipos chicos. Si tu caso es “quiero probar si Llama o Qwen me sirve para un proyecto interno”, montar vLLM alcanza y sobra. El tema cambia cuando la idea es cobrarle a un tercero por token consumido: ahí la ecuación de costo-beneficio se inclina hacia una plataforma como Smart Studio. Ya lo cubrimos antes en la estrategia multicloud de OpenAI con Google Cloud.
Qué implica esta comparación para equipos que quieren vender APIs de IA
Implica que un motor de inferencia rápido no alcanza para armar un negocio de API por tokens. Optimizaciones como el KV-cache reuse o el P/D disaggregation de SGLang resuelven rendimiento, no resuelven facturación, gobierno de API ni experiencia de cliente.
Alibaba Cloud también lanzó en la misma Conferencia Apsara 2026 otras dos piezas que completan el combo: Smart Fusion, un motor que combina múltiples modelos bajo una API unificada y reduce el gasto en tokens en aproximadamente 50% según el comunicado de Alibaba Cloud, y Smart Video, un agente de generación de video de hasta una hora de duración. La empresa también confirmó que en los próximos 12 meses sumará regiones de nube en Turquía, Finlandia y Países Bajos, además de nuevos datacenters en Malasia, Tailandia, Alemania, Emiratos Árabes Unidos, Francia y Hong Kong; actualmente opera 107 zonas de disponibilidad en 31 regiones.
“A medida que Alibaba Cloud ha pasado de una infraestructura nativa de IA a una arquitectura de nube nativa de agentes, la IA también está avanzando rápidamente de la fase experimental a la implementación en el mundo real”, dijo el Dr. Feifei Li, director de tecnología y presidente de Negocios Internacionales de Alibaba Cloud Intelligence, según recoge Computer Weekly.
Qué está confirmado y qué no
Está confirmado que Smart Studio existe como producto, que se presentó en la Conferencia Apsara 2026 y que combina los componentes descriptos arriba: gestión de clusters, gateway, metering y consolas white-label. También está confirmada la expansión de infraestructura regional de Alibaba Cloud prevista para los próximos 12 meses desde el anuncio. Más contexto en cómo los bots de OpenAI rastrean sitios web.
Lo que no está confirmado de forma independiente es el benchmark del 505% de mejora de performance: es una cifra autorreportada por Alibaba, no un dato validado por un tercero. Tampoco hay precios públicos detallados de Smart Studio ni disponibilidad confirmada región por región para ese producto específico, más allá de la expansión general de datacenters. El ejemplo de “Estudio Ficticio SA” mencionado más arriba es una construcción hipotética para ilustrar la diferencia entre BYO-GPU y BYO-Key, no un caso documentado en las fuentes.
Errores comunes al evaluar un MaaS
- Creer que gateway + billing alcanza: el error típico es sumar un API gateway y un sistema de facturación sobre vLLM o TGI y pensar que ya está. Falta la reconciliación de reintentos, streams cortados y uso concurrente, que es donde se rompe todo en producción.
- Subestimar el mantenimiento post-lanzamiento: cambios en el modelo, en CUDA o en las reglas de pricing exigen testing y monitoreo constante. Si nadie lo hace, la facturación se desalinea del consumo real.
- Mezclar BYO-GPU y BYO-Key sin pensar el modelo de negocio: uno asume el costo de infraestructura, el otro vive del margen de reventa. Combinarlos sin un plan claro de precios termina licuando el margen.
- Elegir una plataforma comercial completa cuando el caso real es investigación interna: si no vas a vender APIs a terceros, pagar por toda la capa comercial de un MaaS es gasto innecesario.
Si tu plan incluye exponer esa API al público y necesitás resolver dominio, hosting del panel de administración o infraestructura web alrededor del servicio, en Argentina podés resolverlo con donweb.com sin meterte en otro proyecto de integración paralelo.
Preguntas Frecuentes
¿Qué es Alibaba Cloud Smart Studio?
Es una plataforma comercial de Model-as-a-Service que Alibaba Cloud presentó en la Conferencia Apsara 2026, pensada para que empresas empaqueten, midan y facturen APIs de modelos de IA bajo su propia marca. Integra gestión de clusters, inferencia optimizada, gateway de API y consolas white-label en un solo producto.
¿Cuál es la diferencia entre vLLM, SGLang o TGI y una plataforma MaaS?
vLLM, SGLang y TGI son motores de inferencia: corren el modelo y sirven requests vía API, nada más. Una plataforma MaaS como Smart Studio agrega la capa comercial completa encima: gateway, autenticación por cliente, facturación multi-tenant y paneles de administración.
¿Por qué es difícil montar un servicio comercial de IA sobre frameworks open source?
Porque lo difícil no es desplegar cada pieza, sino que operen como un servicio único y confiable: alinear acceso, uso y facturación entre gateway, inferencia y cuentas, además de manejar reintentos y streams interrumpidos. El trabajo de testing y monitoreo sigue después del lanzamiento, cada vez que cambia el modelo, el engine o el pricing.
¿Qué significan BYO-GPU y BYO-Key para monetizar GPU?
BYO-GPU significa correr modelos en infraestructura propia para uso interno o venta de servicios a clientes, asumiendo el costo fijo del hardware. BYO-Key significa revender modelos de Model Studio o APIs de terceros a un precio propio, quedándose con el margen de reventa sin asumir el costo de la GPU.
¿Cuándo conviene usar un framework open source en vez de una plataforma comercial de inferencia?
Conviene cuando el objetivo es investigación de algoritmos, testing de modelos o uso interno a pequeña escala, sin planes de vender APIs a terceros. También aplica si la empresa ya tiene resuelta su propia capa de gestión de GPU, acceso a API y billing.
Conclusión
Lo que cambia con Smart Studio no es la inferencia en sí, sino el tiempo que toma convertir GPU ociosa en un negocio de API facturable. La fuente oficial lo resume bien: si el plan es vender tokens a terceros, una plataforma MaaS resuelve en horas lo que un equipo tardaría meses en integrar a mano. Si el plan es research o uso interno, vLLM, SGLang o TGI siguen siendo la opción más directa, sin pagar por una capa comercial que no vas a usar.
Antes de decidir, conviene chequear tres cosas con tu propio caso: cuánto tráfico externo real vas a facturar, si ya tenés o no un sistema de billing confiable, y si el benchmark de performance que te muestran (sea el 505% de Alibaba o cualquier otro) viene validado por un tercero o es autorreportado por el fabricante.
Fuentes
- From Inference to Commercial MaaS: Alibaba Cloud Smart Studio vs. Open-Source – artículo técnico publicado en dev.to por la cuenta Smart Studio
- Alibaba Cloud anuncia nuevas regiones de nube y funciones de IA – Computer Weekly en español
- Comparative Analysis of Large Language Model Inference Serving Systems: vLLM y HuggingFace TGI – arXiv