En pocas palabras: OpenAI envió 508 requests en los 30 días hasta el 20 de octubre de 2026, tercero detrás de Google (961) y Anthropic (680), según el experimento con Cloudflare AI Crawl Control. Pese a ese volumen, ChatGPT citó el sitio en 0 de 12 respuestas probadas el 17 de octubre.
Un desarrollador midió con Cloudflare AI Crawl Control los bots de IA que visitaron su blog personal de ocho posts durante 30 días, hasta el 20 de octubre de 2026. El resultado: casi 4.040 requests, liderados por Google, Anthropic y OpenAI, aunque solo 26 fueron de un asistente respondiendo en vivo a una persona.
Un crawler de IA es un programa automatizado que empresas como OpenAI, Anthropic o Google usan para recorrer páginas web y alimentar sus modelos o sus índices de búsqueda. Cada bot se identifica con un user agent propio (GPTBot de OpenAI, ClaudeBot de Anthropic, Googlebot de Google) y herramientas como Cloudflare AI Crawl Control permiten ver cuántas veces visitó tu sitio, qué páginas leyó y con qué propósito.
En este artículo:
- En unos minutos
- ¿Cuántas veces visitaron bots de IA un sitio en 30 días?
- ¿Qué empresa de IA envía más bots a rastrear páginas?
- ¿Para qué rastrean las páginas los bots de IA: entrenamiento, búsqueda o asistente?
- ¿Qué páginas leen más los crawlers de IA: posts o sitemaps?
- ¿Ser rastreado por OpenAI significa que ChatGPT te va a citar?
- Cómo decidir qué hacer con estos números según el tipo de sitio
- ¿Cómo detectar bots falsos que usan el nombre de un crawler de IA?
- ¿Cómo ver qué bots de IA visitan tu propio sitio?
- Qué significa esto para equipos y webmasters en Latinoamérica
- Errores comunes al medir bots de IA en tu sitio
- Preguntas Frecuentes
- Conclusión
- Fuentes
En unos minutos
- Cloudflare registró ~4.040 requests de crawlers de IA en 30 días sobre un blog de ocho posts, según el experimento publicado en dev.to.
- Google envió más solicitudes (961), seguido por Anthropic (680) y OpenAI (508).
- Casi la mitad de las requests exitosas (~1.720) fueron para entrenar modelos; solo 26 fueron un asistente de IA leyendo una página porque alguien preguntó algo.
- Con 508 visitas de OpenAI en el mes, ChatGPT no citó el sitio en ninguna de 12 respuestas probadas el 17 de octubre.
- Ocho de los diez paths más pedidos por “bots de IA” eran archivos como .env o credentials.json: scanners disfrazados, no crawlers reales.
¿Cuántas veces visitaron bots de IA un sitio en 30 días?
En los 30 días previos al 20 de octubre de 2026, los crawlers de IA que Cloudflare reconoce hicieron alrededor de 4.040 requests a un blog personal de ocho posts, según el experimento de yappatyih.com. De esas, unas 3.540 fueron exitosas (las demás dieron error 404 o similar).
Ojo con esto: es un sitio chico, ocho posts, no un ecommerce ni un medio con miles de URLs. El número en sí no es el dato importante. Lo que importa es la proporción entre quién rastrea, para qué y qué pasa después con esa visita. Ahí está el jugo del experimento.
Una semana antes, el 13 de octubre, la misma ventana de 30 días mostraba cerca de 3.000 requests. Googlebot subió de 602 a 889, ClaudeBot de 464 a 642, GPTBot de 356 a 373. La tendencia es clara: más rastreo, y la mayor parte del crecimiento vino de Google, Anthropic y Apple.
¿Qué empresa de IA envía más bots a rastrear páginas?
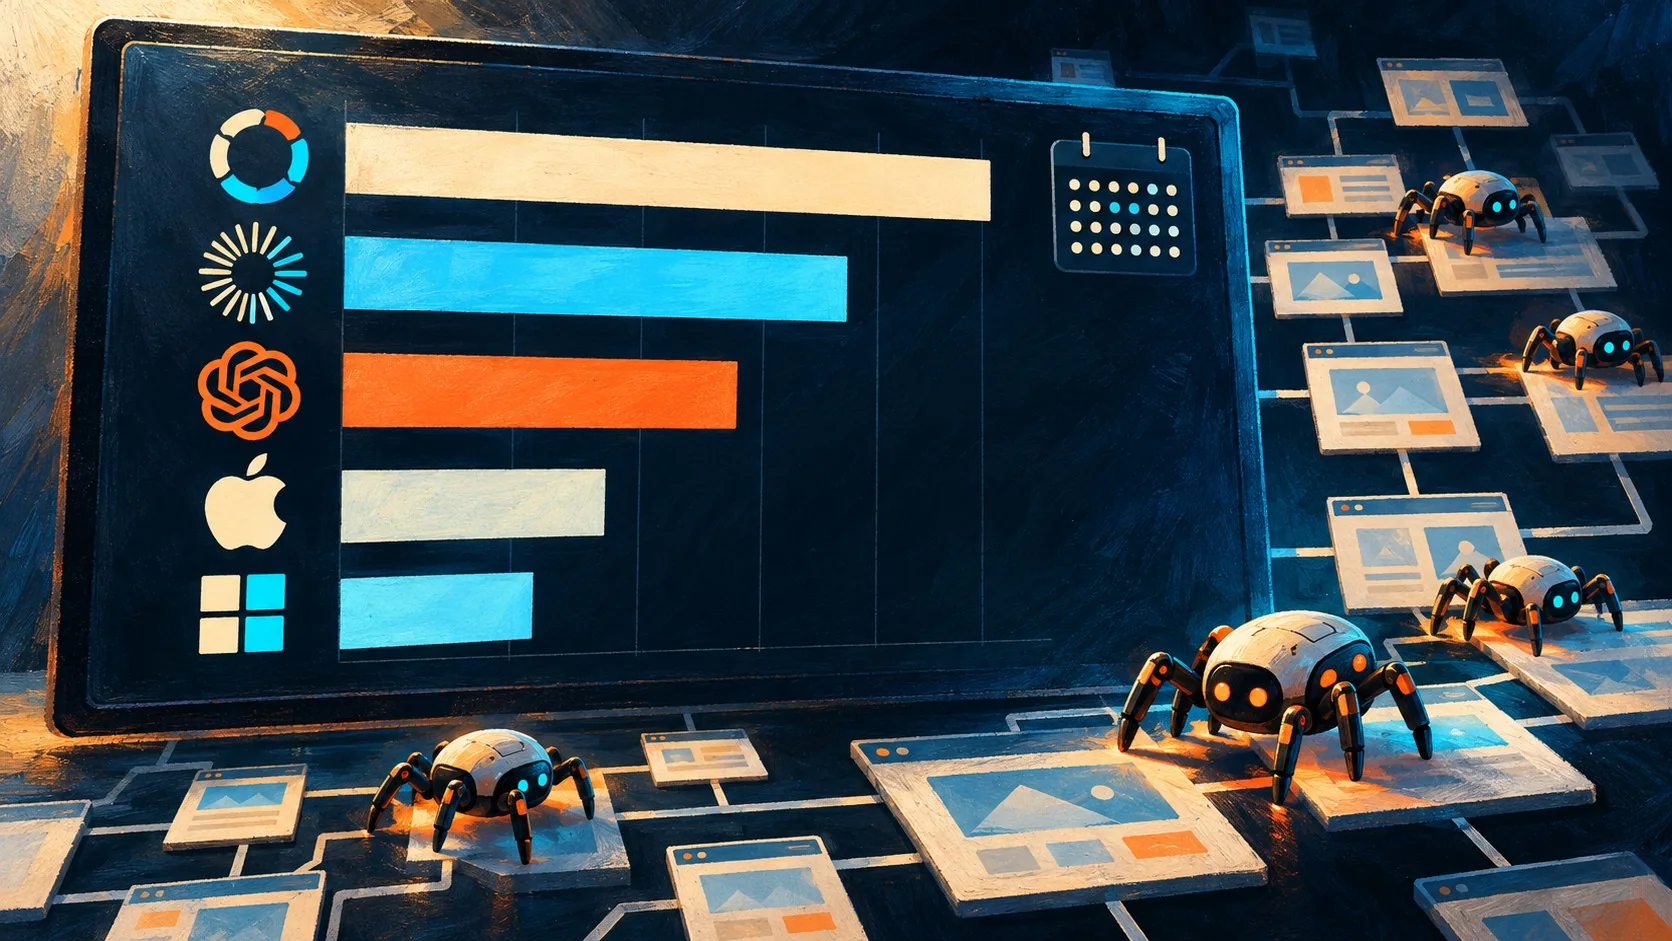
Google lideró con 961 requests permitidas, seguido por Anthropic con 680 y OpenAI con 508, de acuerdo con el ranking de diez empresas que armó Cloudflare AI Crawl Control agrupando cada crawler por compañía.
| Empresa | Crawler principal | Requests permitidas (30 días) |
|---|---|---|
| Googlebot | 961 | |
| Anthropic | ClaudeBot | 680 |
| OpenAI | GPTBot | 508 |
| Apple | Applebot | 377 |
| Microsoft | BingBot | 309 |
| Huawei | PetalBot | 238 |
| Meta | Meta-ExternalAgent | 212 |
| Common Crawl | CCBot | 138 |
| Amazon | Amazonbot | 128 |
| Internet Archive | archive.org_bot | 111 |
Googlebot es el crawler detrás de Google Search, y las respuestas con IA de Google usan el mismo índice, por eso aparece primero en esta lista. Anthropic quedó segundo, por delante de OpenAI. Lo llamativo es que el ranking de tráfico y el ranking de citas no coinciden en nada: Perplexity, la única empresa que sí citó el sitio ese día, ni siquiera entra en el top diez de rastreadores. Medir cuánto te visitan sin medir si eso se traduce en una cita es, en el fondo, medir solo la mitad del problema.
¿Para qué rastrean las páginas los bots de IA: entrenamiento, búsqueda o asistente?
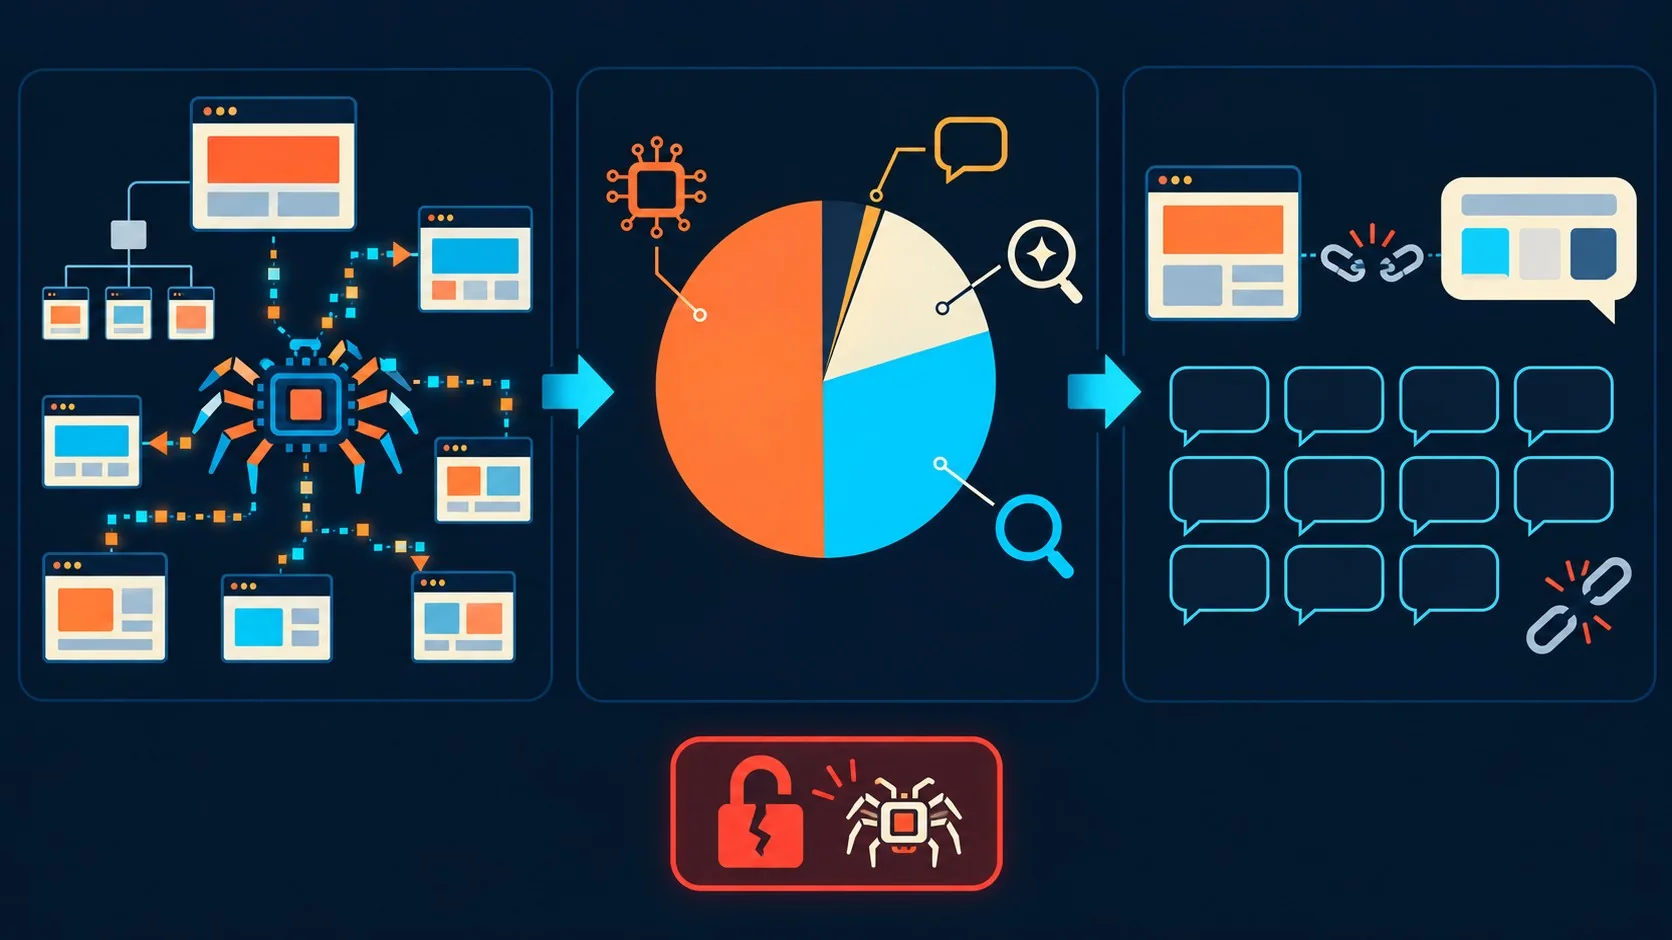
Casi la mitad de las requests exitosas, unas 1.720 de 3.540, fueron para entrenar modelos de IA. Solo 26 fueron del tipo “AI Assistant”, es decir, una persona le pidió algo a un asistente y este fue a leer la página en el momento, según la clasificación por propósito de Cloudflare.
- Entrenamiento (AI Crawler): ~1.720 requests, cerca de la mitad del total. Bots como GPTBot o ClaudeBot juntan páginas para futuros modelos.
- Motor de búsqueda (Search Engine Crawler): ~1.190 requests, un tercio. Construye el índice tradicional, como el de Google Search.
- Búsqueda con IA (AI Search): 482 requests, una de cada siete. Arma el índice que consulta un asistente cuando responde.
- Archivador: 110 requests, el 3%. Guarda copias históricas, como Internet Archive.
- Asistente de IA (AI Assistant): 26 requests, menos del 1%. Es la única categoría donde hay una persona del otro lado, en vivo.
Esa última fila es la que importa de verdad. Veintiséis veces en un mes alguien preguntó algo y un asistente vino a leer una página de este sitio. Todo lo demás fue máquinas llenando sus depósitos por si acaso.
¿Qué páginas leen más los crawlers de IA: posts o sitemaps?
El archivo más leído del sitio no es un post: son los sitemaps. Entre sitemap-posts.xml, sitemap-index.xml, sitemap.xml y sitemap-0.xml, los crawlers hicieron 687 requests en 30 días, más que cualquier post individual, cuyo tope fue 66 lecturas.
Los crawlers gastan la mayoría de sus visitas averiguando qué existe, no leyéndolo. En total se pidieron 271 paths distintos, y todo el mes sumó unos 74 MB de tráfico, 18,63 MB solo de Googlebot y 11,24 MB de GPTBot. En el plan gratuito de Cloudflare, eso no costó nada.
En una ventana de 30 días anterior, la que terminó el 13 de octubre, el archivo llms.txt (el que muchos recomiendan crear “para la IA”) tuvo cero lecturas, y el robots.txt común y viejo tuvo 605. Un sitemap correcto y actualizado pesa más que cualquier archivo especial inventado para crawlers de IA. De ahí sale un criterio simple para priorizar tiempo: si vas a invertir en algo técnico, poné primero el sitemap y la estructura de navegación en orden; un archivo especial para IA no sustituye eso, en el mejor de los casos lo complementa.
¿Ser rastreado por OpenAI significa que ChatGPT te va a citar?
No. OpenAI hizo 508 requests permitidas al sitio en el mes, pero ChatGPT no lo citó en ninguna de 12 preguntas que el propio sitio podía responder, probadas el 17 de octubre de 2026. El patrón se repite con otras empresas: rastreo alto no implica cita.
Como resume el autor del experimento en su publicación original: “Being crawled is not being cited” (ser rastreado no es lo mismo que ser citado). Los números lo confirman:
- OpenAI: 508 requests, 0 de 12 citas en ChatGPT el 17 de octubre.
- Microsoft: 309 requests de BingBot, 0 citas en tres meses según el reporte de AI Performance de Bing Webmaster Tools.
- Google: 961 requests, 14 impresiones en AI features según Search Console, en 28 días.
- Perplexity: ni siquiera entra en el top diez de rastreadores, pero citó el sitio en 4 de 8 respuestas el mismo día.
¿Qué explica la diferencia? Una visita de crawler mete tu página en la pila de candidatas. Que una respuesta la cite depende de qué dice la página, quién más dice lo mismo y cuánta confianza le tiene el motor a tu sitio. La cantidad de visitas no predice la cantidad de citas, y eso es algo que ningún “SEO para IA” te va a vender fácil.
Cómo decidir qué hacer con estos números según el tipo de sitio
El experimento no da una receta única porque el autor mide su propio blog personal, con ocho posts. La decisión de qué hacer con el rastreo de IA cambia bastante según qué tipo de sitio tengas, y acá hay algunos criterios para ordenar esa decisión:
- Blog personal o portfolio: el volumen de rastreo casi no importa. Lo que define si te citan es si tu página dice algo que no está dicho igual en otro lado. Perseguir archivos especiales para IA (llms.txt, etc.) tiene poco sentido si el contenido es genérico.
- Documentación técnica o guías con información puntual: acá el fetch de “AI Assistant” (el 26 de 3.540 del experimento) es la métrica que más vale seguir, porque indica que una persona preguntó algo específico y un asistente fue a buscar la respuesta en vivo.
- Ecommerce con catálogo: conviene diferenciar entrenamiento de búsqueda con IA. Bloquear bots de entrenamiento protege precios y descripciones de ser reutilizados sin control; permitir los de búsqueda con IA mantiene la chance de aparecer cuando alguien pregunta por un producto.
- Medio de noticias o sitio con mucho tráfico orgánico: bloquear de forma general reduce la posibilidad de aparecer en las funciones de IA de Google o Bing, que usan índices separados del buscador tradicional.
Ejemplo hipotético (no corresponde a datos reales del experimento): imaginemos una consultora de software en Buenos Aires que publica dos artículos. El primero documenta un error puntual de configuración al migrar una base de datos a un proveedor cloud específico, con los comandos exactos que lo resuelven. El segundo es una introducción general a “qué es la nube”. Si GPTBot rastrea los dos artículos cien veces cada uno, es más probable que un asistente cite el primero cuando alguien pregunte por ese error exacto, porque no hay otra fuente en español que lo resuelva igual. El segundo, por más que lo rastreen, compite con miles de explicaciones ya indexadas sobre el mismo tema genérico. La diferencia no está en cuántas veces visita el bot: está en si la página resuelve algo que ninguna otra resuelve de la misma forma.
¿Cómo detectar bots falsos que usan el nombre de un crawler de IA?
Si ves requests a archivos como .env, credentials.json o .git/config bajo el nombre de un crawler de IA, no es un crawler real: es un scanner que copió ese user agent para pasar desapercibido. En el experimento, ocho de los diez paths “faltantes” más pedidos eran justamente de ese tipo.
- /web.config y /credentials.json: 4 requests cada uno.
- /.env.local, /.env.bak, /terraform.tfvars, /.git/config, /application.yml y /.git/HEAD: 3 requests cada uno.
Un crawler de entrenamiento real sigue links y sitemaps. No tiene ningún motivo para pedir un archivo .env que nadie enlaza desde ningún lado. En el plan gratuito de Cloudflare, un bot se reconoce por el nombre que declara, no por su dirección IP real, así que estos scanners quedaron contados como si fueran GPTBot o ClaudeBot. Todos recibieron un error 404, porque esos archivos no existían.
El criterio práctico para distinguir un crawler real de uno disfrazado es simple: un crawler real pide rutas que están enlazadas desde algún lugar del sitio (otro post, el sitemap, el menú de navegación). Un scanner pide rutas que no enlazaste en ningún lado, porque las está probando a ciegas contra miles de dominios al mismo tiempo. Si algo pide un archivo que vos nunca enlazaste, no importa qué nombre de bot use en el user agent: no es ese bot.
La comprobación es simple: abrí tusitio.com/.env y tusitio.com/.git/config en el navegador. Las dos tienen que dar error, nunca mostrar un archivo. Si tu sitio lo armó un tercero, pedile hoy mismo que lo chequee.
¿Cómo ver qué bots de IA visitan tu propio sitio?
Hay tres formas de verlo, y la primera toma unos minutos si tu sitio ya corre en Cloudflare, plan gratuito incluido: abrís AI Crawl Control desde el dashboard y ves el total, las empresas y las rutas más leídas.
- Cloudflare AI Crawl Control: en Overview ves el total y las empresas; en Crawlers, cada bot con su propósito y si está permitido o bloqueado; en Metrics, los gráficos con un rango máximo de 30 días. El límite: identifica por nombre declarado, no por IP verificada.
- Log crudo del servidor: si tu sitio no está en Cloudflare, pedile a tu proveedor de hosting el access log (en hosting con cPanel suele estar bajo “Raw Access”) y corré un grep buscando GPTBot, ClaudeBot, Googlebot, Bingbot y los demás nombres de crawler.
- Tu robots.txt: te dice quién está permitido, no quién vino. Un checker de crawlers de IA lo lee de una y te muestra qué bots dejás pasar.
Un detalle que casi nadie chequea: Google Analytics no muestra nada de esto. Deja afuera a los bots conocidos, y la mayoría de estos crawlers nunca ejecuta su script de tracking.
Qué significa esto para equipos y webmasters en Latinoamérica
Si manejás un sitio con contenido propio (notas, guías, documentación técnica), vale la pena correr este mismo chequeo una vez por mes. No para bloquear a nadie por default, sino para aplicar los criterios de la sección anterior según el tipo de sitio: no es lo mismo un blog personal que una base de documentación con información técnica que no está resuelta igual en otro lado.
Bloquear todos los crawlers de IA por las dudas tampoco resuelve nada: si un asistente nunca leyó tu página, menos la va a citar. El autor del experimento deja su robots.txt abierto a todos por esa razón. La pregunta que sí tiene sentido hacerse es otra: ¿tu contenido dice algo que valga la pena citar, o es más de lo mismo que ya está en otras cien páginas?
Errores comunes al medir bots de IA en tu sitio
Subís el reporte de Cloudflare, ves un número grande de requests de OpenAI o Anthropic, y asumís que eso ya es una victoria de visibilidad, lo compartís en una reunión como si fuera tráfico real, y después te preguntás por qué el sitio no aparece citado en ninguna respuesta de ChatGPT. Este error se agrava en equipos de marketing que reciben el reporte sin contexto y lo presentan como métrica de éxito por sí sola, sin cruzarlo con ninguna medición de citas.
- Confundir rastreo con cita: como mostró este experimento, 508 requests de OpenAI dieron 0 citas en ChatGPT. Medí las dos cosas por separado.
- Contar scanners como crawlers reales: si no filtrás por IP, un bot que pide .env bajo el nombre de GPTBot infla tus números sin ser tráfico real de OpenAI.
- Crear llms.txt y descuidar el sitemap: en una ventana de 30 días anterior, llms.txt tuvo 0 lecturas contra 605 del robots.txt; en el mes más reciente, los sitemaps sumaron 687 requests entre todos.
- Mirar solo 30 días y sacar conclusiones de tendencia: Cloudflare en plan free no guarda nada más viejo que eso, así que una sola ventana no te dice si vas para arriba o para abajo de forma sostenida.
Preguntas Frecuentes
¿Cómo saber qué bots de IA están rastreando mi sitio web?
Si tu sitio está en Cloudflare, abrí AI Crawl Control: lista cada crawler de IA que reconoce, su empresa, su propósito y las páginas que leyó, hasta 30 días, incluso en el plan gratuito. Si no usás Cloudflare, buscá en el access log de tu servidor nombres como GPTBot, ClaudeBot o PerplexityBot.
¿Qué diferencia hay entre un bot de entrenamiento y uno de búsqueda de IA?
Un bot de entrenamiento, como GPTBot o ClaudeBot, junta páginas para entrenar modelos de lenguaje. Un bot de búsqueda de IA, como OAI-SearchBot de OpenAI, construye el índice que un asistente consulta al responder. Un tercer tipo, el fetch de asistente (ChatGPT-User, Claude-User), ocurre cuando una persona pregunta algo en vivo y el bot va a leer la página en ese momento.
¿Si GPTBot visita mi web, ChatGPT me va a citar?
No necesariamente. En el experimento de referencia, OpenAI hizo 508 requests al sitio en 30 días y ChatGPT lo citó en 0 de 12 respuestas probadas. Que te rastreen pone tu página en la pila de candidatas; que te citen depende de qué dice tu página y cuánta confianza tenga el motor en tu sitio.
¿Cómo bloqueo los crawlers de IA con robots.txt?
Agregás un bloque específico por cada bot, por ejemplo “User-agent: GPTBot” seguido de “Disallow: /”, y repetís el patrón para ClaudeBot, Google-Extended u otros nombres que quieras bloquear. Esto le pide al crawler que no entre, pero depende de que esa empresa respete la directiva.
¿Google, OpenAI o Anthropic rastrean más páginas?
En el experimento medido con Cloudflare, Google rastreó más (961 requests en 30 días), seguido por Anthropic (680) y después OpenAI (508). El orden puede variar según el sitio, pero estos tres nombres son los primeros que conviene chequear en cualquier reporte de crawlers de IA.
Conclusión
El dato que cambia la conversación no es cuántas veces te rastrean, sino que rastreo y cita son cosas distintas, y por ahora casi no se tocan: 508 requests de OpenAI y cero citas en ChatGPT lo dejan bastante claro. Si administrás un sitio, lo accionable es correr este mismo chequeo con Cloudflare AI Crawl Control (o con el log de tu servidor) una vez al mes, separar entrenamiento de búsqueda de IA, aplicar el criterio de qué tipo de sitio tenés antes de decidir si bloqueás algo, y revisar que ningún scanner disfrazado de GPTBot esté pidiendo tus archivos .env. Lo que no se puede concluir todavía, con un solo sitio y un solo mes de datos, es si ese patrón se repite igual en sitios más grandes o con más autoridad. Habría que ver.