En pocas palabras: lazycommit es un CLI en Python sin dependencias que usa Qwen2.5-Coder 0.5B (400 MB) corriendo local vía Ollama, llama.cpp o LM Studio para leer tu diff staged y generar mensajes de commit en formato Conventional Commits en unos 2 segundos, sin enviar código a la nube.
Hay una fricción chiquita pero constante en el día a día de cualquiera que use Git seguido: llegás al punto de hacer git commit y tenés que inventar, de nuevo, una frase que resuma lo que acabás de cambiar. Casi nadie odia programar, pero bastante gente odia esa pausa. lazycommit ataca justo ese momento: lee tu diff staged y te tira un mensaje en formato Conventional Commits, generado por un modelo chico que corre en tu propia máquina. El proyecto lo publicó su autor en dev.to, como parte del Hacktoberfest Open-Source AI Challenge (semana 3), y el código está en GitHub con licencia MIT.
Lo interesante no es tanto “otra herramienta de IA para Git” —de esas hay bastantes— sino la decisión de forzar todo a correr local, con un modelo de menos de 500 millones de parámetros. Esa restricción de diseño es la que vale la pena mirar con detalle, porque define tanto lo que la herramienta puede hacer bien como lo que no.
En este artículo:
- En síntesis
- ¿Qué es lazycommit y qué problema resuelve?
- ¿Qué modelo de IA usa lazycommit y por qué corre en local?
- ¿Cómo instalar lazycommit para generar commit messages con IA local?
- ¿Cómo escribió lazycommit tres commits reales en la demo del autor?
- ¿Te conviene usar lazycommit? Algunos criterios para decidir
- ¿Qué límites tiene un modelo de 0.5B para esta tarea?
- ¿Por qué usar un modelo open-weight en vez de una API en la nube?
- Errores comunes al usar lazycommit
- Preguntas Frecuentes
- Conclusión
- Fuentes
En síntesis
- lazycommit lee el diff staged con
git diff --cachedy devuelve un mensaje de commit en formato Conventional Commits. - El modelo default es Qwen2.5-Coder 0.5B Instruct, pesa cerca de 400 MB y corre en CPU, sin GPU.
- En una demo del propio autor, el modelo generó tres mensajes correctos (feat, docs, test) en unos 2 segundos cada uno sobre una VM de 2 cores; el autor mismo aclara que es un dato puntual, no un benchmark.
- El código es MIT y los pesos del modelo tienen licencia Apache-2.0, separados pero ambos abiertos.
- El modo default solo imprime la sugerencia; hace falta la flag
--commitpara que confirme el commit automáticamente.
¿Qué es lazycommit y qué problema resuelve?
lazycommit resuelve un problema puntual: escribir el mensaje de commit cuando no tenés ganas, ni tiempo, ni una frase clara en la cabeza. Su autor, en el repositorio de GitHub, cuenta que commitea a diario y que la parte que siempre quiere saltarse es justamente esa. Tiene sentido: “fix stuff” como mensaje no describe nada, y sin embargo es probablemente el commit message más repetido de la historia de Git.
La herramienta es Python puro, sin dependencias de runtime, lo cual no es un detalle menor: significa que instalarla no te arrastra media librería de terceros. Stageás tus cambios con git add, corrés lazycommit, y el CLI manda el diff a un servidor local que habla el protocolo de chat de OpenAI. Ese servidor corre un modelo open-weight que lee el diff y devuelve un mensaje tipo feat: add timeout option to portscan. Con la flag --commit, lo aplica directo, sin pedirte confirmación extra.
Ejemplo hipotético (ilustrativo, no es un caso real reportado): imaginemos a alguien que trabaja en una API interna de facturación y durante una tarde toca tres cosas: agrega un endpoint de reintentos, corrige un typo en la validación de montos y actualiza el README con la nueva variable de entorno. Si stagea los tres cambios juntos en un solo commit gigante, un modelo de 0.5B probablemente va a tener que elegir un solo “tipo” para describir algo que en realidad son tres cosas distintas, y es ahí donde el recorte automático de diff puede perder contexto relevante. El mismo escenario, dividido en tres commits con git add -p (uno por cambio lógico), le da al modelo un diff acotado y coherente por vez, y es mucho más probable que acierte el tipo correcto en cada uno. El patrón no es específico de lazycommit: cualquier generador automático de mensajes de commit, local o en la nube, rinde mejor cuando el diff que recibe representa una sola intención de cambio.
¿Qué modelo de IA usa lazycommit y por qué corre en local?
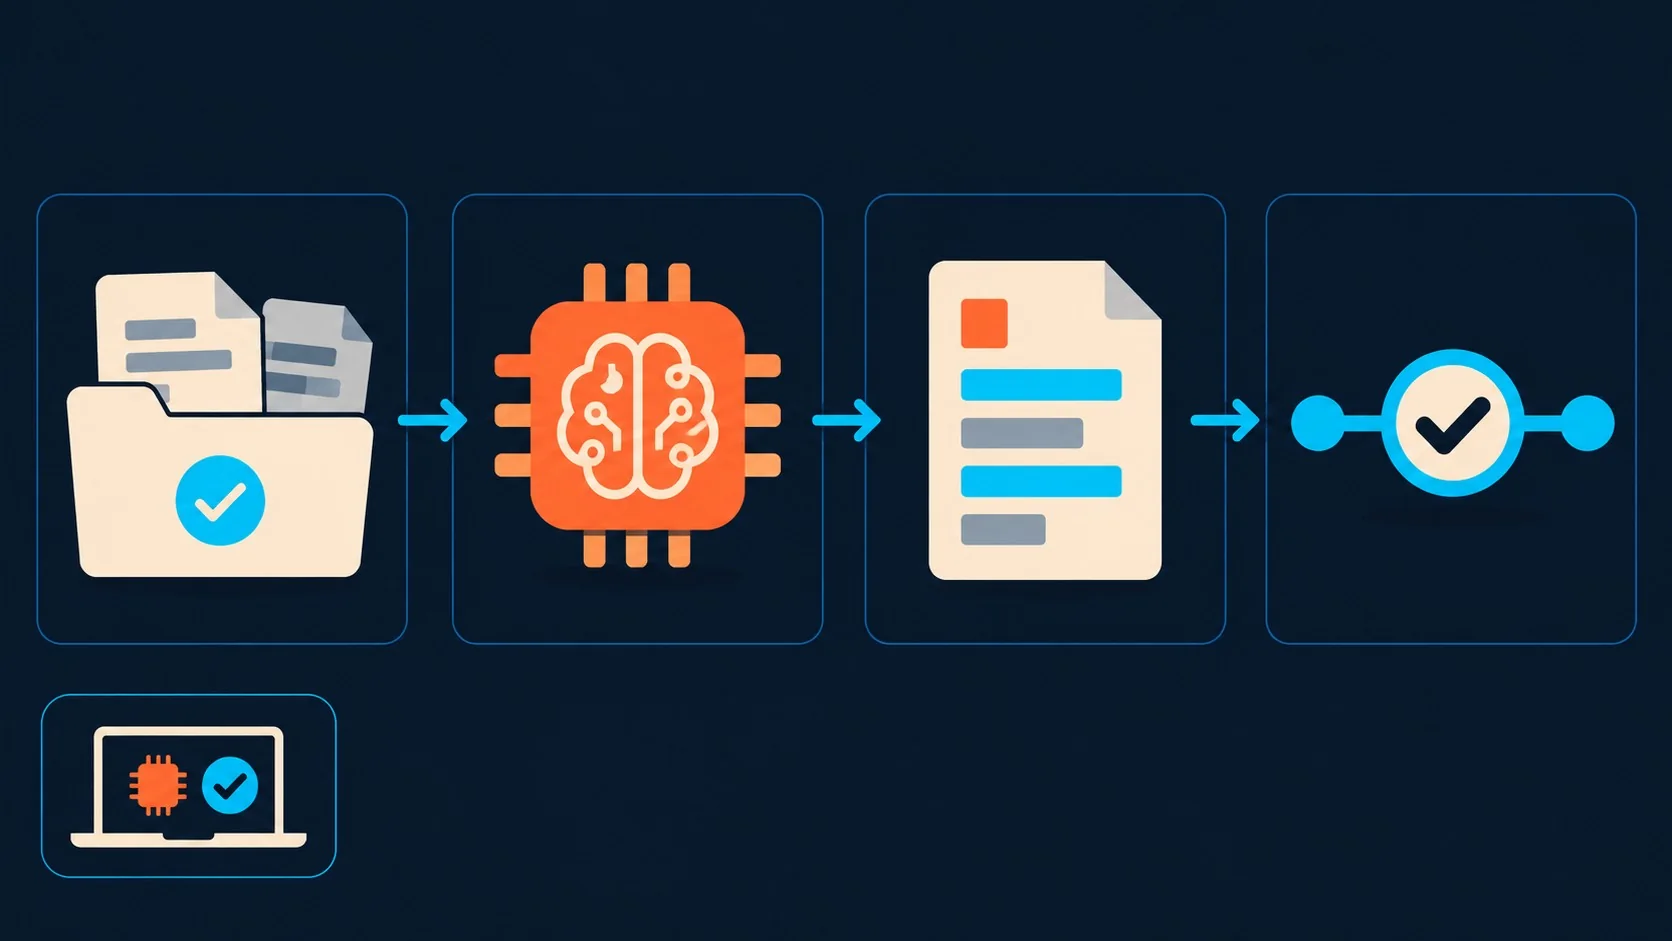
lazycommit usa por default Qwen2.5-Coder 0.5B Instruct, un modelo de unos 400 MB que corre sin problemas en la CPU de una laptop, sin necesidad de GPU. El tamaño chico es la clave de todo el diseño: no hace falta hardware especial ni mandar nada a un servicio externo para generar un mensaje de commit. Es, en cierto modo, lo opuesto a la tendencia de “modelo más grande es siempre mejor” que domina buena parte de la conversación sobre IA generativa.
El CLI habla con cualquier servidor que implemente la API de chat de OpenAI, lo cual incluye Ollama, llama.cpp y LM Studio. No hay acoplamiento a un proveedor específico: si mañana sale un modelo mejor, según explica el autor, alcanza con cambiar una variable de entorno (LAZYCOMMIT_MODEL) para apuntar a otro.
Las licencias están separadas a propósito. El código de la aplicación es MIT; los pesos del modelo mantienen su propia licencia Apache-2.0. Esa separación le permite a quien use la herramienta auditar exactamente qué está corriendo, revisar la ficha del modelo y decidir con qué servidor open-source lo ejecuta. Nada de cajas negras ni de “confiá en nosotros”.
¿Cómo instalar lazycommit para generar commit messages con IA local?
Instalar lazycommit toma dos comandos si ya tenés Ollama instalado: primero el CLI, después el modelo. No hace falta cuenta, API key ni configuración adicional.
- Instalá el CLI con
pip install git+https://github.com/MRNOWSHIRWAN/lazycommit.git, directo desde el repositorio. - Bajá el modelo con
ollama pull qwen2.5-coder:0.5b-instruct, unos 400 MB de descarga. - Levantá el servidor con
ollama serve, que escucha enhttp://localhost:11434/v1por defecto. - Corré lazycommit dentro de cualquier repo Git con cambios staged, y la herramienta te va a mostrar la sugerencia en pantalla.
Por default, lazycommit solo imprime el mensaje sugerido y no toca nada. Si querés que confirme el commit directamente, agregás la flag --commit. Es una decisión de diseño deliberada: separar “sugerir” de “ejecutar” para que el modo rápido no se lleve puesto nada sin que lo mires antes.
Si usás llama.cpp en vez de Ollama, el comando cambia a llama-server --model qwen2.5-coder-0.5b-instruct-q4_k_m.gguf --port 8080 y hay que exportar LAZYCOMMIT_BASE_URL=http://localhost:8080/v1.
¿Cómo escribió lazycommit tres commits reales en la demo del autor?
En la demo que publicó el autor, lazycommit generó tres mensajes de commit consecutivos sobre un repositorio de prueba con un escáner de puertos chico, acertando el tipo correcto las tres veces. El resultado quedó documentado así en el git log:
feat: add timeout option to portscan, para la feature nueva.docs: add README with project description, para la documentación.test: add test for localhost closed port, para el test agregado.
Cada mensaje tardó cerca de 2 segundos en generarse, corriendo sobre una VM de 2 cores con el modelo en CPU. El propio autor aclara algo que vale la pena remarcar: eso es un resultado medido en esa máquina puntual, no un benchmark formal. No hay garantía de que se repita igual en otro hardware o con diffs más complejos, y conviene leerlo con esa cautela.
¿Cómo logró acertar el tipo correcto las tres veces con un modelo tan chico? La respuesta está en el prompt: tres ejemplos cortos (uno de feat, uno de docs, uno de test) que guían al modelo. Sin el ejemplo de docs, el 0.5B clasificaba un cambio al README como feat. Con el ejemplo puesto, acertó. Es un recordatorio útil más allá de este proyecto puntual: con modelos chicos, un ejemplo concreto suele rendir más que un párrafo de instrucciones abstractas.
¿Te conviene usar lazycommit? Algunos criterios para decidir
No hace falta adivinar: con los datos que el propio proyecto expone, se pueden armar algunos criterios razonables para saber si esta herramienta tiene sentido en tu flujo o no.
- Trabajás con código que no querés que salga de tu máquina. Si tu diff staged incluye lógica de negocio sensible, credenciales de ejemplo o simplemente código de un repo privado que no querés mandar a ningún API de terceros, el enfoque 100% local de lazycommit resuelve exactamente eso.
- Hacés muchos commits chicos por día. Cuanto más seguido escribís mensajes de commit, más rinde automatizar la parte mecánica. Si commiteás una o dos veces por semana, el ahorro es marginal.
- Tus diffs tienden a ser acotados y de un solo propósito. El pipeline recorta diffs grandes para que entren en la ventana de contexto de un modelo chico, así que cuanto más grande y mezclado sea el cambio, más chance hay de que se pierda matiz. Separar cambios con
git add -payuda bastante acá. - Estás dispuesto a leer el mensaje antes de pushear. Esto no es opcional: un modelo de 0.5B acierta la mayoría de las veces, pero “la mayoría” no es “siempre”. Si vas a usar
--commita ciegas, mejor no lo uses. - Ya tenés (o podés instalar) Ollama, llama.cpp o LM Studio. Si tu equipo trabaja en Windows corporativo sin permisos para instalar nada, el setup local puede ser más fricción que la que ahorra la herramienta.
Si varios de estos puntos te cierran, probarlo tiene poco costo: es gratis, corre offline y el peor escenario es que termines escribiendo el mensaje vos mismo, como ya hacías antes.
¿Qué límites tiene un modelo de 0.5B para esta tarea?
Un modelo de 0.5B parámetros no es infalible, y el propio autor lo dice sin vueltas: acierta el tipo y el asunto del commit la mayoría de las veces, pero no siempre. Por eso el modo default de lazycommit solo imprime la sugerencia en pantalla, nunca commitea solo. “Being lazy is the goal; being careless is not” (“ser vago es el objetivo, ser descuidado no”), resume el autor en su publicación original.
El pipeline interno tiene varios resguardos pensados justamente para compensar las limitaciones de un modelo chico. El diff se recorta si es muy grande, para que entre en la ventana de contexto sin perder el nombre de cada archivo tocado. La salida se limpia de comillas, bloques de markdown y frases tipo “Commit message:” antes de mostrarla. Si después de limpiar no queda nada usable, la herramienta no inventa un mensaje de la nada: directamente avisa que hay que escribirlo a mano.
Hay 15 tests con pytest que cubren las reglas de limpieza, el recorte del diff, el cliente HTTP contra un servidor falso y el flujo completo en un repositorio Git temporal, y todos pasan según el repositorio publicado en GitHub. Eso no garantiza que el mensaje siempre sea perfecto, pero sí que el pipeline no se rompe silenciosamente cuando algo no sale como se espera.
¿Por qué usar un modelo open-weight en vez de una API en la nube?
Usar un modelo open-weight evita que tu diff staged —que es exactamente el código que todavía no publicaste— salga de tu máquina hacia un servicio externo. El autor lo plantea como el argumento central del proyecto: sin cuenta, sin API key, sin términos de servicio que leer, sin costo por request.
Pensalo en términos prácticos: subís cambios sensibles a un repo privado, corrés tu generador de mensajes favorito, y si ese generador manda el diff a un servidor de terceros, ya perdiste el control sobre dónde queda esa información, aunque sea por un instante. Con un modelo local, el diff nunca sale del disco; es una garantía estructural, no una política de privacidad que podrías leer o no.
Trabajar offline, en un tren o sin conexión, también entra en el paquete. Y hay un punto que no es menor: el código abierto le permitió al autor leer la ficha del modelo, chequear la licencia, bajar el archivo exacto y correrlo con un servidor open-source como llama.cpp. Nada de depender de que un proveedor externo siga existiendo en cinco años para que la herramienta funcione; los pesos quedan en el disco, tal cual están hoy.
Errores comunes al usar lazycommit
- Confiar el modo
--commitsin revisar antes. El autor mismo advierte que lee cada mensaje antes de pushear. Usar la flag que commitea directo sin mirar el resultado anula la única salvaguarda real del proyecto. - Dejar diffs gigantes sin stagear por partes. Un diff enorme se recorta automáticamente para entrar en el contexto del modelo chico, y eso puede cortar información relevante. Stagear cambios en bloques lógicos (con
git add -p) da mejores resultados, como se ve en el ejemplo hipotético más arriba. - Esperar que un modelo de 0.5B escriba commits perfectos siempre. Acierta el tipo y el asunto la mayoría de las veces, no todas. Tratarlo como oráculo infalible es pedirle algo que el propio autor nunca prometió.
- Olvidarse de levantar el servidor local antes de correr el CLI. Si Ollama (o llama.cpp) no está corriendo en el puerto configurado, lazycommit no tiene con quién hablar y falla directo.
Preguntas Frecuentes
¿Cómo funciona lazycommit para generar mensajes de commit?
lazycommit lee el resultado de git diff --cached (solo los cambios staged), lo recorta si es muy grande y se lo manda a un modelo local vía la API de chat de OpenAI. El modelo devuelve un mensaje en formato Conventional Commits, que el CLI limpia de comillas y marcas de markdown antes de mostrarlo.
¿Qué modelo de IA usa lazycommit?
El modelo default es Qwen2.5-Coder 0.5B Instruct, de unos 400 MB, que corre en CPU sin necesidad de GPU. Se puede cambiar por otro modelo seteando la variable de entorno LAZYCOMMIT_MODEL, siempre que el servidor lo soporte.
¿Es seguro usar un modelo local para leer mi código antes de hacer commit?
Sí, porque el diff nunca sale de tu máquina: el modelo corre en un servidor local (Ollama, llama.cpp o LM Studio) sin conexión a servicios externos, sin cuenta ni API key. Eso evita exponer código que todavía no publicaste a un tercero.
¿Cómo instalo lazycommit con Ollama?
Corré pip install git+https://github.com/MRNOWSHIRWAN/lazycommit.git para instalar el CLI, después ollama pull qwen2.5-coder:0.5b-instruct para bajar el modelo y ollama serve para levantar el servidor en http://localhost:11434/v1. Con eso ya podés correr lazycommit dentro de cualquier repo con cambios staged.
¿lazycommit reemplaza la revisión manual del mensaje de commit?
No, y el propio autor lo deja claro: el modo default solo imprime la sugerencia, nunca commitea solo. La idea es que leas el mensaje generado antes de pushear, porque un modelo de 0.5B acierta la mayoría de las veces pero no siempre.
Conclusión
lazycommit no inventa una categoría nueva —automatizar mensajes de commit con IA ya existía antes—, pero sí pone el foco en un lugar poco común: en vez de competir por calidad máxima con un modelo gigante en la nube, apuesta por un modelo mínimo que corre local y nunca ve tus datos salir del disco. Para quien maneja código sensible, no quiere depender de un API externo o simplemente prefiere no pagar por cada mensaje de commit, esa apuesta tiene sentido concreto, no solo filosófico.
Si vas a probarlo, el camino lógico según los propios criterios del proyecto es: instalá el CLI, bajá el modelo con Ollama, y corré lazycommit sin la flag --commit las primeras veces. Fijate qué tan bien clasifica tus propios diffs —sobre todo si tenés el hábito de mezclar varios cambios en un solo commit— antes de confiarle el commit directo. Es gratis, corre offline, y si el modelo de 0.5B no te convence, cambiar a uno más grande es una sola variable de entorno.