En pocas palabras: Afonso Faro, de 16 años, entrenó solo Ganymede 1.1, un modelo MoE de 780.000 millones de parámetros (20B activos por token), publicado el 21 de octubre de 2026 bajo su laboratorio Merkium, usando más de 450 GPUs H200 y disponible gratis vía chat y API compatible con OpenAI.
Afonso Faro tiene 16 años y durante el último año entrenó solo, bajo un laboratorio propio llamado Merkium, un modelo de lenguaje de 780.000 millones de parámetros llamado Ganymede 1.1. Lo contó él mismo en un posteo publicado en Dev.to el 21 de octubre de 2026, sin equipo grande ni presupuesto de big tech.
Ganymede 1.1 es un modelo de lenguaje tipo mixture of experts (MoE) con 780B parámetros totales, de los cuales solo unos 20B se activan por cada token procesado. Tiene ventana de contexto de 1 millón de tokens, razonamiento siempre activo, soporte de streaming y tool calling, y hoy está disponible gratis vía chat y API compatible con OpenAI.
En este artículo:
- En 30 segundos
- ¿Qué es un modelo mixture of experts (MoE) y por qué lo eligió para ahorrar cómputo?
- ¿Qué infraestructura usó para entrenar un modelo de este tamaño?
- ¿Qué errores y aprendizajes reconoció durante el año de entrenamiento?
- ¿Qué medidas de seguridad incorporó en la versión 1.1?
- ¿Qué puede hacer hoy Ganymede 1.1 y cómo probarlo?
- ¿Qué limitaciones tiene este relato y qué falta verificar de forma independiente?
- Qué está confirmado y qué no
- Errores comunes al leer este tipo de anuncios
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Afonso Faro, de 16 años, entrenó Ganymede 1.1, un modelo MoE de 780B parámetros totales con solo ~20B activos por token.
- El pretraining usó unos 5 billones (trillion en inglés) de tokens de texto web público y código open source.
- El entrenamiento corrió en más de 450 GPUs H200 distribuidas en centros de datos de Francia, Portugal y los Países Bajos.
- Ganymede 1.1 tiene ventana de contexto de 1M tokens, razonamiento siempre activo y API gratuita con límite de 30 requests por minuto.
- El relato es autopublicado por el propio autor, sin benchmarks ni auditoría externa que confirmen las cifras.
¿Qué es un modelo mixture of experts (MoE) y por qué lo eligió para ahorrar cómputo?
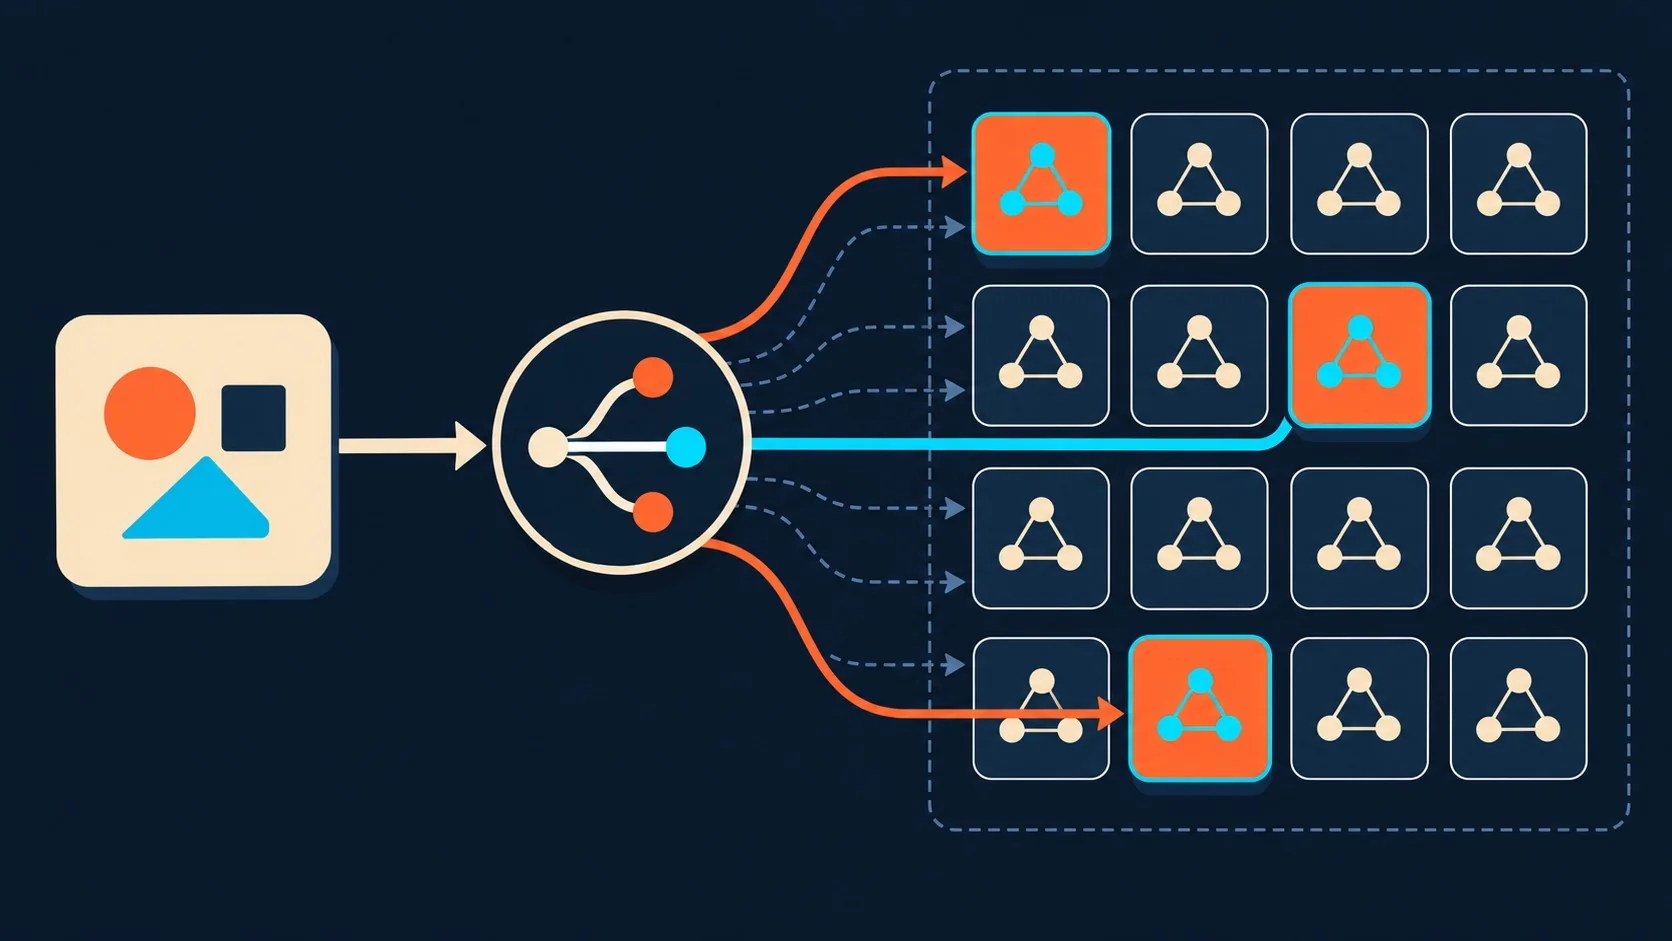
Un modelo mixture of experts (MoE) divide la red en varios subgrupos de parámetros llamados “expertos”, y un router decide cuáles de esos expertos procesan cada token. En Ganymede 1.1 esto significa 780B parámetros totales, pero solo unos 20B activos en cualquier inferencia dada, según detalla Faro en su propio relato.
Ponele que necesitás la capacidad de un modelo gigante pero no podés pagar el cómputo de uno. Esa es exactamente la cuenta que hizo Faro: con arquitectura sparse (dispersa) conseguís la capacidad de un modelo enorme pagando el costo de entrenamiento y de servido de uno mucho más chico. Para alguien sin el presupuesto de un laboratorio grande, él mismo lo dice sin vueltas: era la única forma realista de encarar un proyecto de este tamaño.
¿Y por qué no entrenar un modelo denso directamente? Porque un denso de 780B activaría los 780B parámetros en cada token, lo que multiplica el costo de cómputo por decenas. La arquitectura MoE no es nueva (la vienen usando varios labs open-weight), pero que un adolescente la aplique por su cuenta para un proyecto personal es lo que le da color a la nota.
¿Qué infraestructura usó para entrenar un modelo de este tamaño?
Faro entrenó Ganymede en más de 450 GPUs H200 repartidas en centros de datos de Francia, Portugal y los Países Bajos, con un dataset de pretraining de unos 5 billones de tokens de texto web público y código open source. Esto lo describe directamente en la fuente original.
Coordinar cómputo entre tres países no es gratis en términos de complejidad: latencia entre nodos, sincronización de gradientes, fallas que aparecen en un data center y no en otro. El propio autor admite que sumó dificultad operativa, pero que fue el único camino para conseguir la cantidad de cómputo que necesitaba. Dicho de otra forma: no tenía un único clúster propio, así que armó uno distribuido con lo que pudo acceder. Si te interesa entender mejor qué hay detrás de este tipo de arquitecturas, repasamos cómo funcionan los modelos de lenguaje en otra nota.
Eso sí: la fuente no detalla cuánto costó en dólares esa infraestructura, ni quién la proveyó ni bajo qué modalidad (renta por hora, acuerdo con algún proveedor cloud, etc). Es un dato relevante que falta y que cualquier lector técnico va a querer antes de replicar algo parecido.
¿Qué errores y aprendizajes reconoció durante el año de entrenamiento?
Faro reconoce que la limpieza de datos le llevó más tiempo que el entrenamiento mismo, y que no reinventó todo: adaptó componentes de diseños MoE open-weight ya publicados, aclarando que Ganymede no es un fine-tune de otro modelo.
- La limpieza de datos tomó más de lo previsto: antes de meter los 5T tokens al entrenamiento, corrió un filtro para sacar API keys e información personal del texto web y del código. Esperaba que fuera un paso rápido. No lo fue: ajustar el filtro para que detectara secretos reales sin tirar código útil le exigió mucha más iteración de la planeada.
- No reinventó la arquitectura desde cero: la base sigue diseños MoE open-weight ya publicados, y algunos componentes vienen adaptados de modelos abiertos existentes. Él mismo dice que ser transparente con esto importa, porque construir sobre trabajo publicado le ahorró meses.
¿Suena a que hizo todo desde la nada? No. Y la verdad es que está bien que lo diga así, con nombre y todo: la honestidad sobre de dónde viene la arquitectura es justo lo que falta en varios anuncios de modelos “propios” que en realidad son wrappers con otro nombre.
¿Qué medidas de seguridad incorporó en la versión 1.1?
En la versión 1.1, Faro agregó una jerarquía de instrucciones dentro del system prompt, para que el modelo sepa qué instrucciones tienen prioridad sobre otras, además de detección de intentos de jailbreak y de intentos de suplantar la identidad del modelo.
El argumento que usa es simple: es mucho más fácil diseñar esto desde el arranque que parchearlo después de que alguien encuentra el agujero. Tiene sentido si pensás en cómo funcionan la mayoría de los jailbreaks conocidos en modelos grandes: no explotan un bug puntual, explotan la ausencia de una jerarquía clara entre lo que dice el sistema y lo que pide el usuario.
Ahora bien, ninguna de estas protecciones fue auditada por terceros. No hay un red team independiente que haya probado romper Ganymede 1.1 y publicado resultados. Es una medida razonable en el diseño, pero su efectividad real todavía no tiene evidencia pública más allá de la palabra del autor.
¿Qué puede hacer hoy Ganymede 1.1 y cómo probarlo?
Ganymede 1.1 es un modelo de razonamiento general con ventana de contexto de 1 millón de tokens, razonamiento siempre activo, y soporte para streaming y tool calling. Hoy es gratis, tanto en chat como vía API compatible con OpenAI, con un límite de 30 requests por minuto por key.
Se puede probar en chat.merkium.nl, y la documentación técnica (para quien quiera integrarlo con sus propias herramientas vía API) está en merkium.nl/docs. Que sea compatible con el formato de OpenAI es un detalle práctico: significa que gran parte del tooling existente (SDKs, frameworks de agentes) funciona sin reescribir nada.
Si alguna vez armaste un proyecto propio y necesitaste exponerlo al mundo con una API, sabés que el modelo en sí es solo una parte de la ecuación. Hace falta dónde correr el backend, dominio, certificados. Para proyectos de ese tamaño (sin pretender 450 GPUs distribuidas, obviamente) un hosting como donweb.com alcanza de sobra para levantar un dominio y un servidor que hable con una API externa.
¿Qué limitaciones tiene este relato y qué falta verificar de forma independiente?
Todo lo que sabemos de Ganymede 1.1 viene de un solo posteo autopublicado por Afonso Faro en Dev.to. No hay benchmarks independientes, ni tercero que haya corrido evaluaciones estándar (MMLU, GSM8K, lo que sea) sobre el modelo, ni auditoría externa de las cifras de parámetros, cómputo o rendimiento que él mismo reporta. Complementá con lo que logró el equipo de Sora.
¿Significa que está mintiendo? No necesariamente. Significa que, por ahora, las cifras de 780B parámetros totales, 20B activos, 5T tokens de entrenamiento y 450+ GPUs H200 son afirmaciones del autor, no hechos confirmados por un tercero. La única forma de verificarlas de manera práctica es probando el modelo vos mismo en el chat o la API y comparando su comportamiento contra modelos conocidos en tareas de razonamiento largo, uso de herramientas y resistencia a jailbreaks, sin tomar el anuncio como dato cerrado.
Qué está confirmado y qué no
- Confirmado por el autor: arquitectura MoE, 780B parámetros totales con ~20B activos, dataset de ~5T tokens, entrenamiento en 450+ H200, contexto de 1M tokens, acceso gratuito vía chat y API.
- No confirmado por terceros: benchmarks de rendimiento comparados con otros modelos, eficacia real de las protecciones contra jailbreak, costo total del proyecto, identidad verificable del equipo de Merkium más allá del propio Faro.
Errores comunes al leer este tipo de anuncios
- Confundir parámetros totales con parámetros activos: decir que Ganymede “es un modelo de 780B” sin aclarar que solo 20B se activan por token da una idea equivocada de qué tan pesado es correrlo en inferencia.
- Tomar las cifras de cómputo como verificadas: 450+ H200 y 5T tokens son datos que vienen únicamente del autor. Tratarlos como si vinieran de un paper revisado por pares es un error de lectura, no un hecho.
- Asumir que “no es un fine-tune” significa que todo es original: el propio Faro aclara que adaptó componentes de diseños MoE ya publicados. No reinventar la rueda está bien, pero hay que leer esa aclaración con atención antes de asumir que todo salió de cero.
Preguntas Frecuentes
¿Quién es Afonso Faro y qué es Ganymede 1.1?
Afonso Faro es un joven de 16 años que fundó el laboratorio Merkium y entrenó Ganymede 1.1, un modelo de lenguaje tipo mixture of experts de 780B parámetros totales con ~20B activos por token. Lo contó en un posteo propio publicado en Dev.to el 21 de octubre de 2026.
¿Qué es un modelo mixture of experts (MoE)?
Un modelo MoE divide sus parámetros en subgrupos llamados expertos y usa un router que decide cuáles procesan cada token, en vez de activar toda la red de una sola vez. Esto permite tener la capacidad de un modelo muy grande pagando el costo de cómputo de uno mucho más chico.
¿Cuántos parámetros tiene realmente activos el modelo Ganymede?
Ganymede 1.1 activa aproximadamente 20B parámetros por token procesado, aunque el modelo completo suma 780B parámetros totales distribuidos entre todos sus expertos. Esa diferencia es lo que hace viable entrenarlo y servirlo sin infraestructura de big tech. En auditorías de código entre modelos rivales profundizamos sobre esto.
¿Se puede entrenar un modelo de lenguaje grande sin el presupuesto de una big tech?
Según el relato de Faro, sí es posible usando arquitectura sparse (MoE) y cómputo distribuido entre varios centros de datos, en su caso más de 450 GPUs H200 repartidas en Francia, Portugal y los Países Bajos. Eso sí, requirió un año de trabajo y bastante iteración, sobre todo en la limpieza de datos.
¿Cómo acceder al chat o a la API de Ganymede 1.1?
Ganymede 1.1 está disponible gratis en chat.merkium.nl para uso directo, y también vía API compatible con OpenAI con un límite de 30 requests por minuto por key. La documentación técnica está en merkium.nl/docs.
Conclusión
Lo que publicó Afonso Faro es, en esencia, la prueba de que un proyecto de un solo adolescente puede llegar a una escala de 780B parámetros usando arquitectura sparse y cómputo distribuido, algo que hace pocos años parecía reservado solo a laboratorios con cientos de millones de dólares. El dato concreto, 20B parámetros activos sobre 780B totales, 5T tokens de entrenamiento, 450+ GPUs H200 en tres países, viene todo de la misma fuente: el propio autor.
Si te interesa probarlo, la forma más honesta de evaluarlo es meterle tareas reales de razonamiento largo o tool calling en el chat o la API, y comparar contra modelos que ya conocés, en vez de quedarte solo con las cifras del posteo. Eso te da una base propia de verificación, mientras esperamos que aparezcan benchmarks independientes que confirmen (o no) lo que cuenta Merkium.