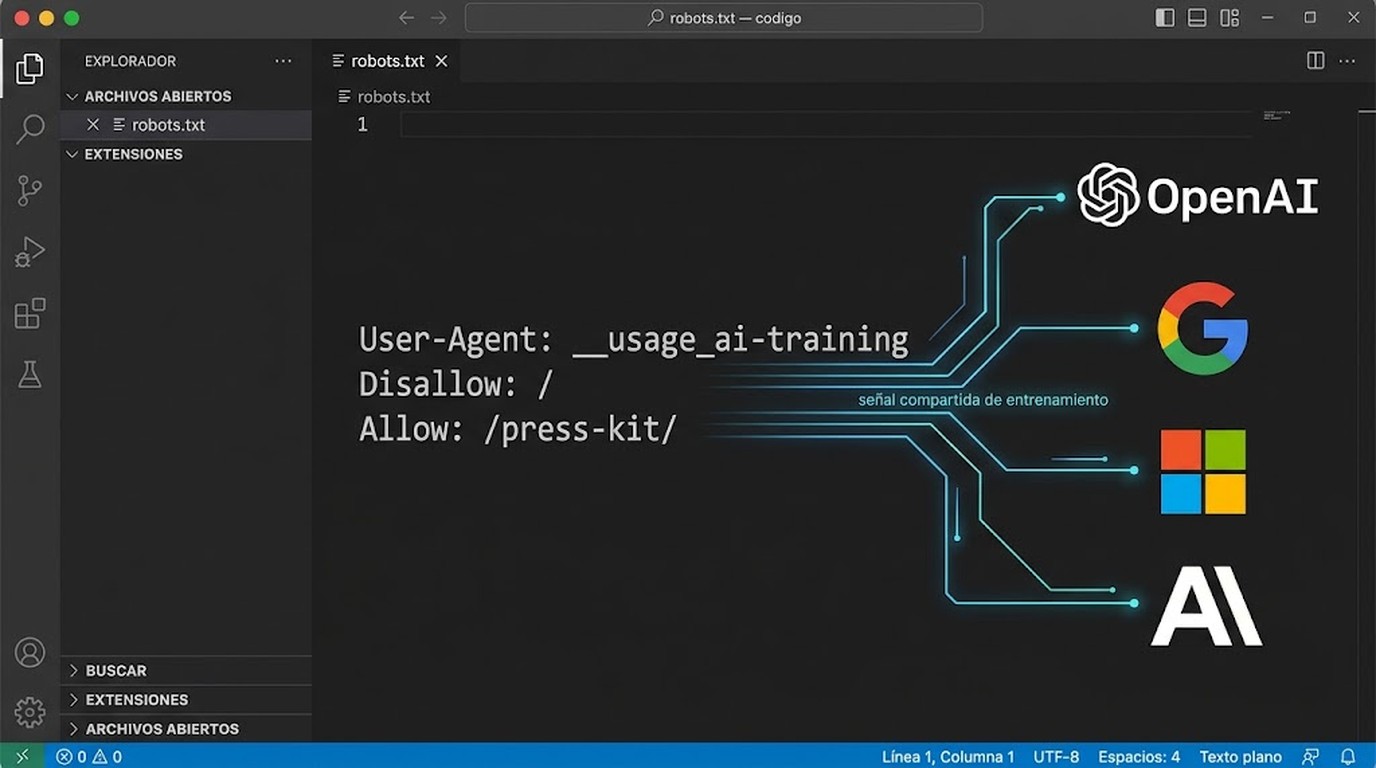
En pocas palabras: OpenAI, Google, Microsoft y Anthropic acordaron el 30 de octubre de 2026 respetar el token __usage_ai-training en robots.txt para que los sitios bloqueen el entrenamiento de IA en las cuatro plataformas con una sola línea. Anthropic ya lo implementó; OpenAI, Google y Microsoft lo sumarán entre los próximos meses y 2027.
OpenAI, Google, Microsoft y Anthropic anunciaron el 30 de octubre de 2026 que van a respetar un mismo token en robots.txt, __usage_ai-training, para que cualquier sitio exprese con una sola línea su preferencia sobre el entrenamiento de IA en las cuatro plataformas a la vez. Anthropic ya empezó a implementarlo. OpenAI, Google y Microsoft recién lo van a sumar entre los próximos meses y 2027.
El token __usage_ai-training es una línea de preferencia dentro del archivo robots.txt, definida en un Internet-Draft de Kevin Kelley, de Anthropic, publicado el 30 de octubre de 2026, que permite a un sitio declarar si acepta o rechaza que su contenido se use para entrenar modelos de IA generativa. No reemplaza los controles por bot que ya existen, como GPTBot, Google-Extended o ClaudeBot: los complementa.
En este artículo:
- En 30 segundos
- ¿Qué es el token __usage_ai-training y cómo funciona en robots.txt?
- ¿Qué empresa ya implementó el token y cuáles lo harán en 2027?
- ¿El token bloquea el rastreo (crawling) o solo el uso para entrenamiento?
- ¿Qué pasa con los controles existentes como GPTBot, Google-Extended y ClaudeBot?
- ¿Qué límites tiene esta señal voluntaria de robots.txt?
- Cómo configurar el token __usage_ai-training en el robots.txt de un sitio
- Qué está confirmado y qué todavía no
- Errores comunes al configurar la nueva preferencia de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- OpenAI, Google, Microsoft y Anthropic confirmaron el 30/10/2026 que van a leer el token __usage_ai-training en robots.txt para decidir qué contenido entra al entrenamiento.
- Anthropic ya empezó a implementarlo. Google apunta a principios de 2027, OpenAI habla de “los próximos meses” y Microsoft menciona 2027 (AI Weekly cita puntualmente el 1° de febrero de 2027).
- El token no bloquea el rastreo: un bot puede seguir leyendo la página, solo cambia si ese contenido se puede usar para entrenar un modelo.
- Es un Internet-Draft individual del IETF, sin aval formal, que vence el 3 de mayo de 2027 si nadie lo renueva.
- Si usás el token sin una regla explícita para Google-Extended, Google va a interpretarlo como un bloqueo a Google-Extended, lo que también afecta el grounding en Gemini.
¿Qué es el token __usage_ai-training y cómo funciona en robots.txt?
El token __usage_ai-training es una etiqueta que se escribe en la línea User-Agent de un grupo normal de robots.txt, sin inventar sintaxis nueva ni romper las reglas de RFC 9309 que ya usa cualquier archivo robots.txt del planeta. El borrador, titulado “Machine-Readable Training Preference Signal”, lo deja bien claro: ni gramática nueva, ni directivas nuevas, ni cambios en cómo se resuelve la precedencia entre rutas.
El ejemplo que trae el propio documento es este:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Con esas tres líneas, un sitio dice “no quiero que mi contenido se use para entrenar modelos de IA, excepto lo que está en /press-kit/”. Fijate que el mecanismo reutiliza Disallow y Allow con un significado nuevo: ya no hablan de qué puede rastrear un bot, hablan de qué preferencia de uso tiene el operador del sitio sobre ese contenido.
Ojo con un detalle que mucha gente va a pasar por alto: si tu robots.txt solo tiene un grupo con User-Agent: *, eso no cuenta como preferencia bajo este draft. Necesitás un grupo que nombre explícitamente __usage_ai-training. Lo explicamos a fondo en todo lo que necesitás saber sobre Sora.
¿Qué empresa ya implementó el token y cuáles lo harán en 2027?
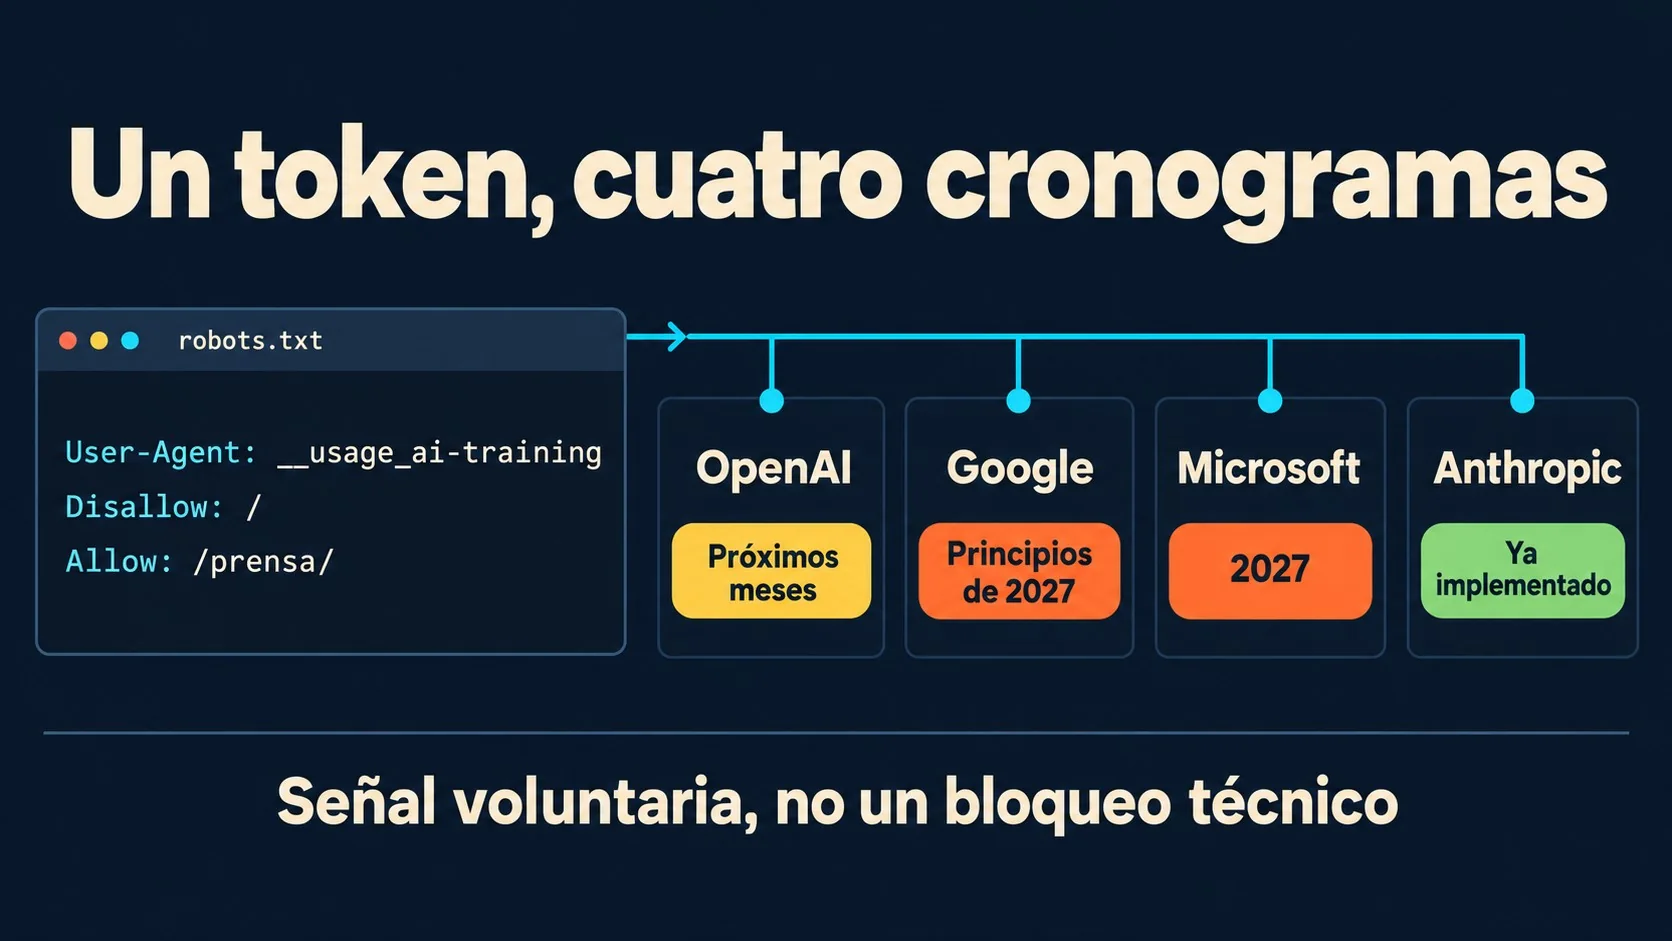
Anthropic es la única de las cuatro que ya empezó a implementar soporte para el token, según las declaraciones del propio 30 de octubre. Las otras tres tienen cronogramas que se estiran hasta bien entrado 2027, y ninguna publicó todavía la fecha exacta en la que cada pipeline de entrenamiento va a leer la señal en producción.
Google es la que dejó la postura más escrita en piedra: su documentación de rastreadores dice que planea sumar soporte a principios de 2027, según el detalle técnico publicado por DataStudios. OpenAI, en cambio, dijo que apunta a implementarlo en los próximos meses y que va a publicar detalles técnicos recién cuando esté listo. Microsoft habla de 2027 en general, aunque AI Weekly reportó una fecha puntual, el 1° de febrero de 2027.
| Empresa | Estado | Cronograma | Control existente que sigue funcionando |
|---|---|---|---|
| Anthropic | Implementación en curso | Ya empezó | ClaudeBot |
| Planificado | Principios de 2027 | Google-Extended | |
| OpenAI | Planificado | Próximos meses | GPTBot |
| Microsoft | Planificado, con ajuste separado para grounding | 2027 (1° de febrero según AI Weekly) | Controles existentes de Bing |
Ninguna de las cuatro confirmó si la preferencia se va a aplicar sobre datasets que ya existen. Esa es la pregunta que de verdad define cuánto cambia esto en la práctica, y por ahora nadie la contestó.
¿El token bloquea el rastreo (crawling) o solo el uso para entrenamiento?
El token no bloquea el rastreo. Solo expresa una preferencia sobre el uso del contenido para entrenamiento, y el propio borrador lo dice de forma textual: “esta señal no es una directiva para el comportamiento de rastreo”. Un bot puede seguir visitando tu página igual que siempre, lo que cambia es si ese contenido queda habilitado para alimentar el entrenamiento de un modelo.
¿Y entonces qué pasa con el “grounding”, esa recuperación en vivo que usan los chatbots para traer contenido fresco a una respuesta? Ahí está el matiz más interesante de todo el anuncio: Microsoft planea agregar un ajuste separado para distinguir entrenamiento de grounding, algo que hoy no existe en ningún control por bot. Google, en cambio, mezcla las dos cosas bajo el mismo paraguas de Google-Extended, lo que genera un problema concreto que explico abajo. En las auditorías de código que realizamos profundizamos sobre esto.
¿Qué pasa con los controles existentes como GPTBot, Google-Extended y ClaudeBot?
Los controles por bot siguen funcionando exactamente igual, y las cuatro empresas lo confirmaron: nadie va a desactivar GPTBot, Google-Extended ni ClaudeBot cuando el token entre en vigencia. Durante toda la transición, que para Google y Microsoft se extiende hasta 2027, las reglas específicas por rastreador van a ser la única vía realmente efectiva.
Acá viene el detalle que más le importa a cualquier medio que publique en la web: Google dijo que si un sitio expresa el opt-out a través del token compartido pero no tiene una regla explícita para Google-Extended, la empresa lo va a interpretar como si hubiera bloqueado Google-Extended directamente. El problema es que Google-Extended no solo controla entrenamiento, también gobierna el grounding en Gemini Apps y en Grounding with Google Search de Vertex AI. Un sitio que quiera rechazar el entrenamiento pero seguir siendo citado en respuestas de Gemini necesita, sí o sí, escribir una regla específica para Google-Extended en vez de confiar solo en el token nuevo.
¿Qué límites tiene esta señal voluntaria de robots.txt?
El límite más grande es que nada obliga a nadie a respetarla. El mecanismo es una señal de coordinación, no un control de acceso, algo que OpenAI mismo describió así en su comunicado, y cualquier scraper que hoy ignora robots.txt puede seguir ignorando el token exactamente de la misma manera.
El documento tampoco tiene peso formal: es un Internet-Draft individual, publicado el 30 de octubre de 2026 y con vencimiento el 3 de mayo de 2027 salvo que alguien lo renueve, y el propio IETF aclara que un draft individual “no cuenta con el respaldo formal de la organización ni tiene estatus oficial dentro de su proceso de estandarización”. Dicho de otra forma: es una propuesta en desarrollo, no una norma que algún organismo obligue a cumplir. Ya lo cubrimos antes en el chip que superó a Blackwell.
Dos cosas más que conviene tener claras. Primero, actualizar el robots.txt no borra nada de lo que ya está metido en un dataset o en los pesos de un modelo entrenado antes de esta fecha. Segundo, el propio borrador permite que acuerdos privados de licencia entre un medio y un proveedor anulen la preferencia expresada en el archivo, algo que ya venía siendo tema en las negociaciones entre editoriales y las grandes IA.
Cómo configurar el token __usage_ai-training en el robots.txt de un sitio
Configurarlo es agregar un grupo nuevo al robots.txt sin tocar nada de lo que ya tenías. Si administrás el hosting de tu sitio, podés acceder a ese archivo según las herramientas que ofrezca tu proveedor, sin necesidad de pasar por un desarrollador.
- Sumá un grupo nuevo, no reemplaces el existente. Dejá las reglas de GPTBot, Google-Extended y ClaudeBot tal como están y agregá abajo el bloque con __usage_ai-training.
- Usá Disallow: / si querés bloquear todo el sitio. Es la regla más general y cubre cualquier ruta que no tenga una excepción explícita.
- Agregá Allow para las carpetas que sí querés habilitar. Un caso típico es un directorio de prensa o materiales de difusión, como en el ejemplo oficial del draft.
- Revisá que no dependas solo de User-Agent: *. Ese comodín no cuenta como preferencia bajo este mecanismo, así que si tu archivo solo tiene eso, el token nuevo no va a servir de nada hasta que lo agregues de forma explícita.
- Si te importa Gemini, escribí una regla aparte para Google-Extended. El token solo no te protege del todo si querés seguir apareciendo en respuestas con grounding de Google.
Qué está confirmado y qué todavía no
Lo confirmado es el mecanismo técnico y la intención de las cuatro empresas de leerlo. Lo que no está confirmado es casi todo lo que importa para medir el impacto real.
- Confirmado: el token __usage_ai-training existe en un draft dateado y firmado, Anthropic ya empezó a implementarlo, y las cuatro empresas dijeron públicamente que lo van a respetar.
- Confirmado: los controles existentes por bot (GPTBot, Google-Extended, ClaudeBot) siguen activos y van a seguir siendo la vía efectiva mientras dure la transición.
- No confirmado: si la preferencia se va a aplicar a contenido ya recolectado antes de que cada empresa active su implementación.
- No confirmado: una fecha exacta de Google y OpenAI, más allá de “principios de 2027” y “próximos meses”.
- No confirmado: si algún otro proveedor de IA fuera de las cuatro firmantes va a sumarse a leer el mismo token.
Errores comunes al configurar la nueva preferencia de IA
- Borrar las reglas por bot pensando que el token nuevo ya las reemplaza. No las reemplaza: hasta que cada empresa active su implementación, son las únicas reglas que realmente funcionan.
- Confiar en User-Agent: * como si fuera un opt-out universal. Bajo este draft, un comodín genérico no cuenta como preferencia expresada; necesitás el grupo con el nombre exacto del token.
- Bloquear entrenamiento en Google sin pensar en el grounding. Como Google trata el opt-out del token como un bloqueo a Google-Extended, un sitio que quiera seguir citado en Gemini necesita una regla propia y específica para ese user-agent.
- Esperar que el cambio en robots.txt borre contenido viejo de algún dataset. El token solo afecta hacia adelante, nada en las reglas actuales promete retirar material ya usado en entrenamientos anteriores.
Preguntas Frecuentes
¿Qué es el token __usage_ai-training en robots.txt?
Es una etiqueta que se escribe en la línea User-Agent de un grupo de robots.txt para expresar si un sitio acepta o rechaza que su contenido se use en el entrenamiento de modelos de IA generativa. Lo definió Anthropic en un Internet-Draft publicado el 30 de octubre de 2026 y no cambia la sintaxis estándar de robots.txt. Relacionado: un modelo open source a una fracción del costo.
¿Cómo bloqueo que OpenAI, Google o Microsoft entrenen con mi contenido?
Hasta que las implementaciones de cada empresa estén activas, lo efectivo es mantener las reglas por bot (GPTBot, Google-Extended, ClaudeBot) además de agregar el nuevo grupo con __usage_ai-training y Disallow: /. Usar solo el token todavía no garantiza nada, porque Google recién lo lee desde principios de 2027 y Microsoft y OpenAI lo implementan en fechas similares.
¿Google, Microsoft y Anthropic ya respetan este nuevo estándar de robots.txt?
Solo Anthropic empezó a implementarlo, según el anuncio del 30 de octubre de 2026. Google apunta a principios de 2027, Microsoft habla de 2027 (con una fecha puntual del 1° de febrero según AI Weekly) y OpenAI dice que lo hará en los próximos meses sin precisar día.
¿Qué diferencia hay entre bloquear el entrenamiento y bloquear el rastreo de un bot de IA?
Bloquear el rastreo le impide a un bot visitar o leer una página, mientras que bloquear el entrenamiento solo le dice que no use ese contenido para ajustar los parámetros de un modelo. El token __usage_ai-training cubre exclusivamente el segundo caso: el borrador aclara que no es una directiva para el comportamiento de rastreo.
¿Cuándo entra en vigencia el nuevo token para bloquear entrenamiento de IA?
No hay una fecha única: Anthropic ya lo implementó al momento del anuncio, el 30 de octubre de 2026, mientras que Google, OpenAI y Microsoft lo van a activar en algún punto entre los próximos meses y 2027. El propio draft que define el token vence el 3 de mayo de 2027 si nadie lo renueva.
Conclusión
Lo que cambió el 30 de octubre no es que ahora el entrenamiento de IA sea controlable de forma perfecta, es que dejó de hacer falta mantener una lista separada de reglas por cada proveedor. Eso sí: la señal depende de que las cuatro empresas cumplan lo que dijeron, y todavía falta que Google, OpenAI y Microsoft terminen de implementarla.
Si administrás un sitio, lo razonable hoy es sumar el grupo con __usage_ai-training sin tocar las reglas existentes por bot, y prestar atención especial a Google-Extended si te importa seguir apareciendo en respuestas de Gemini. El resto (si realmente se respeta, si cubre datasets viejos, si se suman más proveedores) va a quedar más claro recién cuando cada empresa publique los detalles técnicos que todavía debe.
Fuentes
- DataStudios – Análisis técnico del Internet-Draft del token __usage_ai-training
- AI Weekly – Cronogramas de implementación de OpenAI, Google, Microsoft y Anthropic
- GeeksRoom – Cobertura del anuncio de OpenAI sobre la señal de entrenamiento
- DiarioBitcoin – Detalle del borrador y controles existentes de OpenAI