GitHub presentó GitHub Copilot Fusion el 28 de octubre de 2026 en GitHub Universe, San Francisco. El sistema orquesta modelos de Anthropic y OpenAI según la tarea y, en el Artificial Analysis Coding Agent Index, Fusion Max quedó dos puntos por debajo de Claude Opus 5.5 Max con la mitad del costo por tarea.
GitHub Copilot Fusion es un enrutador y orquestador en tiempo real dentro de GitHub Copilot que elige qué modelo usar para cada tarea de programación (razonamiento, generación de código, debugging o uso de herramientas) sin que el desarrollador tenga que decidirlo. Vos elegís un nivel de esfuerzo (Standard, High o Max) y Fusion resuelve el resto, según confirma la documentación oficial de GitHub.
En este artículo:
- En 30 segundos
- ¿Cómo elige Copilot Fusion qué modelo de IA usar en cada tarea?
- ¿Qué significan los niveles Standard, High y Max en Copilot Fusion?
- ¿Es cierto que Fusion Max igualó a Claude Opus 5.5 Max con la mitad del costo?
- ¿Qué limitaciones tiene la comparación entre Copilot Fusion y Claude Code?
- ¿Qué cambia esto para los equipos de desarrollo que usan GitHub Copilot?
- ¿De dónde viene Copilot Fusion? El origen en Project HydraFusion
- Qué está confirmado y qué no sobre Copilot Fusion
- Errores comunes al evaluar Copilot Fusion
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- GitHub lanzó Copilot Fusion el 28 de octubre de 2026 en GitHub Universe, ya disponible de forma general en VS Code, Copilot CLI, la app de GitHub Copilot y JetBrains.
- Fusion Max obtuvo 60 puntos en el Artificial Analysis Coding Agent Index v2.0, dos puntos por debajo de Claude Code con Opus 5.5 Max (62 puntos).
- El costo por tarea con Fusion Max fue de USD 5.59 contra USD 11.42 de Claude Code con Opus 5.5 Max, con 40% menos tiempo y la mitad de tokens (7.2 millones).
- Hasta el 30 de noviembre de 2026 hay un 30% de descuento en costo de modelos para quienes usen Fusion en planes pagos.
- Según Octoverse, los agentes iniciaron más del 40% de los pull requests en septiembre de 2026, contra 17% en marzo.
¿Cómo elige Copilot Fusion qué modelo de IA usar en cada tarea?
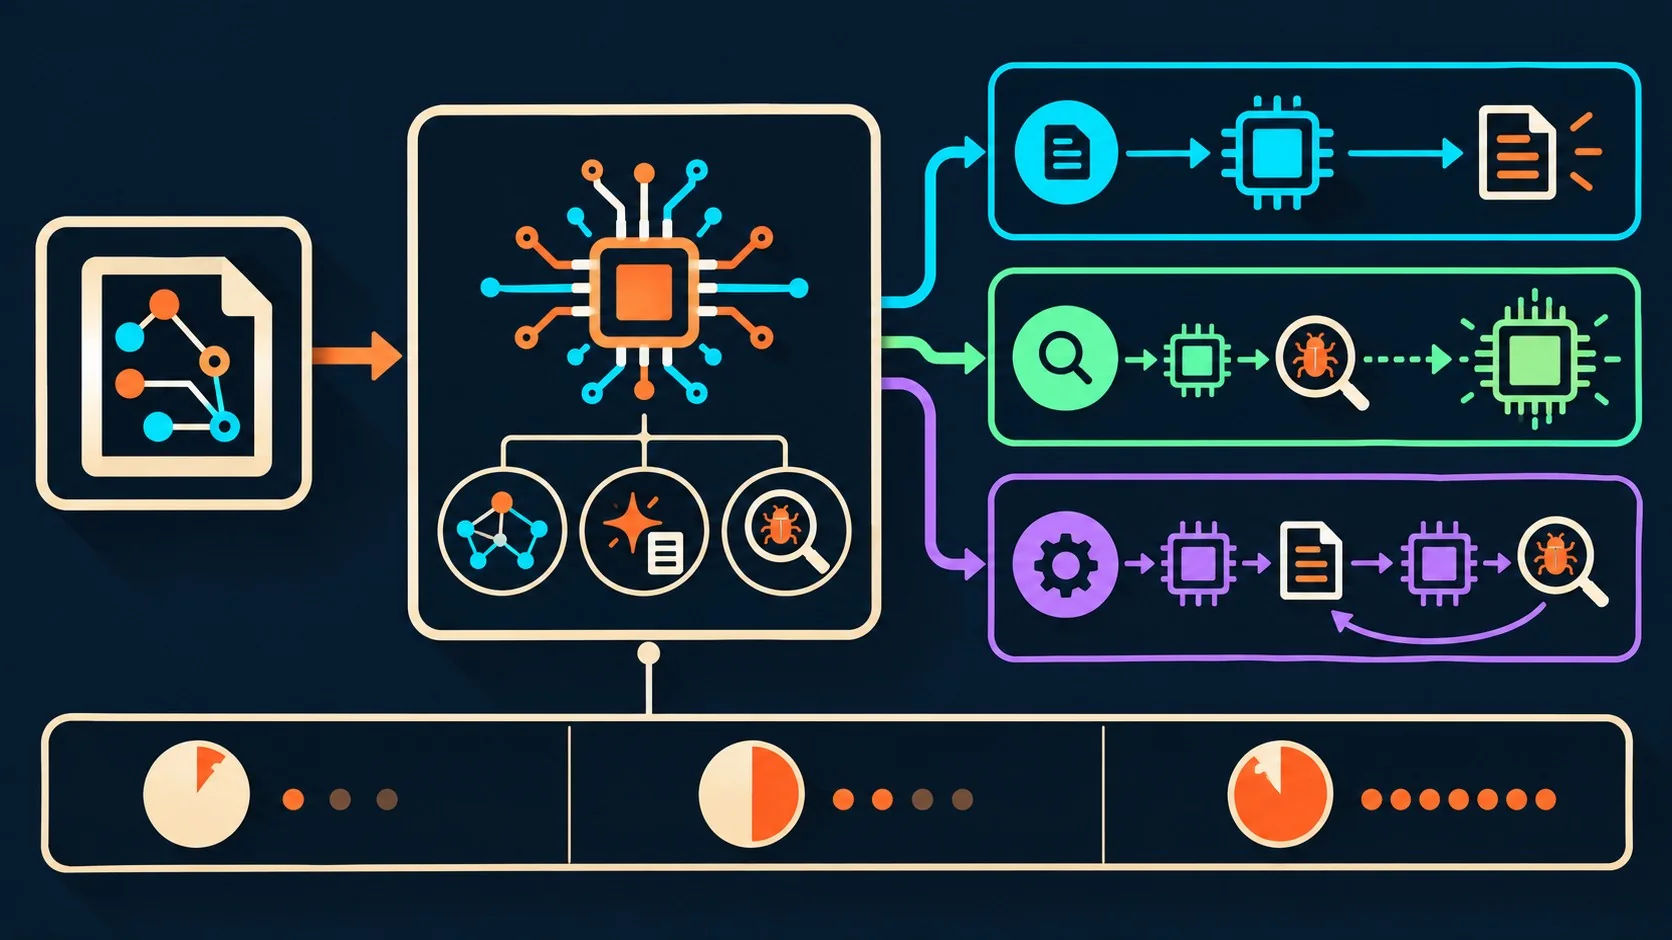
Fusion analiza cada pedido según cuatro señales: razonamiento, generación de código, debugging y uso de herramientas, y con eso decide el patrón de ejecución que va a usar. No hay un modelo fijo detrás: hay una decisión por prompt, y esa decisión puede cambiar entre un mensaje y el siguiente dentro de la misma sesión, según detalla The New Stack.
Son tres los patrones posibles. Uno es “single”, donde un solo modelo resuelve todo de punta a punta. Otro es “cascade”: un modelo eficiente redacta una solución y un juez decide si la acepta o la escala a un modelo más potente. El tercero es “critique”, donde un modelo arma la respuesta mientras otros la critican en paralelo y el primero revisa su trabajo con ese feedback combinado.
Ponele que le pedís un refactor simple de una función. Fusion probablemente use el patrón single con un modelo liviano. Ahora si le pedís depurar un bug que cruza varios archivos y dependencias, puede activar cascade o critique, sumando llamadas a modelos más caros solo cuando la tarea lo justifica. La propia documentación de GitHub aclara que una tarea simple no genera ni consume créditos de IA en una revisión innecesaria.
¿Qué significan los niveles Standard, High y Max en Copilot Fusion?
Standard, High y Max son los tres niveles de esfuerzo que vos elegís, mientras Fusion decide el modelo y el patrón de ejecución dentro de cada uno. Fusion Standard apunta a trabajo cotidiano con un solo modelo por tarea; Fusion High habilita orquestación con ahorro moderado de tokens para bugs complejos o cambios en varios archivos; Fusion Max prioriza la capacidad de punta sin perder de vista la eficiencia, para el trabajo que exige más análisis. En nuestra nota sobre si Cursor sigue siendo mejor opción que Copilot, profundizamos sobre esto.
Hay un cuarto nivel, Fusion Fast, pero ese no lo elegís vos: solo aparece en el chat inline de Visual Studio Code para escenarios que necesitan respuesta rápida.
Para equipos enterprise hay un detalle que importa bastante: los administradores pueden habilitar o deshabilitar modelos específicos solo para Fusion, sin tocar la disponibilidad de esos mismos modelos para el resto del equipo. También pueden definir si Fusion es o no el modelo por defecto para todos los usuarios de Copilot en la organización.
¿Es cierto que Fusion Max igualó a Claude Opus 5.5 Max con la mitad del costo?
No igualó, quedó cerca: Fusion Max sacó 60 puntos contra 62 de Claude Code con Opus 5.5 Max en el Artificial Analysis Coding Agent Index v2.0, una diferencia de dos puntos a favor de Claude. Lo que sí se cumple es la parte del costo, según el análisis independiente de Artificial Analysis publicado el 28 de octubre de 2026.
Fusion Max costó USD 5.59 por tarea contra USD 11.42 de Claude Code con Opus 5.5 Max, usando 7.2 millones de tokens por tarea (la mitad que Opus 5.5 en Claude Code) y un 40% menos de tiempo. En Terminal-Bench 4.0 Fusion lideró con 71 puntos. En FrontierCode quedó tercero con 51, detrás de Claude Code con Opus 5.5 Max (56) y de Devin Fusion combinando Opus 5.5 Max con GPT-6 Luna en modo high (54), que a su vez empató el puntaje general de 62 a USD 8.00 por tarea. Donde Fusion más resigna es en SWE-Atlas-QnA-AA, con 57 puntos.
| Sistema | Puntaje Coding Agent Index | Costo por tarea (USD) | Tokens por tarea | FrontierCode |
|---|---|---|---|---|
| GitHub Copilot Fusion Max | 60 | 5.59 | 7.2M | 51 |
| Claude Code con Opus 5.5 Max | 62 | 11.42 | ~14.4M (estimado, el doble que Fusion) | 56 |
| Devin Fusion (Opus 5.5 Max + GPT-6 Luna High) | 62 | 8.00 | mayor que Fusion (Fusion usó 30% menos tokens que Devin Fusion, según Artificial Analysis) | 54 |
¿Qué limitaciones tiene la comparación entre Copilot Fusion y Claude Code?
La limitación principal es que Fusion Max quedó por debajo de Opus 5.5 Max en puntaje general, no por encima: la ventaja que reivindica GitHub es de costo y velocidad, no de calidad superior. Eso lo confirma el mismo reporte de Artificial Analysis, que es un benchmark independiente, pero los números de ahorro de costo y tiempo que circularon primero vienen del comunicado de GitHub, no de una verificación replicada por un tercero distinto del que hizo el benchmark. Para más detalles técnicos, mirá nuestra guía completa de herramientas para developers.
¿Alguien corrió estos mismos tests con otra metodología para confirmar los márgenes exactos? Todavía no hay registro de eso. Tomalo con pinzas: el ranking de Artificial Analysis es sólido como referencia, pero un benchmark mide tareas tipo, no necesariamente tu caso de uso. Si tu equipo trabaja con un stack muy específico, lo razonable es correr tu propia comparación de costo y calidad en un sprint chico antes de mover todo el flujo a Fusion Max, en vez de asumir que el resultado del índice se traslada uno a uno a tu backlog real.
¿Qué cambia esto para los equipos de desarrollo que usan GitHub Copilot?
Cambia que dejás de perder tiempo eligiendo modelo a mano, algo que ya venía pasando de forma manual: el 61% de los usuarios de Copilot alternó entre más de un modelo en septiembre de 2026, según los datos de uso que cita technology.org. Fusion toma ese hábito existente y lo convierte en producto.
Hari Pokhrel, principal software engineer en AT&T, lo resume así en el comunicado de GitHub: “Previously, developers would often choose a more powerful model for a complex task and forget to switch back for everyday activities.” Pokhrel le atribuye a Fusion Standard una mejora en la eficiencia de tokens, con menos gasto innecesario y más capacidad para trabajo de mayor valor.
El contexto de fondo es grande. Según el reporte Octoverse de GitHub, los agentes iniciaron más del 40% de los pull requests en septiembre de 2026 (unos 110 millones de PRs ese mes), contra 17% en marzo. El 90% de esos PRs iniciados por agentes se mergearon dentro de las dos semanas, contra 86% de los que no tenían participación de agentes detectada. En los doce meses hasta septiembre, los desarrolladores pushearon código 17.9 mil millones de veces, más que en 2024 y 2025 juntos.
¿De dónde viene Copilot Fusion? El origen en Project HydraFusion
Copilot Fusion nace de combinar dos piezas que ya existían por separado: la orquestación de Project HydraFusion y la selección automática de modelos de Copilot. HydraFusion arrancó como research preview en septiembre de 2026 y, según technology.org, enrutó casi 60.000 sesiones en la CLI y la app de Copilot antes de integrarse a Fusion. Tema relacionado: la llegada de GPT-6 Astra a la plataforma.
La selección automática de modelos, por su parte, ya la había probado el 63% de los usuarios pagos de Copilot en septiembre. GitHub no inventó la orquestación de cero: tomó dos features en fase de prueba, las fusionó (de ahí el nombre) y las lanzó como producto general el 28 de octubre. No es un movimiento aislado: Ramp integró selección de modelos a su agente open source Open SWE este mes, y Replit hizo lo mismo con enrutamiento “inteligente” por defecto en todas las cuentas durante el verano boreal.
Qué está confirmado y qué no sobre Copilot Fusion
- Confirmado: disponibilidad general desde el 28 de octubre de 2026 en VS Code, Copilot CLI, la app de GitHub Copilot y JetBrains, según la documentación oficial.
- Confirmado: el puntaje de 60 para Fusion Max y el costo de USD 5.59 por tarea, medidos por Artificial Analysis en su índice v2.0.
- Confirmado: administradores enterprise pueden restringir modelos específicos solo dentro de Fusion sin afectar al resto del equipo.
- No confirmado de forma independiente: que los ahorros de 40% en tiempo se mantengan igual en tareas fuera del índice de benchmark, ya que ese dato proviene del comunicado de GitHub sobre un índice de terceros.
- Pendiente: el self-serve para que empresas grandes contraten Copilot sin suscripción separada, hoy solo disponible a través del equipo de ventas de GitHub.
Errores comunes al evaluar Copilot Fusion
- Leer “igualó a Opus 5.5 Max” como superioridad técnica. El dato real es que quedó dos puntos abajo en el índice general; la ventaja es de costo y velocidad, no de calidad bruta.
- Activar Fusion Max para todo. Fusion High o Standard alcanzan para la mayoría de las tareas diarias, y usar Max de entrada puede disparar el consumo de créditos sin necesidad real.
- Asumir que Fusion reemplaza la revisión del código. Si Fusion descarta un borrador, los cambios que ese borrador ya hizo en tu workspace (como ediciones de archivos) no se deshacen solos: hay que revisar antes de commitear, algo que la propia documentación de GitHub marca como limitación.
- Confundir el descuento temporal con precio final. El 30% de descuento en costo de modelos con Fusion rige hasta el 30 de noviembre de 2026; después de esa fecha, cada modelo se factura a su tarifa estándar.
Preguntas Frecuentes
¿Qué es GitHub Copilot Fusion?
Es un sistema de enrutamiento y orquestación en tiempo real dentro de GitHub Copilot que elige automáticamente qué modelo de IA usar para cada tarea de código, combinando capacidades de Anthropic y OpenAI según lo que pida el trabajo. Cobertura relacionada: los problemas de seguridad con credenciales estáticas.
¿Cómo elige Copilot Fusion qué modelo de IA usar?
Analiza señales de razonamiento, generación de código, debugging y uso de herramientas, y con eso elige entre tres patrones: single (un modelo), cascade (un modelo barato que escala a uno más fuerte si hace falta) o critique (varios modelos revisan el trabajo de uno). Nuestros colegas de donweb.news lo analizan en cómo automatizar builds con GitHub Actions.
¿Copilot Fusion es mejor que Claude Opus 5.5?
En puntaje general no: Fusion Max sacó 60 contra 62 de Claude Code con Opus 5.5 Max en el Artificial Analysis Coding Agent Index. Donde sí le gana es en costo (USD 5.59 contra USD 11.42 por tarea) y en tiempo (40% menos). Lo explicamos a fondo en los nuevos modelos disponibles para todos los planes.
¿Qué diferencia hay entre Fusion Standard, High y Max?
Standard prioriza equilibrio entre costo y velocidad para trabajo cotidiano con un solo modelo; High suma orquestación moderada para tareas más exigentes; Max busca la mayor capacidad de razonamiento posible cuidando igual la eficiencia de tokens.
¿Cuánto cuesta usar Copilot Fusion?
No hay cargo extra por Fusion en sí: pagás la tarifa estándar de cada modelo que termine usando. Hasta el 30 de noviembre de 2026, los usuarios de planes pagos tienen un 30% de descuento en el costo de modelos al usar Fusion.
Conclusión
Copilot Fusion no vuelve obsoleto a Claude Opus 5.5 Max, lo compite desde otro ángulo: menos costo, menos tiempo, un puntaje apenas dos puntos abajo. Para un equipo que corre miles de tareas de código por mes, esa diferencia de USD 5.59 contra USD 11.42 por tarea pesa bastante más que dos puntos de un índice. El tema es que todavía no hay una medición independiente propia, por fuera del comunicado de GitHub y el benchmark de Artificial Analysis, que confirme esos márgenes en tareas que no sean las del índice.
Si tu equipo ya usa Copilot, probar Fusion Standard en un sprint y comparar consumo de créditos contra el mes anterior es un punto de partida razonable, sin apostar todo el flujo de trabajo a Fusion Max desde el primer día.