En pocas palabras: Sí, parcialmente: Kimi K3.1 Pro lista a 2 dólares de entrada y 10 de salida por millón de tokens, el mismo precio que GPT-6.1 Sol de OpenAI y Claude Sonnet 5.5, según precios oficiales verificados el 29 de octubre de 2026.
DeepSeek subió el precio de salida de V4 Flash de 0,28 a 1,32 dólares por millón de tokens en horario pico (un salto de 4,7x) desde el 16 de agosto de 2026, según el estudio de Tokely. Kimi K3.1 Pro y GLM-5.3 también listan más caro que sus generaciones anteriores, con primas de 2,34x y 2,15x respectivamente sobre sus flagships previos.
Los precios API de modelos chinos IA son las tarifas oficiales que DeepSeek, Alibaba (Qwen), Moonshot AI (Kimi), Z.ai (GLM) y MiniMax publican por millón de tokens de entrada, caché y salida. Esos precios, verificados el 29 de octubre de 2026, definen cuánto paga un equipo de desarrollo por consumir esas APIs y si siguen siendo la opción barata frente a OpenAI y Anthropic.
En este artículo:
- En 30 segundos
- ¿Cuánto subió el precio de DeepSeek desde agosto de 2026?
- ¿Qué es la “prima de generación” en Kimi y GLM?
- ¿Qwen y MiniMax rompen el patrón de subas?
- ¿Kimi K3.1 Pro cuesta lo mismo que GPT-6.1 Sol y Claude Sonnet 5.5?
- ¿Los modelos chinos más chicos siguen siendo más baratos que los de EE.UU.?
- ¿Qué deben hacer los equipos que usan estas APIs ante estos cambios de precio?
- Errores comunes al comparar precios de API de modelos chinos
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- DeepSeek V4 Flash: output pasó de 0,28 a 1,32 dólares por millón de tokens en pico desde el 16 de agosto de 2026 (4,7x).
- Kimi K3.1 Pro lista a 4,00 dólares blended, 2,34x más que Kimi K2.6 ($1,71 blended).
- GLM-5.3 lista a 2,15 dólares blended, 2,15x más que GLM-4.7 ($1,00 blended).
- Kimi K3.1 Pro cuesta exactamente lo mismo que GPT-6.1 Sol y Claude Sonnet 5.5 ($2 input / $10 output).
- Qwen3.8-Max en Singapur solo cuesta 1,07x más que Qwen-Max, mostrando que la región pesa más que la generación.
¿Cuánto subió el precio de DeepSeek desde agosto de 2026?
DeepSeek reemplazó su tarifa única por precios diferenciados de pico y valle desde las 16:00 UTC del 16 de agosto de 2026. El output de V4 Flash saltó de 0,28 a 1,32 dólares por millón de tokens en horario pico, 4,7 veces la tarifa que figuraba en su página el 1 de agosto, y el de V4 Pro pasó de 0,87 a 3,96 dólares, 4,6 veces más.
Ojo con los horarios: pico es de 01:00 a 04:00 y de 06:00 a 10:00 UTC. Fuera de esas franjas, DeepSeek cobra la mitad.
El 10 de septiembre de 2026 llegó V4.1 Flash con tabla propia: 0,60 dólares de output en valle y 1,20 en pico, con horario pico limitado a días de semana (fines de semana y feriados chinos son valle). Comparado contra el precio de referencia del 1 de agosto, V4.1 Flash sigue costando 2,1x en valle y 4,3x en pico. Y el dato que más circula en coberturas de septiembre-octubre de 2026, el de 1,32 dólares, en realidad corresponde al pico de V4 Flash del 16 de agosto, no a un modelo nuevo (si viste esa cifra repetida sin contexto, ahora sabés de dónde sale). Para más detalles técnicos, mirá la diferencia entre API y MCP.
¿Qué es la “prima de generación” en Kimi y GLM?
La prima de generación es el precio blended del flagship más nuevo de un desarrollador dividido por el de su generación anterior, ambos medidos el mismo día. Al 29 de octubre de 2026 esa prima es de 2,34x para Kimi y 2,15x para GLM, según el relevamiento de precios listados en las páginas oficiales.
Kimi K2.6 lista a 0,95 dólares de input y 4 de output, 1,71 blended. Kimi K3 sube a 3 y 15 dólares, 6,00 blended (3,5x K2.6). Kimi K3.1 Pro, el que más importa para quien está eligiendo modelo hoy, queda en 2 y 10 dólares, 4,00 blended, 2,34x K2.6. La página de Kimi avisa que la serie K2 cierra a usuarios nuevos el 31 de octubre de 2026 y se retira a fin de diciembre, así que cualquier cuenta nueva arranca directo al nivel de precio de K3.
GLM sigue un patrón parecido. GLM-4.5, GLM-4.6 y GLM-4.7 listan los tres a 0,60 y 2,20 dólares, 1,00 blended. GLM-5 sube a 1,55x. GLM-5.1, 5.2 y 5.3 quedan parejos en 1,40 y 4,40 dólares, 2,15 blended, 2,15x sobre GLM-4.7.
¿Qwen y MiniMax rompen el patrón de subas?
Sí, y por un margen grande. En la región Singapur de Alibaba Cloud, Qwen3.8-Max lista a 3,00 dólares blended contra 2,80 de Qwen-Max, apenas 1,07x, y queda por debajo de Qwen3.7-Max (3,75 blended). La línea Qwen Plus muestra lo mismo: Qwen3.7-Plus cuesta 0,70 blended, solo 1,17x sobre qwen-plus. Ya lo cubrimos antes en precios y capacidades de Claude 3 Opus.
Lo interesante es que para Qwen la región importa más que la generación. En la región China (Beijing), Qwen-Max lista a 0,345 input y 1,377 output, y Qwen3.8-Max a 1,65 y 4,951, una brecha blended de 4,1x. En Singapur esa misma comparación da 1,07x. Mismo modelo, mismo día, resultado totalmente distinto según dónde compres la API.
MiniMax directamente bajó. M3 lista a 0,30 input y 1,20 output (hasta 512K tokens de contexto), según la propia página se trata de un descuento permanente del 50% frente a los 0,60 y 2,40 dólares que costaba antes. M3.1 Flash queda en 0,15 y 0,60 dólares.
¿Kimi K3.1 Pro cuesta lo mismo que GPT-6.1 Sol y Claude Sonnet 5.5?
Sí, exactamente lo mismo. Kimi K3.1 Pro, GPT-6.1 Sol y Claude Sonnet 5.5 listan los tres a 2 dólares de input y 10 de output, 4,00 dólares blended. La única diferencia está en el input cacheado: Kimi cobra 0,20 dólares contra 0,10 de los dos modelos estadounidenses.
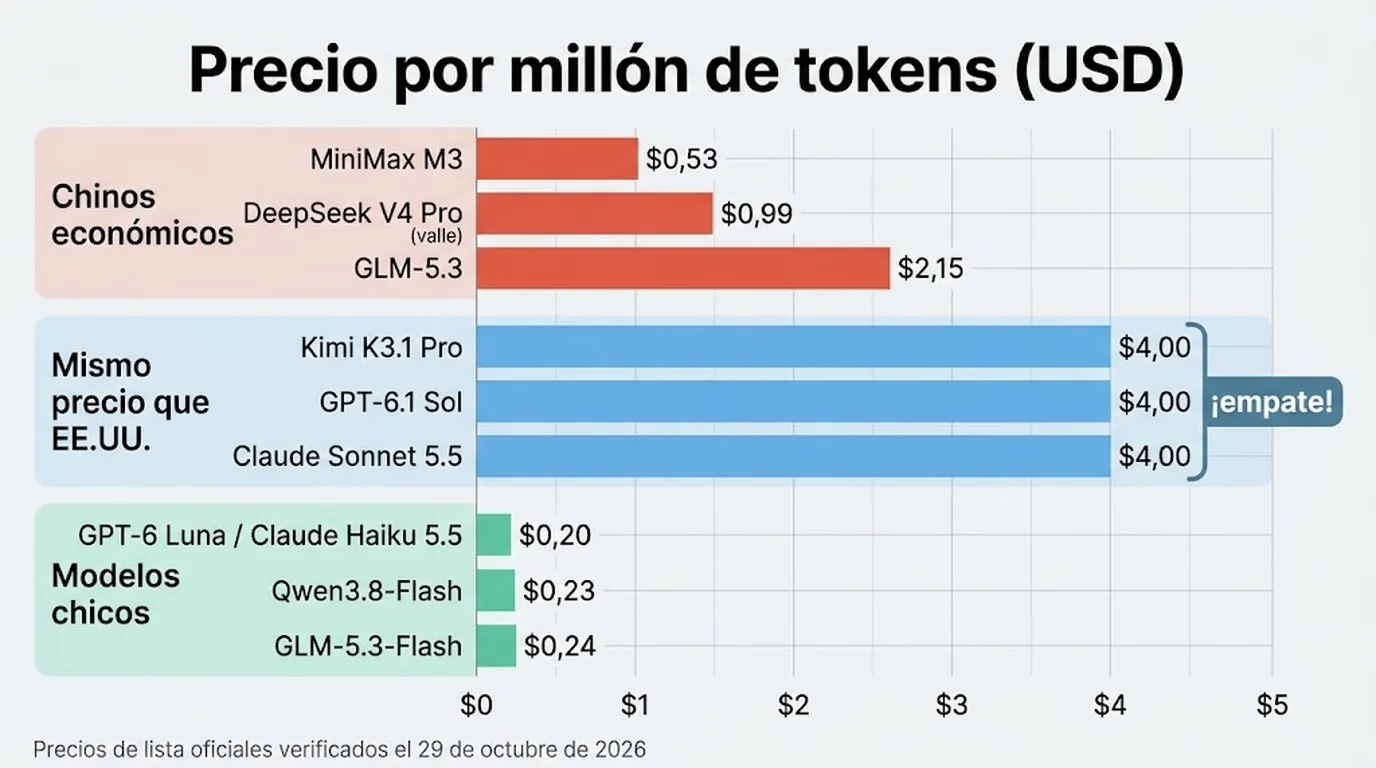
¿Y qué pasa con el resto de la escala? Kimi K3, a 3 y 15 dólares, queda en 1,5x el precio de Sonnet 5.5. Claude Opus 5.5 lista arriba de todos, a 8,00 blended. Por debajo del punto de precio de Sonnet están Qwen3.8-Max (3,00 blended), GLM-5.3 (2,15, es decir 0,54x Sonnet 5.5) y GPT-6.1 Terra (2,00 blended). DeepSeek V4 Pro queda en 1,98 blended en pico y 0,99 en valle, y MiniMax M3 en 0,53. Las opciones más baratas de clase flagship siguen siendo chinas, pero el flagship más nuevo de Kimi ya se sentó en la mesa de precios de Estados Unidos. Sobre eso hablamos en nuestra guía completa de modelos de lenguaje.
¿Los modelos chinos más chicos siguen siendo más baratos que los de EE.UU.?
No en todos los casos. GPT-6 Luna y Claude Haiku 5.5 listan los dos a 0,10 input y 0,50 output, 0,200 blended, por debajo de Qwen3.8-Flash en Singapur (0,230), GLM-5.3-Flash (0,237) y de DeepSeek V4.1 Flash en valle y MiniMax M3.1 Flash, ambos en 0,263 blended.
Eso sí: en caché, China sigue ganando con claridad. DeepSeek V4.1 Flash cobra 0,003 dólares por millón de tokens en hits de caché fuera de pico, contra 0,01 de GPT-6 Luna y Haiku 5.5, y MiniMax M3.1 Flash cobra 0,015. ¿Para quién importa esto? Para cualquiera que corra agentes con prompts de sistema largos y repetidos: ahí el ahorro de DeepSeek es real y se nota en la factura mensual.
| Modelo | Input ($/1M) | Output ($/1M) | Blended (3:1) |
|---|---|---|---|
| DeepSeek V4 Flash (pico) | 0,44 | 1,32 | 0,66 |
| DeepSeek V4 Pro (pico) | 1,32 | 3,96 | 1,98 |
| DeepSeek V4.1 Flash (valle) | 0,15 | 0,60 | 0,26 |
| Kimi K2.6 | 0,95 | 4,00 | 1,71 |
| Kimi K3.1 Pro | 2,00 | 10,00 | 4,00 |
| GLM-5.3 | 1,40 | 4,40 | 2,15 |
| Qwen3.8-Max (Singapur) | 2,00 | 6,00 | 3,00 |
| MiniMax M3 | 0,30 | 1,20 | 0,53 |
| GPT-6.1 Sol | 2,00 | 10,00 | 4,00 |
| Claude Sonnet 5.5 | 2,00 | 10,00 | 4,00 |
| Claude Opus 5.5 | 4,00 | 20,00 | 8,00 |
¿Qué deben hacer los equipos que usan estas APIs ante estos cambios de precio?
Lo primero: dejar de asumir que un modelo chino es automáticamente la opción barata y chequear el precio modelo por modelo. Con la prima de generación de Kimi en 2,34x y Kimi K3.1 Pro ya empatado con GPT-6.1 Sol y Sonnet 5.5, esa suposición vigente hasta 2025 ya no cierra siempre.
En DeepSeek, programá las cargas pesadas fuera de las franjas pico (01:00 a 04:00 y 06:00 a 10:00 UTC, días de semana). Reutilizá prefijos largos de prompt para que caigan en tarifa de caché, que en DeepSeek baja hasta 0,003 dólares por millón de tokens. Y revisá dónde compras: Alibaba Cloud Singapur cobra DeepSeek V4 Pro a un flat de 2,40 input y 4,80 output, 1,8x el precio pico del propio DeepSeek y 3,6x su precio valle. Comprarle al revendedor en vez de al desarrollador directo te puede salir bastante más caro sin que lo notes hasta la factura. Relacionado: la tabla comparativa de la guerra de precios.
Si tu stack corre sobre Kimi K2, hay una fecha concreta para mover el calendario: cierre a usuarios nuevos el 31 de octubre de 2026 y retiro completo a fin de diciembre. Después de esa fecha arrancás directo en el nivel de precio de K3.
Errores comunes al comparar precios de API de modelos chinos
- Comparar sin mirar la región. Qwen-Max y Qwen3.8-Max difieren 1,07x en Singapur pero 4,1x en Beijing: el mismo par de modelos, la misma fecha, resultados opuestos según dónde compres.
- Ignorar el horario en DeepSeek. Correr un batch de madrugada UTC sin revisar la franja pico puede significar pagar 4,7x el output sin necesidad.
- Asumir que “chino” es sinónimo de “barato”. Kimi K3.1 Pro lista exactamente igual que GPT-6.1 Sol y Claude Sonnet 5.5, y GPT-6 Luna queda por debajo de los modelos flash chinos en la comparación blended.
- No aprovechar el caché de input. Con prompts largos repetidos, no usar la tarifa de cache hit (0,003 dólares en DeepSeek) es dejar plata en la mesa.
- Comprar vía revendedor sin comparar. Alibaba Cloud Singapur cobra DeepSeek V4 Pro hasta 3,6x más que el precio off-peak oficial de DeepSeek.
Preguntas Frecuentes
¿Los modelos de IA chinos están subiendo de precio en 2026?
Parcialmente. DeepSeek subió sus tarifas de output hasta 4,7x en horario pico desde agosto de 2026, y los flagships más nuevos de Kimi y GLM listan 2,34x y 2,15x más que sus generaciones previas. Qwen y MiniMax, en cambio, mantienen subas menores o directamente bajaron precios con descuentos permanentes.
¿Cuánto aumentó DeepSeek su precio de API?
El output de V4 Flash pasó de 0,28 a 1,32 dólares por millón de tokens en horario pico, un salto de 4,7x desde el 16 de agosto de 2026. V4 Pro subió de 0,87 a 3,96 dólares, 4,6x más, en el mismo cambio de tarifa.
¿Kimi K3.1 Pro es más caro que GPT-6.1 o Claude Sonnet 5.5?
No, cuesta exactamente lo mismo: los tres listan a 2 dólares de input y 10 de output, 4,00 dólares blended. La diferencia aparece solo en input cacheado, donde Kimi cobra el doble (0,20 contra 0,10 dólares).
¿Qué son los horarios pico y valle en la API de DeepSeek?
Son dos franjas de precio distinto que DeepSeek aplica desde el 16 de agosto de 2026: pico va de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días de semana, con tarifas hasta el doble del valle. Fines de semana y feriados chinos cuentan siempre como valle.
¿Siguen siendo más baratas las IA chinas que OpenAI y Anthropic?
No en todos los casos. DeepSeek V4 Pro en valle (0,99 blended), MiniMax M3 (0,53) y GLM-5.3 (2,15) siguen por debajo de Claude Sonnet 5.5 y GPT-6.1 Sol (4,00), pero Kimi K3.1 Pro ya empata con ambos y GPT-6 Luna queda por debajo de los modelos flash chinos.
Conclusión
Lo que muestran los precios API modelos chinos IA listados el 29 de octubre de 2026 es que la ventaja de precio ya no es pareja ni automática. DeepSeek cobra según el reloj, Kimi y GLM cobran según la generación, y Qwen cobra según la región donde factures. El criterio práctico para cualquier equipo que elija proveedor hoy es simple: no mires el nombre del desarrollador, mirá la ficha de precio del modelo puntual, la región de compra y el horario de tu carga de trabajo, porque esas tres variables pueden cambiar el costo final más que el hecho de que el modelo sea chino o estadounidense.
Esto no permite concluir que un modelo sea mejor que otro en calidad o velocidad: el propio estudio aclara que no midió esos aspectos, solo precio de lista. Antes de migrar presupuesto de un proveedor a otro, conviene correr una prueba propia con tu carga real de tokens y tu mezcla de input y output, porque el blended 3:1 que usan estos reportes es una aproximación, no tu factura real.