En pocas palabras: Sí, se puede: Farhan Alfath construyó un Mini-GPT desde cero con PyTorch en una notebook Intel Core i5 de 12va gen con 16GB de RAM, sin GPU dedicada. Con 128 dimensiones, 4 capas Transformer, 0,8 millones de parámetros y tokenizador a nivel carácter, tras 3000 pasos de entrenamiento logró un train loss de 0,06.
Un desarrollador armó un LLM desde cero en su propia notebook, sin GPU dedicada: un Mini-GPT con 128 dimensiones, 0,8 millones de parámetros y 4 capas, entrenado con PyTorch hasta bajar el train loss a 0,06, según el artículo original de Farhan Alfath. Lo interesante del caso no es la potencia del modelo (no la tiene, y no pretende tenerla) sino que expone, paso por paso, la mecánica que después queda escondida detrás de la interfaz de un ChatGPT o un Claude.
En este artículo:
- En 30 segundos
- ¿Qué es un LLM y cómo predice el próximo token?
- ¿Qué hardware se necesita para entrenar un mini-GPT en una PC común?
- ¿Cómo está armada la arquitectura de este Mini-GPT?
- ¿Cómo funciona el tokenizador por carácter en este proyecto?
- ¿Qué resultado dio el entrenamiento y qué significa un train loss de 0,06?
- ¿Por qué el Mini-GPT “alucina” palabras que no existen?
- Ejemplo hipotético: qué pasaría si entrenás este mini-GPT con tu propio texto
- ¿Conviene armar tu propio mini-GPT? Criterios para decidir
- ¿Cómo probar el código del Mini-GPT paso a paso?
- Errores comunes al entrenar un mini-GPT local
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El Mini-GPT se entrenó en una notebook con Intel Core i5 de 12va gen y 16GB de RAM, sin GPU dedicada.
- La arquitectura tiene 128 dimensiones de embedding, 4 capas de Transformer y 0,8 millones de parámetros en total.
- El tokenizador trabaja a nivel carácter: cada letra única es un token, así que una palabra se convierte en una secuencia de números.
- Tras entrenar 3000 pasos repitiendo un mismo cuento 30 veces, el train loss bajó a 0,06 y el modelo casi memorizó el texto.
- El código completo está en el repositorio Mini-GPT en GitHub, con instrucciones para entrenar y usar el modelo sin reentrenar.
Un LLM (Large Language Model) es un modelo entrenado con grandes volúmenes de texto para predecir qué token viene a continuación, dado un contexto previo. Mini-GPT es un proyecto educativo de código abierto que replica esa lógica en escala chica, con PyTorch, para que cualquiera entienda cómo funciona un Transformer por dentro antes de usar modelos comerciales como Claude o ChatGPT.
¿Qué es un LLM y cómo predice el próximo token?
Un LLM funciona adivinando, token por token, qué sigue en una secuencia de texto. No “entiende” en el sentido humano: calcula probabilidades sobre qué carácter o palabra es más probable que venga después, basándose en lo que vio antes. Esa distinción importa porque es la raíz de casi todo lo que viene después en esta nota, desde por qué el modelo memoriza hasta por qué a veces inventa palabras.
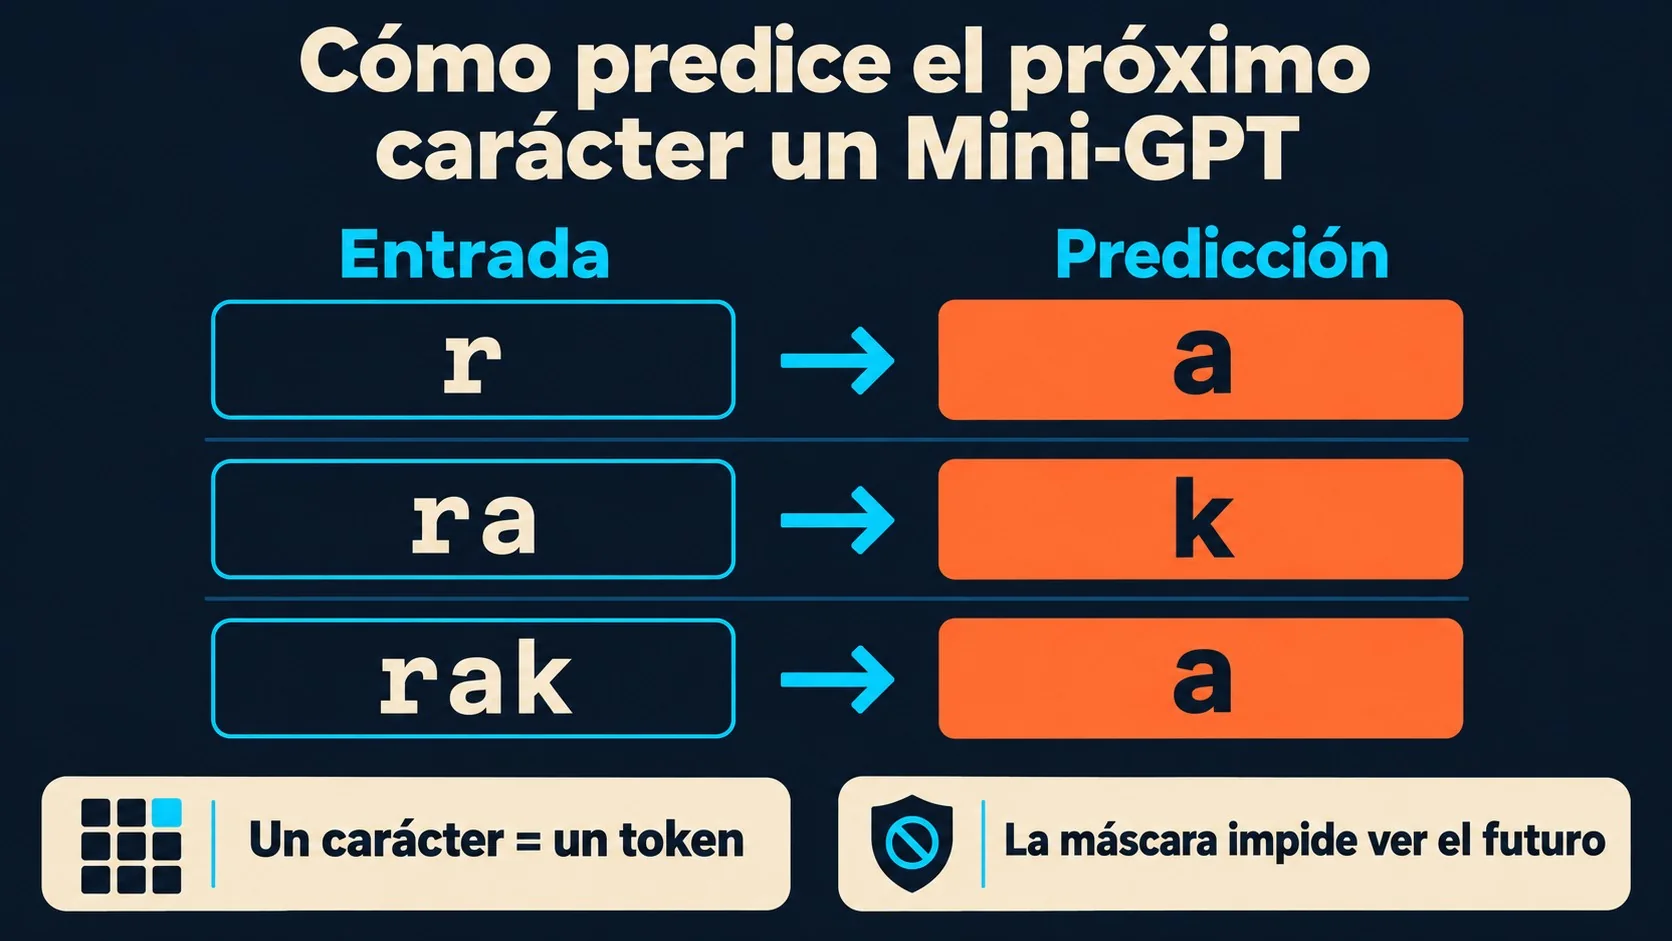
El ejemplo que usa la fuente es claro. Si el modelo ve la letra “r”, predice “a”. Si ya tiene “ra”, predice “k”. Con “rak” en pantalla, predice otra “a”. Así se va armando “raka” letra por letra, desplazando la ventana de contexto un token a la vez.
- Input “r”: el modelo predice “a”.
- Input “ra”: el modelo predice “k”.
- Input “rak”: el modelo predice “a”.
Cada token revisa qué tan relevantes son los tokens anteriores mediante un mecanismo de atención. Una máscara (causal mask) impide que el modelo “espíe” tokens futuros durante el entrenamiento, algo central en la arquitectura Transformer. ¿Y cómo genera texto nuevo una vez entrenado? Predice un token, lo agrega al texto, y repite el proceso. Uno a la vez, sin atajos. Ya lo cubrimos antes en entrenar tu propio modelo desde cero.
¿Qué hardware se necesita para entrenar un mini-GPT en una PC común?
Alcanza con una notebook de oficina: en este proyecto se usó un procesador Intel Core i5 de 12va generación con 16GB de RAM, sin placa de video dedicada. PyTorch detecta automáticamente si hay una GPU con CUDA disponible, pero si no la hay, corre igual en CPU.
Eso sí: en CPU el entrenamiento es más lento. Para un modelo de este tamaño (0,8 millones de parámetros) no es un problema real, pero si alguien quisiera escalar a millones de tokens de contexto o billones de parámetros, ahí sí la GPU deja de ser opcional. Para armar un LLM desde cero con fines de aprendizaje, el hardware de cualquier notebook disponible en 2026 sobra. La cuenta que vale hacerse acá no es “¿tengo suficiente poder de cómputo?” sino “¿para qué lo quiero?” — y esa pregunta es la que separa a quien busca entender de quien busca un producto terminado.
¿Cómo está armada la arquitectura de este Mini-GPT?
La arquitectura tiene 128 dimensiones de embedding, 4 capas de bloques Transformer y 0,8 millones de parámetros en total, según el repositorio de aalfath7/Mini-GPT. Cada bloque incluye self-attention causal multi-head, una red feed-forward con activación GELU, conexiones residuales y LayerNorm.
Para poner esa cifra en perspectiva (sin comparar peras con naves espaciales): GPT-3, el modelo que popularizó OpenAI, tiene 175.000 millones de parámetros, un dato público y conocido desde su lanzamiento. El Mini-GPT de este proyecto tiene 0,8 millones. La diferencia de escala es de más de 200.000 veces. Nadie espera que este modelo chico escriba un ensayo coherente, la gracia es entender el mecanismo, no competir en capacidad.
¿Cómo funciona el tokenizador por carácter en este proyecto?
El tokenizador asigna un número a cada letra única del texto de entrenamiento, así que un texto completo termina siendo una secuencia de números que el modelo puede procesar matemáticamente. Un carácter equivale a un token (1 letra = 1 token), lo que simplifica el aprendizaje aunque la arquitectura de fondo sea la misma que la de un LLM real. Lo explicamos a fondo en todo lo que necesitás saber sobre ChatGPT.
El dataset se divide 90% para entrenamiento y 10% para validación, según el repositorio. Ojo con un detalle importante: si entrenás con un texto y después probás el modelo con otro texto distinto, el tokenizador se reconstruye y el vocabulario no va a coincidir con los pesos ya entrenados. Los caracteres que no estaban en el texto original tampoco se pueden usar en el prompt.
| Hiperparámetro | Valor | Qué significa |
|---|---|---|
| BATCH | 32 | Cantidad de fragmentos de texto que se entrenan a la vez |
| CONTEXT | 64 | Longitud del contexto, cuántos tokens “recuerda” el modelo |
| D_MODEL | 128 | Tamaño del vector de embedding |
| N_HEADS | 4 | Cantidad de cabezas de atención |
| N_LAYERS | 4 | Cantidad de bloques Transformer |
| DROPOUT | 0,1 | Probabilidad de dropout durante el entrenamiento |
| STEPS | 3000 | Cantidad de pasos de entrenamiento |
| LR | 3e-4 | Learning rate del optimizador AdamW |
¿Qué resultado dio el entrenamiento y qué significa un train loss de 0,06?
El entrenamiento con un mismo cuento (la historia de Raka) repetido 30 veces bajó el train loss a 0,06, un número bajo que indica que el modelo predice casi perfectamente el siguiente carácter del texto que ya vio. El resultado generado quedó casi idéntico al texto original.
¿Eso significa que el modelo “aprendió” a escribir? No exactamente, y conviene ser honestos con esa distinción porque es la que más se presta a confusión. Significa que memorizó. Subís los pasos de entrenamiento, el loss baja, el texto generado se parece cada vez más al original, pero en el fondo el modelo está repitiendo lo que vio, no generalizando un patrón nuevo. Es una diferencia clave cuando alguien evalúa qué tan “inteligente” parece un modelo chico: baja loss con un solo texto repetido no es lo mismo que capacidad real de generar contenido original. Un número bonito en la consola no es, por sí solo, evidencia de nada más que eso.
¿Por qué el Mini-GPT “alucina” palabras que no existen?
El Mini-GPT alucina porque predice letra por letra y, cuando dos fragmentos del texto de entrenamiento se parecen entre sí, el modelo puede “perderse” y saltar a una continuación distinta de la esperada. La fuente documenta un caso concreto: la frase generada fue “Raka suka menadi, pakanya sekali cerita terlebih dari kecih dahulu”, y la palabra “kecih” no existe en ningún lado del texto original. Sobre eso hablamos en entender cómo funciona la arquitectura GPT.
¿Es un bug exclusivo de modelos chicos? No. Es el mismo mecanismo que explica las alucinaciones en LLM grandes como GPT o Claude: el modelo predice la continuación más probable estadísticamente, no la más verdadera. Cuando el contexto es ambiguo o se parece a otra parte del texto que vio, mezcla fragmentos y produce algo que suena a lenguaje pero no corresponde a ningún hecho real. Ver ese fenómeno en un modelo de 0,8 millones de parámetros ayuda a entender por qué pasa también en modelos de miles de millones: la escala cambia el resultado, no la causa.
Ejemplo hipotético: qué pasaría si entrenás este mini-GPT con tu propio texto
Ejemplo hipotético, no verificado, solo para ilustrar la mecánica descrita en la documentación del proyecto: imaginemos que alguien reemplaza el cuento de Raka por, digamos, un archivo con todas las letras de canciones de su banda favorita, y lo guarda como data.txt. Según cómo está armado el tokenizador en el repositorio, pasarían al menos tres cosas previsibles.
- El vocabulario cambia por completo. Si las letras de las canciones tienen signos, acentos o mayúsculas que no estaban en el cuento original, el tokenizador los va a incorporar como tokens nuevos, y el modelo recién entrenado va a tener una tabla de caracteres distinta a la del ejemplo original.
- Los pesos viejos (mini_gpt.pt) quedan inservibles. Si esa persona intentara usar
pakai_mini_gpt.pycon el archivo de pesos entrenado sobre el cuento de Raka pero tipeando un prompt con el texto de las canciones, el repositorio advierte explícitamente que el vocabulario no va a coincidir: hay que reentrenar primero. - El train loss probablemente no bajaría tan rápido a 0,06. Un cancionero completo tiene muchísima más variedad de palabras y estructuras que un cuento corto repetido 30 veces. Más variedad en el dataset implica, en principio, que el modelo necesita más pasos (o más datos) para memorizar, y que es menos probable que termine simplemente copiando un único texto de memoria.
La utilidad de pensar este escenario hipotético no es predecir un número exacto —eso solo se sabe corriendo el código—, sino anticipar qué variables mirar antes de frustrarse: si cambiás el dataset, esperá reentrenar; si el loss no baja como en el ejemplo original, probablemente sea porque tu texto tiene más diversidad, no porque algo esté roto.
¿Conviene armar tu propio mini-GPT? Criterios para decidir
No todo el que quiere usar un LLM necesita construir uno desde cero. Antes de clonar el repositorio, tiene sentido chequear estos puntos:
- Tu objetivo es entender, no producir. Si lo que buscás es generar texto útil ya, un modelo comercial va a dar mejores resultados con cero configuración. Este proyecto tiene sentido si el objetivo es ver por dentro cómo funciona la predicción de tokens.
- Tenés tiempo para iterar, no solo para correr un script. El valor está en cambiar hiperparámetros, romper cosas, ver qué pasa con un dataset distinto y entender por qué. Correrlo una sola vez con el texto de ejemplo no enseña gran cosa más que “funciona”.
- Tu dataset es chico y controlado. El tokenizador por carácter y la arquitectura de 0,8 millones de parámetros están pensados para textos cortos. Si la idea es entrenar con un corpus grande, hace falta repensar la arquitectura, no solo el hardware.
- Aceptás que el resultado va a tener errores. Con pocos pasos de entrenamiento y un modelo chico, las “alucinaciones” de palabras inventadas son parte esperada del proceso, no un indicio de que algo está mal configurado.
Si alguno de esos puntos no se cumple —por ejemplo, si lo que necesitás es un asistente que responda bien ya— probablemente convenga usar un modelo comercial existente en lugar de entrenar uno propio.
¿Cómo probar el código del Mini-GPT paso a paso?
Para probar el proyecto hay que instalar PyTorch con pip install torch, entrenar con python mini_gpt.py (usa el texto de ejemplo sobre Raka) o python mini_gpt.py data.txt si tenés tu propio texto, y después usar el modelo ya entrenado con python pakai_mini_gpt.py sin necesidad de reentrenar.
El repositorio aalfath7/Mini-GPT tiene tres archivos clave: mini_gpt.py define el modelo, el tokenizador y el entrenamiento; pakai_mini_gpt.py permite usar el modelo de forma interactiva escribiendo un comienzo de frase; y mini_gpt.pt guarda los pesos entrenados. Durante el entrenamiento, el loss de train y de validación se imprime cada 500 pasos, así que podés ver el progreso en tiempo real sin esperar a que termine todo el proceso.
Errores comunes al entrenar un mini-GPT local
- Cambiar el dataset sin reentrenar. El tokenizador se reconstruye desde el texto que uses. Si entrenaste con un archivo y después probás con otro distinto, el vocabulario no coincide con los pesos guardados en mini_gpt.pt.
- Confundir memorización con generalización. Un train loss de 0,06 con un solo texto repetido 30 veces significa que el modelo copió el patrón, no que aprendió a escribir de forma general.
- Modificar hiperparámetros sin reentrenar. Si cambiás D_MODEL, N_LAYERS o cualquier valor del bloque de configuración, hay que correr mini_gpt.py de nuevo antes de usar pakai_mini_gpt.py, porque los pesos viejos no van a ser compatibles.
- Esperar texto coherente con pocos pasos. Con 3000 steps y un modelo de 0,8 millones de parámetros, el resultado va a tener errores de palabras inventadas. Es parte esperable del proceso, no una falla del código.
Preguntas Frecuentes
¿Qué es un LLM y cómo predice el siguiente carácter?
Un LLM es un modelo entrenado con grandes volúmenes de texto que predice el siguiente token basándose en los tokens anteriores. En un tokenizador por carácter, eso significa adivinar la próxima letra: si ve “ra”, calcula que “k” es la continuación más probable según lo que aprendió durante el entrenamiento.
¿Se puede entrenar un modelo de lenguaje en una computadora normal sin GPU?
Sí, se puede. PyTorch corre en CPU si no detecta una GPU con CUDA disponible. El proyecto Mini-GPT se entrenó en una notebook con Intel Core i5 de 12va generación y 16GB de RAM, sin placa de video dedicada, y completó el proceso sin problemas. Esto se conecta con lo que analizamos en armar tu propio LLM paso a paso.
¿Cuánta RAM y qué procesador hacen falta para entrenar un LLM chico?
Para un modelo de 0,8 millones de parámetros como este Mini-GPT, un procesador Intel Core i5 de 12va generación y 16GB de RAM son suficientes, según los datos del propio proyecto. Modelos más grandes, con más capas o más dimensiones, van a necesitar más memoria y, probablemente, una GPU.
¿Por qué los modelos de lenguaje inventan palabras que no existen?
Porque predicen el siguiente token basándose en probabilidades, no en verificación de hechos. Cuando dos fragmentos de texto se parecen entre sí, el modelo puede saltar a una continuación incorrecta y generar una palabra o afirmación que no existe en ningún lado, un fenómeno conocido como alucinación tanto en modelos chicos como en los grandes.
¿Qué es PyTorch y para qué sirve en un proyecto de IA?
PyTorch es un framework de código abierto para construir y entrenar redes neuronales, usado en este proyecto para definir el modelo Transformer, entrenarlo y generar texto. Se instala con pip install torch y detecta automáticamente si hay GPU disponible para acelerar el entrenamiento.
Conclusión
Armar un LLM desde cero en una notebook sin GPU ya no es ciencia ficción, es un fin de semana con PyTorch y un texto de ejemplo. El Mini-GPT de este proyecto no compite con Claude ni con ChatGPT, ni pretende hacerlo: con 0,8 millones de parámetros frente a los 175.000 millones de GPT-3, la distancia es abismal. Lo que sí ofrece es algo que ningún modelo comercial te va a mostrar por dentro: el mecanismo exacto de cómo se predice un token, por qué aparece una alucinación y qué significa realmente un train loss bajando a 0,06.
Si estás empezando en IA y querés entender Transformers sin depender de una API externa, clonar el repositorio Mini-GPT, cambiar el texto de entrenamiento por algo propio (como en el ejemplo hipotético del cancionero) y ver qué pasa es un ejercicio mucho más útil que leer diez papers sobre atención. Vas a romper cosas, vas a ver palabras inventadas, y ahí vas a entender de verdad por qué los modelos grandes también se equivocan.