En pocas palabras: La release b11940 de llama.cpp, publicada el 28 de octubre de 2026, suma el PR #31256 con soporte para deferred tools y tool_reference content parts. Sus tres commits llevan la etiqueta Assisted-by: Claude Opus 5.5, con co-autoría humana de Aldehir Rojas.
El 28 de octubre de 2026, el proyecto llama.cpp publicó la release b11940 con el PR #31256: soporte para deferred tools y tool_reference content parts, que el equipo ya integró en master. Los tres commits llevan la marca Assisted-by: Claude Opus 5.5, el modelo insignia de Anthropic.
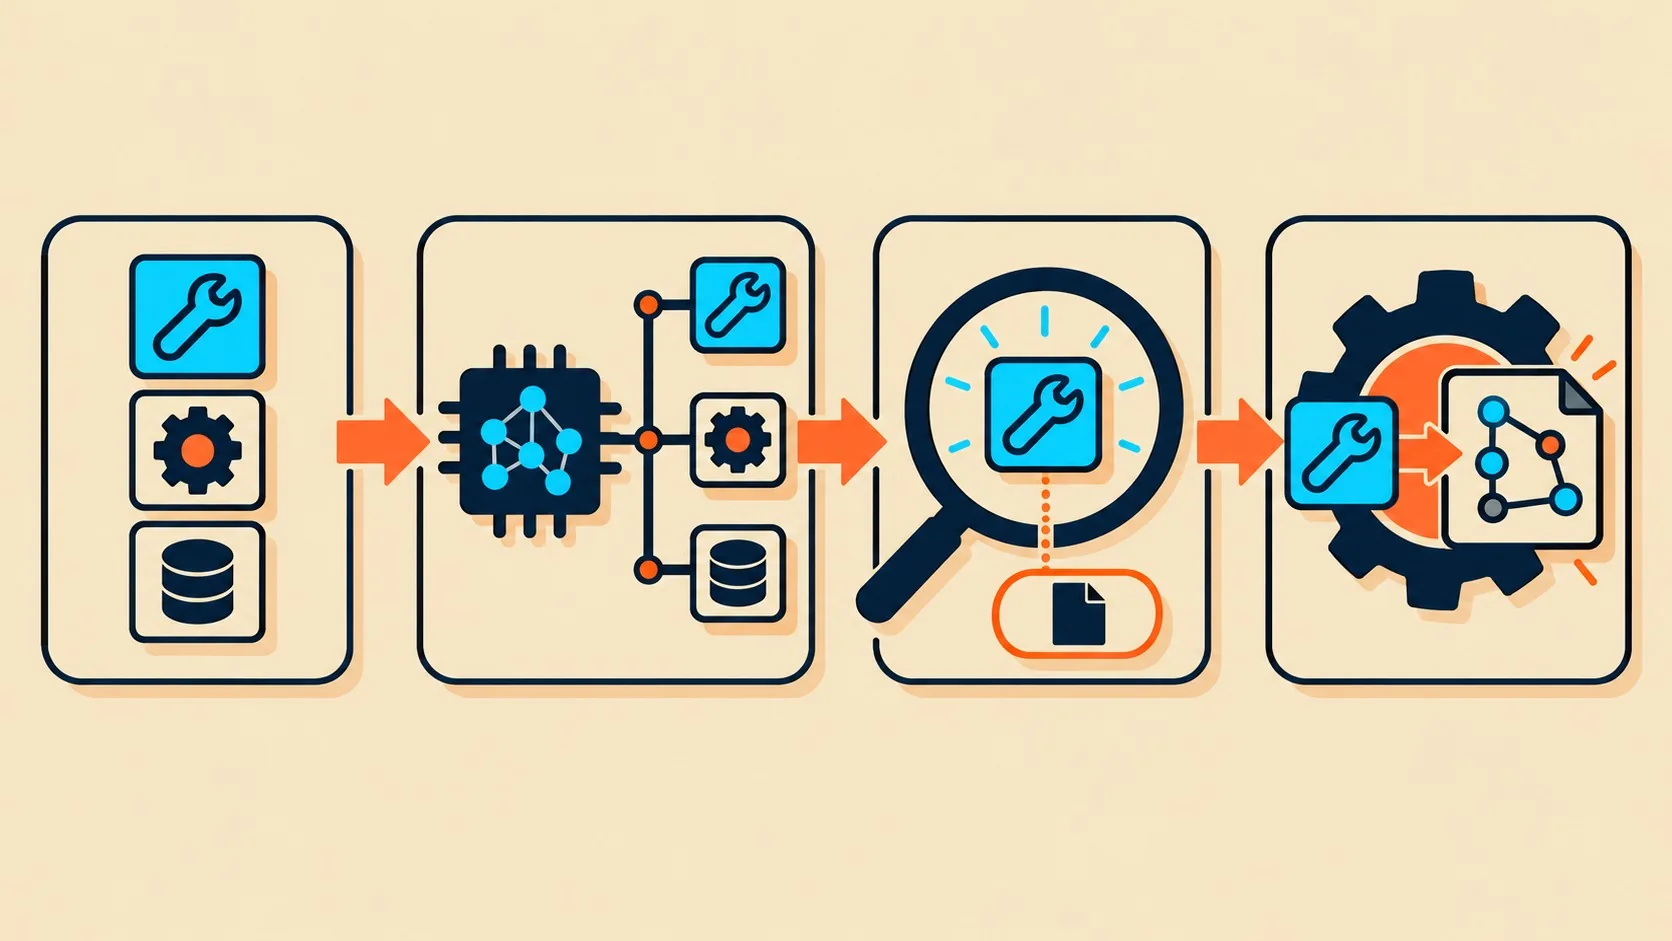
Los deferred tools son una función de llama.cpp, el motor de inferencia en C++ para modelos de lenguaje que corre modelos GGUF en CPU y GPU. Permiten declarar una tool disponible para el modelo sin renderizar su definición completa en el prompt: queda “callable” en la grammar, pero oculta, hasta que un content part de tipo tool_reference la revela, sin tocar el prefijo cacheado del prompt.
En este artículo:
- En 30 segundos
- ¿Qué son los deferred tools y los tool_reference content parts en llama.cpp?
- ¿Qué cambia exactamente el PR #31256 en llama.cpp?
- ¿Qué rol tuvo Claude Opus 5.5 en el desarrollo de este PR de llama.cpp?
- ¿Qué modelos y plataformas soportan hoy el deferred tool calling?
- ¿Qué límites tiene esta release al ser un pre-release?
- Qué está confirmado y qué no sobre esta release
- Errores comunes al interpretar esta release
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La release b11940 de llama.cpp (28 de octubre de 2026) suma el PR #31256 con deferred tools y tool_reference content parts.
- Los tres commits del PR llevan la etiqueta Assisted-by: Claude Opus 5.5, con co-autoría humana de Aldehir Rojas.
- El cambio evita inflar el prompt con definiciones de tools que no se usan en cada turno, sin romper el cache de prefijo.
- El PR pasó 17 de 18 checks y lo mergeó ngxson a master el 27 de octubre de 2026.
- b11940 está marcada como Pre-release: la generó github-actions, sin ciclo de QA manual todavía.
¿Qué son los deferred tools y los tool_reference content parts en llama.cpp?
Un deferred tool es una herramienta que el servidor de llama.cpp mantiene disponible para el modelo sin escribir su esquema completo en cada request. Ponele que tenés un agente con 40 tools registradas: meter las 40 definiciones en el prompt lo infla y rompe el cache de prefijo apenas agregás una más. Con deferred tools, la tool queda en la grammar (el modelo puede invocarla) pero su descripción detallada no se renderiza hasta que hace falta.
Ahí entra el tool_reference content part: un bloque que revela una tool diferida justo antes de usarla, sin reescribir el resto del contexto ya procesado. El beneficio es concreto: menos tokens de sistema por turno y menos invalidación de cache en sesiones largas con catálogos grandes de herramientas, el caso típico de agentes conectados a decenas de servidores MCP (que no es poco, si pensás en integraciones reales con 50 o más tools activas). Tema relacionado: la comparativa entre Sonnet y Opus.
¿Qué cambia exactamente el PR #31256 en llama.cpp?
El PR #31256, que abrió el usuario tdakhran, llegó a master cuando ngxson lo mergeó el 27 de octubre de 2026, con 17 de 18 checks automáticos aprobados. El commit principal, eb7818c, la pieza central del PR, agrega el soporte de deferred tools y tool_reference content parts al módulo common de llama.cpp. El PR solicitó revisión de code owners como CISC, ggerganov y pwilkin antes del merge.
La rama original se llamaba tarek/lfm3/upstream/2-deferred-tools, lo que sugiere que el trabajo viene de la integración de LFM3, el modelo de LiquidAI, en llama.cpp. El PR tuvo tres commits en total: el soporte base, un segundo commit que suma a Aldehir Rojas como co-autor (Co-authored-by: Aldehir Rojas), y un tercero que corrige el chequeo de tipos en el test de deferred tools. Los tres llevan la etiqueta Assisted-by: Claude Opus 5.5, con co-autoría humana de Aldehir Rojas, en el mensaje de commit (spoiler: eso no significa que un humano no haya revisado cada línea).
¿Qué rol tuvo Claude Opus 5.5 en el desarrollo de este PR de llama.cpp?
Claude Opus 5.5 asistió la escritura de código del PR #31256, según indica la etiqueta Assisted-by en cada commit, pero no figura como autor. El mérito del diseño y el merge quedó en manos humanas: tdakhran, Aldehir Rojas y ngxson. El código corre en producción. No hay autoría de IA en el sentido formal del término.
Opus 5.5 es el modelo insignia de la familia Claude 5.5 de Anthropic, presentado como sucesor de Opus 5. Según el anuncio de Anthropic, disponible en su sitio oficial, rinde al nivel de Claude Fable 5.1 en la mayoría de tareas y cuesta 40% menos que Opus 5 en cargas de trabajo típicas. Los números de precio, vigentes al momento del anuncio, son concretos: Opus 5.5 cobra USD 4 por millón de tokens de entrada y USD 20 por millón de salida, un 20% menos que Opus 5, mientras que las lecturas de cache bajan a USD 0,20 por millón de tokens, un 60% menos. Eso importa para este tipo de PR porque buena parte del trabajo de “asistir” un commit de código es iterar sobre el mismo archivo una y otra vez, y ahí el cache hit ratio define el costo real.
En su propio material de lanzamiento, Anthropic cita a Mario Rodriguez, Chief Product Officer de GitHub: “en VS Code, resolvió más tareas de terminal que Opus 5 con menos de la mitad de los pasos”. No es una prueba específica sobre llama.cpp, pero da una idea del tipo de tarea (refactors largos, cambios multi-archivo) donde Anthropic posiciona a este modelo.
Otro dato del mismo comunicado: en una prueba interna, Anthropic le pidió a Opus 5.5 reescribir HAProxy, el software ampliamente utilizado para balancear tráfico web entre servidores, de C a Rust. Terminó en 9,5 horas, contra 12 horas de Claude Fable 5.1, con un costo 51% menor, y ambas reescrituras pasaron casi todos los tests de regresión propios de HAProxy. ¿Significa que Opus 5.5 “escribió” el PR de deferred tools solo? No, significa que alguien con acceso al modelo lo usó como copiloto en una tarea de ingeniería real, que es justo lo que dice el changelog.
¿Qué modelos y plataformas soportan hoy el deferred tool calling?
Hoy, el soporte confirmado de deferred tool calling en llama.cpp apunta a LFM3, el modelo de LiquidAI, que es justo el motivo por el que se abrió este PR: la rama original se llama tarek/lfm3/upstream/2-deferred-tools. El repo xybrid-ai referencia este trabajo en dos PRs propios, uno para soportar texto, tool calling y visión de LFM3, y otro para actualizar su fork de llama.cpp al commit que incluye esta función.
En builds, b11940 ofrece paquetes para Linux (x64, arm64, s390x), Windows (x64, arm64), macOS (Apple Silicon e Intel), iOS, Android (arm64 y Snapdragon con NPU Hexagon) y openEuler, con backends de CPU, CUDA 12 y 13, Vulkan, ROCm 10.0, SYCL (FP32 y FP16) y OpenVINO. Si pensás correr esto en un servidor propio, un VPS con GPU para inferencia, por ejemplo, conviene chequear primero qué backend soporta tu hardware, porque la tabla de builds cambia seguido entre release y release. Para infraestructura en Argentina, opciones como donweb.com cubren ese tipo de despliegue sin complicarte con drivers CUDA desde cero.
¿Qué límites tiene esta release al ser un pre-release?
b11940 está marcada como Pre-release en GitHub. La generó github-actions, no un maintainer a mano. Eso implica builds menos probados que una release estable: en este caso, el build de macOS Apple Silicon con KleidiAI habilitado aparece como DISABLED, igual que algunas variantes de openEuler.
El tema es que llama.cpp publica pre-releases con frecuencia, así que “pre-release” acá no implica inestabilidad grave, sino que todavía no pasó por el ciclo completo de validación de una release etiquetada como estable. Si vas a usar deferred tools en producción, el criterio práctico es simple: probalo primero contra tu propio set de tools, con tu propio harness de tests, antes de asumir que el comportamiento documentado en el PR es exactamente el que vas a ver en tu caso. Repasamos ese criterio de validación en nuestra guía completa sobre Claude.
Qué está confirmado y qué no sobre esta release
Confirmado, según el changelog oficial y el PR mergeado: el commit eb7818c agrega deferred tools y tool_reference content parts al módulo common, con tres commits etiquetados Assisted-by: Claude Opus 5.5, co-autoría de Aldehir Rojas, y 17 de 18 checks pasados antes del merge del 27 de octubre de 2026.
- Confirmado: el soporte está en master y se shipea en b11940, con builds disponibles para los principales sistemas operativos y backends.
- Confirmado: el trabajo está vinculado a la integración de LFM3 (LiquidAI) en llama.cpp, según el nombre de la rama y los PRs relacionados en xybrid-ai.
- No confirmado: qué porcentaje del código escribió Opus 5.5 versus los humanos del PR. El changelog no detalla ese split, solo marca “Assisted-by”.
- No confirmado: si otros modelos además de LFM3 ya usan deferred tool calling en producción con llama.cpp. No hay en las fuentes disponibles una lista cerrada de modelos soportados hoy.
Errores comunes al interpretar esta release
- Pensar que Opus 5.5 “escribió” el PR solo. El changelog dice Assisted-by, no Authored-by. La diferencia es real: hubo revisión humana de code owners antes del merge.
- Confundir deferred tools con lazy loading de pesos del modelo. No tiene que ver con cargar el modelo de forma diferida, sino con ocultar definiciones de tools en el prompt hasta que se necesitan.
- Asumir que b11940 es una release estable. Está etiquetada Pre-release y la generó github-actions, sin un ciclo de QA manual completo todavía.
- Dar por hecho que todos los modelos ya soportan deferred tool calling. La evidencia disponible apunta a LFM3 como caso de uso concreto, no a un soporte universal en todo lo que corre sobre llama.cpp.
Preguntas Frecuentes
¿Qué es la release b11940 de llama.cpp?
Es una pre-release del proyecto llama.cpp publicada el 28 de octubre de 2026, generada por github-actions, que incorpora el commit eb7818c con soporte para deferred tools y tool_reference content parts del PR #31256.
¿Qué son los deferred tools en llama.cpp?
Son herramientas que el modelo puede invocar según la grammar activa, pero cuya definición completa no se renderiza en el prompt hasta que un tool_reference content part la revela. Esto evita inflar el contexto con esquemas de tools que no se van a usar en ese turno.
¿Claude Opus 5.5 puede escribir código real para proyectos open source?
Según el changelog de llama.cpp, Opus 5.5 asistió los tres commits del PR #31256 con la etiqueta Assisted-by, aunque la autoría y el merge quedaron en manos de desarrolladores humanos. Anthropic también documentó casos como la reescritura de HAProxy de C a Rust en 9,5 horas, con un costo 51% menor que Claude Fable 5.1.
¿Qué modelos soportan deferred tool calling?
La evidencia disponible en el PR y en los repositorios relacionados confirma a LFM3, el modelo de LiquidAI, como el caso de uso que motivó esta función. La rama original del PR se llamaba tarek/lfm3/upstream/2-deferred-tools, y el repo xybrid-ai referencia este trabajo para integrar LFM3 con tool calling y visión.
¿Qué diferencia hay entre tool_reference y una tool call normal?
Una tool call normal es la invocación que hace el modelo cuando ya conoce la definición completa de la herramienta, cargada previamente en el prompt. Un tool_reference content part, en cambio, revela una tool que estaba diferida, sin necesidad de reescribir el prefijo del contexto ya cacheado.
Conclusión
La release b11940 de llama.cpp suma una pieza chica pero útil para quien corre agentes con muchas tools: deferred tools y tool_reference content parts resuelven un problema de cache y tamaño de prompt que cualquiera que haya armado un agente con 20 o 30 herramientas conoce de memoria. Que Claude Opus 5.5 aparezca como asistente en los commits es un dato más sobre cómo los equipos de código abierto ya usan modelos frontera para tareas de ingeniería real, no una garantía de que el código esté libre de revisión humana.
Si trabajás con llama.cpp y catálogos grandes de tools, lo que conviene hacer ahora es probar b11940 contra tu propio set antes de asumir el comportamiento documentado en el PR, justamente porque todavía es pre-release. Si el interés es por LFM3, vale la pena seguir los PRs de xybrid-ai, que son la referencia más concreta de integración disponible hoy.