
En pocas palabras: Un tutorial de dev.to del 16 de septiembre de 2026 explica cómo armar en 15 minutos un chatbot que combina DeepSeek, GLM y Qwen mediante Yingsuan AI, un gateway de terceros con endpoint único compatible con el SDK de OpenAI, 100 llamadas de prueba gratis y sin tarjeta de crédito.
Un tutorial publicado en dev.to el 16 de septiembre de 2026 muestra cómo armar un chatbot multi-modelo IA que combina DeepSeek, GLM y Qwen detrás de una sola API key, usando el gateway de terceros Yingsuan AI. La promesa del autor: tenerlo funcionando en unos 15 minutos, con 100 llamadas de prueba gratis y sin pedir tarjeta de crédito.
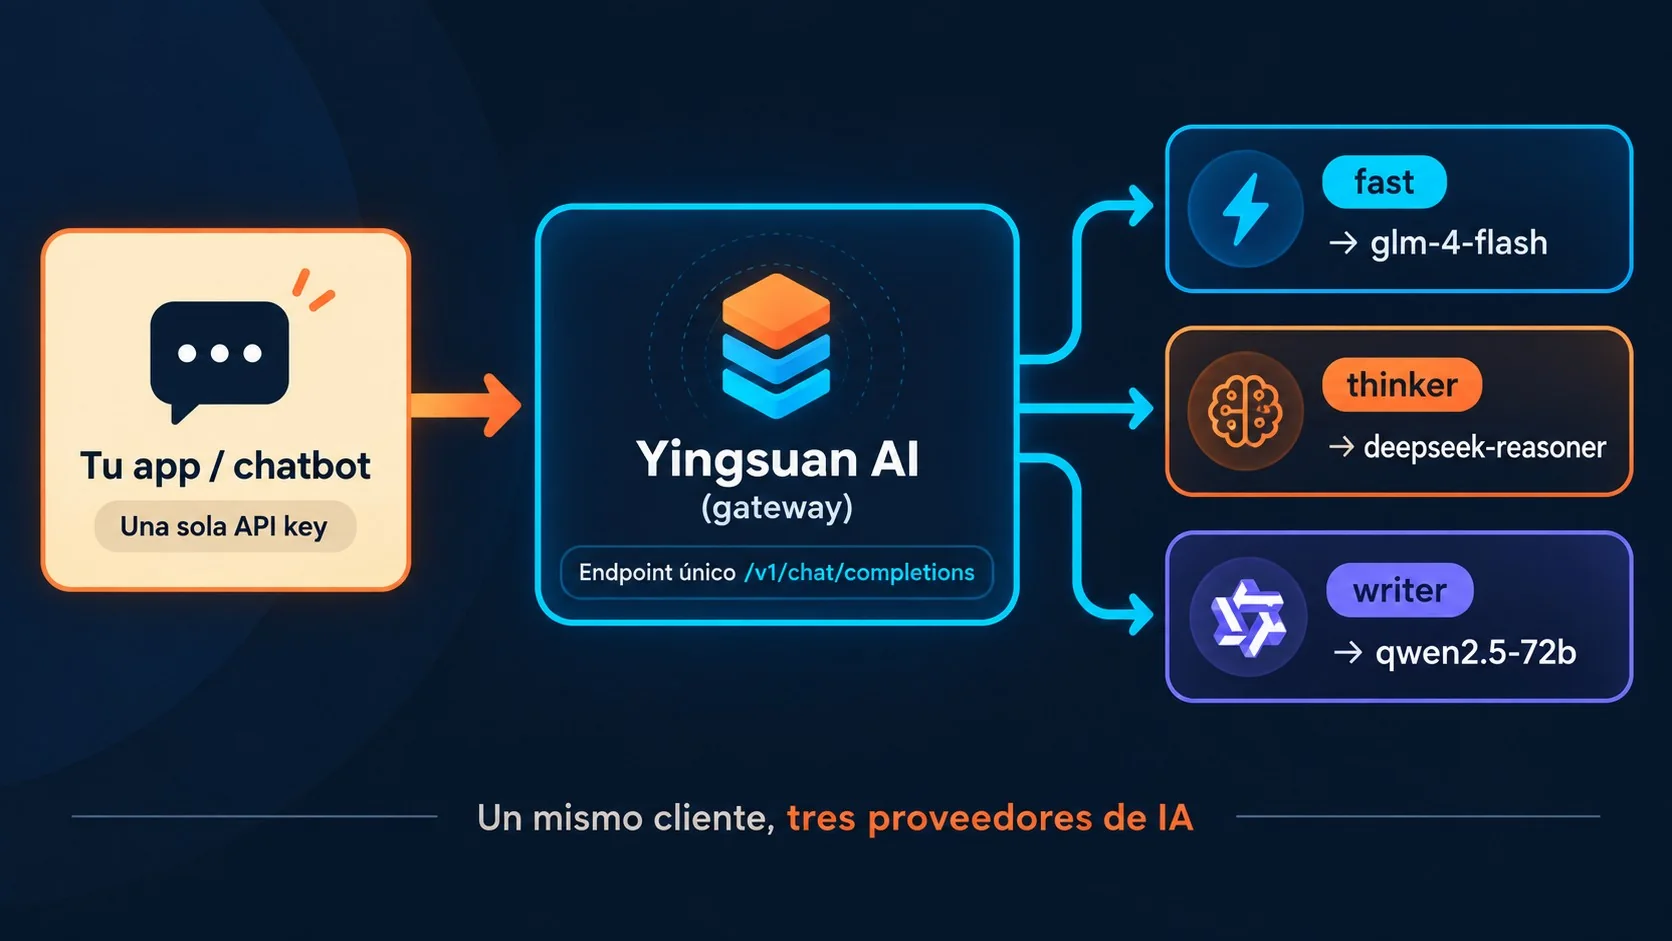
Un chatbot multi-modelo IA es una aplicación que enruta cada mensaje a distintos modelos de lenguaje según la tarea, en vez de atarse a uno solo. Yingsuan AI es un servicio intermediario, no oficial de DeepSeek, Zhipu (dueño de GLM) ni Alibaba (dueño de Qwen), que expone un único endpoint compatible con el protocolo /v1/chat/completions de OpenAI en yingsuan.top/v1.
En este artículo:
- En 30 segundos
- ¿Qué es Yingsuan AI, el gateway detrás de esta guía?
- ¿Cómo funciona el enrutamiento entre DeepSeek, GLM y Qwen en el código?
- ¿Qué modelos incluye y cuáles son realmente gratis?
- ¿Qué limitaciones y riesgos tiene depender de un gateway no oficial?
- ¿Conviene usar este enfoque en vez de las APIs oficiales de cada proveedor?
- Qué está confirmado y qué no
- Errores comunes al armar un chatbot multi-modelo IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Yingsuan AI expone un endpoint único compatible con el SDK de OpenAI para acceder a DeepSeek, GLM y Qwen con una sola API key, según el tutorial original.
- El ejemplo en Python define cinco alias de modelo (fast, smart, thinker, writer, coder); el ejemplo en Node.js, con tres alias (fast, smart, thinker), arma el chatbot completo en unas 40 líneas.
- Cada API key nueva viene con 100 llamadas de prueba gratis; glm-4-flash y un modelo chico de Qwen quedan gratis de forma permanente, según describe la fuente.
- El método
switch()permite cambiar de modelo en medio de una conversación sin perder el historial de mensajes previos. - No hay verificación independiente de precios, cuotas ni disponibilidad futura del servicio: son datos que aporta la propia empresa que lo vende.
¿Qué es Yingsuan AI, el gateway detrás de esta guía?
Yingsuan AI es un gateway de terceros que reempaqueta las respuestas de DeepSeek, GLM y Qwen bajo un formato único compatible con OpenAI. No lo fabrica ninguno de esos tres proveedores. Es una capa intermedia que traduce las llamadas a cada API real y las devuelve con la misma estructura de respuesta, sin importar qué modelo respondió.
Ojo con esto: el artículo que enseña a usarlo lo publicó una cuenta identificada como yingsuan_ai en dev.to, el mismo 16 de septiembre de 2026 según figura en la publicación. No es una nota independiente de un medio técnico evaluando el servicio; es contenido de la propia empresa mostrando cómo usar lo que vende (spoiler: eso no lo hace falso, pero sí lo vuelve una fuente que hay que leer con ese filtro puesto).
Para arrancar hace falta una API key gratuita, sin tarjeta de crédito, con 100 llamadas de prueba incluidas. El endpoint base es https://yingsuan.top/v1 y el mismo SDK oficial de OpenAI, tanto en Python 3.9+ como en Node.js 18+, funciona sin modificaciones: solo cambian el base_url y el api_key.
¿Cómo funciona el enrutamiento entre DeepSeek, GLM y Qwen en el código?
El enrutamiento funciona con un diccionario de alias que mapea nombres cortos a los identificadores reales de cada modelo; cambiar de modelo es reemplazar ese string en el parámetro model de la llamada, sin tocar nada más del código. Cubrimos ese tema en detalle en entender cómo funcionan los modelos de lenguaje.
La clase MultiModelChatbot en Python guarda el historial de la conversación en una lista simple de mensajes con formato OpenAI (rol y contenido) y tiene un método switch(model_key) que cambia el modelo activo. Lo interesante es que ese historial se mantiene intacto aunque saltes de un modelo a otro en medio de la charla: arrancás con glm-4-flash para el saludo, pasás a deepseek-reasoner para resolver una cuenta de velocidad promedio, y el bot sigue teniendo memoria de todo lo anterior porque el formato de mensajes es el mismo para los tres proveedores.
La versión en JavaScript hace lo mismo en un CLI interactivo: el usuario escribe /model thinker para pasar al modelo de razonamiento antes de una pregunta difícil, y /model fast para volver al modelo gratuito después. Según el propio tutorial, todo el armado (cliente, historial, comando de switch) entra en unas 40 líneas.
¿Qué modelos incluye y cuáles son realmente gratis?
El ejemplo de código define cinco alias: fast, smart, thinker, writer y coder, cada uno apuntando a un modelo real distinto según la tarea. Acá va el detalle tal como lo describe la fuente:
| Alias | Modelo real | Uso sugerido según la fuente | Costo |
|---|---|---|---|
| fast | glm-4-flash | Chat casual, respuestas rápidas | Gratis permanente |
| smart | deepseek-chat | Uso general, modelo todoterreno | Cupo pago tras las 100 llamadas gratis |
| thinker | deepseek-reasoner | Matemática y lógica paso a paso | Cupo pago tras las 100 llamadas gratis |
| writer | qwen2.5-72b | Generación de texto largo | Cupo pago tras las 100 llamadas gratis |
| coder | deepseek-v3 | Tareas de código | Cupo pago tras las 100 llamadas gratis |
Acá hay un matiz que conviene marcar. En la sección de precios del propio tutorial se menciona que glm-4-flash y qwen2.5-7b quedan gratis para siempre. Pero el alias writer del código de ejemplo usa qwen2.5-72b, un modelo más grande que no aparece mencionado entre los gratuitos permanentes. Es decir: el modelo Qwen que se usa para textos largos en el ejemplo probablemente no sea el mismo que queda gratis de forma indefinida. La fuente no aclara esa diferencia, así que tomalo con pinzas antes de armar tu tier gratuito pensando que todo Qwen es gratis. Más contexto en elegir el modelo de IA correcto.
¿Qué limitaciones y riesgos tiene depender de un gateway no oficial?
El riesgo principal es que la disponibilidad, los precios y la vigencia de los modelos gratuitos dependen de las políticas de Yingsuan AI, no de DeepSeek, Zhipu ni Alibaba. Si el gateway cambia condiciones, sube precios o directamente cierra, tu chatbot deja de funcionar de un día para el otro, sin que ninguno de los tres proveedores originales tenga responsabilidad ni obligación de avisarte.
- Dependencia de un solo intermediario: si Yingsuan AI cae o cambia su API, perdés acceso a los tres modelos al mismo tiempo, aunque cada proveedor original siga funcionando de forma normal.
- Cero verificación independiente de precios y cuotas: las cifras de “100 llamadas gratis” y “modelos permanentemente gratis” las publica la propia empresa que vende el servicio, sin auditoría externa que las respalde.
- Falta de soporte oficial: si un modelo devuelve un error o un comportamiento raro, no podés reclamarle a DeepSeek o Alibaba directamente porque técnicamente no sos cliente de ellos, sino de un tercero.
- Riesgo de vendor lock-in inverso: aunque el gateway promete portabilidad entre modelos, tu app queda atada a la infraestructura y a las decisiones de negocio de Yingsuan AI.
¿Alguien evaluó de forma independiente la estabilidad de este servicio o el cumplimiento real de esas cuotas gratuitas? Todavía no hay ese dato disponible públicamente.
¿Conviene usar este enfoque en vez de las APIs oficiales de cada proveedor?
Depende de qué priorices: si buscás velocidad de prototipo y un solo secreto para administrar, el gateway gana; si buscás control, soporte directo y garantías contractuales, las APIs oficiales de cada proveedor ganan.
La ventaja concreta del enfoque de un solo endpoint es la que describe la fuente: un secreto para rotar, una sola variable de entorno, y la posibilidad de sumar un modelo nuevo cambiando un string en un diccionario. Nada de migrar SDK, nada de reescribir lógica de reintentos para cada proveedor. Para un prototipo, una prueba de concepto o un proyecto personal, ese ahorro de fricción es real y no hay que subestimarlo. Relacionado: proteger tu modelo con firewall y nginx.
El tema es que las APIs oficiales de DeepSeek, de Zhipu (GLM) y de Alibaba (Qwen) te dan trazabilidad directa de facturación, canales de soporte propios y, en general, mejor documentación de límites de tasa y políticas de uso. Si tu chatbot va a producción con usuarios reales pagando, evaluar esa opción en paralelo no es capricho: es la diferencia entre depender de un intermediario que podés perder de vista y tener el contrato directo con quien entrena el modelo.
Qué está confirmado y qué no
- Confirmado por la fuente: el gateway usa el protocolo
/v1/chat/completionscompatible con OpenAI, ofrece 100 llamadas de prueba gratis por key nueva y mantiene gratis de forma permanente aglm-4-flashyqwen2.5-7b. - Confirmado por la fuente: el código de ejemplo (Python y Node.js) funciona con la clase estándar del SDK de OpenAI, sin dependencias adicionales.
- No confirmado de forma independiente: vigencia futura de las cuotas gratuitas, tiempos de respuesta reales de cada modelo a través del gateway, y si los precios pagos son competitivos frente a usar cada API oficial por separado.
- No confirmado: ningún dato sobre uptime, políticas de privacidad de datos que pasan por el gateway, ni acuerdos formales entre Yingsuan AI y DeepSeek, Zhipu o Alibaba.
Errores comunes al armar un chatbot multi-modelo IA
- Asumir que “gratis permanente” es garantía contractual: es una política que puede cambiar sin aviso previo si el gateway lo decide. No lo uses como base de un producto comercial sin un plan B.
- Mezclar historiales de conversación entre modelos con formatos distintos: si en algún momento agregás un modelo que no respeta el formato de mensajes de OpenAI, el historial compartido se rompe silenciosamente y las respuestas empiezan a venir raras.
- No loguear qué modelo respondió cada mensaje: sin ese registro, es imposible después auditar costos, calidad de respuesta por modelo o depurar por qué el bot contestó mal algo puntual.
- Probar solo en local y asumir que el comportamiento en producción va a ser igual: subís el código, lo probás con dos o tres mensajes de prueba, funciona bárbaro, lo mandás a producción y ahí aparecen los límites de tasa reales, la latencia bajo carga y los casos borde que en la demo nunca salieron.
Preguntas Frecuentes
¿Qué es Yingsuan AI y para qué sirve?
Yingsuan AI es un gateway de terceros que da acceso a modelos de DeepSeek, GLM y Qwen a través de un único endpoint compatible con el SDK de OpenAI. Sirve para armar aplicaciones que usan varios modelos sin tener que manejar tres cuentas, tres SDKs y tres sistemas de facturación por separado.
¿Cómo puedo usar DeepSeek, GLM y Qwen con una sola API key?
Registrando el base_url del gateway (https://yingsuan.top/v1) y una sola API key en el cliente de OpenAI, y después eligiendo qué modelo llamar cambiando el parámetro model en cada request. El código de ejemplo lo resuelve con un diccionario de alias como fast, smart o thinker.
¿Es gratis usar el gateway de Yingsuan AI?
Cada API key nueva incluye 100 llamadas de prueba gratis, y dos modelos (glm-4-flash y qwen2.5-7b) quedan gratis de forma permanente según la fuente. El resto de los modelos, como deepseek-reasoner o qwen2.5-72b, pasan a un plan pago una vez agotada la cuota gratuita. Tema relacionado: las novedades de Copilot en 2026.
¿Qué modelo conviene usar para cada tipo de tarea?
Según el ejemplo del tutorial, glm-4-flash sirve para chat casual y respuestas rápidas, deepseek-reasoner para matemática y lógica paso a paso, deepseek-v3 para tareas de código y qwen2.5-72b para generación de texto largo. Son recomendaciones del propio artículo, no benchmarks comparados de forma independiente.
¿Conviene usar un gateway de terceros en vez de las APIs oficiales de cada proveedor?
Para prototipos y proyectos personales, un gateway de terceros ahorra tiempo de integración porque unifica tres SDKs en uno. Para productos en producción con usuarios pagando, conviene evaluar en paralelo las APIs oficiales de DeepSeek, Zhipu y Alibaba, que dan soporte directo y trazabilidad de facturación propia.
Conclusión
Lo que cambia con este tutorial no es la tecnología de fondo (los modelos de DeepSeek, GLM y Qwen ya existían y ya eran accesibles vía API), sino la fricción para combinarlos en un mismo proyecto. Un diccionario de alias y un solo cliente de OpenAI alcanzan para armar un chatbot que rutea entre tres proveedores distintos, algo que antes implicaba manejar tres integraciones separadas.
Ahora bien, antes de sumar este gateway a un proyecto real, el criterio práctico es simple: probalo primero con el cupo gratuito, medí latencia y calidad de respuesta por modelo, y guardá un registro de qué modelo contestó cada mensaje. Con esos datos en mano vas a poder decidir si te conviene quedarte con el intermediario o migrar directamente a las APIs oficiales de cada proveedor una vez que el proyecto crezca.