
En pocas palabras: Un servidor MCP vía stdio hereda los privilegios del proceso que lo lanza, y ese lanzamiento es el punto que nadie controla. CVE-2026-46519 (mcp-server-kubernetes, corregido en v3.6.0) y CVE-2026-85660 (cli-mcp-server, CVSS 9.2) prueban que filtrar herramientas después del arranque no alcanza sin un control default-deny previo al spawn.
Hay una pregunta que casi nadie se hace cuando configura un servidor MCP local: ¿quién decidió que este proceso podía arrancar, con este comando exacto, con estos privilegios? No es una pregunta retórica. Para septiembre de 2026 ya hay vulnerabilidades concretas que muestran qué pasa cuando esa pregunta queda sin respuesta: CVE-2026-46519 en mcp-server-kubernetes y CVE-2026-85660 en cli-mcp-server (este último con CVSS 9.2) demuestran que filtrar la lista de herramientas después de que el proceso ya está corriendo llega, literalmente, un paso tarde.
La seguridad MCP stdio es el conjunto de controles que deciden si un servidor del Model Context Protocol puede arrancar, con qué comando, argumentos y credenciales, antes de que ese proceso exista. MCP (Model Context Protocol) es el estándar que definió Anthropic para conectar modelos de lenguaje con herramientas externas vía JSON-RPC, y stdio es uno de sus transportes: el que ejecuta un proceso local con acceso directo al sistema operativo del host. La idea central que conviene retener de todo este análisis es simple de enunciar y bastante más incómoda de aceptar: una vez que el proceso existe, ya es tarde para ponerle reglas.
En este artículo:
- En 30 segundos
- ¿Qué vulnerabilidades reales expusieron el problema del transporte stdio en MCP?
- ¿Por qué el filtrado en tools/list no garantiza seguridad en tools/call?
- ¿Cuál es el momento real donde se decide la seguridad MCP stdio de un servidor?
- ¿Qué es el modelo default-deny pre-spawn que propone la fuente?
- ¿Qué criterios usar para priorizar qué servidores MCP necesitan el gate primero?
- ¿Qué respondió Anthropic sobre el diseño de stdio en los SDKs de MCP?
- ¿Qué alternativas y mitigaciones concretas existen hoy?
- Qué está confirmado y qué no
- Errores comunes al asegurar servidores MCP con stdio
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- CVE-2026-46519 (mcp-server-kubernetes, corregido en v3.6.0) filtraba
tools/listpero no bloqueabatools/call, permitiendo ejecutarkubectl_deleteyexec_in_podigual. - CVE-2026-85660 (cli-mcp-server) tiene CVSS 9.2 crítico: bypass del allowlist de comandos vía sustitución de shell cuando
ALLOW_SHELL_OPERATORSestaba activo. - La Cloud Security Alliance estimó 150 millones de descargas de paquetes afectados, ~7.000 servidores públicamente alcanzables y ~200.000 despliegues vulnerables, con 14+ CVEs asociados.
- Anthropic calificó como “esperado” que los SDKs de MCP pasen el comando al shell sin sanitizar, dejando esa tarea a cada desarrollador.
- El modelo default-deny pre-spawn propone decidir, vincular a una identidad, aprobar y dejar registro antes de que el proceso arranque, no después.
¿Qué vulnerabilidades reales expusieron el problema del transporte stdio en MCP?
Tres casos documentados en 2026 muestran que el riesgo del transporte stdio en MCP no es teórico: CVE-2026-46519, CVE-2026-85660 y el conjunto de fallas que analizó la Cloud Security Alliance (CSA) en LiteLLM, Bisheng y Flowise. Vistos por separado parecen tres bugs distintos en tres proyectos distintos. Vistos juntos, apuntan al mismo punto ciego: nadie controla qué se ejecuta antes de que el proceso arranque.
Empecemos por el más citado. CVE-2026-46519 afecta a mcp-server-kubernetes, un paquete npm que quedó vulnerable en todas las versiones anteriores a la 3.6.0. El bug, publicado el 17 de mayo de 2026 y catalogado como severidad alta según el advisory de GitHub GHSA-cr22-wjx7-2w6m, permitía saltarse variables de entorno como ALLOWED_TOOLS y ALLOW_ONLY_READONLY_TOOLS con un truco tan simple que sorprende que haya pasado desapercibido: esas restricciones solo se chequeaban al mostrar la lista de herramientas, no al ejecutarlas.
Después está CVE-2026-85660, en cli-mcp-server, con un CVSS de 9.2 (crítico). Acá el problema es un bypass del allowlist de comandos mediante sustitución de shell, activo cuando el flag ALLOW_SHELL_OPERATORS estaba encendido. El allowlist existe, se ejecuta, hace su trabajo… hasta que armás el input de determinada manera y desaparece.
Ejemplo hipotético (no corresponde a un incidente reportado, es una ilustración del mecanismo de CVE-2026-46519): imaginemos a un responsable de seguridad que configuró ALLOWED_TOOLS para bloquear operaciones destructivas en un clúster de Kubernetes gestionado vía MCP. Revisó la documentación, probó que la herramienta kubectl_delete no aparecía en la lista que el servidor devolvía al cliente, y dio por cerrado el tema. Según el mecanismo descrito en el advisory, un cliente mal configurado (o un actor malicioso que conociera el nombre exacto de la herramienta) podría haber invocado kubectl_delete directamente por su identificador, sin pasar por la lista filtrada, porque el chequeo de restricción vivía en el handler de presentación y no en el de ejecución. El punto del ejemplo no es narrar un caso real, sino mostrar por qué “no aparece en la lista” y “no se puede ejecutar” son afirmaciones distintas que, en este bug, no coincidían.
El tercer caso es el más grande en escala. La investigación de CSA sobre el diseño de stdio en los SDKs de MCP identificó que los comandos configurados se pasan al shell de forma incondicional, y el comando se ejecuta aunque el proceso objetivo falle al iniciar. Esto afecta a LiteLLM (CVE-2026-30623), Bisheng (CVE-2026-33224) y Flowise (CVE-2026-40933). CSA calculó, según el análisis publicado en dev.to, unos 150 millones de descargas de paquetes con este patrón, cerca de 7.000 servidores públicamente alcanzables, aproximadamente 200.000 despliegues vulnerables y más de 14 CVEs relacionados.
¿Por qué el filtrado en tools/list no garantiza seguridad en tools/call?
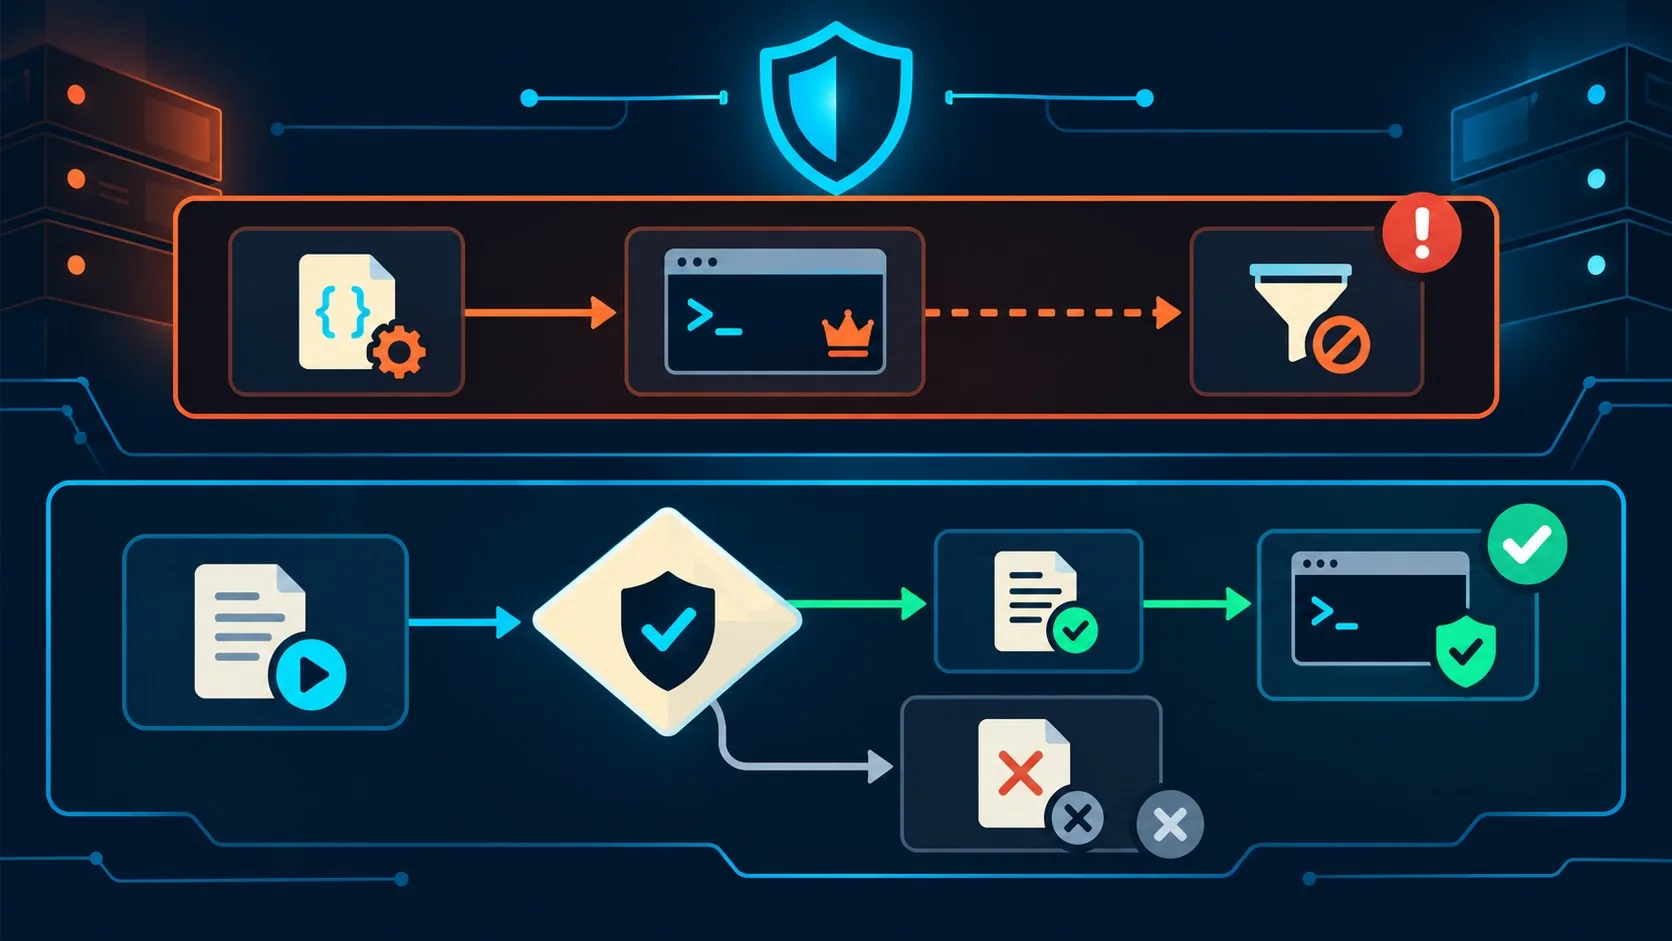
Porque son dos capas de código distintas que pueden desincronizarse, y CVE-2026-46519 es la prueba de que efectivamente se desincronizan. El handler que arma la respuesta de tools/list aplicaba las variables de restricción; el handler que ejecuta tools/call las ignoraba por completo. Resultado: la lista de herramientas mentía. Lo explicamos a fondo en las diferencias entre API y MCP.
Esto no es un detalle menor de implementación. Es el síntoma de un problema de diseño más amplio: pensar que restringir la presentación de las herramientas equivale a restringir su ejecución. No es lo mismo, y conviene marcarlo así de tajante: una lista de herramientas es una interfaz, no un control de acceso. Un cliente MCP podía consultar la lista, ver que kubectl_delete no aparecía o figuraba como bloqueado, y llamarlo igual por nombre, porque el código que realmente dispara el comando nunca chequeaba esa restricción.
¿Alguien verificó esto de forma independiente antes de que saliera el parche? Sí, quedó confirmado en NVD y en el advisory de GitHub, con severidad alta y ruta de explotación documentada. La corrección llegó en la versión 3.6.0 de mcp-server-kubernetes, pero el patrón de fondo (dos capas de autorización que no comparten la misma fuente de verdad) puede repetirse en cualquier servidor MCP que separe “qué muestro” de “qué ejecuto” sin una capa común que gobierne ambas decisiones. Vale la pena leerlo así, como patrón reutilizable, más que como bug puntual: cualquier arquitectura que tenga un handler de listado y un handler de ejecución separados corre el mismo riesgo si no comparten la misma fuente de reglas.
¿Cuál es el momento real donde se decide la seguridad MCP stdio de un servidor?
La decisión que importa ocurre antes de que el proceso exista, no en cada llamada a una herramienta. Para cuando llega un tools/call, el proceso ya tiene los privilegios completos del host, así que cualquier control puesto ahí adentro es, como plantea el análisis original, “una lomada de burro dentro del radio de la explosión”, no una frontera real.
La mayoría de los escritos sobre seguridad de agentes arranca la pregunta al revés: “¿cómo autorizo cada llamada a una herramienta?”. El tema es que esa llamada ocurre dentro de un proceso que el host ya lanzó con privilegios completos. Filtrar ahí adentro no separa “una herramienta que ejecuta comandos” de “un atacante que ejecuta comandos”.
La pregunta que sí separa esas dos cosas es otra: ¿este servidor tiene permiso para lanzarse, con este comando, estos argumentos, este entorno, bajo esta delegación, aprobado por quién? Esa decisión pasa una sola vez, antes del spawn, y una vez que el proceso arranca ya es tarde para corregirla desde adentro. Te puede servir nuestra cobertura de cómo aislar tu modelo de IA.
Hay dos formas concretas en las que esto falla, y las dos ocurren antes de cualquier gate de tools/call: la primera es cuando la configuración misma se vuelve vector de ataque (un paquete de npm o PyPI comprometido, una config de editor con contenido malicioso, un pull request que “ayuda” agregando un servidor útil) porque cualquier cosa que escriba un campo command en la config de MCP tiene, a partir de ese momento, un camino sin autenticación hacia ejecución arbitraria de shell en el próximo lanzamiento, sin que ningún modelo de lenguaje esté siquiera involucrado; la segunda es el desfase entre presentación y ejecución que ya vimos en CVE-2026-46519, donde quien despliega el servidor cree que aplicó el principio de mínimo privilegio porque la lista de herramientas así lo indica, mientras la capa que realmente ejecuta los comandos opina otra cosa.
¿Qué es el modelo default-deny pre-spawn que propone la fuente?
El modelo default-deny pre-spawn consiste en gobernar el lanzamiento del servidor MCP, no solo sus llamadas posteriores, mediante cuatro pasos que ocurren antes de que el host haga fork del proceso. Si el que pide el lanzamiento no puede mostrar un permiso explícito más una aprobación registrada para el comando exacto que está por ejecutarse, se deniega. Así de simple.
- Decidir: chequear si la combinación de servidor, ruta del comando, argumentos, entorno e identidad de ejecución está en el allowlist, usando la ruta absoluta al binario (hardcodeada), no un string derivado que alguien pueda manipular.
- Vincular a una delegación: ese lanzamiento específico tiene que estar autorizado por un usuario, un agente y un propósito acotado concretos, no por “el editor de quien sea que lo tenga abierto”.
- Aprobar: exigir un gate humano para cualquier servidor que llegue a shell, credenciales o archivos, la clase que la fuente llama “tier-0 de cadena de suministro”, con el mismo criterio que se usaría para aprobar un cambio en producción.
- Registrar antes del efecto: emitir un registro de decisión (quién, qué, con qué identidad, aprobado por quién) antes del spawn, para que el lanzamiento sea auditable desde el origen y no algo que hay que reconstruir después revisando logs.
Lo interesante de este enfoque es que separa la decisión (que vive del lado del cliente o del agente) del efecto (el proceso ya lanzado), para que no puedan desalinearse como se desalinearon la lista y la ejecución en CVE-2026-46519. El registro de decisión, además, tiene que anclarse fuera del propio servidor auditado y ser recalculable en una revisión posterior, porque si el registro vive adentro del mismo proceso que estás auditando, cualquiera que comprometa ese proceso también puede borrar la evidencia.
Volviendo al ejemplo hipotético del responsable de seguridad: bajo este modelo, la revisión no habría terminado cuando kubectl_delete desapareció de la lista visible. Habría terminado cuando existiera un registro, generado antes de que el servidor arrancara, de que ese servidor específico (con ese comando, esos argumentos, esa identidad) fue aprobado para correr con esas restricciones exactas. La diferencia entre los dos escenarios es exactamente la diferencia entre confiar en una interfaz y confiar en un registro auditable.
¿Qué criterios usar para priorizar qué servidores MCP necesitan el gate primero?
Implementar un gate default-deny pre-spawn para absolutamente todos los servidores MCP de una organización de una sola vez no suele ser realista. Tiene sentido, entonces, priorizar según el riesgo real que cada servidor representa. Estos son cuatro criterios que se desprenden de los propios casos analizados y que sirven como punto de partida para ordenar ese trabajo:
- Radio de explosión del comando. Un servidor que puede ejecutar
kubectl_delete, borrar archivos o modificar infraestructura pesa distinto que uno que solo lee datos. Los servidores con capacidad de escritura o destrucción (la categoría que CVE-2026-46519 y CVE-2026-85660 comprometían) deberían ser los primeros en pasar por el gate. - Origen de la configuración. Si el campo
commanddel servidor se arma a partir de una dependencia externa (un paquete npm, una extensión de editor, un template compartido), el riesgo de que ese comando se modifique sin que nadie lo note es mayor que si es un binario fijo mantenido internamente. - Alcance de red. Un servidor accesible desde fuera de la red interna, aunque sea indirectamente, hereda el mismo problema que CSA describió a escala: miles de despliegues alcanzables sin que el operador lo supiera. Ese subconjunto conviene tratarlo como prioritario, no como excepción.
- Flags que amplían la superficie de ejecución. Cualquier variable de entorno del estilo de
ALLOW_SHELL_OPERATORS, que habilita sustitución de shell o comandos compuestos, es en sí misma una señal de que ese servidor necesita el gate antes que otros donde esa opción está desactivada.
Ninguno de estos criterios reemplaza al modelo de cuatro pasos descrito arriba; son, más bien, una forma de decidir por dónde empezar cuando los recursos para auditar son limitados y no todos los servidores MCP de una organización pueden revisarse en la misma semana.
¿Qué respondió Anthropic sobre el diseño de stdio en los SDKs de MCP?
Según la investigación de CSA citada en el análisis original, Anthropic calificó como “esperado” (expected) el comportamiento por el cual los SDKs de MCP pasan el comando configurado al shell sin condiciones, ejecutándolo incluso cuando el proceso objetivo falla al iniciar, y dejó la tarea de sanitizar esa entrada en manos de cada desarrollador que integra el protocolo.
Esa postura es, técnicamente, defendible: un SDK no puede anticipar todos los contextos de uso, y delegar la sanitización a quien integra el servidor es una decisión de diseño razonable en abstracto. El problema es la consecuencia práctica. Con 150 millones de descargas de paquetes que heredan este patrón y catorce o más CVEs derivados según los números de CSA, “esperado” terminó significando “explotado en la práctica” en varios proyectos concretos: LiteLLM, Bisheng y Flowise entre ellos.
¿Esto significa que MCP como protocolo está mal diseñado? No necesariamente. Significa que dejó sin estandarizar una capa que, para la fuente original, debería ser parte del protocolo mismo: el gate previo al lanzamiento. Ese vacío es el que cada implementación termina resolviendo (o no resolviendo) por su cuenta, con resultados muy dispares, y es también la razón por la que los criterios de priorización de la sección anterior tienen sentido: mientras el protocolo no lo resuelva de forma nativa, la responsabilidad de decidir qué servidor audita primero cada equipo sigue siendo un trabajo manual.
¿Qué alternativas y mitigaciones concretas existen hoy?
La recomendación más concreta que da CSA es directa: si un transporte HTTP gobernado alcanza para tu caso de uso, desactivá stdio. Reservá stdio solo para los escenarios donde el aislamiento de proceso por cliente es justamente lo que necesitás, como firma de operaciones o acceso a claves, y ahí sí gatee el lanzamiento con el modelo default-deny.
Una buena implementación separa la decisión del efecto para que no puedan derivar por separado, como pasó en CVE-2026-46519, y ancla el registro de decisión fuera del servidor auditado, de forma que sea recalculable si alguien lo revisa después. Si tu equipo corre estos servidores en infraestructura propia, ya sea un VPS o un servidor dedicado, contar con un proveedor confiable para dominios y hosting en Argentina como donweb.com ayuda a que al menos la capa de red y el aislamiento entre entornos no sumen otro punto ciego a la lista.
La fuente original menciona a un producto de terceros que aplica un esquema de autorización más evidencia, con registros de decisión por llamada atados a identidad y argumentos. Vale aclarar que esto es un dato de contexto tomado de la fuente, no una recomendación editorial de este medio: la fuente misma admite que es “guía y una forma de runtime, no la afirmación de que un producto resuelve esto de punta a punta”. El gate de lanzamiento previo al spawn sigue siendo la capa que los diseñadores del protocolo decidieron no estandarizar, y eso vale independientemente de qué herramienta se use para implementarlo.
Qué está confirmado y qué no
- Confirmado: CVE-2026-46519 está verificado en NVD y en GitHub Advisory Database (GHSA-cr22-wjx7-2w6m), con parche disponible desde mcp-server-kubernetes v3.6.0.
- Confirmado: CVE-2026-85660 tiene CVSS 9.2 crítico y afecta a cli-mcp-server vía bypass de allowlist por sustitución de shell.
- Confirmado: los CVEs de LiteLLM, Bisheng y Flowise (CVE-2026-30623, CVE-2026-33224, CVE-2026-40933) comparten el patrón de ejecución incondicional del comando en el shell, según la investigación de CSA.
- No verificado de forma independiente: las cifras de 150 millones de descargas, ~7.000 servidores alcanzables y ~200.000 despliegues vulnerables provienen de la estimación de CSA citada en la fuente original; no hay, hasta ahora, una auditoría pública separada que las replique con metodología propia.
- No confirmado: si Anthropic va a estandarizar en el protocolo un gate de lanzamiento pre-spawn como el que propone la fuente. Por ahora sigue siendo una recomendación de terceros, no una especificación oficial.
Errores comunes al asegurar servidores MCP con stdio
- Confiar en el filtrado de tools/list como control de seguridad. Como mostró CVE-2026-46519, esa lista puede mentir. La corrección real es validar en la capa de ejecución, no solo en la de presentación.
- Dejar comandos como strings derivados en la config. Si el
commandse arma dinámicamente a partir de variables que otro proceso puede tocar, cualquier compromiso de la cadena de suministro (un paquete de npm, una config de editor) se convierte en ejecución arbitraria. La ruta al binario debería ser absoluta y fija. - Activar flags como ALLOW_SHELL_OPERATORS sin entender el alcance. CVE-2026-85660 explotó exactamente ese flag en cli-mcp-server. Si no necesitás operadores de shell, no los habilites.
- Asumir que HTTP y stdio tienen el mismo perfil de riesgo. No lo tienen. Stdio ejecuta un proceso local con privilegios del host; un transporte HTTP gobernado permite aplicar controles de red y autenticación que stdio, por diseño, no tiene.
- Tratar el gate pre-spawn como un proyecto de todo o nada. Auditar y gatear cada servidor MCP a la vez rara vez es viable. Priorizar por radio de explosión, origen de la configuración y alcance de red (ver la sección de criterios más arriba) permite avanzar sin bloquear todo el trabajo hasta tener el sistema completo.
Preguntas Frecuentes
¿Qué es el problema de autorización en el transporte stdio de MCP?
Es que la decisión de seguridad relevante ocurre después de que el proceso ya tiene privilegios completos del host, en lugar de antes del lanzamiento. Para cuando llega una llamada a una herramienta (tools/call), cualquier control dentro del proceso ya llega tarde, porque el proceso mismo es el privilegio.
¿Qué vulnerabilidades se descubrieron en servidores MCP en 2026?
Las principales documentadas en 2026 son CVE-2026-46519 (mcp-server-kubernetes, filtrado cosmético de tools/list), CVE-2026-85660 (cli-mcp-server, CVSS 9.2, bypass de allowlist por sustitución de shell) y el grupo identificado por CSA en LiteLLM, Bisheng y Flowise por ejecución incondicional de comandos en el shell.
¿Cómo funciona la ejecución de comandos en un servidor MCP vía stdio?
El cliente MCP lanza el servidor como un subproceso local pasándole un comando, argumentos y variables de entorno definidos en la configuración. Según la investigación de CSA, ese comando se pasa al shell de forma incondicional y puede ejecutarse aunque el proceso objetivo falle al iniciar, lo cual amplía la superficie de ataque si la configuración está comprometida.
¿Qué es el modelo default-deny pre-spawn para servidores MCP?
Es un esquema de cuatro pasos (decidir, vincular a delegación, aprobar y registrar) que se ejecuta antes de que el host lance el proceso del servidor MCP. Si no hay un permiso explícito y una aprobación registrada para el comando exacto que se va a ejecutar, el lanzamiento se deniega por defecto.
¿Por qué el filtrado de tools/list no protege contra tools/call?
Porque son dos handlers de código distintos que pueden aplicar reglas diferentes, y CVE-2026-46519 probó que efectivamente lo hacían: las variables de restricción se chequeaban al listar herramientas pero no al ejecutarlas, permitiendo llamar directamente a herramientas destructivas por nombre.
Conclusión
Lo que dejan claro estos cuatro CVEs de 2026 es que la seguridad MCP stdio no se resuelve poniendo más controles adentro del proceso que ya está corriendo. Se resuelve un paso antes: decidiendo si ese proceso tiene permiso para existir, con ese comando exacto, bajo esa identidad, con aprobación registrada. CVE-2026-46519 mostró que confiar en el filtrado de tools/list es una ilusión de control, algo que el ejemplo hipotético del responsable de seguridad intenta ilustrar sin dramatizarlo más de lo que el bug ya lo hace. CVE-2026-85660 mostró que un allowlist mal probado se salta con la sintaxis correcta. Y la investigación de CSA, con 150 millones de descargas afectadas según sus propias estimaciones, mostró que el problema no es un bug aislado sino un patrón de diseño repetido en varios SDKs.
Si tu equipo corre servidores MCP con stdio hoy, la tarea concreta no es auditar cada tools/call. Es auditar la config que decide qué se lanza, quién lo aprobó y con qué privilegios, antes de que exista el proceso, empezando por los servidores de mayor radio de explosión y configuración más expuesta.
Fuentes
- The MCP stdio launch boundary is the authorization decision everyone skips — dev.to, 16 de septiembre de 2026.
- GHSA-cr22-wjx7-2w6m — GitHub Advisory Database, CVE-2026-46519.
- CVE-2026-46519 — National Vulnerability Database.
- CVE-2026-85660 — National Vulnerability Database.