
En pocas palabras: El desarrollador de Simple Memo arma el contexto para Claude y Cursor con un solo comando rg sobre carpetas de notas en markdown, sin embeddings ni base de datos vectorial, desde hace ocho meses, según contó el 16 de septiembre de 2026 en Dev.to.
Un desarrollador que hace la app de notas Simple Memo lleva ocho meses armando el contexto que le pasa a Claude y a Cursor con un solo comando de terminal: sin embeddings, sin base de datos vectorial y sin re-ranker. Lo contó en un artículo publicado el 16 de septiembre de 2026 en Dev.to, y el caso sirve para algo más que anécdota: da una vara concreta para decidir si vale la pena montar un pipeline vectorial antes de tener el problema que ese pipeline resuelve.
RAG sin embeddings es una variante de retrieval-augmented generation en la que el contexto del prompt se arma con búsqueda literal de texto, por ejemplo con el comando rg o grep, en vez de vectores, similitud coseno o una base de datos vectorial. La persona que escribió las notas busca a mano las líneas relevantes y las pega en el prompt, sin que ningún paso automático decida qué es “relevante”.
En este artículo:
- En 30 segundos
- ¿Qué hizo exactamente este desarrollador para reemplazar los embeddings?
- ¿Qué es un RAG reducido a lo esencial, sin la maquinaria de embeddings?
- ¿Por qué la búsqueda literal le gana a los embeddings en un corpus personal?
- Ejemplo hipotético: dos corpus, dos decisiones distintas
- ¿Cuáles son los límites reales de buscar notas sin embeddings?
- ¿Qué plan sigue el autor para combinar búsqueda literal y semántica?
- Errores comunes al pensar en RAG sin embeddings
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Ocho meses de retrieval real sin embeddings, sin vector database y sin chunking, según el propio autor.
- El comando completo de búsqueda es uno solo:
rg -i --sort path 'palabra' notes/. - El corpus es una carpeta de archivos markdown, uno por mes, de unas pocas miles de líneas, no millones de documentos.
- La única falla que admite: grep no encuentra lo que no recordás haber escrito ni conceptos relacionados sin palabras en común.
- El próximo paso anunciado es un fallback semántico solo para los casos donde la búsqueda literal no devuelve nada, medido durante un mes.
¿Qué hizo exactamente este desarrollador para reemplazar los embeddings?
Reemplazó toda la maquinaria de un RAG tradicional por un único comando de terminal. Durante ocho meses, según cuenta en su artículo, buscó contexto para sus prompts con rg -i --sort path 'outbox|retry|idempoten' notes/ sobre una carpeta de archivos markdown, uno por mes, sin chunking, sin índice vectorial y sin re-ranker.
El flujo es este: escribe notas en formato markdown, un archivo por mes, cada línea con fecha y redactada con las palabras que espera buscar después. Cuando se sienta a trabajar un problema con Claude o dentro de Cursor, no invoca ningún pipeline. Busca en la carpeta las cinco a veinte líneas que tocan el tema, las lee, y pega a mano las que sobreviven esa lectura en el prompt.
El autor describe esa búsqueda como “la parte menos inteligente de todo el sistema”, y la descripción es literal: el “índice” no es una estructura de datos, es un hábito de escritura. Escribe cada línea como si un desconocido con su misma pregunta fuera a hacer grep de eso dentro de un año, así que lidera con el sustantivo, no con la sensación.
El modelo nunca toca sus notas directamente. Solo ve el puñado de líneas que él eligió llevar al prompt. Relacionado: todo lo que necesitás saber sobre Claude.
¿Qué es un RAG reducido a lo esencial, sin la maquinaria de embeddings?
RAG, en su versión más despojada, es poner en el prompt texto relevante que ya tenés para que el modelo responda desde tu mundo y no desde el promedio de todo internet. Esa es la cláusula que sobrevive cuando se le saca todo lo demás al diagrama de siempre: embeber documentos, guardarlos como vectores, embeber la consulta, buscar vecinos cercanos, meter los resultados en el prompt, generar.
Los embeddings son una forma de resolver la relevancia, no la única. Pagan bien cuando una máquina tiene que adivinar qué es “relevante” en un corpus que ningún humano leyó de punta a punta. El autor no tiene ese problema: su corpus son unas pocas miles de líneas de texto plano que él mismo escribió, leyó y releyó, así que la máquina no tiene nada que adivinar. La pregunta relevante no es si grep alcanza, sino qué parte de un sistema de retrieval es imprescindible para una sola persona y qué parte solo se vuelve imprescindible en una escala que esa persona no tiene.
¿Por qué la búsqueda literal le gana a los embeddings en un corpus personal?
Porque casi todos los ejes que justifican una base de datos vectorial se invierten cuando el corpus es la libreta de una sola persona. La tabla que arma el autor en su análisis lo deja bastante claro:
| Eje | RAG pensado para escala | Retrieval personal (grep) |
|---|---|---|
| Tamaño del corpus | Millones de fragmentos que nadie leyó completos | Unas pocas miles de líneas escritas por una sola persona |
| Quién ejecuta la consulta | Un paso automático que adivina relevancia | La misma persona, que ya sabe qué busca |
| Qué rankea los resultados | Similitud coseno más un re-ranker | Los propios ojos leyendo el output |
| Frescura | Un job de re-embedding programado | La línea es buscable apenas se guarda |
| Costo de un acierto erróneo | Silencioso, enterrado en un contexto largo | Visible, porque se lee cada línea |
| Recall de ítems olvidados | Lo principal que se paga | El único agujero real del sistema |
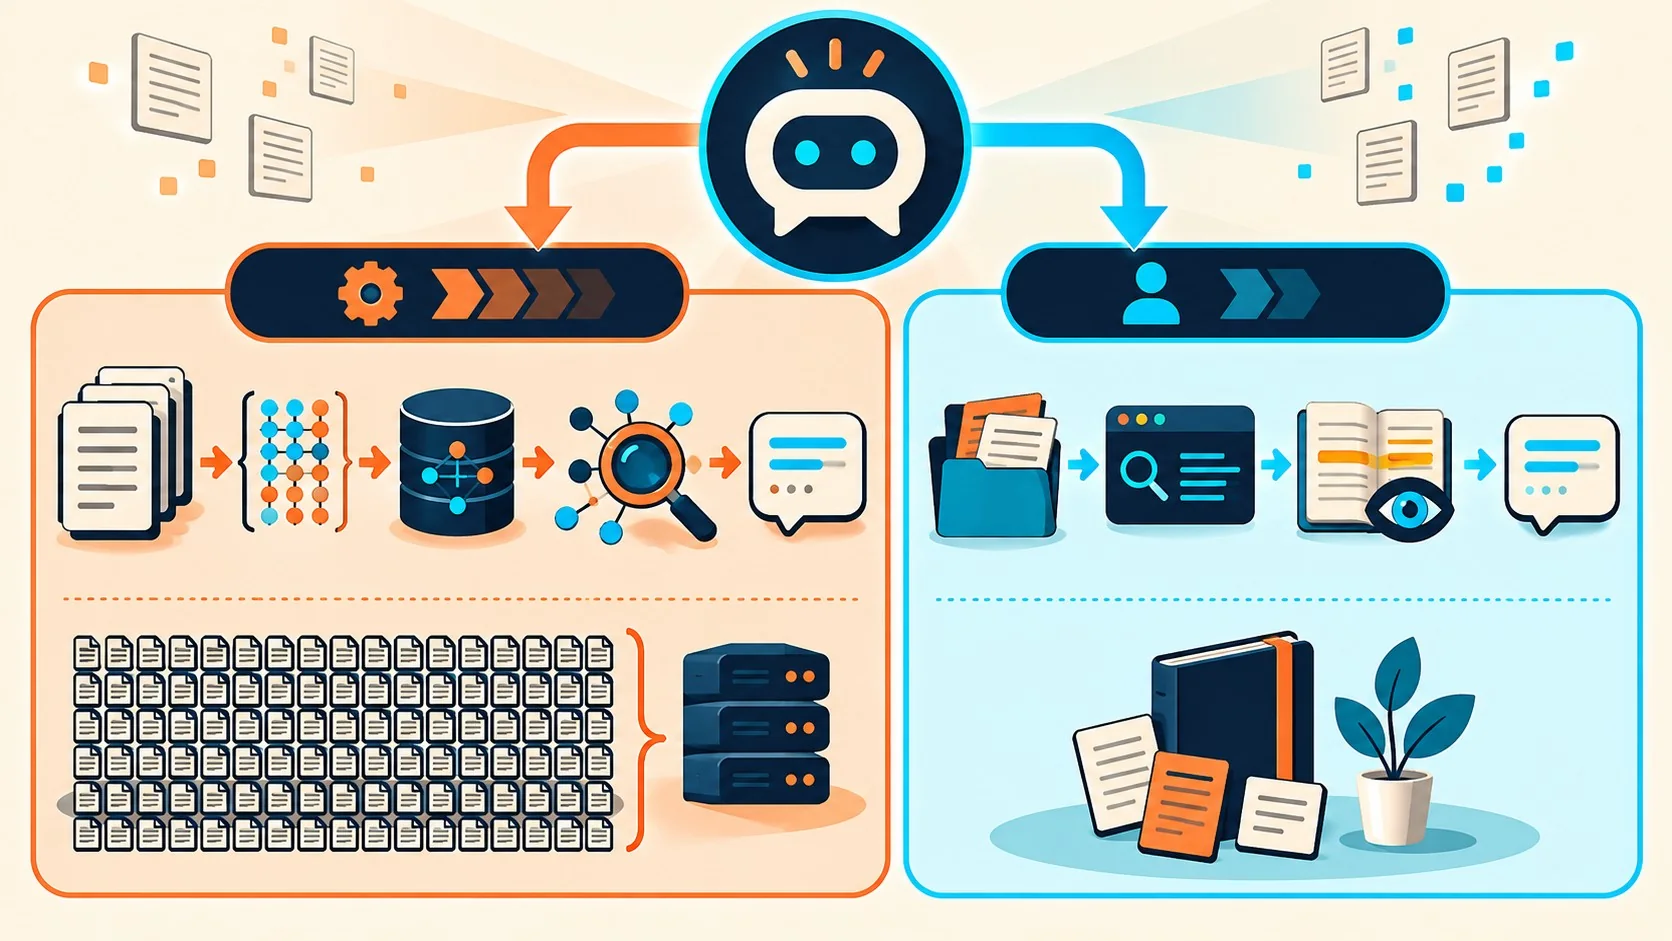
Tres cosas hacen el trabajo, y ninguna es un algoritmo de búsqueda. La primera es la falta de escala: buscar de forma literal sobre unas pocas miles de líneas devuelve resultados en el tiempo que tarda en sacar las manos del teclado, y no hay techo de recall que resolver porque puede escanear cada resultado a simple vista.
La segunda es que él mismo es el planificador de consultas, y es bueno para eso con su propio material. Una búsqueda vectorial tiene que inferir que “outbox” y “lo que guarda el correo sin enviar” son el mismo concepto. Él no tiene que inferir nada: se acuerda de haber escrito ambas cosas y busca la que usó. Te puede servir nuestra cobertura de elegir el modelo correcto según tu caso.
La tercera es la confianza. Al leer cada línea antes de que entre al prompt, también la está auditando: detecta la nota vieja, la línea que suena actual pero era una suposición, el número que no debería pasar como dato firme. Un pipeline que inyecta los ocho fragmentos con mayor puntaje sin que nadie los revise elimina justo ese control de calidad, que en un corpus personal es gratis y en uno automatizado hay que reconstruir con otra capa de herramientas.
Antes de copiar este esquema conviene contestarse tres preguntas, no una sola. ¿Cuántas líneas tiene hoy el corpus real, no el que imaginás dentro de un año? ¿Sos la única persona que va a consultarlo, o en algún momento otro compañero va a necesitar buscar ahí sin haber escrito ninguna línea? ¿Podés escanear diez resultados de grep en menos de un minuto sin perder el hilo de lo que buscabas? Si las tres respuestas apuntan a “sí, es chico, soy yo solo, y sí, lo leo rápido”, el vector store es una inversión adelantada a un problema que todavía no tenés. Si alguna falla, ahí empieza a valer la pena mirar embeddings en serio.
Ejemplo hipotético: dos corpus, dos decisiones distintas
Nota: el siguiente es un ejemplo hipotético construido para ilustrar el criterio, no un caso real reportado en la fuente. Pensemos en dos personas que quieren darle contexto propio a Claude para trabajar todos los días.
La primera es freelance y lleva un archivo markdown por mes con notas de reuniones, decisiones de diseño y bugs resueltos: unas 3.000 líneas acumuladas en dos años, todas escritas por ella misma. Cuando necesita contexto, sabe más o menos qué buscó la última vez que tuvo un problema parecido, así que un rg con la palabra clave correcta le devuelve en segundos las cinco o diez líneas que importan. Bajo el criterio de las tres preguntas anteriores, contesta que sí a las tres: corpus chico, única consultante, resultados que puede leer de un vistazo. Montar un índice vectorial ahí sería mantenimiento sin beneficio medible.
La segunda trabaja en un equipo de soporte técnico que documenta incidentes hace cinco años, con aportes de una decena de personas que ya no están en la empresa. Nadie recuerda con qué palabras exactas se describió cada incidente, y el volumen ya pasó las decenas de miles de líneas: escanear diez resultados de grep no alcanza para confiar en que no falta nada. Ahí las tres respuestas dan que no: corpus grande, múltiples autores, resultados que ya no se pueden auditar a ojo. Ese es el escenario donde, según la lógica que plantea la fuente, la búsqueda semántica deja de ser un lujo y empieza a resolver un problema real.
La diferencia entre los dos casos no es la herramienta, es la escala y quién hace la consulta. El mismo comando que le ahorra tiempo a la primera persona sería insuficiente para la segunda, no porque grep sea peor buscador, sino porque deja de cumplir el supuesto que lo hace funcionar: que quien busca ya sabe, más o menos, qué escribió.
¿Cuáles son los límites reales de buscar notas sin embeddings?
El límite principal es simple: grep solo encuentra lo que recordás haber escrito, con palabras parecidas a las que usaste. Si te olvidaste de que escribiste una línea, o la escribiste con otras palabras, grep no la rescata, porque busca cadenas de texto exactas y vos le estás dando la cadena equivocada.
Ahí es donde la búsqueda semántica gana terreno. Podría encontrar una línea de hace seis meses sobre “tormentas de reintentos” cuando buscás “el buzón de salida duplica los envíos”, aunque no compartan ni una palabra. El autor lo reconoce como el argumento genuino a favor de la maquinaria vectorial, y admite que se vuelve más fuerte cada mes que la carpeta crece.
Hay dos fallas más. Se rompe apenas otra persona necesita consultar esas notas, porque ahí el planificador gratuito y experto —él mismo— deja de estar en el loop, y toda la intención que nunca puso por escrito tiene que reconstruirla una máquina. Y se rompe de forma gradual con el tamaño: el día en que escanear los resultados deja de ser instantáneo es el día en que cruzó, sin darse cuenta, a la zona donde los tutoriales tenían razón. En generar explicadores simples en dos comandos profundizamos sobre esto.
¿Qué plan sigue el autor para combinar búsqueda literal y semántica?
Va a agregar un fallback semántico, pero solo para el caso de “recall miss”: la búsqueda literal sigue siendo la puerta de entrada, y el índice de embeddings se consulta únicamente cuando grep no devuelve nada y él todavía cree que la nota existe.
Va a correrlo durante un mes sobre la misma carpeta y a contar dos números: cuántas veces se activa el fallback y cuántas veces encuentra algo real. La lógica es directa: un fallback que nunca da un acierto es infraestructura que hay que mantener sola, sin retorno.
El autor sospecha que va a activarse poco y a valer la pena justo esos días. Lo que resulta más útil de esa decisión, más allá de si acierta o no, es el orden: primero mide, después decide si agrega la capa vectorial, en vez de instalarla de entrada porque “así se hace un RAG”.
Errores comunes al pensar en RAG sin embeddings
- Asumir que todo RAG necesita vectores. El requisito real es meter texto relevante en el prompt; los embeddings son un método para encontrar ese texto, no una definición del concepto.
- Copiar el setup sin mirar el tamaño del corpus. Lo que funciona para unas pocas miles de líneas escritas por una sola persona no escala igual a documentación de equipo con miles de páginas y varios autores.
- Escribir notas sin pensar en cómo las vas a buscar después. Una línea como “se puso rara, la arreglé” no la encuentra ni grep ni un modelo semántico, porque no tiene el sustantivo que una búsqueda futura va a usar.
- Pegar todo el resultado de la búsqueda sin leerlo. Parte del valor de hacer retrieval a mano es auditar cada línea antes de que entre al contexto; saltearse ese paso anula la ventaja frente a un pipeline automático.
- Descartar la búsqueda semántica por completo. Sigue siendo la única herramienta real para el caso de “sé que escribí algo sobre esto y no lo encuentro”, que la búsqueda literal no puede resolver por diseño.
Preguntas Frecuentes
¿Qué es RAG (retrieval-augmented generation) explicado simple?
RAG es la práctica de darle a un modelo de lenguaje texto propio, relevante, dentro del prompt, en vez de dejar que responda solo con lo que tiene memorizado de su entrenamiento. La parte de “retrieval” (búsqueda) puede hacerse con vectores y similitud coseno o, como en este caso, con una búsqueda literal de texto. Lo explicamos a fondo en integrar Claude sin necesitar una API key.
¿Se puede hacer RAG sin embeddings ni base de datos vectorial?
Sí, siempre que el corpus sea chico y la misma persona que escribió las notas sea quien busca y elige qué pegar en el prompt. El caso documentado usa solo el comando rg sobre archivos markdown, sin vectores, durante ocho meses, sobre un corpus de unas pocas miles de líneas.
¿Cómo le doy contexto de mis notas a Claude sin usar una herramienta especial?
Guardá tus notas en texto plano organizadas por fecha, buscá las líneas relevantes con grep o un buscador de archivos, leelas y pegá manualmente las que sirvan en el prompt de Claude. El truco no está en la herramienta de búsqueda sino en escribir las notas con las palabras que vas a usar para buscarlas después.
¿Cuándo conviene usar búsqueda semántica en vez de búsqueda literal?
Conviene cuando el corpus creció tanto que ya no podés escanear cada resultado a simple vista, cuando más de una persona necesita consultar el mismo material, o cuando buscás algo que sabés que escribiste pero no recordás con qué palabras exactas. En esos tres casos la búsqueda literal empieza a fallar por diseño.
¿Qué ventajas tiene buscar notas a mano en vez de con IA?
La principal ventaja es que vos auditás cada línea antes de que entre al contexto del modelo, así detectás notas viejas o datos que ya sabías que estaban mal. Además, no hay que mantener un índice vectorial ni pagar por re-embeddings cada vez que agregás una nota nueva.
Conclusión
El caso documentado en Dev.to no dice que los embeddings estén de más. Dice que su lugar depende de la escala, y que para una libreta personal de unas pocas miles de líneas, escritas y releídas por la misma persona que las busca, la búsqueda literal resuelve el problema real sin pipeline. Si vos manejás notas propias para trabajar con Claude o Cursor, el punto de partida razonable no es montar una base de datos vectorial, es escribir las líneas pensando en cómo las vas a buscar después, y sumar embeddings recién cuando el corpus, los autores o el tiempo de lectura de los resultados dejen de cumplir las tres condiciones que hacen que grep alcance.