En pocas palabras: Anthropic logró que claude.ai fuera 3 veces más rápido en un sprint de dos semanas durante agosto de 2026: el tiempo hasta una página tipeable en carga fresca bajó de 3.1 a 0.55 segundos (p75), usando Claude Tag, un modelo interno comparable a Opus 5.5, para detectar cuellos de botella y fusionar más de 3.000 cambios sin incidentes.
Anthropic anunció que en agosto de 2026, tras un sprint de dos semanas, logró que claude.ai 3 veces más rápido sea una realidad medible: el tiempo hasta tener una página tipeable en carga fresca bajó de 3.1 a 0.55 segundos en el percentil 75, según el post oficial de ingeniería publicado el 23 de septiembre de 2026. Todo el trabajo se coordinó en un único canal de Slack, con Claude participando en cada hilo.
Claude Tag es el nombre en beta que Anthropic le puso a un modelo de investigación interno, comparable en capacidad a Opus 5.5, que se usó para encontrar cuellos de botella de rendimiento, construir benchmarks propios y enviar mejoras de código en claude.ai y la app de escritorio. El equipo humano fijó los objetivos, definió los trade-offs y aprobó cada cambio antes de que se fusionara.
En este artículo:
- En 30 segundos
- ¿Qué anunció Anthropic sobre la velocidad de claude.ai?
- ¿Cuáles son las cifras exactas detrás de claude.ai 3 veces más rápido?
- ¿Qué es Claude Tag y qué rol cumplió en el proceso?
- ¿Cómo midieron el rendimiento sin depender solo del reloj?
- ¿Qué bugs concretos de rendimiento encontró Claude en su propia plataforma?
- Ejemplo hipotético: cómo se vería este método en un equipo sin recursos de Anthropic
- Criterios para decidir qué medir primero
- ¿Qué está confirmado y qué queda sin verificar de forma independiente?
- Cómo aplicar este método en tu propio equipo, paso a paso
- Qué significa para equipos de desarrollo en Latinoamérica
- Errores comunes al interpretar este tipo de anuncios de performance
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El tiempo a página tipeable en claude.ai pasó de 3.1 a 0.55 segundos en p75, según el post oficial.
- Iniciar una sesión de Claude Code bajó de 0.8 a 0.3 segundos.
- Cargar una sesión de Claude Cowork pasó de 2.6 a 0.73 segundos.
- Se fusionaron más de 3.000 cambios en dos semanas sin un solo incidente ni rollback de cara al usuario.
- El proceso corrió con Claude Tag (beta) trabajando en más de 150 hilos de Slack en simultáneo.
¿Qué anunció Anthropic sobre la velocidad de claude.ai?
Anthropic confirmó que en agosto de 2026 dedicó un sprint de dos semanas a optimizar cuatro journeys de usuario que en conjunto representan el 95% de la actividad en claude.ai: abrir la app, iniciar una conversación, cargar una conversación existente y enviar un mensaje. Entre web y desktop, esos cuatro flujos se tradujeron en trece mediciones distintas.
El punto de partida fue simple: los usuarios venían quejándose de que la plataforma era lenta, y según reconoce el propio equipo, tenían razón. En vez de armar un comité de performance tradicional, Anthropic abrió un canal de Slack único, invitó a Claude a cada hilo y dejó correr el trabajo de forma abierta entre ingenieros humanos y el modelo.
¿Cuáles son las cifras exactas detrás de claude.ai 3 veces más rápido?
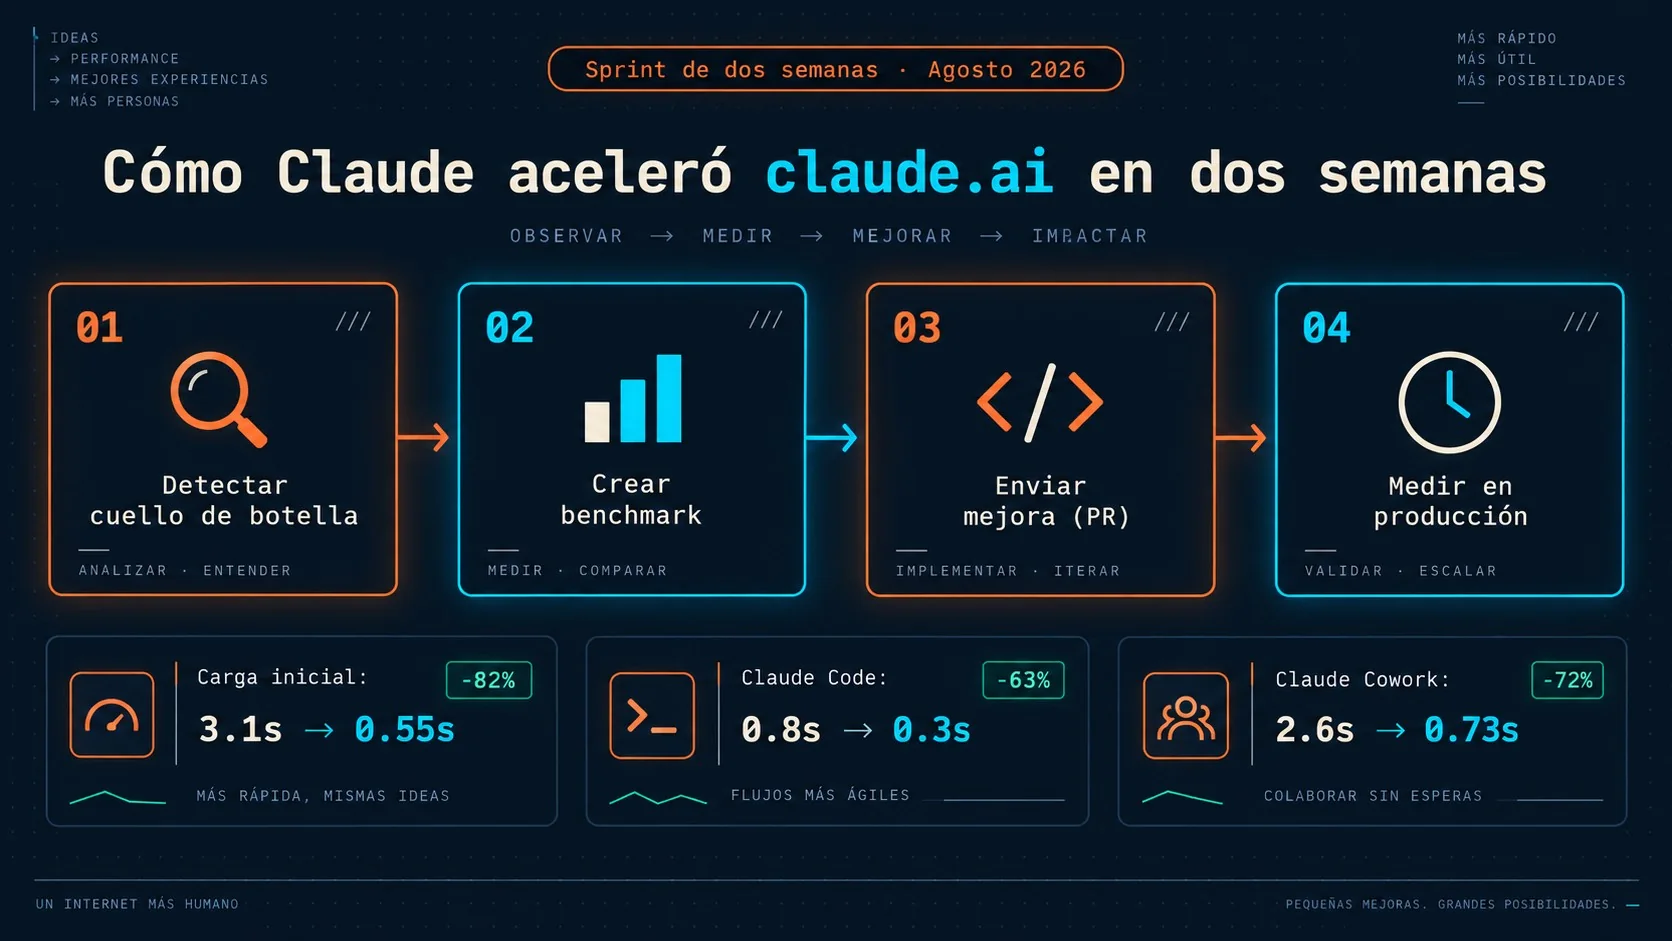
Las tres cifras que Anthropic publicó, todas medidas en el percentil 75, son estas: el tiempo hasta una página tipeable en carga fresca de claude.ai bajó de 3.1 a 0.55 segundos, iniciar una sesión nueva de Claude Code pasó de 0.8 a 0.3 segundos, y cargar una sesión de Claude Cowork en la nube bajó de 2.6 a 0.73 segundos. Si te interesa entender qué otras funciones trae Claude más allá de la velocidad, tenemos una guía completa sobre la plataforma.
Sumando esas mejoras a escala, Anthropic estima un ahorro de decenas de miles de horas-usuario de espera por día. Es una proyección de la propia empresa, no un dato auditado por terceros, pero da una idea del volumen: claude.ai tiene una base de usuarios lo bastante grande como para que fracciones de segundo, multiplicadas, se conviertan en jornadas laborales completas ahorradas todos los días.
¿Qué es Claude Tag y qué rol cumplió en el proceso?
Claude Tag (beta) es el modo en el que Anthropic hizo correr un modelo de investigación interno, aproximadamente comparable a Opus 5.5, dedicado exclusivamente a tareas de performance dentro de claude.ai. Encontró cuellos de botella, armó sus propios benchmarks, escribió y envió los parches, y después se quedó vigilando cada deploy para ver si el cambio realmente funcionaba en producción.
Acá está el punto que distingue este caso de un simple “usamos IA para programar”: los humanos no revisaban código línea por línea todo el tiempo. Fijaban el objetivo, decidían qué trade-offs aceptar (por ejemplo, cuánta complejidad agregar a cambio de cuántos milisegundos) y aprobaban cada pull request antes de mergear. Con ese esquema, el equipo fusionó más de tres mil cambios sin un solo incidente de cara al cliente ni un rollback.
¿Y quién le dio la orden inicial? Según las instrucciones del canal citadas en el post, la consigna fue “facilitar todo lo relacionado con la performance de claude.ai y la app de escritorio”, incluyendo monitorear deploys, evaluar la calidad de la telemetría existente, mantener dashboards curados y proponer proyectos de forma proactiva. La meta declarada era llegar a la mayor autonomía posible, aunque el propio equipo aclaró que “hoy sabemos que eso todavía no es posible”. Vale la pena leerlo dos veces: es Anthropic diciendo, en su propio blog, que ni ellos confían todavía en dejar a un modelo sin supervisión humana en cada merge. Sobre las diferencias entre modelos de la familia Claude, también escribimos una comparación entre Sonnet y Opus.
¿Cómo midieron el rendimiento sin depender solo del reloj?
El equipo pasó de medir tiempo real (wall-clock) a medir cosas determinísticas, como conteo de instrucciones de CPU, commits de React, recálculos de estilo y mutaciones del DOM, porque el reloj es ruidoso y no sirve como gate confiable en integración continua. Cada métrica nueva tenía que demostrar primero que mover la aguja en el laboratorio se traducía en una mejora real de milisegundos para el usuario.
El ejemplo que mejor lo explica: Sam, uno de los ingenieros del equipo, le preguntó a Claude si se podía medir en instrucciones de JavaScript en vez de tiempo real. Once minutos después había cinco hilos corriendo en paralelo, cada uno con una métrica distinta. Para probar que la idea servía, Claude optimizó dos rutas críticas (el armado del árbol de mensajes de una conversación y un scanner de líneas de estado en Claude Code) usando Valgrind, y encontró que un cuarto de las instrucciones en la primera ruta eran búsquedas de diccionario megamórficas que resolvían tres veces el mismo ID de mensaje.
Una hora después, Claude había recortado las instrucciones un 48% y un 31% en cada ruta, y el tiempo real había caído 78% y 44% respectivamente. A partir de ahí, cualquier pull request que subiera el conteo de instrucciones de esas rutas fallaba automáticamente en CI, y un job diario bajaba el techo cada vez que el número mejoraba. La lección que se llevó el equipo: apenas hay un número para vencer, Claude puede empezar a optimizar, así que lo más rentable pasó a ser buscar más cosas para medir.
Lo que esto revela, más allá del caso puntual, es un cambio de orden en el proceso clásico de optimización. Normalmente medís, esperás datos, y recién después optimizás. Acá el orden colapsa: apenas existe una métrica, ya hay alguien (o algo) optimizando contra ella. Eso explica por qué el equipo terminó invirtiendo tanto esfuerzo en construir benchmarks nuevos en vez de arreglar código directamente: el benchmark es, en la práctica, el verdadero entregable.
¿Qué bugs concretos de rendimiento encontró Claude en su propia plataforma?
Claude detectó fallas de rendimiento que ninguna métrica tradicional venía capturando, desde jank visual en el sidebar hasta medio millón de recargas ocultas por día. Estos son los casos más concretos que documenta el post oficial:
- Jank en el sidebar: filas de chat y de Cowork aparecían en momentos distintos después de cargar la página, generando saltos visuales. El Cumulative Layout Shift no lo detectaba (cada salto puntuaba 0.008, muy por debajo del umbral de 0.1), así que Claude armó telemetría propia sobre la Layout Instability API y encontró que el 31% de las cargas web movían algo después de que la página ya era usable.
- El bug de las rayas (em dash): resaltar un bloque de código terminado podía congelar la página por un segundo entero. La causa era que cualquier carácter no Latin-1, como una raya o comillas tipográficas, hacía que V8 guardara todo el string en UTF-16, forzando a las expresiones regulares de sintaxis a correr por el camino lento de dos bytes. Se arregló con un cambio de veinte líneas.
- Recargas fantasma: un
location.reload()perdido en el código causaba medio millón de recargas ocultas por día que ninguna métrica de carga existente podía ver. - Selector CSS costoso: un único selector
:root:has()le agregaba 24 milisegundos a cada cambio en el DOM.
Otro dato que llama la atención: un censo de React hooks encontró 6.900 hooks y 900 suscripciones a stores en el camino de tipeo del composer, todos re-renderizando en cada tecla que apretaba el usuario. Lo interesante de estos cuatro casos no es la solución técnica en sí (bastante puntual cada una), sino el patrón común: en los cuatro, el problema era invisible para las métricas que ya tenían configuradas. Nadie decidió ignorar el jank del sidebar; simplemente no existía un instrumento que lo mostrara como un problema. Sobre cómo Claude puede automatizar tareas de diagnóstico similares, también cubrimos el uso de skills como el explicador ELI5 en Claude Code.
Ejemplo hipotético: cómo se vería este método en un equipo sin recursos de Anthropic
Nota: lo que sigue es un ejemplo hipotético, construido para ilustrar el método descripto en el post de Anthropic. No es un caso real ni corresponde a ninguna empresa en particular.
Imaginemos un equipo chico que mantiene una tienda online y recibe quejas de que el checkout “se siente lento”. Sin el presupuesto ni el equipo de Anthropic, el mismo método se podría adaptar así: en vez de arrancar con “vamos a optimizar todo”, el equipo elegiría un único journey (por ejemplo, agregar un producto al carrito y llegar a la pantalla de pago) y lo instrumentaría de punta a punta, separando cuánto tiempo se va en el servidor y cuánto en el cliente. Después, en vez de confiar solo en el tiempo real que reporta el navegador (que varía según la conexión de cada usuario), agregarían una métrica más estable en su entorno de pruebas: cantidad de renders de React en esa pantalla, o cantidad de llamadas a la API que se disparan de más. Esa métrica, aunque mucho más modesta que un conteo de instrucciones con Valgrind, cumpliría la misma función que describe el post: da un número concreto contra el cual iterar, en vez de perseguir una sensación de “lentitud” que nadie puede medir dos veces igual.
Criterios para decidir qué medir primero
El post no da una receta explícita para priorizar, pero de la lectura del caso se pueden extraer criterios razonables, respaldados en lo que el propio equipo de Anthropic hizo primero:
- Volumen de uso antes que intuición: Anthropic no arrancó por el journey que “se sentía” más lento, sino por los cuatro que sumaban el 95% de la actividad. Si no sabés cuál journey concentra más uso en tu producto, ese es el primer dato que falta, antes de optimizar nada.
- Separar cliente de servidor antes de medir: el post insiste en que cada medición debía “disambiguar” trabajo del cliente y del servidor. Sin esa separación, es imposible saber si un journey lento se arregla con código o con infraestructura.
- Preferir métricas determinísticas para CI, wall-clock para el usuario final: el tiempo real sigue siendo la métrica que le importa al usuario, pero no sirve como gate porque es ruidosa. Una métrica de laboratorio (conteos, renders, recálculos) solo vale si ya demostró correlación con el tiempo real, como hizo Claude antes de adoptar cada benchmark nuevo.
- Descartar el benchmark que no mueve el reloj: el propio equipo se comprometió a “unshippear” cualquier métrica de laboratorio que no pudiera probar una mejora real en milisegundos. Es un criterio simple y aplicable a cualquier escala: si optimizás un número y el usuario no lo nota, el número está mal elegido.
¿Qué está confirmado y qué queda sin verificar de forma independiente?
Lo confirmado por Anthropic en su propio comunicado es el volumen de cambios (más de 3.000 fusionados, más de 200 cambios en los días de mayor actividad), la ausencia de incidentes de cara al cliente y de rollbacks, y las tres cifras de mejora en p75 mencionadas arriba. También está documentado el mecanismo de seguridad: cada cambio visible para el usuario quedaba detrás de un feature flag, y cada pull request pasaba por aprobación humana antes de mergear.
Lo que no está: una auditoría externa e independiente de esas cifras. Todo el relato viene del propio blog de ingeniería de Anthropic, publicado por sus propios empleados, sin benchmark de terceros que replique los números. Tomalo con pinzas, no porque haya motivo concreto para dudar, sino porque es la práctica sana con cualquier anuncio de performance que viene del mismo equipo que lo hizo.
Cómo aplicar este método en tu propio equipo, paso a paso
Si el objetivo no es replicar la escala de Anthropic sino sacar algo utilizable de su método, estos son los pasos concretos que se desprenden del caso:
- Identificá los journeys que concentran la mayor parte del uso, no los que más quejas generan en apariencia. Anthropic trabajó sobre cuatro flujos que sumaban el 95% de la actividad.
- Instrumentá cada journey de punta a punta, separando el momento en que arranca la interacción del usuario y el momento en que el resultado ya está renderizado, y distinguiendo trabajo de cliente y de servidor.
- Elegí una métrica determinística por journey (conteo de renders, de llamadas a la API, de recálculos de estilo) que puedas correr en tu entorno de pruebas sin depender del reloj de pared.
- Probá que esa métrica se correlaciona con el tiempo real antes de confiar en ella. Si optimizarla no mueve la experiencia del usuario, descartala.
- Convertí la métrica en un gate de CI que solo puede mejorar, para que ninguna mejora se pierda con el siguiente cambio de código.
- Iterá journey por journey, no todo el producto a la vez: el post muestra que el efecto compuesto de resolver un journey a fondo abre visibilidad sobre el siguiente.
Qué significa para equipos de desarrollo en Latinoamérica
Si tu equipo usa Claude Code o Claude Cowork en el día a día, los números de menor latencia se traducen directamente en menos tiempo muerto esperando que cargue una sesión. Para equipos remotos que trabajan con conexiones más inestables (algo común en varios países de la región), un tiempo a página tipeable de 0.55 segundos en vez de 3.1 hace una diferencia real en la percepción de la herramienta. Sobre cómo integrar Claude en flujos de trabajo existentes, también escribimos sobre su integración con Make.com.
Ahora bien, la lección de fondo no es sobre Claude específicamente: es sobre medir antes de optimizar. Si tu propia aplicación corre lenta y todavía no sabés por qué, la respuesta casi nunca es “necesitamos más servidores”. Antes de gastar en infraestructura, vale la pena aplicar los pasos de la sección anterior sobre al menos un journey crítico. Eso sí: si después de medir el cuello de botella resulta ser la infraestructura misma (un hosting compartido saturado, por ejemplo), ahí sí tiene sentido evaluar migrar a un proveedor con capacidad de VPS o cloud como donweb.com, en vez de seguir optimizando código contra un servidor que no da abasto.
Errores comunes al interpretar este tipo de anuncios de performance
- Confundir “3x más rápido” con una mejora general del producto: la cifra corresponde a p75 en cuatro journeys puntuales, no a un promedio de toda la plataforma ni a todos los percentiles.
- Ignorar la diferencia entre wall-clock y métricas determinísticas: copiar solo “medimos el tiempo de carga” sin el paso intermedio de instrucciones de CPU o commits de React es perder la parte más replicable del método.
- Asumir que Claude trabajó sin supervisión: cada pull request pasó por aprobación humana y cada cambio visible quedó detrás de un feature flag. No fue automatización sin control.
- Tratar el reporte como verificación externa: son cifras publicadas por Anthropic sobre su propio producto, sin auditoría de un tercero independiente que las haya reproducido.
Preguntas Frecuentes
¿Cómo logró Anthropic que claude.ai sea 3 veces más rápido?
Con un sprint de dos semanas en agosto de 2026 donde Claude Tag (beta), un modelo de investigación interno, encontró cuellos de botella, construyó benchmarks propios y envió más de 3.000 cambios de código, todos aprobados por ingenieros humanos antes de fusionarse. El resultado fue una mejora de hasta 3x en el tiempo a página tipeable, medida en el percentil 75.
¿Qué es Claude Tag y cómo se usó para optimizar claude.ai?
Claude Tag es el nombre beta de un modelo de investigación interno de Anthropic, comparable en capacidad a Opus 5.5, que se dedicó exclusivamente a tareas de performance: detectar cuellos de botella, crear benchmarks determinísticos y vigilar cada deploy después de enviarlo a producción.
¿Cuánto mejoró el tiempo de carga de claude.ai y Claude Code?
El tiempo a página tipeable de claude.ai bajó de 3.1 a 0.55 segundos en p75, mientras que iniciar una nueva sesión de Claude Code pasó de 0.8 a 0.3 segundos. Cargar una sesión de Claude Cowork en la nube bajó de 2.6 a 0.73 segundos.
¿Cuántos cambios se hicieron sin incidentes durante el sprint?
Anthropic fusionó más de 3.000 cambios en las dos semanas del sprint, con más de 200 cambios en los días de mayor actividad, sin registrar un único incidente de cara al cliente ni un rollback.
¿Qué errores de rendimiento encontró Claude en su propia plataforma?
Entre los hallazgos más concretos están un jank visual en el sidebar que afectaba al 31% de las cargas web, un bug donde caracteres como la raya congelaban el resaltado de código por forzar strings en UTF-16, medio millón de recargas ocultas diarias por un location.reload() perdido, y un selector CSS que sumaba 24 milisegundos a cada cambio del DOM.
Conclusión
Lo que cambió acá no es solamente que claude.ai ande más rápido. Es el método: pasar de medir tiempo real (ruidoso, difícil de usar como gate) a instrumentar cada journey con métricas determinísticas que un modelo puede optimizar de forma iterativa, con humanos aprobando cada paso. Si administrás un producto con problemas de performance, la parte replicable de este caso no son los 0.55 segundos, son los seis pasos de la sección anterior: elegir journey, instrumentar, definir métrica determinística, probar correlación, poner gate en CI, iterar.
Para equipos que usan Claude Code o Cowork, el beneficio directo ya está en producción. Para el resto, el ejercicio útil es preguntarse cuántos de los cuellos de botella de tu propia aplicación siguen sin medirse simplemente porque nadie armó el benchmark todavía.