En pocas palabras: Anthropic logró que claude.ai fuera hasta 3 veces más rápido durante un sprint de dos semanas en agosto de 2026, usando el modelo interno Claude Tag (comparable a Opus 5.5) para medir y desplegar más de 3.000 cambios sin incidentes ni rollbacks. Lo interesante no es solo el número: es el método que armaron para llegar ahí, y qué de ese método sirve aunque tu equipo no tenga un modelo propio.
Anthropic hizo que claude.ai sea hasta 3 veces más rápido en un sprint de dos semanas durante agosto de 2026, usando un modelo de investigación interno llamado Claude Tag para medir y optimizar más de 3.000 cambios sin un solo incidente ni rollback, según el blog oficial de Anthropic. El dato llamativo no es la velocidad en sí —algo esperable en este tipo de posts—, sino que el volumen de cambios mergeados en catorce días sea manejable sin que nada se rompa de cara al usuario.
Claude Tag es un modelo de investigación interno de Anthropic, comparable en capacidad a Opus 5.5, que la empresa usó en modo beta para detectar cuellos de botella de rendimiento en claude.ai, construir benchmarks propios y desplegar mejoras de código de forma directa. El sistema funcionó dentro de un canal de Slack, con ingenieros humanos aprobando cada cambio antes de que llegara a producción.
En este artículo:
- En 30 segundos
- ¿Qué resultados concretos logró Anthropic en el sprint de rendimiento de claude.ai?
- ¿Cómo midió Claude los problemas de rendimiento antes de solucionarlos?
- ¿Qué errores de rendimiento descubrió Claude que nadie había detectado antes?
- Ejemplo hipotético: aplicar la misma lógica a escala chica
- Criterios de decisión: ¿tu equipo está en condiciones de intentar algo así?
- ¿Qué garantías usó Anthropic para evitar incidentes al desplegar miles de cambios?
- ¿Qué implica este experimento para el desarrollo de software asistido por IA?
- Qué significa esto para equipos de desarrollo en Latinoamérica
- Errores comunes al intentar replicar este tipo de sprint de performance
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La carga inicial de claude.ai bajó de 3.1 a 0.55 segundos en el percentil 75.
- Anthropic mergeó más de 3.000 cambios en dos semanas sin un solo incidente de usuario.
- Claude Tag, el modelo interno comparable a Opus 5.5, hizo la mayor parte del trabajo de medición y optimización.
- El sistema encontró bugs invisibles, como un freeze de un segundo causado por em dashes y medio millón de recargas ocultas por día.
- Anthropic estima que el ahorro ronda las decenas de miles de horas de usuario por día.
¿Qué resultados concretos logró Anthropic en el sprint de rendimiento de claude.ai?
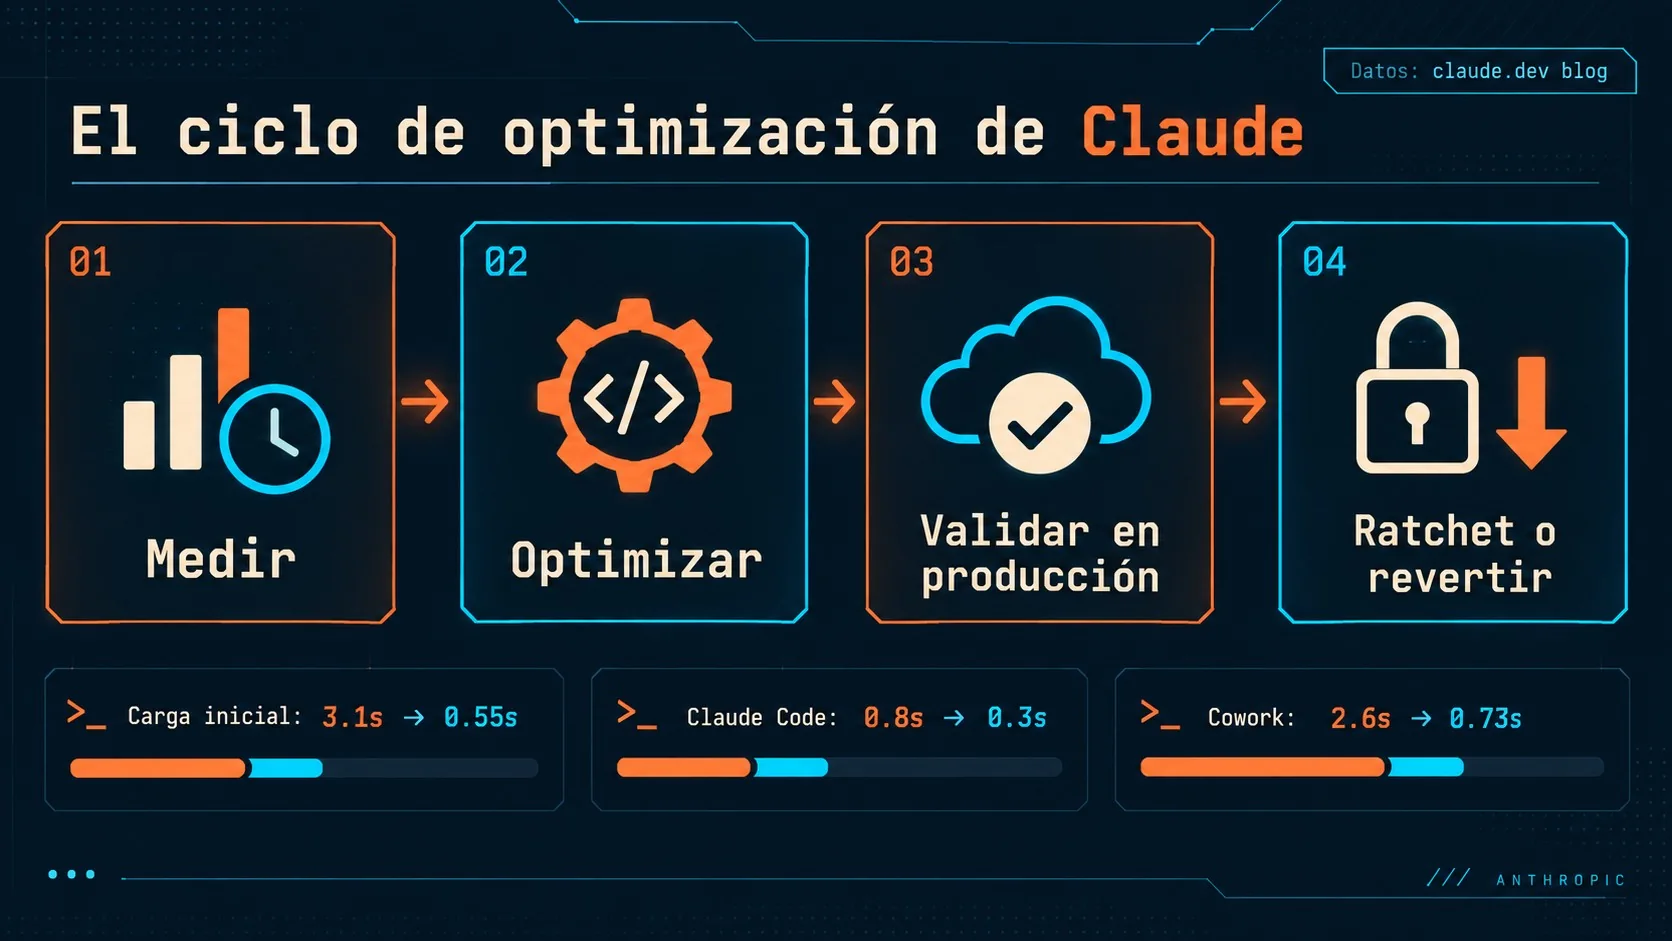
En agosto de 2026, el equipo de Anthropic corrió un sprint de dos semanas enfocado en cuatro journeys de usuario que suman el 95% de la actividad total en claude.ai y la app de escritorio de Claude. Los números, medidos en el percentil 75 según el post técnico publicado por Raymond Wang, Sam Attard e Issac G., quedan más claros en tabla que en prosa:
| Journey de usuario | Antes | Después | Mejora |
|---|---|---|---|
| Carga inicial de claude.ai (p75) | 3.1 s | 0.55 s | ~82% |
| Inicio de sesión de Claude Code | 0.8 s | 0.3 s | ~62% |
| Carga de sesión de Claude Cowork | 2.6 s | 0.73 s | ~72% |
La empresa calcula que esa mejora ahorra decenas de miles de horas de espera por día entre todos los usuarios. Pero el número que más vale la pena subrayar, para quien piense en replicar algo de esto, no es ninguno de la tabla: es que mergearon más de 3.000 cambios sin un solo rollback. Eso implica que el cuello de botella real no fue la generación de código, sino el sistema de validación alrededor de cada cambio.
¿Cómo midió Claude los problemas de rendimiento antes de solucionarlos?
Claude analizó datos de uso a través del MCP server de Datadog e identificó los cuatro journeys de mayor impacto: abrir la app, arrancar una conversación, cargar una conversación existente y enviar un mensaje. Entre web, escritorio y los distintos productos, eso dio trece mediciones puntuales que el equipo instrumentó hasta hacerlas comparables entre sí.
Acá aparece un problema que cualquiera que haya optimizado rendimiento conoce: el tiempo real (wall-clock) es lo que el usuario siente, pero es demasiado ruidoso para usarlo como gate de integración continua. Un mismo request puede tardar distinto por motivos que no tienen nada que ver con el código —red, carga del servidor, hasta el estado térmico de la CPU del usuario—. Por eso el equipo, según cuenta Sam Attard en el post, le pidió a Claude explorar alternativas deterministas: conteo de instrucciones con Valgrind bajo node --predictable, commits de React por interacción, recálculos de estilo y mutaciones del DOM. La lógica es simple aunque no obvia: si una métrica no varía entre corridas, se puede usar como bloqueo automático de un PR; si varía, solo sirve como alerta para que un humano mire. Once minutos después de plantear la pregunta en Slack, ya había cinco hilos corriendo en paralelo, cada uno probando una métrica distinta.
¿Funcionó de entrada? No del todo, y ese matiz importa. Cada benchmark nuevo tenía que demostrar primero, con datos, que moverlo en el laboratorio se traducía en una mejora real de tiempo de respuesta. Si no lo probaba, lo descartaban sin culpa. El caso que mejor ilustra el mecanismo es la rutina que arma el árbol de mensajes de una conversación: Claude perfiló el código con Valgrind y encontró que un cuarto de las instrucciones eran búsquedas en diccionarios megamórficos, resolviendo el mismo ID de mensaje tres veces. Una hora después había cortado el conteo de instrucciones un 48% en esa ruta y un 31% en un scanner de líneas de estado de Claude Code, y el tiempo real cayó 78% y 44% respectivamente. Recién ahí, con la correlación probada, cualquier PR que subiera esos conteos empezó a fallar en CI de forma automática.
¿Qué errores de rendimiento descubrió Claude que nadie había detectado antes?
Lo que tienen en común los hallazgos de este sprint, documentados en el blog de ingeniería de Anthropic, es que ninguno era nuevo: eran bugs viejos que ningún dashboard estándar los detectaba. Cuatro casos concretos:
- El bug del em dash congelaba el resaltado de código. Si una respuesta tenía un carácter no-Latin-1, como un em dash o una comilla curva, V8 guardaba todo el string en UTF-16 y mandaba cada regex de sintaxis por la ruta lenta de dos bytes, causando un freeze de casi un segundo. La solución fue un cambio de veinte líneas.
- El composer tenía 6.900 hooks de React activos. Un censo de hooks reveló 6.900 hooks y 900 suscripciones a stores en la ruta de escritura del composer, todos re-renderizando en cada tecla.
- Un selector CSS agregaba 24 milisegundos por cambio. Un solo selector
:root:has()sumaba esa demora a cada mutación del DOM, algo invisible para las métricas de carga estándar. - Había medio millón de recargas ocultas por día. Un
location.reload()olvidado en el código disparaba recargas que ninguna métrica de carga detectaba porque ocurrían después del primer pintado.
El caso del sidebar es quizás el más instructivo de todos, porque muestra el límite de confiar ciegamente en una métrica estándar. Alguien compartió una grabación donde las filas del panel lateral aparecían con un salto visual molesto, pero el Cumulative Layout Shift marcaba apenas 0.008 por salto, bien dentro del umbral aceptable de 0.1. El CLS agregado literalmente decía “acá no pasa nada”. Issac propuso mirar la Layout Instability API directamente en vez de confiar en ese agregado, y con eso Claude armó un test que nombraba cada región afectada. El resultado: 31% de las cargas de página movían algo después de que la página ya era usable, sin que el usuario tocara nada. La métrica “oficial” estaba técnicamente bien y absolutamente ciega al problema real.
Ejemplo hipotético: aplicar la misma lógica a escala chica
Nota: lo que sigue es un ejemplo hipotético para ilustrar el mecanismo, no un caso real reportado por Anthropic ni verificado por esta publicación.
Imaginá un equipo de cinco personas manteniendo el checkout de un e-commerce en Latinoamérica, sin ningún modelo interno tipo Claude Tag, apenas un asistente de código genérico. El equipo no tiene trece mediciones instrumentadas como Anthropic, tiene cero. ¿Cómo se vería adaptar el mismo patrón, sin la escala ni los recursos de Anthropic?
Un camino posible: primero, elegir un único journey crítico —el checkout, porque ahí se pierde plata directamente— en vez de intentar medir todo de una. Segundo, instrumentar tres o cuatro momentos concretos de esa ruta (tiempo hasta que carga el formulario de pago, tiempo hasta la confirmación de la tarjeta, tiempo hasta la pantalla de éxito), igual que Anthropic disambiguó “cliente” de “servidor” en sus trece mediciones. Tercero, usar el asistente de código para proponer un benchmark de laboratorio de al menos una de esas métricas —no necesariamente Valgrind, pero sí algo determinista, como contar renders o llamadas a API en un flujo simulado— antes de tocar producción. Cuarto, exigir la misma disciplina que usó Anthropic: ningún cambio se acepta como “mejora” hasta que el benchmark de laboratorio demuestre correlación con el tiempo real. El volumen sería infinitamente menor al de Anthropic, pero el principio —medir antes de optimizar, y probar la correlación antes de confiar en la métrica— es el mismo.
Criterios de decisión: ¿tu equipo está en condiciones de intentar algo así?
Antes de copiar el modelo del sprint, tiene sentido chequear si están dadas las condiciones mínimas. Ninguno de estos criterios viene del post de Anthropic; son una síntesis propia de lo que el caso deja como requisito implícito:
- ¿Ya tenés instrumentación por journey, o hay que construirla desde cero? Anthropic arrancó el sprint con trece mediciones ya comparables entre sí. Si tu equipo no tiene ninguna, el primer sprint no va a ser de optimización: va a ser de instrumentación, y conviene planificarlo así.
- ¿Tenés feature flags con reversión rápida? El loop de Anthropic dependía de poder apagar cualquier cambio visible al usuario sin un deploy nuevo. Sin eso, cada experimento se vuelve más caro y más lento de descartar.
- ¿Alguien puede revisar cambios al ritmo que se proponen? En los días de mayor actividad, Anthropic mergeó más de 200 cambios en un solo día. Si tu equipo tiene una sola persona disponible para aprobar PRs, ese va a ser el techo real de velocidad, no la capacidad del modelo.
- ¿Tenés algún proxy determinista para tu métrica de negocio, o solo wall-clock ruidoso? Si la única señal que tenés es “se siente lento”, vas a necesitar encontrar primero un número que no varíe entre corridas, como hizo Anthropic con los conteos de instrucciones, antes de poder automatizar nada.
¿Qué garantías usó Anthropic para evitar incidentes al desplegar miles de cambios?
El loop que armó Anthropic para cada hilo de trabajo fue siempre el mismo: detectar el problema, medir con un benchmark de laboratorio, mandar un PR con feature flag para lo visible al usuario, observar el deploy en producción y recién ahí decidir si ratchetear el benchmark hacia abajo o apagar la flag. Ese ciclo se repitió en más de 150 hilos de Slack corriendo al mismo tiempo durante el sprint.
Ojo con esto: ningún benchmark entraba a CI sin antes probar, con datos, que mejorarlo mejoraba también el tiempo real percibido por el usuario. Si un ingeniero sospechaba que una métrica era ruidosa o no correlacionaba con nada, la sacaban del pipeline sin culpa. El equipo mantuvo el control humano en tres puntos concretos: quién fija los objetivos del sprint, quién aprueba cada cambio antes de mergear, y quién decide qué benchmarks sobreviven. Nada de eso corrió solo, por más que el volumen de cambios sugiera lo contrario.
Llegaron a doce de trece objetivos fijados al inicio del sprint para el tercer día. Eso da una pista de por qué el equipo terminó redefiniendo la meta a mitad de camino: el plan original se quedó corto casi de inmediato.
¿Qué implica este experimento para el desarrollo de software asistido por IA?
La lección central que deja el sprint, en palabras del propio equipo de Anthropic, es que con Claude “medir algo lo vuelve abordable”. Antes, medir era el paso cero: agregabas una métrica, esperabas que llegara data, y recién ahí entendías el problema. Con un modelo capaz de optimizar en loop, medir pasa a ser el primer paso de la escalada, no el último.
Eso cambia el cálculo de dónde poner el esfuerzo de ingeniería. Si instrumentar algo nuevo garantiza que ese algo se va a optimizar solo, la actividad de mayor apalancamiento deja de ser escribir código y pasa a ser encontrar qué más medir. Es un cambio de enfoque, no solo de velocidad, y probablemente sea la parte más transferible de todo el caso: no todos van a tener un modelo comparable a Opus 5.5 corriendo veinticuatro horas, pero cualquier equipo puede preguntarse qué no está midiendo todavía.
Ahora bien, Anthropic es explícita sobre el límite de todo esto: el objetivo declarado del canal es que Claude sea “lo más autónomo posible”, pero hoy eso no existe todavía. Cada cambio pasó por revisión y aprobación humana. No hubo despliegue sin supervisión, y conviene no perder ese detalle en el entusiasmo por el número de “3x más rápido”.
Qué significa esto para equipos de desarrollo en Latinoamérica
Si tu equipo mantiene una app web con latencia como problema recurrente, la parte del patrón de Anthropic que sí es replicable sin necesitar un modelo interno de esa escala es la disciplina, no la infraestructura: instrumentar cada journey crítico con una métrica clara antes de tocar código, y usar esa métrica como gate en CI en vez de discutir a ojo si algo “se siente” más rápido.
Para equipos que corren su infraestructura desde Latinoamérica vale la pena agregar una variable que el post de Anthropic no cubre porque no es su problema: la velocidad de carga percibida también depende de dónde vive el servidor y qué tan bien configurado está el hosting. Un frontend optimizado con el mejor loop de medición del mundo igual pierde si el backend responde lento por una infraestructura mal dimensionada.
Errores comunes al intentar replicar este tipo de sprint de performance
- Usar tiempo real (wall-clock) como único gate de CI. Es la métrica que más le importa al usuario, pero también la más ruidosa. Anthropic la combinó con conteos deterministas, como instrucciones o commits de React, que no varían entre corridas.
- Confiar en el Cumulative Layout Shift sin mirar la fuente del dato. El caso del sidebar de claude.ai muestra que un CLS agregado de 0.008 puede esconder un 31% de páginas con saltos visuales reales. Conviene mirar los eventos de
layout-shiftpor región, no solo el score final. - Dejar que un modelo optimice sin gate de reversión. Cada PR de Claude en el sprint pasó por observación de deploy antes de confirmarse. Sin ese paso, un cambio que mejora el benchmark de laboratorio puede empeorar la experiencia real sin que nadie lo note a tiempo.
- Medir solo lo obvio. Bugs como el freeze por em dash o las recargas ocultas por
location.reload()no aparecían en ningún dashboard estándar. Encontrarlos exigió preguntarse qué más se podía instrumentar, no solo revisar lo que ya se medía.
Preguntas Frecuentes
¿Cómo logró Anthropic que claude.ai sea 3 veces más rápido?
Anthropic corrió un sprint de dos semanas en agosto de 2026 donde Claude Tag, un modelo de investigación interno, midió cuatro journeys clave de usuario, construyó benchmarks de laboratorio y desplegó más de 3.000 cambios de código, todos aprobados por ingenieros humanos antes de mergear.
¿Qué es Claude Tag y para qué lo usó Anthropic?
Claude Tag es un modelo de investigación interno de Anthropic, en fase beta y comparable en capacidad a Opus 5.5, que la empresa usó para encontrar cuellos de botella de rendimiento en claude.ai, armar benchmarks propios y proponer y ejecutar optimizaciones de código.
¿Puede una IA optimizar su propio código sin intervención humana?
No en este caso, y Anthropic lo dice de forma explícita: aunque la meta declarada del proyecto es llegar a la mayor autonomía posible, cada uno de los más de 3.000 cambios mergeados durante el sprint pasó por aprobación humana antes de llegar a producción.
¿Qué errores de rendimiento encontró Claude en claude.ai que los humanos no habían visto?
Entre los hallazgos más llamativos están un freeze de casi un segundo al resaltar código causado por em dashes que forzaban strings UTF-16 en V8, un censo que reveló 6.900 hooks de React activos en el composer, y medio millón de recargas de página ocultas por día generadas por un location.reload() olvidado en el código.
¿Cuánto tardó Anthropic en mejorar la velocidad de claude.ai?
El sprint duró dos semanas en agosto de 2026, pero el equipo llegó a doce de los trece objetivos de rendimiento fijados al inicio ya para el tercer día, según el post técnico publicado por Anthropic el 23 de septiembre de 2026.
Conclusión
Lo que cambió acá no es solamente que claude.ai carga más rápido, aunque eso ya es una mejora concreta para cualquiera que lo use todos los días. Lo que cambió es el método: cuando medir un problema se vuelve barato y rápido gracias a un modelo capaz de instrumentar, benchmarkear y optimizar en loop, la limitante de un equipo de ingeniería deja de ser la mano de obra y pasa a ser la imaginación para encontrar qué medir. Eso sí, el dato duro que hay que quedarse es que ningún cambio se mergeó sin revisión humana. Si tu equipo evalúa adoptar un flujo parecido, el punto de partida realista no es “delegar todo a un modelo”: es armar el mismo loop de detectar, medir, desplegar con flag y observar, con gente tomando las decisiones finales, y con la humildad de asumir que probablemente el primer sprint sea de instrumentación, no de optimización.