En pocas palabras: Desde el 29 de septiembre de 2026, Amazon Bedrock ofrece inferencia en región para Claude Opus 5 y Claude Sonnet 5 en Seúl (ap-northeast-2), y Claude Sonnet 5 en Singapur (ap-southeast-1), vía el endpoint bedrock-runtime, sin que los datos salgan de esa región.
Si tu equipo trabaja con datos de clientes en Corea del Sur o Singapur, este anuncio de AWS resuelve un problema puntual: hasta ahora, usar los modelos más nuevos de Anthropic con garantía de residencia de datos en esas dos regiones era, en el mejor de los casos, incómodo. Con la inferencia en región (in-region inference), Bedrock procesa el prompt y devuelve la respuesta sin que nada cruce la frontera de la región elegida.
En este artículo:
- En 30 segundos
- ¿Qué anunció AWS sobre Claude en Seúl y Singapur?
- ¿Qué es la inferencia en región de Amazon Bedrock?
- ¿Cuándo conviene inferencia en región y cuándo cross-Region? Criterios para decidir
- ¿Cómo se invoca Claude Opus 5 o Sonnet 5 con la API de Bedrock?
- ¿Qué implica esto para empresas que operan en Asia Pacífico?
- Errores comunes al implementar inferencia en región
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Claude Opus 5 y Claude Sonnet 5 ya están disponibles con inferencia en región en Seúl (ap-northeast-2).
- Claude Sonnet 5 también está disponible con inferencia en región en Singapur (ap-southeast-1).
- Todo corre sobre el endpoint bedrock-runtime, sin capa de enrutamiento entre regiones.
- Pensado para sectores con residencia de datos estricta: finanzas, salud y sector público.
- Se invoca vía Converse API, InvokeModel API o Anthropic Messages API con los IDs anthropic.claude-opus-5 y anthropic.claude-sonnet-5.
¿Qué anunció AWS sobre Claude en Seúl y Singapur?
AWS habilitó Claude Opus 5 y Claude Sonnet 5 en la región de Seúl, y Claude Sonnet 5 en Singapur, con inferencia en región sobre el endpoint bedrock-runtime, según el blog oficial de AWS. El endpoint que usás es siempre el mismo: bedrock-runtime. Lo que cambia es la región que apuntás en tu cliente (ap-northeast-2 o ap-southeast-1) y el ID del modelo que invocás (anthropic.claude-opus-5 o anthropic.claude-sonnet-5).
Vale la pena notar algo que el anuncio no dice explícitamente pero que se desprende de cómo está construido: la disponibilidad es asimétrica entre las dos regiones (Opus 5 solo en Seúl, Sonnet 5 en ambas). Si tu arquitectura necesita el modelo más grande y operás desde Singapur, hoy no tenés esa opción con garantía de residencia local; tendrías que evaluar si tu caso de uso tolera Sonnet 5 o si necesitás esperar una ampliación futura.
¿Qué es la inferencia en región de Amazon Bedrock?
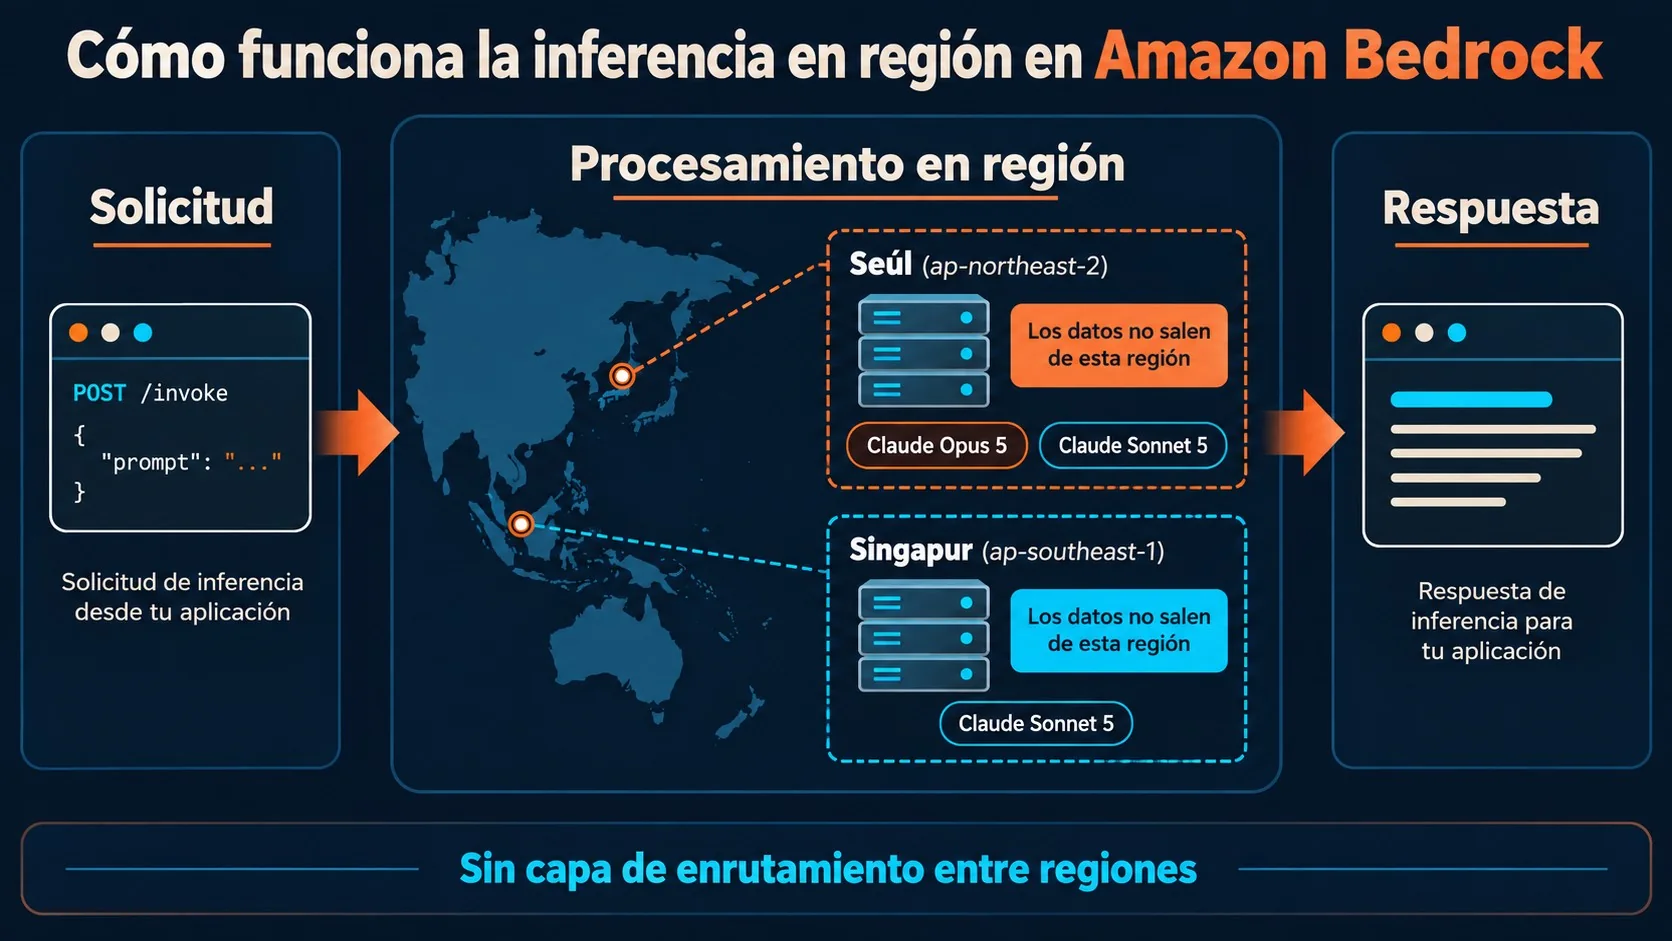
La inferencia en región (in-region inference) es un modo de Amazon Bedrock donde tu solicitud se procesa por completo dentro de la única región de AWS que especificás, sin salir de ella en ningún momento del ciclo de vida del request, según AWS. A diferencia de los perfiles de inferencia cross-Region, acá no hay capa de enrutamiento: el prompt que le mandás a Seúl lo procesa Seúl, y el que le mandás a Singapur lo procesa Singapur.
Ejemplo hipotético (a modo ilustrativo, no un caso real): imaginemos un banco con sede en Seúl que quiere usar Claude Sonnet 5 para resumir reclamos de clientes. Su equipo de compliance exige que ningún dato personal salga de Corea del Sur durante el procesamiento. Con in-region inference, el banco apunta su cliente a ap-northeast-2, invoca anthropic.claude-sonnet-5, y tanto el prompt (que puede incluir fragmentos del reclamo) como la respuesta del modelo quedan procesados dentro de esa región. Si en cambio usara un perfil de inferencia cross-Region, no tendría forma de garantizar por contrato que el procesamiento no se derive a otra región en un pico de demanda.
Los casos de uso que menciona la fuente son concretos: servicios financieros, salud y sector público, justo las industrias donde la residencia de datos no es una sugerencia sino un requisito legal.
¿Cuándo conviene inferencia en región y cuándo cross-Region? Criterios para decidir
Más allá de lo que dice el anuncio, la decisión entre uno y otro esquema depende en la práctica de tres o cuatro variables que conviene chequear antes de armar la arquitectura:
- ¿Tenés una obligación regulatoria explícita de residencia de datos? Si la respuesta es sí (por ejemplo, normativa financiera local en Corea del Sur), in-region inference es la opción por defecto: no hay forma de que cross-Region te dé esa garantía contractual, porque su diseño incluye enrutamiento entre regiones.
- ¿Tu carga tiene picos que superan la capacidad de una sola región? Si necesitás que Bedrock reparta tráfico automáticamente cuando una región se satura, cross-Region tiene esa flexibilidad y in-region no. Acá el trade-off es directo: previsibilidad de dónde viven los datos versus margen de escalado automático.
- ¿Tu equipo de monitoreo ya tiene procesos separados por región? Con in-region, facturación, CloudWatch y CloudTrail quedan todos en la misma región, sin distinción origen/destino que rastrear. Si tu tablero de costos y logs ya está pensado por región, esto simplifica en vez de complicar.
- ¿El modelo que necesitás está disponible en tu región con esta modalidad? Como vimos, hoy Opus 5 solo tiene in-region inference en Seúl. Si tu prioridad es el modelo más grande y operás desde Singapur, este criterio puede ser el que defina todo lo demás.
En la práctica, ninguno de estos criterios es excluyente: lo habitual es que el requisito regulatorio (el primero) pese más que los otros tres, porque no es negociable. Los demás sirven para anticipar fricciones operativas, no para descartar la opción.
¿Cómo se invoca Claude Opus 5 o Sonnet 5 con la API de Bedrock?
Se invoca con el ID directo del modelo (anthropic.claude-opus-5 o anthropic.claude-sonnet-5) usando tres vías equivalentes: la API InvokeModel, la API Converse de Bedrock, o el SDK de Anthropic apuntando al endpoint bedrock-runtime de la región elegida. En términos prácticos, el Playground de la consola sirve para probar prompts sin escribir código; Boto3 con InvokeModel o Converse es la vía habitual si tu backend ya está en Python y usa AWS SDK; y el SDK de Anthropic tiene sentido si tu código ya está escrito contra la API nativa de Anthropic y querés migrarlo a Bedrock con cambios mínimos.
Desde la consola de Bedrock, sin escribir una línea de código, podés probar los modelos en el Playground:
- Abrí la consola de Amazon Bedrock en la región que querés usar como origen (Seúl o Singapur).
- Vas a Test > Playground en el panel de navegación.
- Elegís “Select model” en el centro de la pantalla.
- Buscás anthropic.claude-opus-5, seleccionás “On-Demand” bajo Inference, y aplicás.
- Escribís el prompt y corrés para generar la respuesta.
Por código, con Boto3 apuntando a Singapur, el flujo con InvokeModel se ve así: creás un cliente bedrock-runtime con region_name=”ap-southeast-1″, y llamás invoke_model con modelId=”anthropic.claude-sonnet-5″, pasando el body con anthropic_version, max_tokens y el array de messages, tal como muestra el ejemplo oficial de AWS.
Con la Converse API el patrón es parecido, pero apuntando a Seúl (ap-northeast-2) e invocando anthropic.claude-opus-5, pasando inferenceConfig con maxTokens. Y si preferís el SDK de Anthropic directamente, usás Anthropic(base_url=”https://bedrock-runtime.ap-northeast-2.amazonaws.com/anthropic”) junto con el token que genera aws_bedrock_token_generator, para después llamar client.messages.create() como harías con la API nativa de Anthropic.
Requisitos previos según la fuente: cuenta activa de AWS con acceso a Bedrock, AWS CLI configurado, Python 3.8 o superior, y las librerías boto3, anthropic y aws_bedrock_token_generator instaladas vía pip.
¿Qué implica esto para empresas que operan en Asia Pacífico?
Implica que una empresa con operación en Corea del Sur o Singapur puede desplegar aplicaciones de IA generativa con los modelos más recientes de Anthropic sin tener que elegir entre cumplimiento regulatorio y acceso a tecnología de punta. Antes, si tu compliance exigía residencia estricta de datos y no había in-region inference para el modelo que necesitabas, terminabas usando un modelo más viejo o resignando el requisito. Ahora esa tensión se resuelve, al menos para estas dos combinaciones puntuales de modelo y región.
El tema es que esto no aplica a todas las regiones de Bedrock por igual: la disponibilidad varía modelo por modelo y región por región. AWS mantiene actualizada esa información en su guía de disponibilidad regional, así que antes de armar una arquitectura sobre este esquema conviene chequear ahí si tu combinación específica de modelo y región sigue vigente.
Errores comunes al implementar inferencia en región
Acá van los errores que más se repiten cuando alguien arranca con este esquema:
- Asumir que hay failover automático entre regiones. No lo hay. Si Seúl no tiene capacidad disponible en un momento dado, tu request no se redirige solo a otra región como pasaría con cross-Region inference.
- Mezclar el ID del modelo con el de un perfil cross-Region. Para in-region inference usás el ID directo (anthropic.claude-opus-5), no un ARN de perfil de inferencia entre regiones.
- No revisar las cuotas de servicio por región antes de escalar. Cada región tiene sus propios límites, y no se comparten con otras regiones donde también tengas Bedrock activo.
- Olvidarse de instalar aws_bedrock_token_generator cuando se usa el SDK nativo de Anthropic contra Bedrock, lo que rompe la autenticación silenciosamente.
Preguntas Frecuentes
¿Qué es la inferencia en región (in-region inference) de Amazon Bedrock?
Es un modo de procesamiento donde tu solicitud a un modelo se ejecuta enteramente dentro de la región de AWS que especificás, sin salir de ella y sin capa de enrutamiento hacia otras regiones. Está pensado para cargas de trabajo con requisitos estrictos de residencia de datos.
¿Qué modelos de Claude están disponibles en Seúl y Singapur?
En Seúl (ap-northeast-2) están disponibles Claude Opus 5 y Claude Sonnet 5 con inferencia en región. En Singapur (ap-southeast-1) está disponible Claude Sonnet 5. Ambos corren sobre el endpoint bedrock-runtime.
¿Para qué sirve procesar los datos de IA dentro de una sola región de AWS?
Sirve para cumplir con leyes o políticas internas de residencia de datos, sobre todo en sectores como financiero, salud y sector público en Corea del Sur o Singapur. Garantiza que el prompt y la respuesta no cruzan fronteras durante el procesamiento.
¿Cómo se invoca Claude Opus 5 o Sonnet 5 con la API de Bedrock?
Se invoca con el ID directo del modelo, anthropic.claude-opus-5 o anthropic.claude-sonnet-5, usando InvokeModel API, Converse API, o el SDK de Anthropic apuntado al endpoint bedrock-runtime de la región correspondiente.
¿Cómo decido entre inferencia en región y cross-Region para mi caso?
El criterio principal es si tenés una obligación regulatoria explícita de residencia de datos: si la tenés, in-region inference es la opción por defecto porque cross-Region no puede garantizar contractualmente que el procesamiento se quede en una sola región. Si no tenés esa obligación pero necesitás escalado automático entre regiones en picos de demanda, cross-Region ofrece esa flexibilidad que in-region no tiene.
Conclusión
Lo que cambió es concreto: Claude Opus 5 y Sonnet 5 ahora se pueden usar en Seúl con la garantía de que el procesamiento no sale de esa región, y Sonnet 5 tiene la misma garantía en Singapur. Para equipos con obligaciones de compliance en Asia Pacífico, esto destraba proyectos que antes quedaban frenados por el requisito de residencia de datos, aunque conviene tener presente la asimetría entre regiones (Opus 5 solo en Seúl) al momento de elegir dónde montar la arquitectura.
Si estás evaluando esto para tu empresa, el primer paso práctico es chequear la guía de disponibilidad regional de Bedrock para confirmar que tu combinación de modelo y región sigue activa, porque AWS actualiza esa lista con frecuencia y lo que es válido hoy puede sumar o restar modelos mañana.