En pocas palabras: Kimi K3, lanzado por Moonshot AI en julio de 2026, es un modelo Mixture-of-Experts de 2,8 billones de parámetros con contexto de 1M tokens. Su API cuesta USD 0,43 por millón de tokens de entrada y USD 2,15 de salida, casi la mitad que GPT-5.6 Sol.
Moonshot AI lanzó Kimi K3 en julio de 2026: un modelo Mixture-of-Experts de 2,8 billones de parámetros con ventana de contexto de 1M tokens. La API cuesta USD 0,43 por millón de tokens de entrada y USD 2,15 por millón de salida, casi la mitad de lo que cobra GPT-5.6 Sol en output. Ese dato sobre el precio de la API de Kimi K3 es lo que hizo que varios desarrolladores de codegen volvieran a correr sus números.
Kimi K3 es un modelo de lenguaje tipo Mixture-of-Experts (MoE) desarrollado por Moonshot AI, con 2,8 billones de parámetros totales de los cuales solo una fracción se activa por cada token procesado. Tiene contexto de 1M tokens reales, no un “hasta” de marketing, y se accede vía API compatible con el SDK de OpenAI, con precios de entrada y salida por debajo de los de GPT-5.6 Sol y Claude Fable 5.
En este artículo:
- En 30 segundos
- ¿Qué es Kimi K3 y qué arquitectura tiene?
- ¿Cuánto cuesta la API de Kimi K3 frente a GPT-5.6 Sol y Claude Fable 5?
- ¿Qué resultados obtuvo Kimi K3 en los benchmarks?
- ¿Por qué el caché de Kimi K3 baja tanto el costo real?
- ¿Se puede instalar Kimi K3 en un servidor propio?
- ¿Cómo se accede a la API de Kimi K3 con Python?
- Qué significa esto para equipos en Latinoamérica
- Qué está confirmado y qué no
- Errores comunes al evaluar Kimi K3 API
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Moonshot AI lanzó Kimi K3 en julio de 2026, según el análisis técnico publicado en Dev.to.
- El modelo MoE tiene 2,8 billones de parámetros totales, con solo una fracción activa por token.
- Contexto real de 1M tokens, con coherencia comprobada hasta más de 500K tokens en pruebas con repositorios grandes.
- Precio: USD 0,43/M de entrada y USD 2,15/M de salida, contra USD 0,70/USD 4,20 de GPT-5.6 Sol.
- El caché de contexto baja el costo de entrada a USD 0,05/M, un descuento del 88%.
¿Qué es Kimi K3 y qué arquitectura tiene?
Kimi K3 es un modelo sparse MoE de 2,8 billones de parámetros totales, donde solo una parte se activa en cada inferencia. Esa arquitectura explica por qué el precio de la API de Kimi K3 es agresivo: pagás por el cómputo activo, no por toda la matriz de pesos del modelo.
El contexto de 1M tokens es real, no una cifra “hasta” que después se cae en la práctica. Según las pruebas descritas en Dev.to, el modelo mantiene coherencia bien pasados los 500K tokens en dumps de repositorios grandes. Eso importa para quienes cargan bases de código enteras en un solo prompt.
¿Cuánto cuesta la API de Kimi K3 frente a GPT-5.6 Sol y Claude Fable 5?
Kimi K3 cobra USD 0,43 por millón de tokens de entrada y USD 2,15 por millón de salida, con contexto de 1M. GPT-5.6 Sol pide USD 0,70 y USD 4,20 con 400K de contexto. Claude Fable 5 sube a USD 1,40 y USD 7,00 con 500K. Más contexto en los cambios que trajo GPT-5.6 Sol.
| Modelo | Input ($/M) | Output ($/M) | Contexto |
|---|---|---|---|
| Kimi K3 | $0,43 | $2,15 | 1M |
| GPT-5.6 Sol | $0,70 | $4,20 | 400K |
| Claude Fable 5 | $1,40 | $7,00 | 500K |
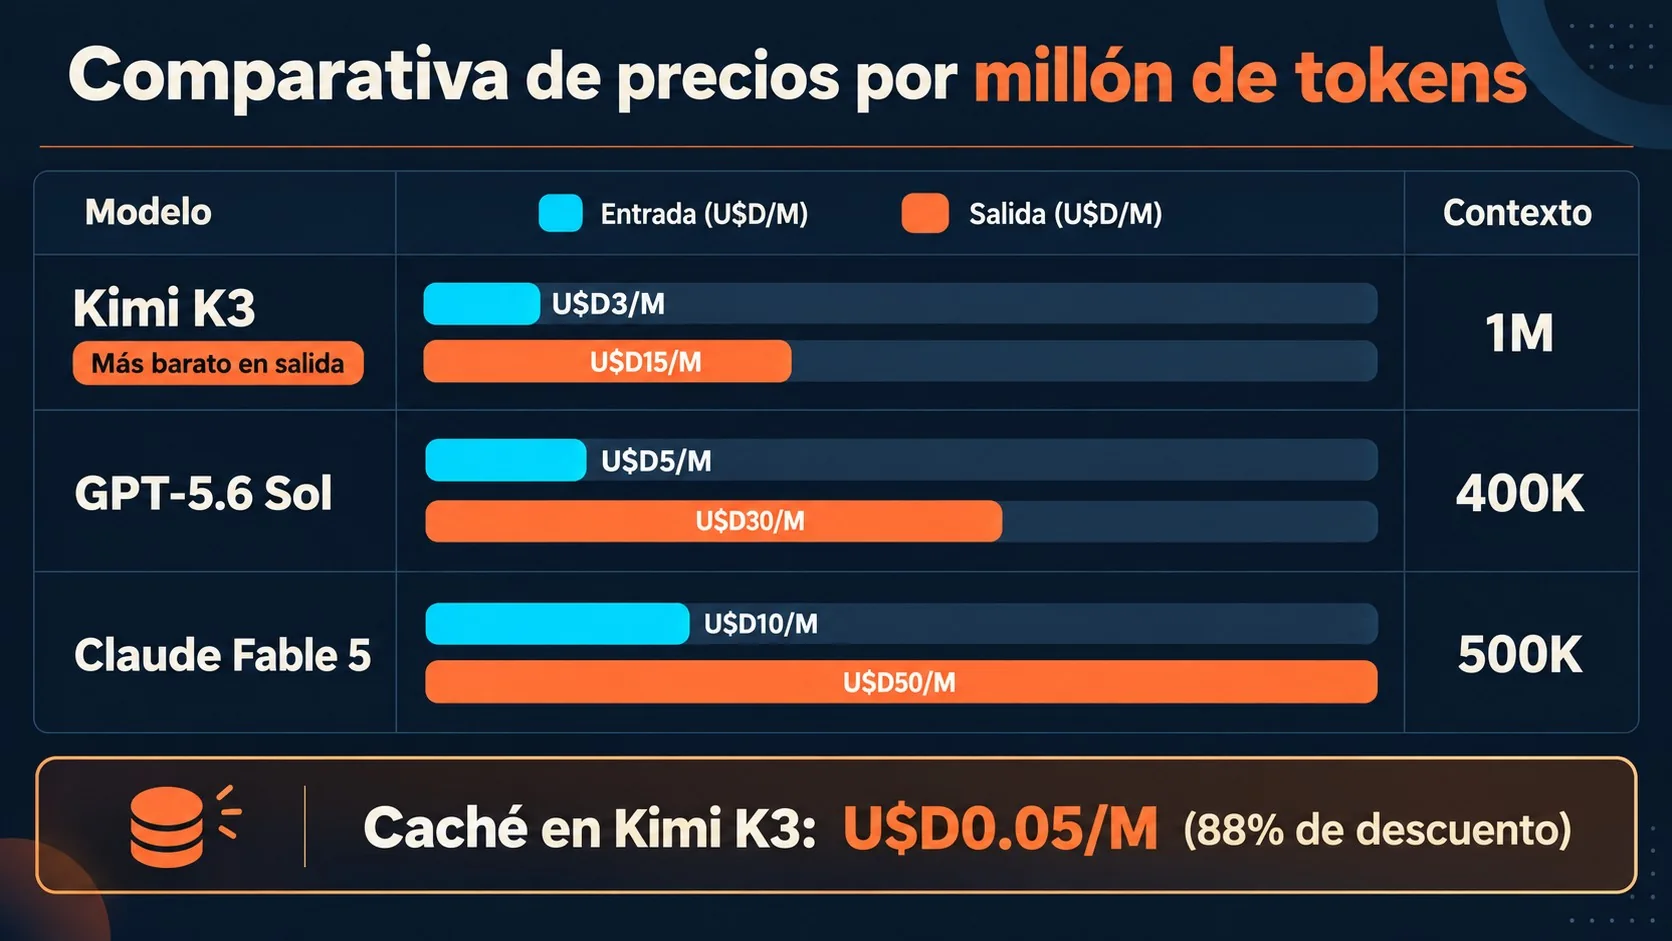
En output, donde vive la mayor parte del gasto en workloads reales, K3 sale casi la mitad que GPT-5.6 Sol y un tercio de Claude Fable 5. En un equipo que genera 50M tokens de salida por mes, la diferencia contra Claude Fable 5 es entre USD 107 y USD 350, según el cálculo del análisis de Dev.to. Ojo con un detalle: esos números salen de un gateway de terceros (Yingsuan), no necesariamente del precio directo que Moonshot AI publica en su propio sitio. El centro de ayuda oficial de Kimi confirma facturación por token, pero remite a la tabla completa en platform.kimi.ai/docs/pricing/chat para las cifras exactas. Antes de armar un presupuesto, conviene chequear ese link directo.
¿Qué resultados obtuvo Kimi K3 en los benchmarks?
Kimi K3 quedó #1 en frontend coding, #9 global en TextArena y #3 en GDPval-AA. El dato que más pesa para quienes construyen herramientas de codegen es el primero.
- TextArena #9 global: top-10 en razonamiento general y seguimiento de instrucciones, sin ser el líder absoluto de la categoría.
- Frontend coding #1: supera a los modelos frontera en generación de UI y componentes, según el ranking citado en el análisis de Dev.to.
- GDPval-AA #3: puntaje fuerte en evaluación agéntica, útil si el caso de uso incluye agentes que ejecutan tareas encadenadas.
¿Significa que K3 es el mejor modelo del mercado en todo? No. Es #9 global en razonamiento, no #1. La fortaleza está concentrada en codegen y frontend, no repartida por igual en cada categoría.
¿Por qué el caché de Kimi K3 baja tanto el costo real?
El precio de caché de Kimi K3 es USD 0,05 por millón de tokens, un 88% de descuento sobre el input normal de USD 0,43. Eso cambia la economía de los agentes de código que reenvían el mismo system prompt y el mismo árbol de archivos en cada turno de la conversación.
En sesiones agénticas largas, los cache hits pueden representar entre 70% y 90% del volumen de input, así que el costo efectivo de entrada colapsa a un rango de USD 0,08 a USD 0,12 por millón. Ese es el número que hace viable a K3 para un asistente de código que está siempre prendido, procesando el mismo contexto base una y otra vez, con pequeñas variaciones en cada llamada. Eso sí: el descuento solo aplica si el system prompt y el contexto estático se mantienen idénticos entre llamadas, así que un prompt que cambia en cada request no ve ese beneficio. Para más detalles técnicos, mirá las diferencias entre API y MCP.
¿Se puede instalar Kimi K3 en un servidor propio?
No es realista. Un modelo de 2,8 billones de parámetros necesita mínimo 8 GPU H100 para un despliegue usable, y más todavía para sostener la KV cache con contexto de 1M tokens.
Eso implica más de USD 150.000 en hardware antes de sumar energía, refrigeración y operación, según el análisis técnico. Salvo que correr inferencia sea tu negocio principal, la API sale estrictamente más barata que armar tu propio cluster.
¿Cómo se accede a la API de Kimi K3 con Python?
Se accede con el SDK de OpenAI, cambiando solo el api_key y el base_url. K3 es compatible con ese SDK, así que si ya tenés integrado GPT en tu stack, la migración es de dos líneas.
from openai import OpenAI

client = OpenAI(
 api_key="TU_API_KEY",
 base_url="https://api.yingsuan.ai/v1" # gateway unificado
)

response = client.chat.completions.create(
 model="kimi-k3",
 messages=[
 {"role": "system", "content": "You are a senior frontend engineer."},
 {"role": "user", "content": "Build a responsive pricing table in React + Tailwind."}
 ],
 temperature=0.3,
 max_tokens=4096
)

print(response.choices.message.content)
Para activar el caching alcanza con mantener el system prompt y el contexto estático idénticos entre llamadas. El gateway pasa el cache_control y los hit rates aparecen en la respuesta de uso. Si querés probar antes de comprometerte, el gateway ofrece 3 modelos permanentemente gratis para prototipar y 100 llamadas de prueba en K3, suficientes para correr tus propios prompts y comparar costo por tarea contra el proveedor que ya usás. Sobre eso hablamos en cómo se compara frente a Fable 5 y GPT 5.6 Sol.
Qué significa esto para equipos en Latinoamérica
Para un equipo que factura en pesos, dólares blue o cualquier moneda que no sea la de Silicon Valley, la diferencia entre USD 0,43 y USD 1,40 por millón de tokens de entrada no es un detalle de laboratorio. Es presupuesto real.
El gateway mencionado en la fuente permite empezar sin tarjeta de crédito y sumar fondos vía Wise para desarrolladores sin tarjeta emitida en Estados Unidos, algo que resuelve una fricción habitual en la región. Dicho esto, conviene verificar los términos de servicio y la jurisdicción del proveedor antes de mandar tráfico de producción, sobre todo si manejás datos sensibles de clientes.
Qué está confirmado y qué no
- Confirmado: el centro de ayuda oficial de Kimi confirma que K3 factura por token y ofrece contexto de 1M; los datos de 2,8 billones de parámetros, la arquitectura MoE y la fecha de lanzamiento (julio de 2026) provienen del análisis publicado en Dev.to, no del centro de ayuda oficial.
- Confirmado: el modelo es compatible con el SDK de OpenAI, cambiando api_key y base_url.
- No confirmado de forma independiente: las cifras de la tabla comparativa provienen de un gateway de terceros y de un análisis publicado en Dev.to, no de un benchmark auditado por un tercero neutral.
- Pendiente de verificar por vos mismo: el precio oficial exacto que cobra Moonshot AI de forma directa, disponible en platform.kimi.ai/docs/pricing/chat, puede diferir del listado en la comparativa.
Errores comunes al evaluar Kimi K3 API
- Tomar el precio del gateway como precio oficial de Moonshot: son dos cosas distintas. Antes de presupuestar, revisá la tabla directa en platform.kimi.ai/docs/pricing/chat.
- No activar el caching en el loop del agente: si el system prompt cambia mínimamente entre llamadas, perdés el descuento del 88% y pagás el input completo cada vez.
- Comparar el self-hosting solo por el precio del hardware: los USD 150.000 en GPUs no incluyen energía, refrigeración ni el equipo de ops necesario para mantener el cluster corriendo.
- Generalizar el #1 en frontend coding a “el mejor modelo en todo”: K3 es #9 global en TextArena, no líder en razonamiento general.
Preguntas Frecuentes
¿Cuánto cuesta la API de Kimi K3?
Según la comparación publicada en Dev.to, la API cobra USD 0,43 por millón de tokens de entrada y USD 2,15 por millón de salida, con contexto de 1M tokens. Con cache hits, ese costo de entrada baja a USD 0,05 por millón. Para el precio oficial directo de Moonshot conviene revisar platform.kimi.ai/docs/pricing/chat.
¿Kimi K3 es más barato que GPT-5.6 Sol?
Sí, en output tokens Kimi K3 cuesta casi la mitad: USD 2,15 por millón contra USD 4,20 de GPT-5.6 Sol. En input también sale más barato, USD 0,43 contra USD 0,70 por millón. En nuestra comparativa entre GPT-5 y Claude profundizamos sobre esto.
¿Cómo se usa Kimi K3 con el SDK de OpenAI?
K3 es compatible con el SDK de OpenAI: alcanza con cambiar el api_key y el base_url apuntando al gateway o a la API de Moonshot, y poner model=”kimi-k3″ en la llamada a chat.completions.create.
¿Se puede correr Kimi K3 en hardware propio?
Técnicamente sí, pero no conviene: hacen falta al menos 8 GPU H100 y más de USD 150.000 en hardware antes de sumar energía y operación. Para la mayoría de los equipos, la API resulta más barata que ese despliegue.
¿Qué resultados dio Kimi K3 en los benchmarks de código?
Kimi K3 quedó #1 en frontend coding, generación de UI y componentes, además de #9 global en TextArena y #3 en GDPval-AA para evaluación agéntica, según los rankings citados en el análisis de Dev.to.
Conclusión
Kimi K3 no gana por ser “la alternativa barata”. Gana porque es #1 en frontend coding y porque el precio de caché a USD 0,05 por millón vuelve viable un agente de código que está corriendo todo el día. El costo más bajo que GPT-5.6 Sol es un plus, no el argumento principal.
Si hoy pagás tarifas de GPT-5.6 Sol o Claude Fable 5 para generación de frontend, el criterio práctico es simple: agarrá tus propios prompts, corré el trial de 100 llamadas en K3, y comparalo contra tu factura actual del mes pasado. Ese cálculo, hecho con tu tráfico real y no con el benchmark de otro, es el único que te va a decir si conviene migrar.