
En pocas palabras: Claude Haiku 5.5, lanzado por Anthropic el 7 de octubre de 2026, cuesta USD 0,10 por millón de tokens de entrada y USD 0,50 de salida en prompts de hasta 100K tokens. Es 90% menos que Haiku 4.5, pero arriba de ese umbral sube 5x.
Claude Haiku 5.5 es el modelo chico de Anthropic. Salió el 7 de octubre de 2026 y cuesta USD 0,10 por millón de tokens de entrada y USD 0,50 de salida, pero solo para prompts de hasta 100K tokens. Arriba de ese umbral el precio sube 5x, según la página oficial de precios.
Claude Haiku 5.5 es un modelo de lenguaje pequeño y rápido de Anthropic, pensado para tareas repetitivas de alto volumen: resúmenes, clasificación, consultas a bases de datos y subtareas de agentes. Es el primer Haiku con nivel de esfuerzo ajustable, tiene ventana de contexto de 1M de tokens y se llama desde la API como claude-haiku-5-5, también en AWS, Google Cloud y Azure.
En este artículo:
- En 30 segundos
- ¿Cuánto cuesta Claude Haiku 5.5 y qué cambia por encima de los 100K tokens?
- ¿Es Haiku 5.5 realmente 90% más barato que Haiku 4.5?
- ¿Cómo queda Claude Haiku 5.5 frente a GPT Luna, DeepSeek y Gemini Flash?
- ¿Para qué tareas sirve Claude Haiku 5.5 y para cuáles no?
- ¿Conviene migrar de Sonnet a Haiku 5.5?
- Qué significa para equipos en Latinoamérica
- Qué está confirmado y qué no
- Errores comunes al evaluar Haiku 5.5
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
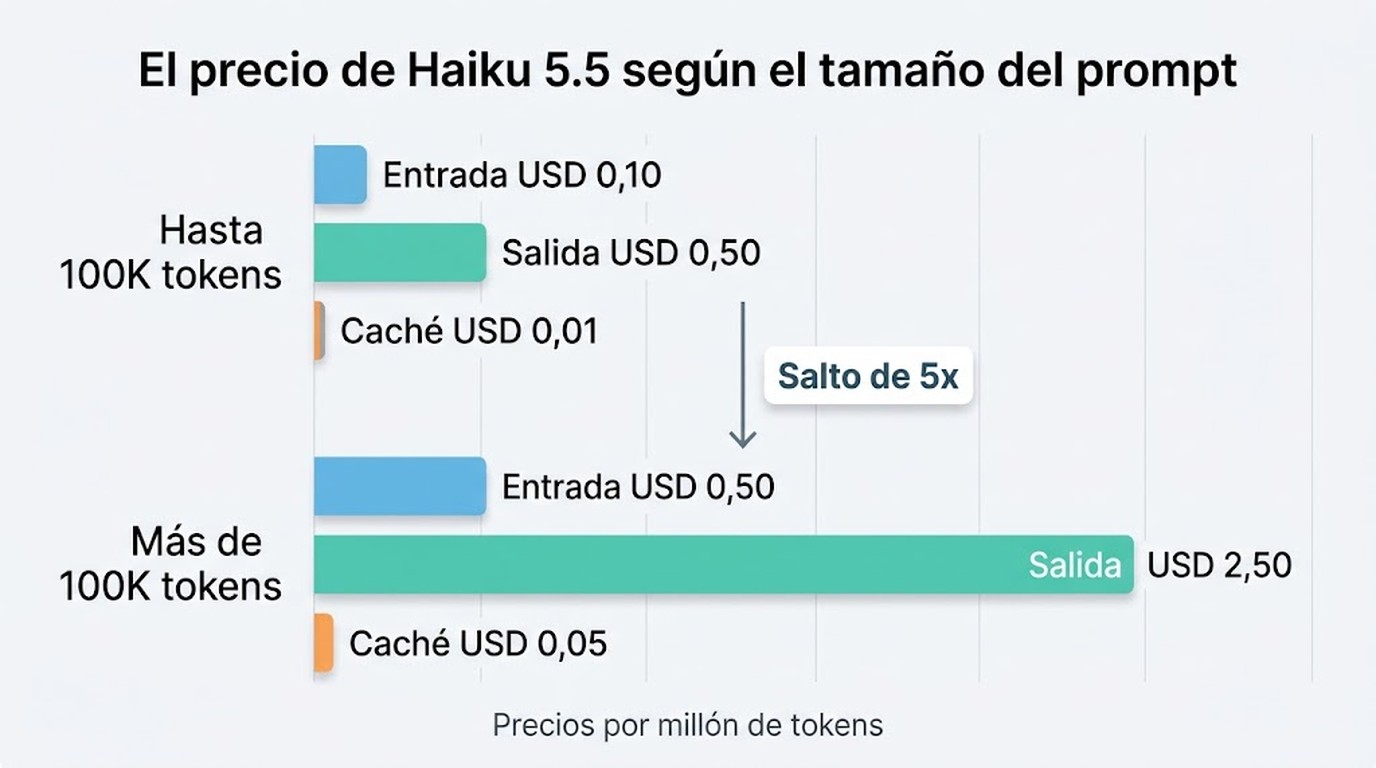
- Hasta 100K tokens de prompt: USD 0,10 de entrada, USD 0,50 de salida y USD 0,01 de lectura de caché por millón.
- Arriba de 100K tokens: USD 0,50, USD 2,50 y USD 0,05. Es un salto de 5x.
- El recorte de 90% frente a Haiku 4.5 (USD 1 / USD 5) vale solo para prompts cortos. Anthropic habla de alrededor de 75% en promedio.
- Los benchmarks son de Anthropic y no hay verificación independiente en las fuentes consultadas.
- La comparación con GPT Luna tiene datos contradictorios entre fuentes y queda pendiente de verificar.
¿Cuánto cuesta Claude Haiku 5.5 y qué cambia por encima de los 100K tokens?
El USD 0,10 es real: figura en la página oficial de precios de Claude. Pero no es un precio único. Tiene dos tramos, y el corte está en 100K tokens de prompt. Pasado ese punto, la ventana de 1M de contexto sigue disponible, solo que usarla sale cinco veces más caro en entrada y salida.
| Concepto (USD por millón de tokens) | Haiku 5.5, hasta 100K | Haiku 5.5, más de 100K | Haiku 4.5 |
|---|---|---|---|
| Entrada | 0,10 | 0,50 | 1,00 |
| Salida | 0,50 | 2,50 | 5,00 |
| Lectura de caché | 0,01 | 0,05 | 0,10 |
| Escritura de caché | 0,125 | 0,625 | 1,25 |
Ejemplo hipotético con aritmética simple: un prompt de 150K tokens cuesta USD 0,075 de entrada en Haiku 5.5 (150.000 / 1.000.000 x 0,50). Un prompt de 50K cuesta USD 0,005. El texto es tres veces más largo y la cuenta es quince veces mayor.
Lo que no queda claro: VentureBeat aclara que los materiales de Anthropic no especifican cómo se factura un pedido de exactamente 100.000 tokens ni qué tokens definen el umbral. Si tu carga anda cerca de esa línea, probalo con la API antes de presupuestar.
¿Es Haiku 5.5 realmente 90% más barato que Haiku 4.5?
Solo con prompts de hasta 100K tokens. Contra los USD 1 / USD 5 de Haiku 4.5, el precio de lista baja 90% en ese tramo y 50% en el largo. Anthropic estima que el ahorro promedio en cargas reales ronda el 75%, porque el tokenizador nuevo usa más tokens por tarea.
Los datos de cada fuente, separados:
- Lo que dice Anthropic (vía VentureBeat y Technology.org): cerca de 90% de los pedidos a Haiku 4.5 caían en el tramo corto, y el ahorro promedio estimado es de 75%, ya contando el tokenizador. Es una estimación de la empresa.
- Lo que dice el análisis de dev.to: el tokenizador, compartido con la familia Opus 4.7+, genera entre 1x y 1,35x tokens para el mismo texto, y el ahorro real rondaría 75%. Technology.org menciona el mismo tokenizador, pero lo asocia con Sonnet 5.5 y Opus 5.5.
Ejemplo hipotético: si el peor caso de 1,35x se cumple, un texto que antes costaba USD 1 de entrada pasa a USD 0,135 (0,10 x 1,35). Es un ahorro de 86,5% solo en entrada y con prompt corto. Ese número es mío, calculado con la cota del análisis, y no está medido. Tema relacionado: cómo se compara GPT-5 con Anthropic.
El “90% más barato” del titular es cierto en la tabla de precios. En tu factura va a depender de cuántos prompts largos mandes y de cuántos tokens genere tu texto.
¿Cómo queda Claude Haiku 5.5 frente a GPT Luna, DeepSeek y Gemini Flash?
Depende de la fuente. El análisis de dev.to ubica a Haiku 5.5 por debajo de Luna (USD 0,20 / 1,20). VentureBeat dice que GPT-6 Luna cuesta lo mismo que Haiku 5.5 en el tramo corto (USD 0,10 / 0,50). Esa discrepancia no está resuelta y hay que verificarla en la página oficial de OpenAI antes de decidir.
| Modelo | Entrada (USD/M) | Salida (USD/M) | Fuente y nota |
|---|---|---|---|
| Claude Haiku 5.5 (hasta 100K) | 0,10 | 0,50 | Precios oficiales de Anthropic |
| Luna, según dev.to (“GPT-5.6 Luna”) | 0,20 | 1,20 | Contradice a VentureBeat. Pendiente de verificar |
| GPT-6 Luna, según VentureBeat | 0,10 | 0,50 | Tarifas base. Más caro arriba de 272.000 tokens de entrada |
| DeepSeek V4.1 Flash | 0,15 | 0,60 | Solo en dev.to |
| Gemini 3.8 Flash | 0,75 | 3,75 | Tarifa promocional hasta el 31/12/2026 (VentureBeat) |
| Gemini 2.5 Flash-Lite | 0,10 | 0,40 | Solo en dev.to. Modelo de generación anterior |
| Gemini 3.5 Flash-Lite | 0,30 | 2,50 | Solo en VentureBeat |
Una tabla de precios no dice cuál modelo resuelve mejor tu tarea. Los benchmarks que cita Technology.org son de Anthropic: Haiku 5.5 saca 72,4% en OSWorld 2.1 contra 48,9% de GPT-6 Luna, y 39,2% en Terminal-Bench 4.0 contra 16,4%. VentureBeat agrega un detalle clave: ese 39% corresponde al esfuerzo máximo, y en esfuerzo medio (el valor por defecto) el puntaje ronda 20%.
Los elogios de Bijan Bowen que recoge dev.to son pruebas informales de un creador de contenido (no son una evaluación reproducible). Lo explicamos a fondo en diferencias entre ambas APIs en costos y rendimiento.
¿Para qué tareas sirve Claude Haiku 5.5 y para cuáles no?
Sirve para trabajo repetitivo y acotado: clasificación, extracción, resúmenes, consultas a bases de datos, voz y soporte en vivo, y como subagente barato de un modelo grande. Anthropic mismo lo describe como apoyo de Opus 5.5 y Sonnet 5.5, que siguen recomendados para código complejo.
Alex Wang, de IA aplicada en Rogo, lo resumió así en una declaración que recoge VentureBeat (traducción nuestra): “es lo bastante preciso como para confiar en él ahí, y lo bastante rápido y barato como para correrlo muchas veces”.
Cuándo conviene Haiku 5.5
- Clasificación y extracción estructurada: salidas bien definidas, poca ambigüedad.
- Bucles internos de agentes: decidir qué herramienta llamar y leer su salida, dejando el modelo caro para la síntesis final.
- Triage y pre-filtrado: una primera pasada barata que decide si escalar a un modelo mayor.
- Generación de alto volumen y bajo riesgo: notificaciones, borradores de respuesta, descripciones.
Cuándo conviene otro modelo
- Razonamiento complejo: el análisis de dev.to dice que el techo de Haiku es menor, y los números de Anthropic lo confirman en código (70,6% de Sonnet 5.5 contra 39,2% en Terminal-Bench 4.0).
- Síntesis de contexto largo: pasado el umbral de 100K pagás USD 0,50 de entrada, y Sonnet 5.5 cuesta USD 2 con mayor capacidad.
- Texto creativo de cara al cliente: acá la diferencia de calidad pesa más que centavos por llamada.
La regla práctica de dev.to: si la salida la consume otro sistema, Haiku; si la juzga una persona, un modelo más caro. Es la recomendación de un analista, no un resultado medido.
¿Conviene migrar de Sonnet a Haiku 5.5?
Solo para las llamadas cuya salida se pueda validar de forma automática. Sonnet 5.5 cuesta USD 2 / 10, veinte veces más en entrada que Haiku 5.5 en el tramo corto, pero Anthropic reservó para Sonnet el trabajo de código complejo. Migrá por tipo de llamada, no por proyecto completo. Complementá con el contraste con la generación Claude 3.
Antes de mover tráfico, esto es lo que conviene revisar (propuesta editorial, no probada por nosotros):
- Distribución de longitud de prompts: medí qué porcentaje de tus pedidos supera los 100K tokens. Anthropic dice que cerca de 90% de los pedidos a Haiku 4.5 quedaban abajo, pero tu caso puede ser distinto.
- Consumo real de tokens: corré la misma muestra con el tokenizador nuevo y comparalo con tu historial.
- Efecto del caché: la lectura cuesta USD 0,01 por millón, cien veces menos que la entrada estándar. En agentes con prompt de sistema estable es donde más se nota.
- Nivel de esfuerzo: probá medio y máximo. La diferencia en Terminal-Bench (cerca de 20% contra 39%) sugiere que el esfuerzo cambia mucho el resultado.
- Costo por tarea completada: sumá reintentos y fallos, no solo tokens. Un criterio concreto: tomá una muestra de tus propias solicitudes, validá cada salida con un esquema o un test automático y compará el costo total por resultado válido contra tu modelo actual.
Una capa de enrutamiento propia, sea en un VPS tuyo o en un servidor en donweb.com, te deja cambiar de modelo sin reescribir la aplicación. Con precios que se mueven cada pocas semanas (Gemini 3.8 Flash tiene tarifa promocional con fecha de vencimiento), ese desacople vale más que cualquier descuento puntual.
Qué significa para equipos en Latinoamérica
La API se factura en dólares, y la página de precios aclara que los valores no incluyen impuestos aplicables. Las fuentes no traen datos sobre impuestos o recargos para Argentina, así que lo que pagues con tarjeta hay que confirmarlo con tu emisor. Anthropic también tiene un recargo de 1,1x para inferencia solo en EE.UU., por si tu caso lo exige.
Qué está confirmado y qué no
- Confirmado: precios de Haiku 5.5 en dos tramos, precios de Haiku 4.5, Sonnet 5.5 a USD 2 / 10, lectura de caché de Sonnet 5.5 bajando de USD 0,20 a USD 0,10, fecha de lanzamiento (7 de octubre de 2026) y disponibilidad en AWS, Google Cloud y Azure.
- Dato de Anthropic sin verificación independiente: el ahorro promedio de 75% y todos los benchmarks.
- Pendiente: el precio real de Luna (USD 0,10 o USD 0,20 de entrada, según la fuente), el multiplicador exacto del tokenizador, la facturación de pedidos de exactamente 100.000 tokens y la velocidad en tokens por segundo, que VentureBeat dice que Anthropic no informó.
Errores comunes al evaluar Haiku 5.5
- Presupuestar con el precio del tramo corto sin medir prompts largos. Si mandás documentos enteros, tu costo vive en la columna de USD 0,50. Corrección: calculá con tu distribución real.
- Comparar solo precio de lista entre proveedores. Un modelo más barato que falla y reintenta sale más caro. Corrección: medí costo por tarea válida.
- Leer el benchmark de Terminal-Bench sin mirar el esfuerzo. El 39,2% es a esfuerzo máximo. Corrección: probá con el nivel que vas a usar en producción.
- Tomar como definitiva la comparación con Luna. Dos fuentes dan precios distintos. Corrección: verificá en la página oficial de OpenAI.
Preguntas Frecuentes
¿Cuánto cuesta Claude Haiku 5.5 por millón de tokens?
Cuesta USD 0,10 de entrada y USD 0,50 de salida por millón de tokens en prompts de hasta 100K tokens. La lectura de caché sale USD 0,01 y la escritura USD 0,125. Son los precios de la página oficial de Anthropic.
¿Qué pasa con el precio de Haiku 5.5 si mi prompt supera los 100K tokens?
El precio pasa a USD 0,50 de entrada y USD 2,50 de salida por millón, cinco veces el tramo corto. La lectura de caché sube a USD 0,05 y la escritura a USD 0,625. Ya lo cubrimos antes en cómo le fue frente a Claude 4.
¿Haiku 5.5 es 90% más barato que Haiku 4.5?
En precio de lista sí, pero solo para prompts de hasta 100K tokens (USD 0,10 contra USD 1 de entrada). Con prompts largos el recorte es de 50%, y Anthropic estima un ahorro promedio de alrededor de 75% por el tokenizador nuevo.
¿Para qué tareas sirve Claude Haiku 5.5?
Sirve para resúmenes, clasificación, consultas a bases de datos, soporte en vivo, agentes de voz y subtareas de agentes. Anthropic recomienda Sonnet 5.5 y Opus 5.5 para código complejo.
¿Conviene migrar de Sonnet 5.5 a Haiku 5.5?
Conviene en las llamadas con salida verificable de forma automática, como extracción o clasificación, y en prompts de menos de 100K tokens. Para razonamiento complejo o contexto largo, mantené Sonnet 5.5 y comparalo por costo por tarea completada.
Conclusión
Claude Haiku 5.5 baja el piso de precio de Anthropic a USD 0,10 / 0,50, pero con una condición: prompts de hasta 100K tokens. Sobre eso, el descuento se achica y el tokenizador nuevo come parte del ahorro. Los benchmarks son de la propia empresa, así que tomalos con pinzas.
Lo que podés hacer esta semana: medir la longitud de tus prompts, correr una muestra de tus tareas más repetitivas en Haiku 5.5 con esfuerzo medio y máximo, y comparar costo por resultado válido. Si la comparación con Luna te importa, confirmá el precio en la página oficial de OpenAI antes de decidir.
Fuentes
- Claude by Anthropic – página oficial de planes y precios de la API
- Technology.org – Claude Haiku 5.5: precios, benchmarks y salvaguardas (8 de octubre de 2026)
- VentureBeat – lanzamiento de Claude Haiku 5.5 y comparación de precios (7 de octubre de 2026)
- dev.to – análisis de Haiku 5.5 y marco de decisión para builders (9 de octubre de 2026)