
En pocas palabras: No, no se puede. La guía de dev.to del 20 de septiembre de 2026 promete DeepSeek-V3 con vLLM en una droplet GPU de DigitalOcean por $6 mensuales, pero el propio autor admite que en uso continuo el costo real es de $432 a $456 al mes.
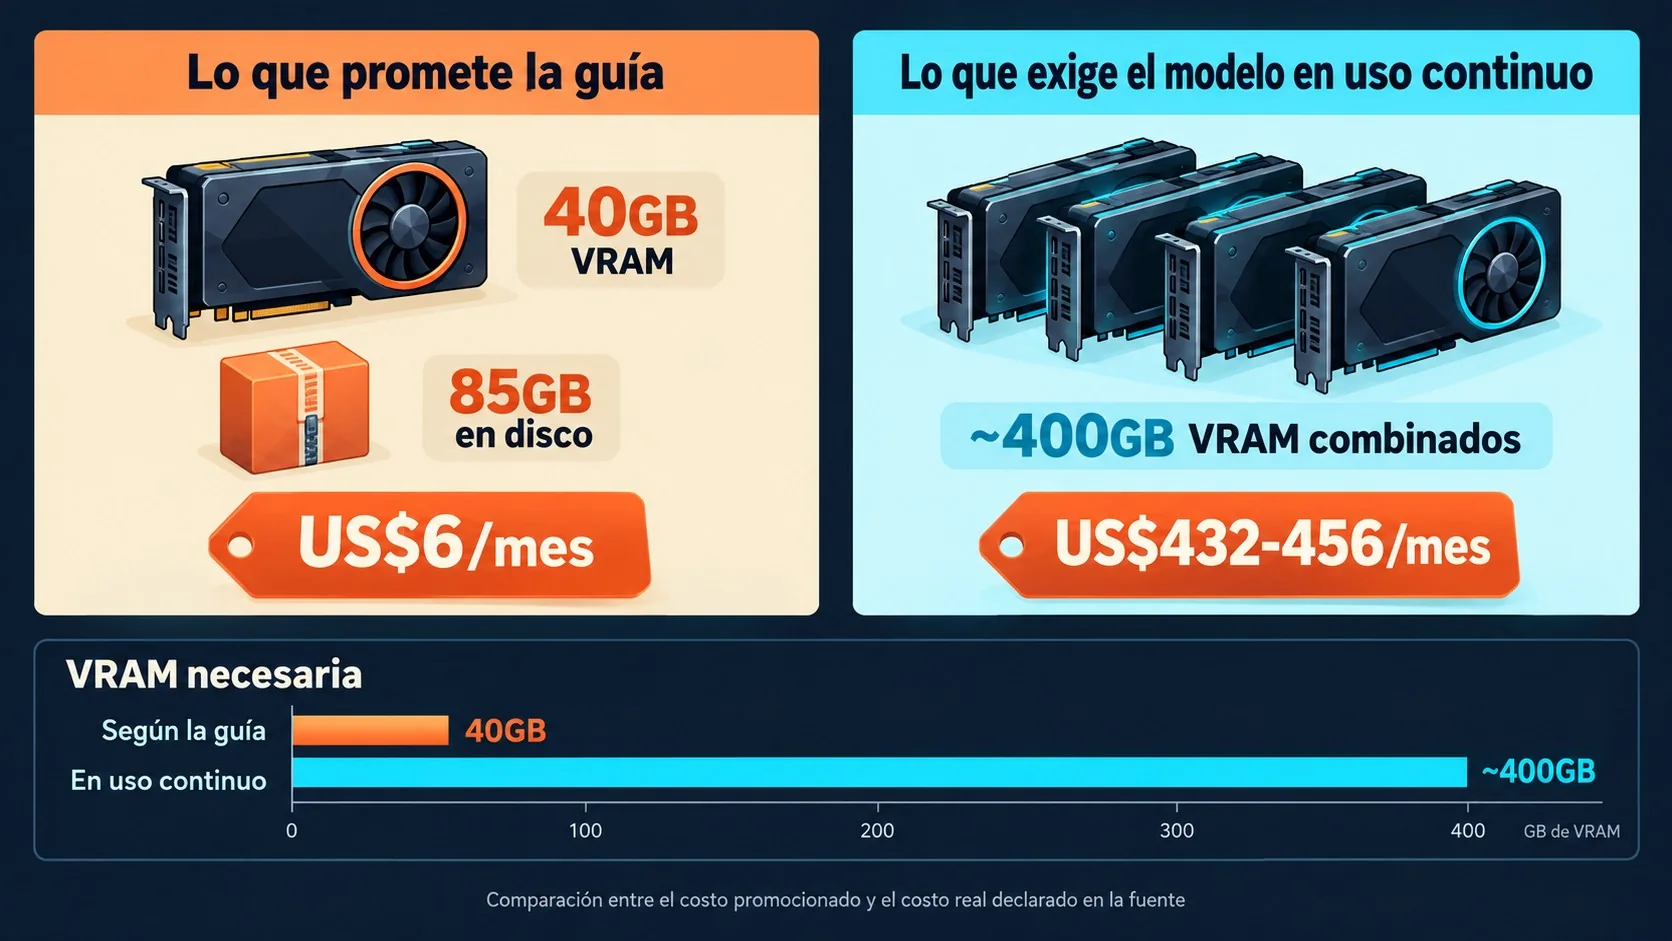
Una guía publicada el 20 de septiembre de 2026 en dev.to asegura que podés desplegar DeepSeek-V3 con vLLM y cuantización de 4 bits en una droplet GPU de DigitalOcean por $6 al mes, reemplazando llamadas a la API de Claude Opus. El propio texto de la guía admite después que ese número solo funciona si compartís el servidor entre varios modelos o lo apagás casi todo el tiempo: en uso continuo, el costo real que declara el autor es de $432 a $456 mensuales.
DeepSeek-V3 es un modelo de lenguaje open source con arquitectura mixture-of-experts (MoE) de 671.000 millones de parámetros totales, de los cuales solo una fracción se activa por cada token procesado. vLLM es un motor de inferencia open source que administra memoria de GPU con paged attention y permite cargar modelos con cuantización nativa para reducir el uso de VRAM. Desplegar DeepSeek-V3 con esta combinación en una droplet GPU es exactamente lo que promete la guía viral que estamos desmenuzando acá, y hay bastante para discutir sobre si los números cierran.
En este artículo:
- En 30 segundos
- ¿Es real que se puede correr DeepSeek-V3 por $6 al mes?
- ¿Cuánta VRAM necesita DeepSeek-V3 con cuantización de 4 bits?
- ¿Qué es vLLM y para qué sirve en un despliegue de este tipo?
- ¿Cuánto cuesta realmente una GPU droplet de DigitalOcean para IA?
- ¿Cómo se compara el rendimiento de DeepSeek-V3 contra Claude Opus?
- ¿Cómo se despliega DeepSeek-V3 en un servidor propio con vLLM?
- ¿Para qué casos conviene evaluar DeepSeek-V3 local en vez de la API de Claude?
- Qué significa para equipos en Latinoamérica
- Qué está confirmado y qué no
- Errores comunes al intentar desplegar DeepSeek-V3
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La guía original habla de $6 al mes, pero su propio cálculo de uso continuo da $432-456 mensuales por una droplet con GPU L40.
- DeepSeek-V3 tiene 671B parámetros totales en arquitectura MoE; la guía dice que la versión cuantizada a 4 bits pesa ~85GB y entra en una GPU de 40GB VRAM.
- Discusiones técnicas independientes en Hugging Face estiman entre 380GB y 400GB de VRAM para correr el modelo completo a 4 bits, muy lejos de los 85GB que menciona la guía.
- En benchmarks citados por el propio autor, DeepSeek-V3 saca 39.2% en AIME contra 40% de Claude Opus, y 59.1% en GPQA contra 64%.
- Claude Opus cobra $15 por millón de tokens de entrada y $60 por millón de salida, según los precios que cita la misma guía.
¿Es real que se puede correr DeepSeek-V3 por $6 al mes?
No, al menos no en el escenario que promete el título. La propia guía de dev.to reconoce que “esto funciona si estás compartiendo la droplet entre varios modelos, o si corrés inferencia on-demand apagando el servidor cuando está inactivo”. Para el escenario de producción continua que el mismo artículo describe (un cliente con 50.000 requests mensuales), el gasto declarado es de $432 al mes solo de GPU L40, más $24 de storage.
Ojo con esto: el autor dice haber gastado $4.200 el mes pasado en llamadas a la API de Claude Opus y haber bajado ese costo a $72 al año con DeepSeek-V3 local. Ese cálculo de $72 anuales no coincide con los $432-456 mensuales que el mismo texto detalla dos párrafos después. Alguien hizo mal las cuentas, o mezcló dos escenarios distintos sin aclararlo (spoiler: probablemente sea lo segundo).
Lo que sí queda claro es la lógica de fondo: si tenés volumen alto y sostenido de requests, una GPU propia puede salir más barata que pagar por token en una API. La pregunta es a qué costo real, y ahí el titular se queda corto.
¿Cuánta VRAM necesita DeepSeek-V3 con cuantización de 4 bits?
Según la guía de dev.to, el modelo cuantizado a 4 bits pesa unos 85GB y entra en una sola GPU de 40GB VRAM usando bitsandbytes con vLLM. Ese número no se sostiene si lo comparás con el consenso técnico de la comunidad que discutió el modelo desde su lanzamiento. Para más detalles técnicos, mirá si querés conocer todas las funciones de Claude.
En la discusión oficial de Hugging Face sobre DeepSeek-V3, el usuario surak calcula que el modelo completo necesita “cerca de 1TB de VRAM” sin cuantizar. El usuario bullerwins hace la cuenta con más detalle: a 4bpw (bits por peso), que es el mínimo aceptado para no perder calidad, el total ronda los 380GB de VRAM, y sumando algo de RAM de sistema el número sube a unos 400GB. Esa cifra está a años luz de los 85GB que menciona la guía viral.
¿De dónde sale la confusión? DeepSeek-V3 activa solo ~37.000 millones de parámetros por token gracias a su arquitectura MoE, aunque el modelo completo tenga 671.000 millones. Un usuario de la discusión de Hugging Face, DeFactOfficial, propuso justamente mantener solo el experto activo en VRAM (unos 37GB en Q8) y el resto en RAM de sistema. Otro usuario, NikolaSigmoid, probó esto con la opción --cpu-offload-gb 900 de vLLM. ¿Funcionó? No: “tried it but does not work!”, escribió textualmente.
Para tener una referencia de cuánto hardware exige el modelo completo sin recortes agresivos, el usuario krustik reportó correr una versión GGUF Q5-K-M con exactamente 502GB de RAM sobre hardware de servidor de diez años, con la GPU ayudando solo en el offload. Esa es la magnitud real del problema, no los 40GB de una L40.
¿Qué es vLLM y para qué sirve en un despliegue de este tipo?
vLLM es un motor de inferencia open source diseñado para servir modelos de lenguaje en producción con uso eficiente de memoria GPU. Implementa paged attention, una técnica que fragmenta la caché de atención (KV-cache) en bloques para evitar desperdicio de VRAM, y según describe la propia guía, reduce el uso de memoria hasta un 60% frente a un manejo manual.
Además de eso, vLLM agrupa (batchea) requests automáticamente para subir el throughput, y tiene soporte nativo para cuantización, incluyendo bitsandbytes de 4 bits. Sin vLLM tendrías que manejar la asignación de VRAM a mano, algo que en un modelo MoE de 671B parámetros es directamente inviable para alguien sin equipo de infraestructura dedicado.
La guía original, publicada el 20 de septiembre de 2026, usa vLLM 0.6.3 junto con Python 3.10, PyTorch compilado para CUDA 12.1 y transformers 4.45.2. Es una pila razonable para esa fecha, pero son versiones fijadas al momento puntual en que se escribió el tutorial: si estás leyendo esto más adelante, conviene chequear qué versiones están vigentes y su compatibilidad antes de replicarlo tal cual, en lugar de asumir que siguen siendo las últimas disponibles. Esto se conecta con lo que analizamos en a la hora de comparar Sonnet y Opus.
¿Cuánto cuesta realmente una GPU droplet de DigitalOcean para IA?
Depende de la GPU y de cuántas horas por día la tengas prendida. La guía cita tres opciones concretas de DigitalOcean con precio por hora, y la diferencia entre uso continuo y uso parcial cambia todo el cálculo mensual.
| GPU | VRAM | Precio por hora | Costo mensual (24/7) |
|---|---|---|---|
| NVIDIA A40 | 48GB | $0.48 | ~$345.60 |
| NVIDIA L40 | 40GB | $0.60 | ~$432 |
| NVIDIA H100 | 80GB | $2.00 | ~$1.440 |
Para la L40, la misma guía calcula que 8 horas diarias de uso bajan el gasto a $144 mensuales, y que 1 hora diaria lo deja en $18. Ahí sí empieza a acercarse a un número chico, aunque a esa escala de uso probablemente no te sirva para producción real con usuarios concurrentes.
El punto es que el precio “de $6” del titular no aparece en ningún escenario que la propia guía detalle con números. Es marketing de afiliado (el artículo incluye un link de referido a DigitalOcean con $200 de crédito), y como pasa seguido con este tipo de contenido, el titular vende más que la letra chica.
¿Cómo se compara el rendimiento de DeepSeek-V3 contra Claude Opus?
Según los números que cita el propio autor de la guía, DeepSeek-V3 saca 39.2% en AIME (American Invitational Mathematics Examination) contra 40% de Claude Opus, y 59.1% en GPQA (Graduate-Level Google-Proof Questions) contra 64% de Opus. La diferencia es chica en AIME y algo más marcada en GPQA.
Sobre precio, la guía cita que Claude Opus cobra $15 por millón de tokens de entrada y $60 por millón de tokens de salida, lo que arma un costo de $0.60 a $2.00 por request de razonamiento. Con eso como referencia, tiene sentido evaluar alternativas si tu volumen de requests es alto. Tema relacionado: instalar esta skill en dos comandos.
Eso sí: estos benchmarks vienen del propio autor de la guía, no de una evaluación independiente ni de un paper con metodología publicada. Tomalo con pinzas. Que un modelo esté “cerca” en dos benchmarks puntuales no dice mucho sobre cómo se comporta en tu caso de uso específico, sobre todo si tu producto depende de razonamiento consistente y no de un promedio en un test estandarizado.
¿Cómo se despliega DeepSeek-V3 en un servidor propio con vLLM?
El proceso que describe la guía tiene seis pasos: provisionar la droplet GPU, instalar drivers NVIDIA y CUDA 12.1, armar un entorno Python 3.10 con vLLM, descargar el modelo desde Hugging Face, configurar vLLM con un archivo YAML y levantar el servicio con systemd para que quede corriendo de forma persistente.
- Drivers y CUDA: se instala nvidia-driver-550 y CUDA toolkit 12.1, verificando con
nvidia-smiynvcc --version. - Entorno Python: un virtualenv con Python 3.10, vLLM 0.6.3, PyTorch para CUDA 12.1, transformers 4.45.2 y bitsandbytes 0.43.1.
- Descarga del modelo: vía huggingface-cli o git-lfs, con un tamaño total sin cuantizar de 1.3TB, que la guía calcula en 20-30 minutos sobre conexión de 1Gbps.
- Configuración de vLLM: un YAML con
quantization: bitsandbytes,gpu-memory-utilization: 0.9ymax-model-len: 4096, más un servicio systemd para reinicio automático.
Subís el modelo, seguís los pasos al pie de la letra, esperás media hora de descarga, configurás el YAML, levantás el servicio systemd y ahí es cuando aparece el problema real: si tu GPU tiene 40GB de VRAM y el modelo cuantizado necesita varias veces eso según la evidencia técnica independiente, el servicio no va a arrancar o va a fallar por falta de memoria mucho antes de que llegues a hacer tu primer curl de prueba.
¿Para qué casos conviene evaluar DeepSeek-V3 local en vez de la API de Claude?
Tiene sentido si tu volumen de requests es alto y sostenido, y si tu caso de uso tolera el 3-5% de diferencia en benchmarks de razonamiento que reporta la propia guía frente a Claude Opus. Para picos ocasionales o volumen bajo, seguir con la API sigue siendo más simple y probablemente más barato.
El tema es que “desplegar DeepSeek-V3” en serio, con el modelo completo funcionando a una latencia productiva, no es un proyecto de fin de semana con una droplet de $6. Requiere GPU real (múltiples GPUs de alta capacidad, según la evidencia de la comunidad de Hugging Face), presupuesto acorde y alguien en el equipo con experiencia en infraestructura de inferencia. Si tu equipo no tiene esa capacidad hoy, correr benchmarks propios antes de migrar cualquier carga de producción es el paso obligado, no opcional. Ya lo cubrimos antes en integrar Claude en tus flujos de Make.com.
Qué significa para equipos en Latinoamérica
Si tu equipo está evaluando esto desde Argentina o la región, el cálculo cambia por el tipo de cambio: gastar $432 mensuales en una droplet GPU no es lo mismo en pesos que en dólares de una empresa con ingresos en moneda dura. Para la capa de aplicación (el backend que orquesta las llamadas al modelo, sea local o vía API), tiene sentido mantenerla en un proveedor de VPS local con soporte en español, como donweb.com, y dejar el cómputo GPU pesado en un proveedor cloud especializado solo si el volumen lo justifica.
Qué está confirmado y qué no
- Confirmado: DeepSeek-V3 es un modelo MoE de 671B parámetros totales, con activación parcial por token, y es open source en Hugging Face.
- Confirmado: vLLM soporta paged attention y cuantización bitsandbytes de forma nativa, según su propia documentación de arquitectura citada en la guía.
- No confirmado: que el modelo cuantizado a 4 bits pese solo ~85GB y entre en una GPU de 40GB VRAM. La comunidad técnica en Hugging Face estima 380-400GB para el mismo escenario.
- No confirmado: los benchmarks de AIME y GPQA citados no tienen metodología publicada ni verificación independiente, son del propio autor de la guía.
- No confirmado: el costo de $6/mes o $72/año, que ni siquiera coincide con los otros números que da el mismo artículo.
Errores comunes al intentar desplegar DeepSeek-V3
- Creer que “4 bits” siempre significa lo mismo: la cuantización de 4 bits reduce tamaño, pero no borra la necesidad de VRAM proporcional al tamaño total del modelo. En un MoE de 671B, eso sigue siendo cientos de gigas, no decenas.
- Subestimar el costo real de la droplet: fijarte solo en el precio por hora sin multiplicar por las horas reales que vas a tener el servidor prendido. La diferencia entre 1 hora y 24 horas diarias es de 24x en el gasto mensual.
- Confiar en benchmarks sin metodología publicada: un número aislado como “39.2% en AIME” sin saber cómo se corrió el test, con qué prompt y cuántas corridas, no alcanza para tomar una decisión de infraestructura de producción.
- Asumir que el offload a CPU RAM resuelve el problema de VRAM: varios usuarios en la discusión de Hugging Face probaron la opción de offload de vLLM y reportaron que no funcionó como esperaban.
Preguntas Frecuentes
¿Es verdad que DeepSeek-V3 se puede correr por $6 al mes?
No en el escenario de producción continua que describe la propia guía viral, donde el gasto declarado sube a $432-456 mensuales por una droplet GPU L40. El número de $6 solo aparece si compartís la infraestructura entre varios modelos o apagás el servidor la mayor parte del tiempo.
¿Cuánta VRAM necesita DeepSeek-V3 cuantizado a 4 bits?
La guía original dice ~85GB, pero discusiones técnicas independientes en Hugging Face calculan entre 380GB y 400GB de VRAM para el modelo completo a 4 bits (4bpw). La diferencia se explica en parte porque el modelo activa solo ~37B parámetros por token, aunque mantener todos los expertos en memoria sigue exigiendo el total.
¿Qué GPU se necesita para desplegar DeepSeek-V3 con vLLM?
Según la evidencia técnica de la comunidad, hace falta bastante más que una sola GPU de 40GB. Configuraciones con múltiples GPUs de alta capacidad o combinaciones de VRAM y RAM de sistema en el orden de 400GB son lo que reporta la discusión de Hugging Face sobre el modelo.
¿DeepSeek-V3 rinde igual que Claude Opus en razonamiento?
Según los benchmarks que cita el propio autor de la guía, DeepSeek-V3 saca 39.2% en AIME contra 40% de Opus, y 59.1% en GPQA contra 64%. Son números cercanos pero no idénticos, y no vienen de una evaluación independiente publicada.
¿Cuánto cuesta realmente una droplet GPU de DigitalOcean para IA?
Varía según la GPU: una A40 de 48GB cuesta $0.48 por hora, una L40 de 40GB cuesta $0.60, y una H100 de 80GB cuesta $2.00 por hora. En uso continuo (24/7), esto se traduce en $345 a $1.440 mensuales según la GPU elegida.
Conclusión
La idea de fondo (usar DeepSeek-V3 con vLLM para bajar costos de inferencia) no es descabellada, y el modelo tiene méritos reales según los propios benchmarks que cita la guía. El problema es la aritmética del titular: $6 al mes no aparece en ningún escenario de producción que el mismo artículo detalla, y los requisitos de VRAM que menciona (85GB, GPU de 40GB) no coinciden con lo que calcula la comunidad técnica que lleva meses discutiendo este modelo en Hugging Face. Si estás evaluando desplegar DeepSeek-V3 para tu equipo, el criterio práctico es simple: pedile a quien te vendió el número mágico que te muestre el nvidia-smi corriendo con el modelo cargado, no un cálculo de servilleta. Y corré tus propios benchmarks con tu propia carga antes de mover un solo request de producción.