
En pocas palabras: Peter Vijeh usó Gemini 3.1 Pro para etiquetar 4.290 comentarios de Reddit por US$9 y entrenó con esas etiquetas un modelo GLiNER local que llegó a 0,83 F1, reemplazando así las llamadas pagas a la API de Gemini por un modelo propio sin costo por uso.
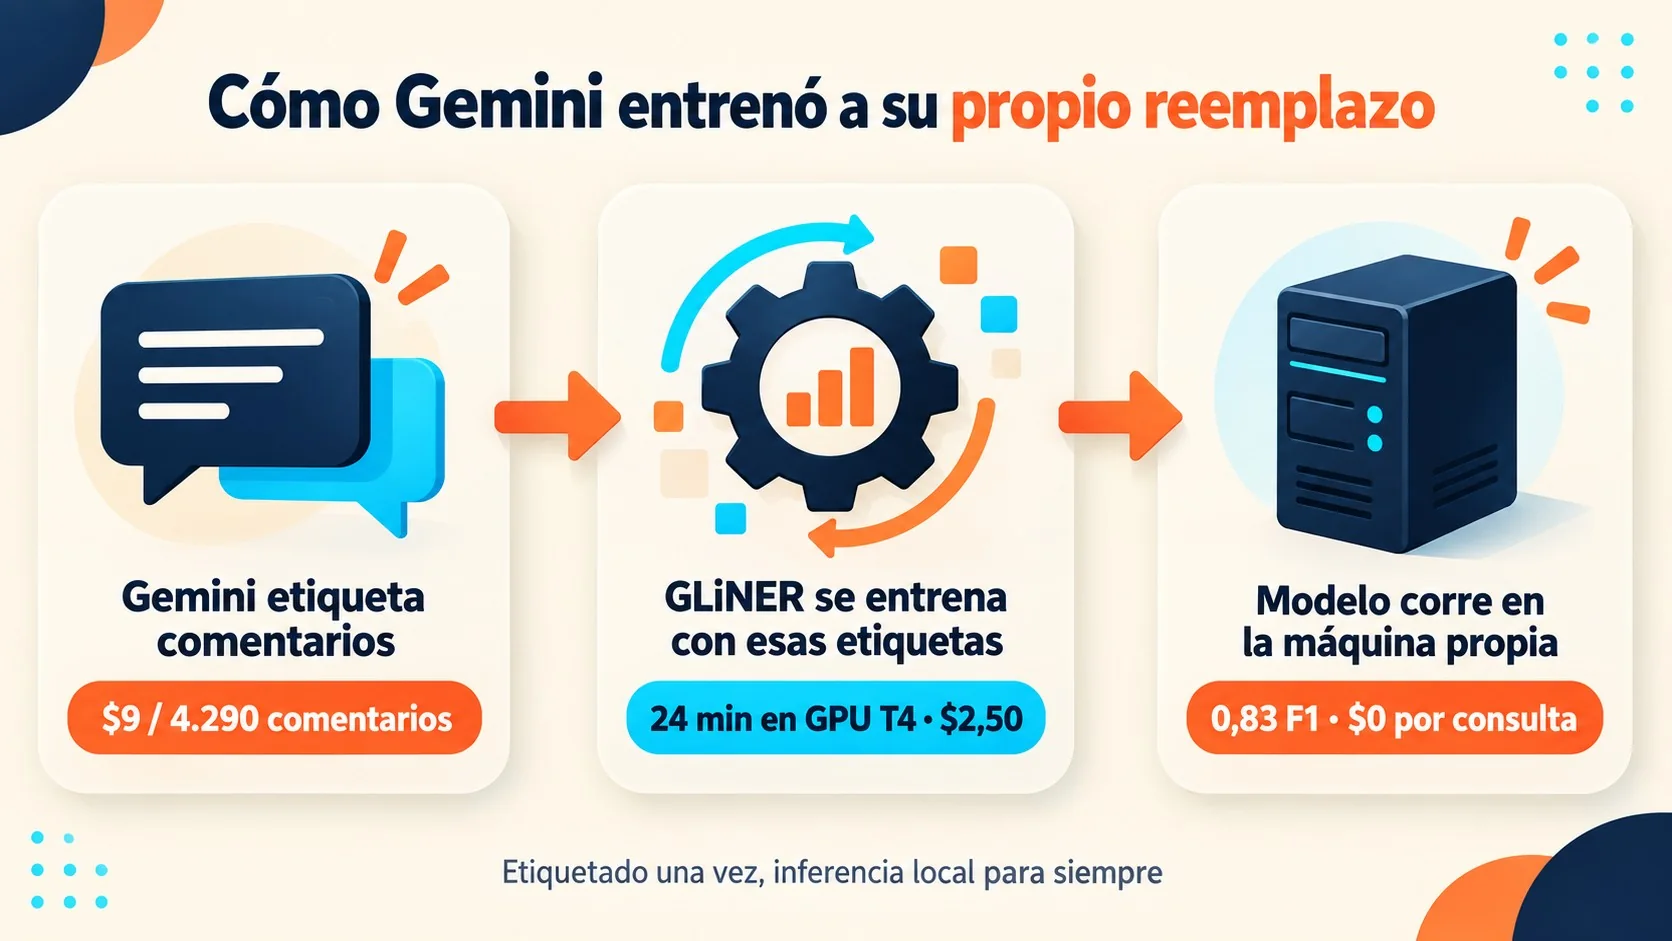
Peter Vijeh, desarrollador y autor del blog personal petervijeh.com, entrenó un modelo GLiNER local con etiquetas generadas por Gemini 3.1 Pro y llegó a 0,83 F1 por apenas US$9 en etiquetas más US$2,50 de GPU, dejando de pagar por cada llamada a la API de Gemini para detectar marcas, modelos y aceros en comentarios de Reddit sobre cuchillos de chef.
La destilación de Gemini es una técnica de destilación de conocimiento en la que un modelo grande (el “profesor”, en este caso Gemini 3.1 Pro) genera etiquetas o respuestas que sirven para entrenar un modelo chico (el “estudiante”, acá GLiNER) que después corre en local sin costo por llamada. Google también la ofrece como servicio oficial dentro de su plataforma Gemini Enterprise Agent, con gemini-3.1-pro como profesor y gemini-2.5-flash como estudiante.
En este artículo:
- En resumen
- ¿Qué es GLiNER y por qué es más barato que llamar a la API de Gemini?
- ¿Cómo usó Gemini para generar las etiquetas de entrenamiento?
- ¿Qué errores aparecieron al entrenar GLiNER con Hugging Face Trainer y Modal?
- ¿Qué resultado de precisión logró el modelo entrenado localmente?
- ¿Cuánto sale en total reemplazar una API de pago por un modelo propio?
- ¿Cómo funciona el servicio oficial de destilación de Gemini que ofrece Google Cloud?
- ¿Qué significa esto para empresas y equipos en Latinoamérica?
- Errores comunes al intentar este tipo de destilación casera
- Preguntas Frecuentes
- Conclusión
- Fuentes
En resumen
- Vijeh etiquetó 4.290 comentarios de Reddit con Gemini 3.1 Pro vía OpenRouter, a temperatura 0, por US$9 total (US$0,0021 por comentario) en 25 minutos.
- Entrenó GLiNER large v2.5 (459M de parámetros) en una Tesla T4 de Modal durante 24 minutos, con un gasto adicional de US$2,50 de GPU.
- El modelo entrenado llegó a 0,83 F1 contra las etiquetas de Gemini, muy por encima del 0,65 F1 que daba GLiNER en modo zero-shot sin entrenar.
- Cinco de diez corridas de entrenamiento fallaron; la más cara fue un tensor mal construido, words_mask, que dejó el loss plano sin ningún error visible en consola.
- El punto de equilibrio de costo se cruza en el comentario número 4.291, siempre que la GPU ya esté disponible y los comentarios nuevos tengan una longitud parecida.
¿Qué es GLiNER y por qué es más barato que llamar a la API de Gemini?
GLiNER es un modelo open source de reconocimiento de entidades (NER) con arquitectura encoder tipo DeBERTa-v3-large, capaz de detectar cualquier tipo de entidad sin entrenamiento específico para esa clase. A diferencia de pedirle a un modelo grande como Gemini que procese cada comentario por separado, GLiNER corre en una GPU propia o incluso en CPU, sin costo por llamada (que no es poco si tu app procesa miles de textos por día).
El problema es que “sin entrenar” tiene un precio en precisión. Vijeh probó GLiNER zero-shot sobre los mismos comentarios que ya había etiquetado Gemini 3.1 Pro, y el resultado fue 0,65 F1 según su propio reporte en petervijeh.com. Es una brecha grande para producción.
La caída no sorprende del todo. El paper original de GLiNER multi-tarea, publicado en arXiv, reporta un F1 promedio de 0,5754 en el benchmark zero-shot CrossNER para la versión gliner_large-v2.1, la anterior a la v2.5 que terminó usando Vijeh. Los cuchillos de chef son justo el tipo de dominio donde un modelo genérico se pierde: nombres como “Mazaki”, “Fibrox” o “white #2” se mezclan con jerga técnica de acero y mango que no aparece en ningún corpus de entrenamiento genérico.
¿Cómo usó Gemini para generar las etiquetas de entrenamiento?
Vijeh usó Gemini 3.1 Pro como “profesor” para etiquetar 4.290 comentarios de Reddit una sola vez, a temperatura 0 y vía OpenRouter, en 25 minutos y por US$9 total, es decir US$0,0021 por comentario. Esas etiquetas (marca, modelo y acero de cada cuchillo mencionado) fueron el único dataset de entrenamiento para GLiNER.
La decisión de prompt que más impactó en la calidad final fue pedirle a Gemini el texto exacto de la entidad en vez de las posiciones de caracteres. Los modelos grandes cuentan caracteres de forma poco confiable y devuelven spans corridos por dos o tres posiciones (ojo con esto si estás armando tu propio pipeline de NER). Vijeh resolvió el problema en código: TypeScript buscaba la subcadena exacta dentro del comentario y calculaba los offsets ahí, no en el modelo. Si el string no aparecía tal cual, la entidad se descartaba y quedaba registrada. En toda la información sobre cómo funciona Gemini profundizamos sobre esto.
Para evitar falsos positivos, cerca del 30% del set de entrenamiento son comentarios con una palabra gatillo típica (gyuto, carbon, handle, patina) pero ningún producto real, etiquetados como vacíos. Antes de la segunda corrida de entrenamiento, Vijeh apartó 225 comentarios como set de validación y no los volvió a tocar en ningún ajuste posterior.
¿Qué errores aparecieron al entrenar GLiNER con Hugging Face Trainer y Modal?
De diez corridas de entrenamiento, cinco no produjeron un modelo usable: tres fallaron por errores de configuración y dos por un bug silencioso en un tensor. Cualquiera que haya entrenado un modelo con Hugging Face Trainer sabe que la letra chica de los parámetros por defecto puede arruinarte una tarde entera.
| Corrida | Qué falló | Solución |
|---|---|---|
| Run 1 | max_steps=10000 por defecto pisó num_train_epochs=3; entrenó 39 épocas | Fijar max_steps de forma explícita |
| Run 2 | load_best_model_at_end sin eval_strategy tira error | Setear eval_strategy=”steps” |
| Run 3 | El Trainer guardó los pesos sin el prefijo “model.” que espera el loader de GLiNER | Agregar el prefijo al guardar |
| Run 4 | Los ejemplos negativos no tenían ner_labels asignado | Setear la lista de labels en todos los ejemplos |
| Runs 4 y 5 | words_mask lleno de unos en vez de índices de palabra; loss plano entre 70 y 130 | Emitir índices incrementales por palabra |
Los primeros tres errores son de manual: configuración mal leída, un parámetro por defecto que pisa otro, un prefijo que falta al guardar pesos. El problema serio empezó en las corridas 4 y 5.
Ahí entra el tensor words_mask. GLiNER lo usa junto a attention_mask, tiene la misma forma, y cualquiera que haya construido una máscara de atención antes lo llena con unos para tokens reales y ceros para padding (el error más lógico del mundo, dicho sea de paso). Vijeh lo hizo así. El entrenamiento corrió hasta el final. No hubo crash. No hubo warning. No hubo NaN. El loss arrancó en 130, bajó a 70 y ahí se quedó, con checkpoints guardados en horario y un F1 de evaluación cercano a cero.
¿Y qué pasó cuando finalmente revisó el código fuente de GLiNER en vez de la documentación? Encontró que words_mask no es una máscara binaria, es un índice de palabra: 0 para tokens especiales y de padding, después 1, 2, 3 para el primer sub-token de cada palabra real. Llenarlo con unos le decía al modelo que todo el comentario era una sola palabra gigante. Con el índice corregido, la corrida número 6 aprendió en el primer intento. Esto se conecta con lo que analizamos en activar Gemini directamente en Chrome.
¿Qué resultado de precisión logró el modelo entrenado localmente?
El modelo final de GLiNER large v2.5 (459M de parámetros) llegó a 0,83 F1 contra las etiquetas de Gemini, medido sobre el set de 225 comentarios que Vijeh nunca tocó durante el ajuste. La versión medium (209M) se quedó en 0,800, una diferencia chica que probablemente no justifique el peso extra en la mayoría de los casos.
Un solo cambio metodológico movió más la aguja que cualquier ajuste de hiperparámetros: reemplazar un umbral de confianza global por un umbral por clase. La recall de materiales pasó de 0,787 a 0,911, porque nombres de acero como MagnaCut, S35VN y HAP40 puntúan con confianza más baja que marcas conocidas, y un único corte los dejaba afuera todo el tiempo.
Hay una limitación que conviene tener clara antes de replicar esto en cualquier otro dominio. Subís el modelo, lo corrés en local, funciona bien contra el set de validación, lo mandás a producción, y ahí te das cuenta de que la única vara con la que mediste todo el proyecto es la que generó el mismo sistema que estás tratando de reemplazar, así que el número final dice menos de lo que parece a primera vista. Donde Gemini se equivocó, el modelo entrenado queda “bien” calificado por copiar el error, y “mal” calificado si por casualidad lo corrige.
¿Cuánto sale en total reemplazar una API de pago por un modelo propio?
El costo directo del proyecto fue de US$9 en etiquetas de Gemini más US$2,50 de GPU en una Tesla T4 de Modal, un total de US$11,50 repartido en diez corridas de entrenamiento (los días de debugging no entran en esta cuenta, aunque fueron el costo real).
El punto de equilibrio se cruza en el comentario número 4.291: a partir de ahí, cada comentario nuevo procesado con el modelo local sale gratis, en vez de sumar otros US$0,0021 a la factura de Gemini. La cuenta funciona si los comentarios futuros tienen una longitud parecida a los del set de entrenamiento y si la GPU ya está disponible, sin costo marginal de infraestructura nueva. Lo explicamos a fondo en integrar la API de Gemini con Node.js.
Vijeh resume la lección con una frase que vale para cualquier equipo que haga fine-tuning chico: “Si tuviera que elegir entre un mejor set de etiquetas y una aserción sobre cada tensor que construyo a mano, me quedo con la aserción”. El modelo y los datos rara vez son el problema. El código que los conecta es el que falla.
¿Cómo funciona el servicio oficial de destilación de Gemini que ofrece Google Cloud?
El servicio de destilación de Gemini de Google Cloud, en acceso anticipado dentro de Gemini Enterprise Agent Platform, entrena un modelo estudiante gemini-2.5-flash usando como profesor gemini-3.1-pro, sin que el equipo tenga que preparar respuestas de verdad fundamental: alcanza con un dataset de solo instrucciones en formato JSONL, según la documentación oficial de Google Cloud.
La diferencia con lo que hizo Vijeh es de fondo. El servicio de Google aprovecha la respuesta final del profesor y también sus “pensamientos sin procesar” (las rutas de razonamiento internas), algo que un proyecto casero con GLiNER no puede replicar porque GLiNER no es un modelo generativo con cadena de razonamiento. Google recomienda un mínimo de 1.000 ejemplos de entrenamiento y reserva el servicio para tareas de razonamiento complejo, como resumen técnico o programación, donde la brecha entre el modelo grande y el chico es sustancial. Para una tarea acotada como extraer marcas y aceros de un comentario de Reddit, el enfoque casero de Vijeh sale más barato y más rápido de iterar.
¿Qué significa esto para empresas y equipos en Latinoamérica?
Si tu producto procesa texto con entidades concretas (tickets de soporte, currículums, contratos, menciones de marca), el patrón “LLM como profesor más encoder chico entrenado” es hoy una de las formas más baratas de bajar el costo por transacción sin perder demasiada precisión. La cuenta de Vijeh es clara: etiquetar entre 2.000 y 5.000 ejemplos con un LLM a US$0,002 por ejemplo cuesta menos de US$10, un piso de inversión que cualquier equipo chico puede justificar en un sprint.
Fastino Labs, el laboratorio detrás de GLiNER, lanzó en abril de 2026 la plataforma Pioneer, descrita en un comunicado de Yahoo Finance citado por El Ecosistema Startup como “el primer agente de fine-tuning para modelos open source”. La apuesta de fondo es la misma que probó Vijeh a pulso: modelos chicos y especializados pueden igualar a modelos de frontera en tareas puntuales, a una fracción del costo y la latencia.
Si vas a servir ese modelo en producción (Vijeh lo hizo con FastAPI), vas a necesitar un servidor donde correrlo de forma estable. Para equipos en Argentina que arrancan este tipo de proyecto sin querer meterse en la configuración de infraestructura desde cero, un hosting cloud como el de donweb.com resuelve esa parte sin fricción.
Errores comunes al intentar este tipo de destilación casera
- Pedirle offsets de caracteres al LLM en vez de substrings. Los modelos grandes cuentan mal los caracteres y devuelven spans corridos; calculá los offsets en tu propio código buscando la subcadena exacta.
- Confiar en los valores por defecto del Hugging Face Trainer. max_steps=10000 puede pisar silenciosamente tu num_train_epochs, y vas a entrenar 39 épocas sin darte cuenta, como le pasó a Vijeh en su primera corrida.
- Construir cualquier tensor “tipo máscara” copiando la lógica de attention_mask. No todos los tensores con la misma forma cumplen la misma función; words_mask en GLiNER es un índice de palabra, no una máscara binaria, y llenarlo mal no tira ningún error visible.
- Usar un umbral de confianza único para todas las clases de entidad. Categorías con nombres poco frecuentes, como aceros técnicos, suelen puntuar con menos confianza que las categorías comunes, y un corte global las descarta de más.
- Elegir el set de validación después de ver los resultados. Un split aleatorio mal fijado puede inflar el F1 varios puntos sin que el modelo haya mejorado en nada real.
Preguntas Frecuentes
¿Qué es la destilación de conocimiento en IA?
Es la técnica de usar un modelo grande y capaz (“profesor”) para generar etiquetas, respuestas o razonamientos que después sirven de dataset de entrenamiento para un modelo chico (“estudiante”). El estudiante aprende a imitar el comportamiento del profesor sin heredar su costo por inferencia ni su tamaño.
¿Cómo se puede entrenar un modelo con las etiquetas que genera Gemini?
El proceso tiene tres pasos: pedirle a Gemini que etiquete un lote de datos una sola vez a temperatura 0, usar esas etiquetas como dataset de entrenamiento supervisado para un modelo chico como GLiNER, y correr ese modelo en local sin volver a llamar a la API. Vijeh siguió exactamente este camino con 4.290 comentarios y llegó a 0,83 F1. Sobre eso hablamos en Gemini superó a otros modelos en pruebas a ciegas.
¿Qué es GLiNER y para qué sirve?
GLiNER es un modelo open source de reconocimiento de entidades nombradas con arquitectura encoder tipo DeBERTa-v3-large, capaz de detectar cualquier categoría de entidad en texto sin entrenamiento previo para esa clase. Sirve para extraer nombres de marcas, personas, lugares o cualquier categoría específica de un dominio, con mucha menos latencia y costo que un LLM generativo.
¿Cuánto cuesta reemplazar la API de Gemini por un modelo propio?
En el caso documentado por Vijeh, el costo total fue de US$9 en etiquetas de Gemini 3.1 Pro más US$2,50 de GPU en una Tesla T4 de Modal, unos US$11,50 en total repartidos en diez corridas de entrenamiento. Ese número no incluye el tiempo de debugging, que fue de varios días por un bug en un solo tensor.
¿Por qué falla el entrenamiento de un modelo aunque el loss no muestre errores?
Porque un tensor de entrada mal construido puede hacer que el modelo entrene sin señales de alarma (loss bajando, checkpoints guardándose, sin crashes ni NaN) mientras aprende una tarea distinta a la que vos querés. En el caso de GLiNER, llenar words_mask con unos en vez de índices de palabra le dijo al modelo que todo el texto era una sola palabra, y la pérdida se estancó sin ninguna alarma visible.
Conclusión
Lo que hizo Vijeh no es un tutorial de destilación perfecto ni un caso que se replique sin fricción: cinco de diez corridas fallaron y el bug más caro fue casi invisible durante días. El resultado final, 0,83 F1 por US$11,50 y 24 minutos de GPU, muestra que la destilación de Gemini hacia modelos chicos y especializados es una alternativa real para cualquier equipo que hoy paga por llamada a un LLM en una tarea acotada y de alto volumen.
Si tu caso de uso se parece al de Vijeh (una categoría de entidades bien definida, mucho volumen, presupuesto ajustado), el camino a seguir es simple en el papel: etiquetá una vez con el modelo grande, entrená un modelo chico, medí contra un set de validación que no toques nunca más. Lo que no es simple es el código del medio, y ahí conviene invertir tiempo en aserciones sobre cada tensor que armes a mano, antes que en etiquetas más prolijas.