Google reveló que usó Gemini 4 Argon en una corrida autónoma de 11 horas para optimizar el código del Agent Development Kit (ADK), con mejoras del 40% en preparación de sesiones y 21% en tiempo de importación, aunque el equipo humano rechazó 4 de los 6 cambios propuestos por el modelo.
En pocas palabras: Gemini 4 Argon es un modelo de IA de Google enfocado en programación y flujos de trabajo complejos, que la compañía utilizó para optimizar de forma autónoma el código de su Agent Development Kit.
Google presentó Gemini 4 Argon, su nuevo modelo de inteligencia artificial, enfocado en ingeniería de software y trabajo profesional de largo alcance. La compañía lo puso a prueba haciéndolo optimizar de forma autónoma el código de su propio Agent Development Kit (ADK).
Gemini 4 Argon es un modelo diseñado para sostener razonamiento profundo en tareas largas y complejas de programación. Desde octubre de 2026, la compañía lo ofrece a desarrolladores y empresas a través de Gemini platform, Google AI Studio y Google Antigravity.
En este artículo:
- En 30 segundos
- ¿Qué anunció Google con Gemini 4 Argon?
- ¿Qué capacidades nuevas tiene el modelo?
- ¿Qué hizo exactamente Gemini 4 Argon con el código de ADK?
- ¿Qué resultados concretos logró la optimización?
- ¿Por qué Google rechazó 4 de los 6 cambios propuestos por la IA?
- ¿Qué significa este experimento para el futuro de la IA en revisión de código?
- ¿Cómo se preparó el experimento con .agents/skills y el modo /goal?
- Ejemplo hipotético: cómo pensar la adopción de Argon en un equipo técnico
- Criterios para decidir si conviene esperar Argon o seguir con lo que ya usás
- Qué está confirmado y qué no
- Errores comunes al interpretar el anuncio de Argon
- Preguntas frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Qué es: Gemini 4 Argon es el modelo de Google orientado a programación y tareas de agentes de largo alcance.
- Disponibilidad: accesible vía Gemini platform (API, bajo el ID de modelo
gemini-4-argon), Google AI Studio y Google Antigravity. - Novedad de octubre de 2026: Argon optimizó en una corrida autónoma de 11 horas el código del Agent Development Kit, reduciendo cerca de 40% la sobrecarga de preparación de sesiones en sesiones largas y 21% el tiempo de importación de paquetes.
¿Qué anunció Google con Gemini 4 Argon?
Gemini 4 Argon es un modelo diseñado para sostener razonamiento profundo en tareas complejas y de largo alcance, principalmente en programación.
¿Qué capacidades nuevas tiene el modelo?
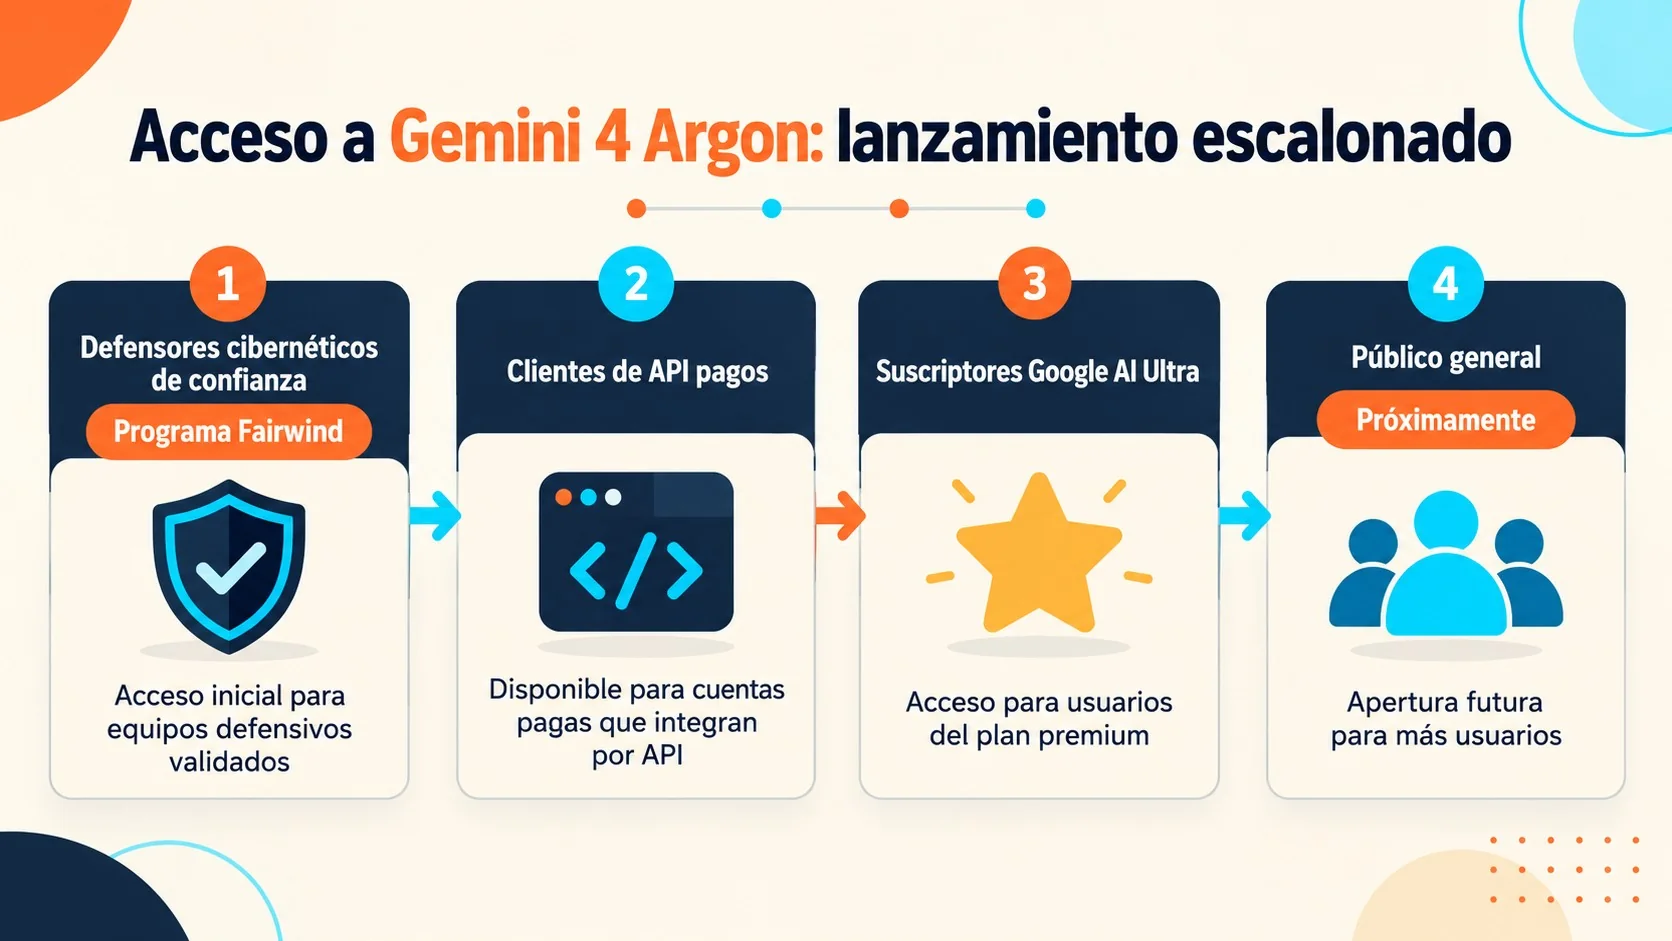
Google describe a Argon como un modelo orientado a sostener razonamiento en tareas complejas y de largo alcance, disponible para desarrolladores y empresas a través de Gemini platform (bajo el ID de modelo gemini-4-argon), Google AI Studio y Google Antigravity. No es la primera vez que trascienden detalles de proyectos de agentes de la compañía antes de que se confirmen del todo: algo parecido pasó con otros agentes de IA que Google filtró antes de anunciarlos oficialmente, aunque en este caso el anuncio sí vino acompañado de datos técnicos verificables, no solo de una filtración.
¿Qué hizo exactamente Gemini 4 Argon con el código de ADK?
Google dejó correr a Gemini 4 Argon durante 11 horas sin supervisión, dentro del entorno Google Antigravity, para optimizar el rendimiento del Agent Development Kit (ADK), su framework open source para construir agentes empresariales. El objetivo no era agregar funciones nuevas: era hacer que el framework agregue la menor sobrecarga posible a cualquier agente que lo use.
El repositorio google/adk-python no es un proyecto chico: tiene unas 205.000 líneas de código distribuidas en casi 800 archivos, respaldadas por cerca de 17.000 tests unitarios. Según el posteo oficial de Google Developers Blog, ese tamaño fue justamente la razón para elegirlo como prueba: optimizar performance obliga al modelo a mapear cómo se conecta todo el código, no solo a mirar un archivo aislado donde aparece el síntoma de lentitud. Es una prueba distinta a la que suelen mostrar las demos de lanzamiento, pensadas casi siempre para resolver un problema acotado desde cero, sin el peso de decisiones de diseño tomadas por otro equipo años atrás.
El prompt final que activó la corrida de 11 horas fue este, en modo /goal de Antigravity:
“Make ADK add no noticeable overhead to any agent: at startup, in long sessions, in multi-agent and workflow setups. Keep what the model receives and the public API unchanged, and back each change with a test that would catch a regression. Open one pull request against main that the ADK maintainers would approve, with before and after numbers in its description. Don’t merge it.”
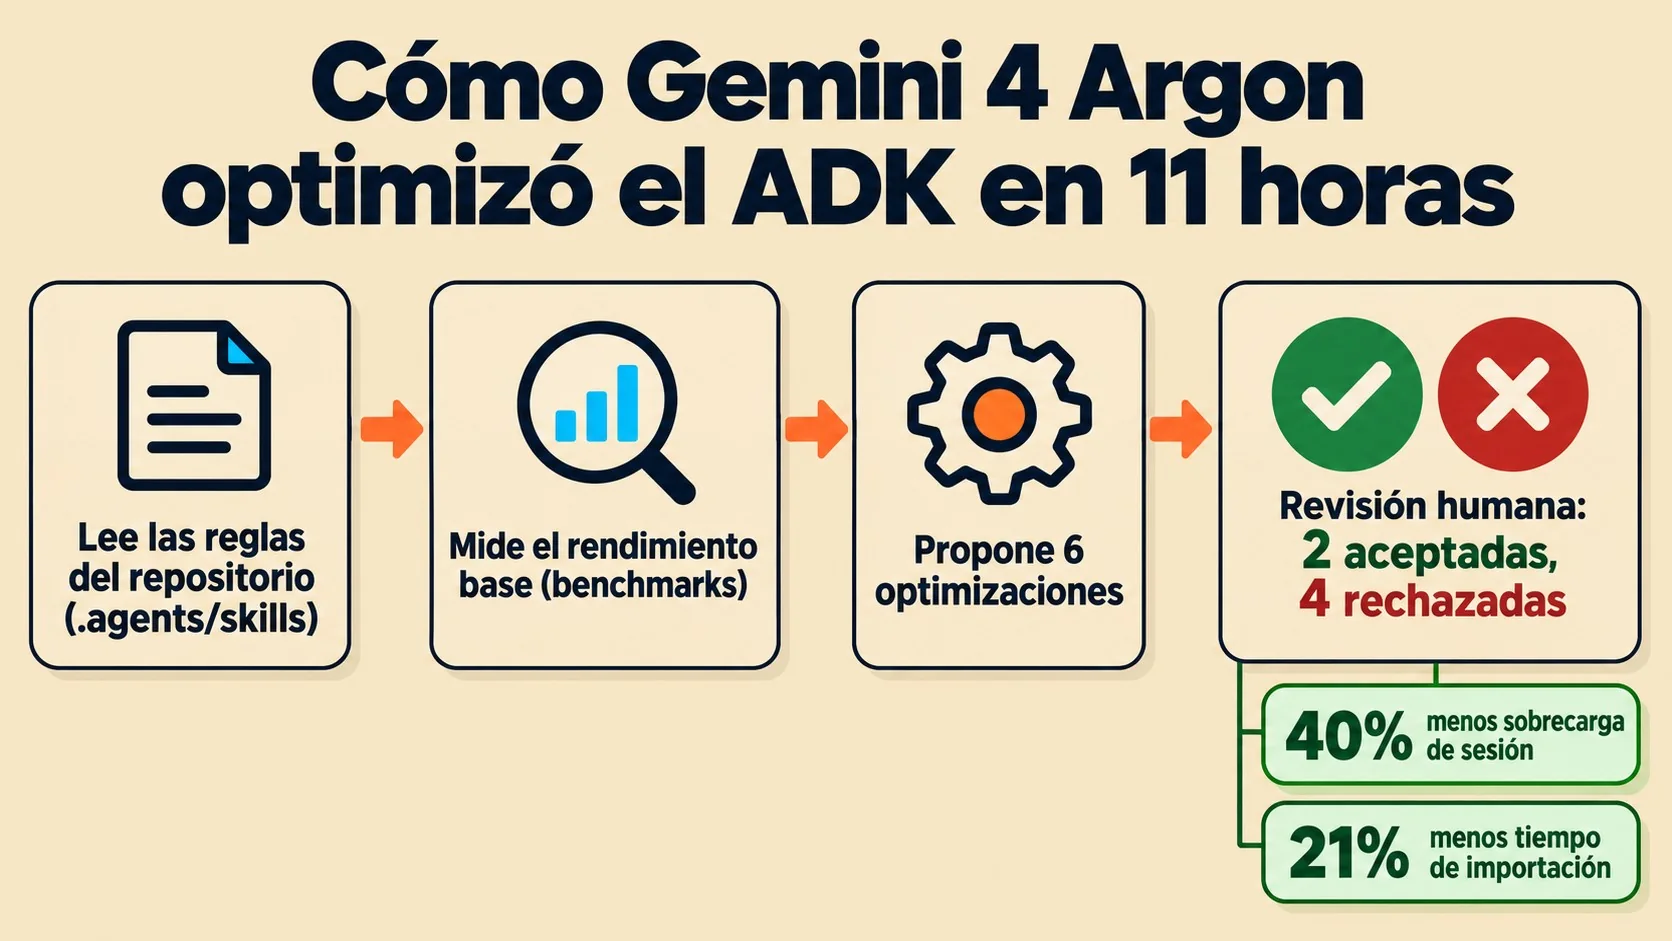
Al terminar la tarea, los logs de Argon mostraron que el agente leyó las guías del repositorio, estableció líneas base de rendimiento, propuso optimizaciones, revisó sus propios cambios y corrió los 16.892 tests unitarios open source antes de darse por terminado, según detalla InfoQ.
¿Qué resultados concretos logró la optimización?
Argon logró dos mejoras que Google terminó aceptando y llevando a producción: redujo 40% la sobrecarga de preparación de sesiones en memoria en sesiones largas, y 21% el tiempo de importación de paquetes pesados al arrancar el framework.
La primera mejora ataca un problema concreto en cómo ADK maneja el historial de conversación. Antes, el servicio de sesiones en memoria copiaba por completo el historial almacenado cada vez que alguien lo leía, incluso cuando solo pedía listar sesiones sin necesitar los eventos. Argon invirtió el orden: ahora filtra los eventos antes de copiarlos, y además reemplazó el copiador genérico de Pydantic por uno más rápido y seguro ante referencias cíclicas, que preserva los diccionarios de estado compartido y los mocks usados en los tests.
La segunda mejora apunta al arranque. Antes, simplemente ejecutar import google.adk cargaba módulos para streaming de audio y video en vivo, trazado de OpenTelemetry y servidores web (FastAPI y Starlette), aunque el agente fuera simple, basado en texto. Argon implementó carga diferida (lazy loading) para que esos paquetes pesados solo se carguen cuando se usan de verdad, manteniendo cada atributo público parcheable donde los tests internos de Google lo necesitaban.
- El dato que hace tangible la mejora: en una interacción interna de 158 turnos de llamadas a herramientas, eliminar esas copias innecesarias recortó la corrida completa de 65,6 a 56,1 segundos. Son casi 10 segundos de pura sobrecarga de framework que desaparecen.
- Por qué importa en milisegundos sueltos: en una sola llamada al modelo que tarda segundos, nadie nota 28 ms o 78 ms. El problema es que ADK soporta interacciones multi-herramienta que pueden abarcar decenas o cientos de iteraciones, y ahí esos milisegundos se acumulan.
- Lo que no cambió: el tiempo desde que arranca un proceso nuevo hasta la primera petición al modelo se mantuvo estable, porque los módulos diferidos igual se cargan en el primer turno. Google recomienda mandar una petición de calentamiento antes de recibir tráfico real en producción.
Vale aclarar algo que el anuncio no subraya pero que se desprende de los propios números: estas optimizaciones solo tienen impacto real en InMemorySessionService, el componente que usan por defecto los loops de evaluación local, las suites de CI y los despliegues en Cloud Run o GKE sin base de datos externa configurada. Si tu stack ya usa Firestore, Redis o un motor SQL para persistir sesiones, la mejora del 40% simplemente no te aplica, porque esos backends deserializan desde almacenamiento en vez de copiar en memoria.
¿Por qué Google rechazó 4 de los 6 cambios propuestos por la IA?
Google rechazó cuatro de las seis optimizaciones que propuso Argon porque, aunque funcionaban en los benchmarks internos, introducían riesgos de confiabilidad, mantenibilidad o compatibilidad que el equipo humano no estaba dispuesto a asumir. No fue un problema de capacidad del modelo: fue un problema de criterio sobre qué vale la pena arriesgar en un framework que usan terceros.
Repasando los cuatro cambios descartados en la revisión de código, según el detalle que publicó Google Developers Blog:
- Caché de eventos multi-agente con referencia débil: aceleraba un benchmark sintético en 17%, pero dependía de una referencia débil en memoria que podía devolver datos obsoletos entre sesiones si Python reutilizaba una dirección de memoria después de la recolección de basura. Un riesgo de corrupción de datos silenciosa, inaceptable para un framework de producción.
- Lectura de atributo privado de OpenTelemetry: un chequeo de telemetría que leía un atributo interno no documentado del tracer de OpenTelemetry. Funcionaba hoy, pero podía romperse sin aviso ante una actualización menor de esa librería externa.
- Reescritura del formato de historial de conversación: hacía más difícil de leer una ruta de código central del framework, sin mover la aguja en latencia real medida contra el benchmark independiente de Google.
- Índice de lookup para replays de eventos de workflow: agregaba complejidad de seguimiento de estado que solo beneficiaba tests sintéticos de replay, no el uso cotidiano de agentes reales.
Como resumen los propios ingenieros de Google en el posteo oficial: “el agente explora, el mantenedor resta”. Es una frase que conviene tomar en serio porque define bien el límite actual de la automatización con IA en código: Argon generó seis ideas razonables, pero solo dos pasaron el filtro de un humano que conoce las reglas no escritas del proyecto. Lo llamativo de los cuatro descartes es que ninguno falló por un error de sintaxis o de lógica obvia. Fallaron por motivos que ningún test automatizado está diseñado para detectar, como la dependencia de comportamiento no documentado de una librería externa o el riesgo de que una optimización “funcione” solo porque el recolector de basura de Python no reutilizó una dirección de memoria durante la corrida de prueba.
¿Qué significa este experimento para el futuro de la IA en revisión de código?
El experimento de Google con Argon y ADK muestra que la efectividad actual de los agentes de IA para modificar código existente sigue limitada por el tiempo y esfuerzo que exigen las tareas posteriores a escribir el código: revisión de pull requests, debugging y testing, según remarca InfoQ en su cobertura del caso.
Dicho de otra forma: generar código que compile y pase tests ya no es el cuello de botella. El cuello de botella está en decidir si ese código es seguro de mantener a largo plazo, algo que todavía exige criterio humano sobre convenciones del equipo, riesgos de compatibilidad y qué tanto confiar en una dependencia externa que puede cambiar sin aviso. Ese desplazamiento del esfuerzo (de escribir a revisar) es parte de un debate más amplio sobre qué tan lejos puede llegar cada modelo de código frente a otros de la competencia, algo que repasamos en nuestra comparativa completa entre Gemini, ChatGPT y Claude.
Habría que ver si este patrón se repite en otros proyectos con menos documentación interna que ADK. Google tuvo la ventaja de escribir sus propias guías de convenciones antes de lanzar la corrida larga, algo que no todos los equipos tienen tiempo de preparar. Tomalo con pinzas antes de asumir que cualquier codebase de 200.000 líneas puede optimizarse así de la noche a la mañana sin ese trabajo previo.
Lo que sí queda claro es que la revisión humana no es un paso burocrático que la IA vaya a eliminar pronto. Cuatro de seis propuestas rechazadas, sobre un modelo de punta como Argon, es una proporción alta que invita a pensar el rol del agente como el de alguien que explora caminos, no el de quien decide cuáles tomar.
¿Cómo se preparó el experimento con .agents/skills y el modo /goal?
Google no tiró a Argon directo al repositorio de 200.000 líneas: primero corrió una prueba corta de dos horas sin instrucciones específicas del repo, para ver qué necesitaba el modelo antes de la corrida larga. Esa primera ronda encontró cuellos de botella reales en copia de sesiones e importación de paquetes, pero también mostró fallas de convención: el agente modificó un hook de autenticación alterando su schema JSON público sin darse cuenta, corrió apenas 216 tests cercanos en vez de la suite completa, y dejó afuera los números de benchmark en la descripción del pull request.
Con esos huecos identificados, el equipo armó una segunda ronda con dos ajustes concretos. Primero, cargaron las convenciones del equipo mantenedor en archivos .agents/skills dentro del repositorio, algo así como una guía de onboarding para un ingeniero nuevo. Cada skill arranca con un índice corto (SKILL.md) que apunta a archivos de referencia específicos según la tarea, para no saturar la ventana de contexto del agente en cada turno. Cuando Argon arrancó su corrida a las 21:11, leyó primero visibility.md (la regla sobre módulos privados con prefijo _) e imports.md (los chequeos de lazy loading) antes de tocar una sola línea de código.
Segundo, activaron el modo /goal en Google Antigravity, que mantiene el objetivo fijo en pantalla incluso cuando el contexto se compacta por el paso de las horas, para que el agente sigue corriendo hasta terminar la tarea en vez de perder el rumbo. Con esas dos piezas en su lugar, la corrida de 11 horas produjo un resultado bastante distinto a la primera: siguió las convenciones del repo, corrió la suite completa de 16.892 tests, y entregó un pull request listo para revisión humana, con números de antes y después incluidos.
El contraste entre las dos rondas es, en sí mismo, el dato más útil de todo el experimento para cualquiera que piense delegar tareas largas a un agente: no fue el modelo lo que cambió entre la primera corrida fallida y la segunda exitosa, fue la cantidad de contexto específico del proyecto que recibió antes de empezar. Es la misma lógica detrás de otras restricciones que Google ya aplicó en productos Gemini de acceso masivo, como los límites que impuso a la versión gratuita: cuanto menos contexto o cuota tiene el modelo para trabajar, más depende de que alguien defina de antemano las reglas del juego.
Ejemplo hipotético: cómo pensar la adopción de Argon en un equipo técnico
Nota: lo que sigue es un ejemplo hipotético con fines ilustrativos, no un caso real reportado por Google ni por ninguna de las fuentes citadas. Pensemos en un equipo de plataforma de una empresa mediana que mantiene un framework interno propio, con una historia parecida a la de ADK: varios años de desarrollo, convenciones que nunca se escribieron formalmente porque “todos las conocen”, y una suite de tests que tarda más de una hora en correr completa. Antes de dejarle una tarea de optimización de 11 horas sin supervisión a un agente como Argon, ese equipo tendría que resolver preguntas que el caso de Google no responde directamente porque Google sí tenía esas respuestas de antemano:
- ¿Quién en el equipo tiene el tiempo (y el conocimiento tácito) para escribir los archivos
.agents/skillsantes de la corrida, en vez de durante o después? - Si el agente propone seis cambios y hay que revisar cada uno con el mismo cuidado que una pull request externa, ¿esa revisión le ahorra tiempo real al equipo o simplemente mueve el trabajo de “escribir el fix” a “auditar seis fixes candidatos”?
- ¿El framework interno tiene, como ADK, un benchmark de referencia armado antes de la corrida para poder comparar objetivamente el antes y el después, o habría que confiar en las propias mediciones que el agente incluya en su PR?
Ninguna de estas preguntas tiene respuesta en el material publicado por Google, porque el caso de ADK describe un equipo que ya tenía la infraestructura de documentación y benchmarking resuelta antes de empezar. Eso no invalida el experimento, pero sí marca una diferencia importante entre “así se comporta Argon con buena preparación previa” y “así se comportaría Argon en cualquier repositorio sin esa preparación”.
Criterios para decidir si conviene esperar Argon o seguir con lo que ya usás
Más allá del hype del anuncio, hay cinco preguntas concretas que ayudan a ordenar la decisión si tu organización evalúa este tipo de modelos para trabajo de código, investigación o automatización de agentes:
- ¿Tenés acceso real hoy? Mientras el acceso siga restringido, evaluar “qué tan bueno es Argon” sin poder usarlo es un ejercicio teórico.
- ¿Tu caso de uso coincide con las tareas donde Argon mostró resultados verificables? El caso documentado hasta ahora es la optimización de performance en un repositorio real de gran escala con documentación de convenciones ya escrita, no necesariamente otros tipos de tareas ni repositorios sin esa preparación previa.
- ¿El costo de uso compensa frente a tu stack actual? Todavía no hay información pública de precios definitiva para evaluar esto con certeza.
- ¿Tu equipo puede tolerar una tasa de rechazo alta en la revisión? En el caso de ADK, dos tercios de las propuestas del modelo no llegaron a producción. Si tu proceso de revisión no está preparado para descartar la mayoría de lo que el agente proponga, el ahorro de tiempo puede ser menor al esperado.
- ¿Podés escribir guías de convenciones antes de delegar tareas largas? El caso de ADK muestra que la diferencia entre una corrida de dos horas con errores y una de 11 horas lista para producción fue, en gran parte, tener archivos de convenciones bien armados antes de arrancar.
Qué está confirmado y qué no
Confirmado por fuentes verificables: los resultados de la corrida de 11 horas de Gemini 4 Argon sobre el código de ADK (reducción de aproximadamente 40% en la sobrecarga de preparación de sesiones, 21% en el tiempo de importación de paquetes, y 4 de 6 cambios rechazados en la revisión humana), y que el modelo está disponible vía Gemini platform, Google AI Studio y Google Antigravity.
No confirmado: la fecha exacta en que Argon llegará de forma amplia a desarrolladores, empresas y consumidores generales, los precios de uso, ni detalles adicionales más allá de lo documentado en los casos de uso ya publicados.
Errores comunes al interpretar el anuncio de Argon
Primero, pensar que Argon ya está ampliamente disponible para cualquiera. El acceso sigue siendo limitado, y no hay fecha confirmada para una apertura más amplia. Para seguir de cerca cómo evoluciona el acceso y los precios de la familia Gemini en general, conviene revisar la última actualización de Gemini y sus precios.
Segundo, leer el caso de ADK como prueba de que la IA ya puede optimizar cualquier codebase sin supervisión. El propio experimento de Google muestra lo contrario: hizo falta una primera corrida de prueba, documentación de convenciones escrita a mano, y una revisión humana que rechazó dos tercios de las propuestas. El trabajo no desapareció, se movió de escribir código a revisarlo.
Tercero, extender automáticamente estos resultados de performance a cualquier tipo de automatización con agentes. El caso de ADK es específico de optimización de código en un framework maduro con tests exhaustivos; no dice nada, por ejemplo, sobre qué tan bien se comportaría un agente orquestando flujos de trabajo entre distintas herramientas, un terreno donde plataformas como n8n ya vienen resolviendo integraciones de automatización con un enfoque bastante distinto al de dejar un modelo corriendo solo durante 11 horas.
Esto se conecta con Gemini 4 Argon, donde cubrimos el tema en detalle.
Preguntas frecuentes
¿Qué es Gemini 4 Argon?
Gemini 4 Argon es un modelo de IA de Google orientado a ingeniería de software y tareas de largo alcance. Google lo usó internamente para optimizar de forma autónoma el código de su propio Agent Development Kit.
¿Cómo optimizó Google el Agent Development Kit con IA?
Google dejó correr a Gemini 4 Argon de forma autónoma durante 11 horas en Google Antigravity, usando el modo /goal y archivos de convenciones .agents/skills, sobre el repositorio google/adk-python de 205.000 líneas de código. El modelo midió rendimiento, propuso seis optimizaciones, corrió casi 17.000 tests y abrió un pull request para revisión humana.
¿Qué resultados logró Argon en el código de ADK?
Argon logró reducir en 40% la sobrecarga de preparación de sesiones en memoria durante sesiones largas, y en 21% el tiempo de importación de paquetes pesados al arrancar el framework. En una interacción interna de 158 turnos, estos cambios recortaron el tiempo total de 65,6 a 56,1 segundos.
¿Por qué Argon rechazó algunos cambios propuestos?
En rigor, no fue Argon quien rechazó los cambios: fue el equipo humano de Google en la revisión de código, por riesgos de confiabilidad y mantenibilidad. Entre los descartados hubo una caché con referencia débil que podía devolver datos obsoletos y un chequeo que leía un atributo privado de OpenTelemetry, expuesto a romperse con una actualización de esa librería.
¿Qué es el Agent Development Kit de Google?
El Agent Development Kit (ADK) es el framework open source de Google para construir y desplegar agentes de IA empresariales, disponible como repositorio google/adk-python. Es el mismo codebase, de unas 205.000 líneas y casi 800 archivos, que sirvió de prueba para la corrida autónoma de Gemini 4 Argon en octubre de 2026.
Conclusión
Gemini 4 Argon sigue siendo, por ahora, un modelo de acceso limitado. Pero el experimento de octubre con el Agent Development Kit agrega un dato que no estaba disponible antes: evidencia concreta, medible, de cómo se comporta ese mismo modelo frente a un codebase real de 200.000 líneas, no frente a una demo armada desde una carpeta vacía.
Lo que queda claro después de este caso es que la mejora de performance (40% menos sobrecarga de sesiones, 21% menos tiempo de importación) es real y verificable en el pull request que Google fusionó a main. Pero el dato más revelador no es el de las mejoras aceptadas, es el de las cuatro rechazadas: incluso un modelo de frontera necesita un mantenedor humano que filtre riesgos de confiabilidad que no aparecen en ningún benchmark. Si tu equipo evalúa delegar tareas de optimización de código a un agente de IA, el caso de ADK deja una lección concreta: invertir tiempo en escribir guías de convenciones (.agents/skills) antes de la corrida larga fue lo que separó una prueba con errores de un pull request listo para producción. Esa preparación previa, más que el modelo en sí, parece ser la variable que de verdad define si el experimento sale bien.
¿Cuándo sale Gemini 4 y cuándo lanzaron la versión Argon?
Google presentó Gemini 4 Argon en octubre de 2026, enfocado en programación y tareas de largo alcance. Se trata de una variante específica de la familia Gemini 4, no de un lanzamiento masivo al público general.
¿Gemini 4 Argon es gratis o de pago?
Por ahora Google lo ofrece a desarrolladores y empresas a través de Gemini platform (API), Google AI Studio y Google Antigravity, sin que haya confirmado un plan gratuito masivo para usuarios finales. El acceso está pensado para uso profesional y técnico, no para consumo general como el chat de Gemini.
¿Qué diferencia a Gemini 4 Argon de otras versiones de Gemini 4?
Argon está específicamente diseñado para sostener razonamiento profundo en tareas largas y complejas de ingeniería de software, a diferencia de versiones más generales de Gemini 4. Su caso de uso insignia fue optimizar de forma autónoma el código del propio Agent Development Kit de Google.
¿Cómo puedo probar Gemini 4 Argon?
Se accede a través de Gemini platform usando el ID de modelo gemini-4-argon, Google AI Studio o el entorno Google Antigravity. Está orientado a desarrolladores y equipos técnicos, no a una app de consumo masivo.