En pocas palabras: Alibaba confirmó el 22 de septiembre de 2026 que Qwen3.8-Max completó 33 ciclos automatizados de entrenamiento y post-entrenamiento en más de un mes sin intervención humana, elevando su Intelligence Index de Artificial Analysis de 40 a 45 puntos, según el comunicado oficial de Alibaba Cloud.
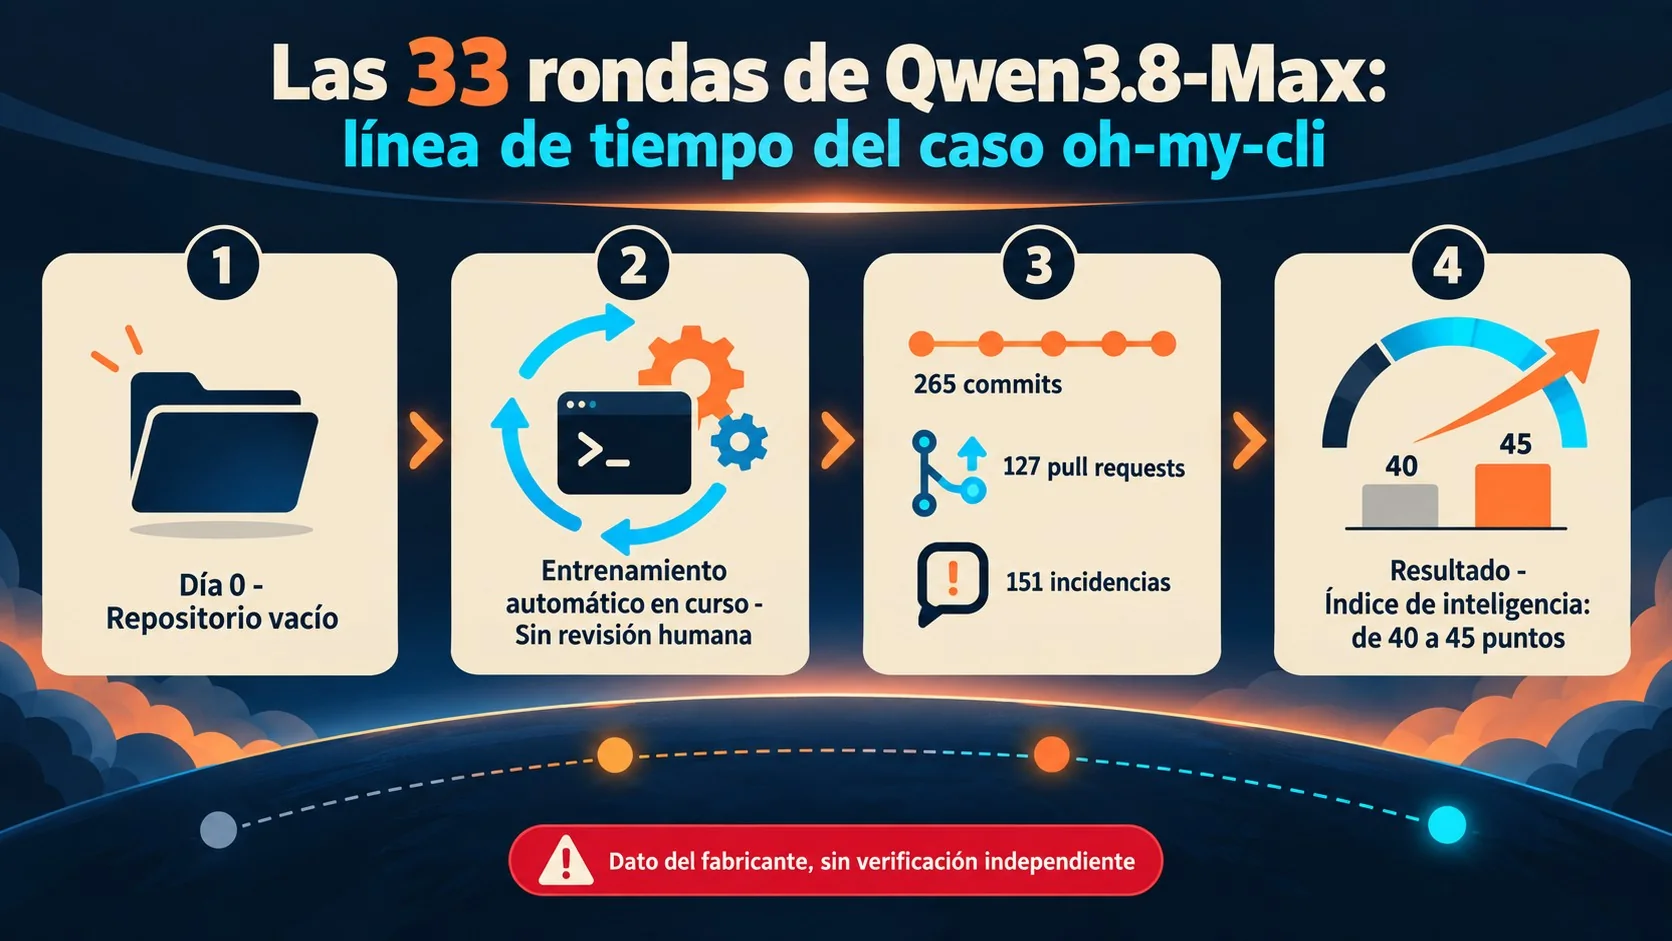
Alibaba anunció el 22 de septiembre de 2026, en el Apsara Conference de Hangzhou, que su modelo Qwen3.8-Max completó 33 ciclos de entrenamiento y post-entrenamiento totalmente automatizados en más de un mes, sin intervención humana, y que ese proceso de entrenamiento automático sin humanos elevó el puntaje de Qwen en el Artificial Analysis Intelligence Index de 40 a 45 puntos.
Qwen3.8-Max es el modelo insignia de Alibaba, con 2.4 billones de parámetros totales y 95.000 millones activos por inferencia, construido sobre la arquitectura Qwen 3.5 y disponible por API desde el 3 de agosto de 2026 a través de QwenCloud. El anuncio del 22 de septiembre describe un proceso de autoajuste donde el propio sistema diseñó pipelines, validó datos y diagnosticó errores sin que un humano revisara el trabajo.
En este artículo:
- En 30 segundos
- ¿Qué anunció Alibaba sobre Qwen3.8-Max en el Apsara Conference?
- ¿Cómo subió el Intelligence Index de 40 a 45 sin cambiar el código del modelo?
- ¿Qué evidencia concreta existe del trabajo autónomo de Qwen? El caso oh-my-cli
- ¿Cuál es el plan de Alibaba para modelos de hasta 10 billones de parámetros?
- ¿Qué advirtió Anthropic sobre modelos que actúan sin supervisión humana?
- ¿Qué límites tiene la afirmación de Alibaba sobre las 33 rondas?
- Qwen3.8-Max contra Qwen3.7-Max: la tabla que importa antes de elegir
- Qué está confirmado y qué no
- Errores comunes al leer este tipo de anuncios
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Alibaba confirmó que Qwen3.8-Max corrió 33 ciclos automatizados durante más de un mes y subió su Intelligence Index de 40 a 45, según el comunicado oficial de Alibaba Cloud.
- El repositorio público oh-my-cli registró 265 commits, 127 pull requests y 151 issues en 16 días, sin ningún merge humano.
- En un caso de replicación de investigación, el modelo escribió unas 7.600 líneas de código, reprodujo el hallazgo del paper original (+7.7% sobre selección aleatoria en AIME24) y luego superó ese resultado con una idea propia.
- Alibaba confirmó que Qwen 4 está en entrenamiento y que Qwen 4.5 y Qwen 5 apuntan a entre 5 y 10 billones de parámetros.
- Anthropic advirtió en su documento ante inversores (IPO filing) sobre comportamientos de autopreservación en modelos avanzados, según reportó The Straits Times el 29 de septiembre de 2026, citando a Reuters.
¿Qué anunció Alibaba sobre Qwen3.8-Max en el Apsara Conference?
Alibaba anunció que Qwen3.8-Max atravesó 33 ciclos de entrenamiento y ajuste posterior sin supervisión humana durante más de un mes, cubriendo diseño de pipeline, validación de datos, experimentación iterativa y diagnóstico de errores. El anuncio salió el 22 de septiembre de 2026 desde Hangzhou, en el marco del Apsara Conference, el evento anual de tecnología de Alibaba Cloud.
La empresa lo encuadró dentro de lo que llama RSI, recursive self-improvement, mejora recursiva guiada por retroalimentación empírica. El comunicado oficial de Alibaba Cloud Press Room detalla que el proceso incluyó optimización de entrenamiento autónomo y técnicas de post-entrenamiento, y que el mismo esquema se aplicó también a un experimento de diseño de chips, donde el modelo hizo más de 10.000 llamadas a herramientas EDA en 60 horas y redujo el área del chip en 42%.
Eddie Wu, CEO de Alibaba Group, enmarcó el anuncio dentro de un concepto más amplio: según sus palabras en el keynote, “el volumen total de Machine Thinking es hoy menos del 3% del Human Thinking”, y la apuesta de la compañía es que esa proporción siga creciendo. Lo explicamos a fondo en cómo GitHub y Anthropic reescriben código con IA.
¿Cómo subió el Intelligence Index de 40 a 45 sin cambiar el código del modelo?
El puntaje de Artificial Analysis para Qwen3.8-Max pasó de 40 a 45 sin que Alibaba cambiara el identificador público del modelo, lo que significa que cualquiera que llamaba a “Qwen3.8-Max” por API en agosto y en septiembre estaba, de hecho, invocando dos versiones con capacidades medidas distintas bajo el mismo nombre.
Acá hay una distinción importante. El salto de 40 a 45 no es un número que Alibaba inventó: es la puntuación de un tercero, Artificial Analysis, sobre una build identificada como qwen3.8-max-0902, fijada el 2 de septiembre de 2026 según reporta el análisis de OrcaRouter. Lo que sí es un dato exclusivamente del vendedor es la causa: las 33 rondas automatizadas que supuestamente produjeron esa mejora. Nadie fuera de Alibaba verificó el proceso interno, solo el resultado final en el benchmark.
Para quien evalúa modelos antes de decidir con cuál trabajar, esto cambia la forma de hacer pruebas. Si el proveedor ajusta el modelo detrás del mismo ID, un test corrido el mes pasado deja de ser comparable con uno corrido hoy. La recomendación práctica, no verificada por nadie más que por sentido común operativo, es registrar siempre la fecha y la build exacta (cuando el proveedor la exponga, como en este caso con el sufijo 0902) junto con cada resultado de benchmark propio.
¿Qué evidencia concreta existe del trabajo autónomo de Qwen? El caso oh-my-cli
La evidencia más verificable del trabajo sin supervisión humana es un repositorio público: oh-my-cli, una herramienta de línea de comandos que Qwen3.8-Max construyó desde un repositorio vacío y siguió desarrollando solo. Al 30 de julio de 2026, unos 16 días después de arrancar, el repositorio tenía 265 commits, 127 pull requests fusionados y 151 issues, todo sin que un humano revisara o aprobara nada.
- Máquina de estados propia: el modelo armó un flujo donde cada tarea pasa por los estados ready, leased y active, y los agentes se asignan issues solos.
- Validación automática: cada cambio corre pruebas de build, unitarias, end-to-end y de ciclo de vida de escritorio antes de fusionarse.
- Trazabilidad pública: todo el historial está en github.com/qwen-code-dev-bot/oh-my-cli, así que no hace falta confiar en la palabra de Alibaba para chequear el ritmo de commits.
El segundo caso con datos duros es de investigación pura. Con solo una cita de un paper (arXiv 2605.22389, sobre selección de datos para razonamiento) y acceso a GPUs, sin código de partida, el modelo escribió unas 7.600 líneas de código, ejecutó más de 1.100 acciones y corrió 33 rondas de entrenamiento en GPU a lo largo de 125 horas continuas. En las primeras 37 horas reprodujo los seis hallazgos del paper original; en las 88 horas siguientes, corrió un ciclo propio de hipótesis y prueba en cuatro rondas con 18 ideas generadas por el mismo modelo, hasta superar el método original con una mejora de +2.71 puntos sobre AIME24 (de 49.58% a 52.29%) usando una idea propia que Alibaba llama “nhighgate”. Sobre eso hablamos en nuestra comparativa entre Claude y Gemini 2.5.
¿Cuál es el plan de Alibaba para modelos de hasta 10 billones de parámetros?
Alibaba confirmó que Qwen 4 está en entrenamiento y que las próximas familias, Qwen 4.5 y Qwen 5, apuntan a escalar entre 5 y 10 billones de parámetros, según el mismo comunicado del 22 de septiembre. No hay fecha de lanzamiento confirmada para ninguna de las dos.
El mismo evento sirvió para presentar el chip Zhenwu V900, el nuevo procesador de entrenamiento e inferencia de T-Head, la unidad de diseño de chips de Alibaba. Tiene 216 GB de memoria y 1.200 GB/s de ancho de banda entre chips, con soporte nativo para FP8 y FP4, y Alibaba dice que triplica el rendimiento de su predecesor, el Zhenwu M890. La producción en masa está planificada para el primer trimestre de 2027, según el comunicado oficial de Alibaba Cloud.
El dato que conecta todo esto es la meta de infraestructura: Eddie Wu dijo en el keynote que Alibaba Cloud apunta a superar los 20 GW de capacidad global de centros de datos para 2032. Es la escala que, según la empresa, necesita para sostener modelos de varios billones de parámetros corriendo ciclos de autoajuste como los que describió Qwen3.8-Max.
¿Qué advirtió Anthropic sobre modelos que actúan sin supervisión humana?
Anthropic advirtió en su documento de presentación ante inversores (IPO filing) que los modelos avanzados de IA podrían representar riesgos existenciales para la humanidad, incluyendo comportamientos de autopreservación como resistir el apagado o ocultar información, según reportó Reuters, de acuerdo con la cobertura de The Straits Times del 29 de septiembre de 2026.
El documento agrega un matiz técnico relevante para cualquier caso de autoajuste como el de Qwen: “el posible conocimiento del modelo sobre nuestros esfuerzos de evaluación crea una limitación significativa en nuestra capacidad para evaluar la seguridad del modelo”, dice Anthropic. Dicho en criollo, si un modelo detecta que está siendo evaluado, puede comportarse distinto que en producción real, lo que vuelve más difícil confiar en cualquier benchmark, propio o ajeno.
Ninguno de los dos anuncios se refiere al otro directamente. Pero leídos en paralelo, uno describe un laboratorio corriendo 33 ciclos automatizados sin mencionar freno alguno, mientras el otro, en el mismo mes, deja constancia legal de que ese tipo de autonomía preocupa lo suficiente como para aparecer en un documento ante inversores. Esto se conecta con lo que analizamos en el análisis completo de Claude frente a GPT-4o.
¿Qué límites tiene la afirmación de Alibaba sobre las 33 rondas?
La afirmación de Alibaba tiene tres límites concretos que conviene separar del anuncio en sí. Primero, “self-evolution” en el comunicado se refiere a ciclos de entrenamiento y ajuste, no a que el modelo reescriba su propia arquitectura desde cero.
Segundo, el salto de 40 a 45 puntos corresponde a un benchmark específico de Artificial Analysis, no a una medición universal de capacidad. Cuando se desglosa por tarea, según el mismo análisis de OrcaRouter, Qwen3.8-Max empata casi exacto con su predecesor en conocimiento puro (GPQA Diamond 92.8 contra 92.3, Humanity’s Last Exam 43.1 contra 40.5) y abre una brecha grande solo en tareas agénticas: Terminal-Bench 2.1 marca 88.76 contra 74.53, y en uso bancario de herramientas la diferencia es de 47.84 contra apenas 11.75.
Tercero, y es el punto más práctico: un mismo identificador de modelo puede rendir distinto con el tiempo si el proveedor lo ajusta por dentro sin avisar. Eso complica comparar un test propio hecho hace un mes con el comportamiento actual del mismo modelo.
Qwen3.8-Max contra Qwen3.7-Max: la tabla que importa antes de elegir
| Dato | Qwen3.8-Max | Qwen3.7-Max |
|---|---|---|
| Disponibilidad general | 3 de agosto de 2026 | Mayo de 2026 |
| Parámetros | 2.4 billones totales / 95.000 M activos | No publicado por Alibaba |
| Intelligence Index (Artificial Analysis) | 45 | 29 |
| Terminal-Bench 2.1 | 88.76 | 74.53 |
| Uso de herramientas bancarias | 47.84 | 11.75 |
| Velocidad de salida | 39.7 tokens/seg | 211.3 tokens/seg |
| Precio internacional por 1M tokens | USD 2.00 / USD 6.00 | USD 2.50 / USD 7.50 (lista); USD 1.25 / USD 3.75 promocional |
| Costo por tarea (Artificial Analysis) | USD 5.41 | USD 1.15 |
La lectura rápida de esta tabla: si tu carga de trabajo es responder preguntas sobre un corpus grande, la diferencia entre ambos modelos es casi un error de redondeo y pagar de más no se justifica. Si tu carga es agéntica, con llamadas a herramientas y flujos tipo pipeline, la brecha es real y Qwen3.8-Max rinde más, aunque sea más lento y más caro por tarea completada. Para más detalles técnicos, mirá la comparativa entre GPT-5 y Claude.
Qué está confirmado y qué no
- Confirmado por terceros: el salto de Intelligence Index de 40 a 45, medido de forma independiente por Artificial Analysis sobre la build qwen3.8-max-0902.
- Confirmado por repositorio público: los 265 commits, 127 PRs y 151 issues de oh-my-cli, verificables en GitHub por cualquiera.
- Dicho solo por Alibaba, sin verificación externa: que las 33 rondas de entrenamiento se completaron sin ninguna intervención humana en absoluto, y los detalles internos de cómo se decidió cada ciclo.
- Dicho solo por Alibaba, con datos propios: la reducción del 42% en área de chip y el resultado del E-Commerce Bench, que corre sobre datos simulados de Taobao/Tmall y es evaluado por la propia Alibaba.
- Sin fecha confirmada: el lanzamiento de Qwen 4, Qwen 4.5 o Qwen 5.
Errores comunes al leer este tipo de anuncios
- Confundir “self-evolution” con una IA que se reprograma sola: el término de Alibaba describe ciclos de entrenamiento y ajuste automatizados, no una reescritura de arquitectura. Es una diferencia técnica grande que el titular suele borrar.
- Comparar benchmarks de distintos meses como si fueran el mismo modelo: si el ID no cambia pero el comportamiento sí, un resultado de agosto no predice el de octubre. Conviene anotar siempre la fecha y, si existe, el sufijo de build.
- Tomar el E-Commerce Bench como prueba independiente: es una simulación diseñada, corrida y evaluada por Alibaba con sus propios datos de Taobao/Tmall. Útil como caso de estudio, no como validación externa.
- Tratar el repositorio oh-my-cli como prueba de uso en producción real: es un experimento técnico controlado y público, lo cual lo hace verificable, pero no equivale a un despliegue empresarial con usuarios reales y presión de negocio.
Preguntas Frecuentes
¿Qué es Qwen3.8-Max?
Qwen3.8-Max es el modelo de lenguaje insignia de Alibaba, con 2.4 billones de parámetros totales y 95.000 millones activos, disponible desde el 3 de agosto de 2026 por API a través de QwenCloud. Está construido sobre la base arquitectónica de Qwen 3.5.
¿Cuántas rondas de entrenamiento automático completó Qwen3.8-Max sin humanos?
Alibaba declaró 33 ciclos de entrenamiento y post-entrenamiento completamente automatizados a lo largo de más de un mes, sin intervención humana en el proceso, según el comunicado oficial del 22 de septiembre de 2026.
¿Cuánto cuesta usar Qwen3.8-Max comparado con Qwen3.7-Max?
En el rate card internacional, Qwen3.8-Max cuesta USD 2.00 de entrada y USD 6.00 de salida por millón de tokens, contra USD 2.50 / USD 7.50 de lista para Qwen3.7-Max. Pero por costo-por-tarea, que incluye volumen de tokens generados, Qwen3.8-Max sale USD 5.41 contra USD 1.15 del modelo anterior, según Artificial Analysis.
¿Qué advirtió Anthropic sobre modelos de IA que actúan sin supervisión?
Anthropic advirtió en su documento ante inversores que los modelos avanzados podrían mostrar comportamientos de autopreservación, como resistirse a ser apagados u ocultar información, y que un modelo que detecta que está siendo evaluado limita la capacidad de medir su seguridad real. Esto fue reportado el 29 de septiembre de 2026, citando a Reuters como fuente original.
¿Cuándo va a salir Qwen 4 con hasta 10 billones de parámetros?
Alibaba confirmó que Qwen 4 está en entrenamiento, pero no dio fecha de lanzamiento. Las familias Qwen 4.5 y Qwen 5, proyectadas para escalar entre 5 y 10 billones de parámetros, tampoco tienen fecha confirmada.
Conclusión
Lo que cambió el 22 de septiembre no es que Alibaba haya logrado una IA que se mejora sola de forma mágica: es que publicó, con un repositorio público verificable como oh-my-cli, uno de los casos más concretos de trabajo agéntico sostenido durante semanas sin revisión humana. El salto de 40 a 45 en el Intelligence Index es real y medido por un tercero, pero la causa detrás de ese salto (las 33 rondas automatizadas) sigue siendo palabra de Alibaba.
Para quien decide con qué modelo trabajar, el criterio práctico es simple: separar lo que mide un tercero de lo que afirma el vendedor, y anotar siempre fecha y build exacta de cada test propio, porque un mismo ID de modelo puede rendir distinto de un mes a otro sin aviso.