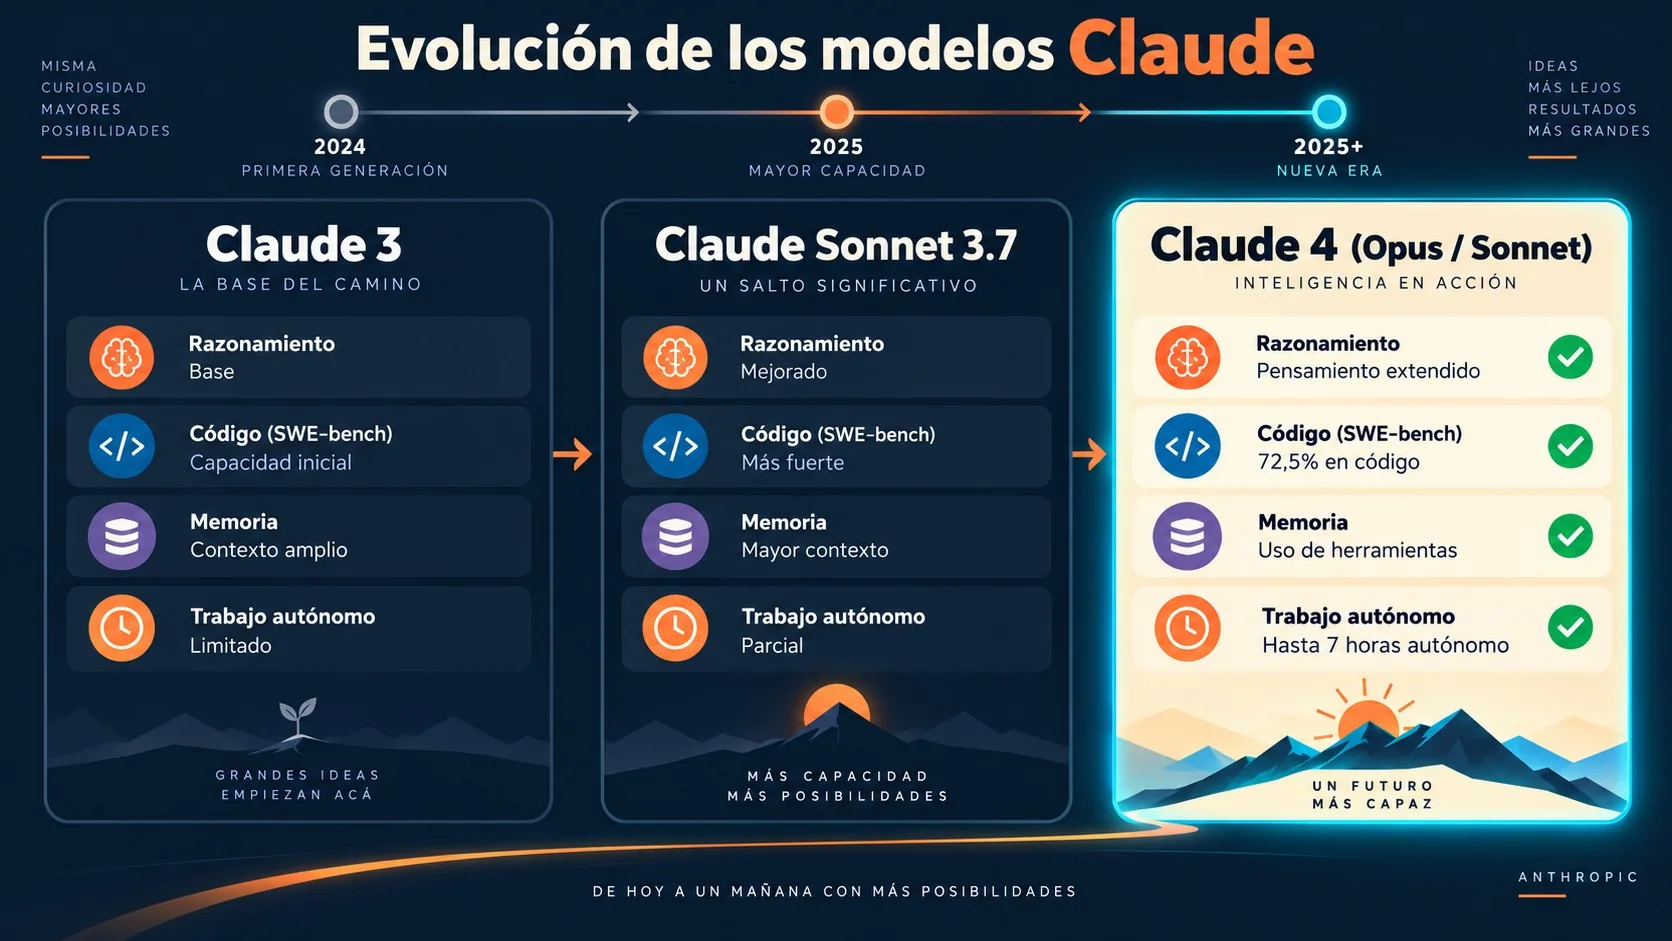
En pocas palabras: Claude 4 es la cuarta generación de modelos de Anthropic, lanzada el 22 de mayo de 2025 con Claude Opus 4 y Claude Sonnet 4. Se diferencia de versiones anteriores por liderar SWE-bench (72.5%), trabajar horas de forma autónoma y ofrecer razonamiento extendido con uso de herramientas.
Si googleaste “qué es Claude 4” probablemente ya viste el nombre en algún lado: GitHub Copilot, Cursor, o algún thread técnico hablando de “el modelo que programa solo”. Claude 4 es la familia de modelos de IA que Anthropic lanzó el 22 de mayo de 2025, compuesta por Claude Opus 4 y Claude Sonnet 4, pensada para programación avanzada, razonamiento y agentes autónomos que trabajan durante horas sin supervisión constante.
Claude 4 es el nombre que Anthropic le puso a su cuarta generación de modelos de lenguaje, lanzada en mayo de 2025. Incluye dos modelos: Claude Opus 4 (el más potente, orientado a tareas complejas de programación y razonamiento) y Claude Sonnet 4 (el reemplazo directo de Sonnet 3.7, con mejor relación entre capacidad y costo). Ambos son modelos híbridos: responden rápido o “piensan” más tiempo según lo que necesites.
En este artículo:
- En 30 segundos
- ¿Cuándo lanzó Anthropic los modelos Claude 4 y cuáles son?
- ¿Qué significa que Claude 4 sea un modelo de razonamiento híbrido?
- ¿Qué resultados obtiene Claude 4 en benchmarks de programación?
- ¿Cómo mejora la memoria y los flujos de trabajo agentic en Claude 4?
- ¿En qué se diferencia Claude Sonnet 4 de Claude Sonnet 3.7?
- Qué vas a necesitar para empezar a usar Claude 4
- Paso 1: Elegí entre Claude Opus 4 y Claude Sonnet 4 según tu tarea
- Paso 2: Activá el pensamiento extendido cuando la tarea lo justifique
- Paso 3: Conectá Claude 4 a tu flujo de trabajo real
- Paso 4: Calculá el costo real por tokens antes de escalar
- Resultado final
- ¿Cuánto cuesta usar Claude Opus 4 y Claude Sonnet 4?
- ¿Dónde está disponible Claude 4 además de la app de Claude?
- ¿Qué limitaciones tiene Claude 4?
- ¿Qué alternativas existen a Claude 4?
- Errores comunes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Anthropic lanzó Claude Opus 4 y Claude Sonnet 4 el 22 de mayo de 2025, como sucesores de la línea Claude 3.x.
- Claude Opus 4 lidera SWE-bench Verified con 72.5% y Terminal-bench con 43.2%, según el comunicado de mayo de 2025.
- Claude Sonnet 4 saca 72.7% en SWE-bench, apenas por encima de Opus 4 en ese benchmark puntual.
- Opus 4 cuesta USD 15/75 por millón de tokens (entrada/salida); Sonnet 4 cuesta USD 3/15, precios vigentes al lanzamiento (mayo 2025); verificá tarifas actuales a octubre de 2026 antes de presupuestar.
- Los dos modelos están disponibles en la API de Anthropic, Amazon Bedrock y Google Vertex AI, además de la app de Claude.
¿Cuándo lanzó Anthropic los modelos Claude 4 y cuáles son?
Anthropic presentó Claude Opus 4 y Claude Sonnet 4 el 22 de mayo de 2025, según el comunicado oficial de la empresa. No lanzó un modelo Haiku dentro de esta generación en ese momento: el anuncio original habla solo de Opus 4 y Sonnet 4, así que si buscás “Claude Haiku 4” tomalo con pinzas hasta que encuentres una fuente que confirme esa versión específica.
Sonnet 4 reemplaza directamente a Sonnet 3.7. Eso significa que si ya tenías integraciones corriendo con 3.7, podés migrar sin rediseñar nada grande: Anthropic lo describe como “drop-in replacement” en la documentación para Amazon Bedrock. Opus 4, en cambio, no tiene un predecesor directo con el mismo nombre: es el tope de gama nuevo, pensado para tareas largas y complejas que antes directamente no se podían resolver con un solo modelo.
Ojo con esto: estamos en octubre de 2026 y Claude 4 ya lleva más de un año en producción. Si Anthropic lanzó versiones posteriores con otro nombre, este artículo no las cubre porque no contamos con fuentes confirmadas sobre eso al momento de escribir. Lo que sigue describe específicamente la generación Claude 4 tal como se anunció y documentó.
¿Qué significa que Claude 4 sea un modelo de razonamiento híbrido?
Un modelo híbrido significa que Claude Opus 4 y Sonnet 4 tienen dos modos de respuesta: uno casi instantáneo para consultas simples, y otro de “pensamiento extendido” (extended thinking) para problemas que requieren razonar paso a paso antes de contestar. Vos elegís cuál usar según la tarea, sin cambiar de modelo.
Lo interesante es que, según el anuncio de Anthropic, ambos modelos ahora pueden usar herramientas (como búsqueda web) durante ese pensamiento extendido, en fase beta. Esto quiere decir que Claude puede alternar entre “pensar” y “buscar datos” mientras arma una respuesta, en vez de pensar primero y buscar después como un proceso separado. Para casos de uso de investigación o análisis de código con dependencias externas, esto cambia bastante el flujo de trabajo.
El tema es que esta flexibilidad tiene un costo en latencia y en tokens. Pedirle a Claude que use extended thinking para una pregunta trivial es tirar plata y tiempo a la basura. Para eso está el modo instantáneo, que es el que corre por defecto en la mayoría de las integraciones.
¿Qué resultados obtiene Claude 4 en benchmarks de programación?
Claude Opus 4 lidera SWE-bench Verified con 72.5% y Terminal-bench con 43.2%, según los datos publicados por Anthropic en el comunicado de mayo de 2025. SWE-bench es un benchmark que mide qué tan bien un modelo resuelve issues reales de GitHub, no ejercicios de juguete, así que el número importa.
¿Y Sonnet 4? Saca 72.7% en el mismo benchmark, levemente por encima de Opus 4. ¿Raro que el modelo “menor” gane en un número puntual al “mayor”? No tanto: SWE-bench mide un tipo específico de tarea, y Anthropic aclara que, más allá de ese dato puntual, Sonnet 4 no iguala a Opus 4 en la mayoría de los dominios, aunque ofrece una combinación óptima de capacidad y practicidad para uso cotidiano.
Donde Opus 4 se despega de verdad es en trabajo sostenido: puede operar durante varias horas seguidas en tareas de miles de pasos sin perder coherencia, según el comunicado de Anthropic. Esa es la diferencia real entre “resolver un ejercicio” y “refactorizar un proyecto completo sin que alguien lo esté mirando cada cinco minutos”. En nuestra guía completa de Claude profundizamos sobre esto.
¿Cómo mejora la memoria y los flujos de trabajo agentic en Claude 4?
Claude Opus 4 puede crear y mantener archivos de memoria cuando los desarrolladores le dan acceso a archivos locales, guardando información clave para mantener continuidad entre sesiones largas. Anthropic muestra un ejemplo llamativo: Opus 4 jugando Pokémon y armando por su cuenta una “Navigation Guide” con notas reales sobre el mapa del juego, para no perderse en partidas largas.
Más allá de la anécdota, esto tiene aplicación directa en tareas agentic serias. Rakuten validó las capacidades de Opus 4 con una refactorización de código abierto que corrió de forma independiente durante 7 horas, manteniendo performance sostenida durante todo ese tiempo, según reporta Anthropic citando al cliente. Eso es un agente trabajando solo, sin intervención humana, durante una jornada laboral completa.
Otro dato que me parece subestimado: ambos modelos son 65% menos propensos a usar atajos o loopholes para completar tareas, comparado con Sonnet 3.7, en tareas agentic particularmente susceptibles a ese comportamiento. Si alguna vez viste un agente “resolver” un test marcándolo como skip en vez de arreglar el bug real, entendés por qué esto importa.
iGent reportó que Sonnet 4 redujo los errores de navegación de código de 20% a casi cero, según cita Anthropic en el mismo comunicado. Eso es plata y horas de debugging que ya no se pierden.
¿En qué se diferencia Claude Sonnet 4 de Claude Sonnet 3.7?
Claude Sonnet 4 mejora a Sonnet 3.7 en codificación, razonamiento y precisión para seguir instrucciones, según Anthropic. El salto más medible está en SWE-bench: Sonnet 4 llega a 72.7%, un número que Anthropic describe como estado del arte para ese modelo dentro de su categoría.
GitHub anunció que Sonnet 4 va a ser el modelo que impulse el nuevo agente de código en GitHub Copilot, destacando que “soars in agentic scenarios” (vuela en escenarios agentic). No es poco que una plataforma con la escala de GitHub elija este modelo como base para su producto de agentes de código.
Sourcegraph lo describe como un salto sustancial en desarrollo de software: se mantiene en tarea por más tiempo, entiende los problemas con más profundidad y produce código más prolijo. Augment Code, por su parte, lo eligió como modelo primario después de ver tasas de éxito más altas y ediciones de código más quirúrgicas, con menos efectos colaterales no deseados.
Qué vas a necesitar para empezar a usar Claude 4
Antes de meterte a usar Claude Opus 4 o Sonnet 4, conviene tener esto resuelto:
- Una cuenta de Claude o una API key de Anthropic. Para uso conversacional, cualquier plan Pro, Max, Team o Enterprise te da acceso a ambos modelos con extended thinking incluido. Si solo querés probar, Sonnet 4 está disponible para usuarios free.
- Acceso a Amazon Bedrock o Google Vertex AI (opcional). Si tu infraestructura ya corre en AWS o GCP, podés usar los mismos modelos sin pasar por la API directa de Anthropic.
- Presupuesto definido por tokens, no por “uso mensual” genérico. Opus 4 y Sonnet 4 se cobran por millón de tokens de entrada y salida, así que necesitás estimar volumen antes de comprometerte.
- Claude Code instalado, si vas a programar. Está disponible de forma general (GA) con extensiones para VS Code y JetBrains.
Paso 1: Elegí entre Claude Opus 4 y Claude Sonnet 4 según tu tarea
Usá Opus 4 para tareas largas, complejas y de alto riesgo (refactors grandes, investigación, trabajo multi-archivo sostenido). Usá Sonnet 4 para todo lo demás: revisiones de código, bugs puntuales, generación de contenido de producción, subagentes dentro de un sistema multi-agente. Relacionado: cómo elegir entre Sonnet y Opus.
Esta decisión no es cosmética: pagar Opus 4 para tareas rutinarias es tirar plata, porque sale cinco veces más caro por tokens de entrada que Sonnet 4. Si estás armando un pipeline de revisión de código automática que corre cientos de veces por día, Sonnet 4 es la opción razonable. Si estás migrando una base de código entera a otro framework y necesitás que el modelo sostenga contexto durante horas, ahí Opus 4 se justifica.
Resultado esperado: tenés definido qué modelo vas a usar antes de escribir una sola línea de integración, lo que te ahorra tener que reescribir prompts y pipelines más adelante.
Paso 2: Activá el pensamiento extendido cuando la tarea lo justifique
En la API, el pensamiento extendido se configura con un presupuesto de tokens para razonamiento (thinking budget). Subís ese número cuando necesitás que el modelo analice un problema en profundidad antes de responder, y lo dejás bajo o apagado para interacciones rápidas.
// Ejemplo conceptual de configuración, en base a la documentación de AWS Bedrock
let inferenceConfig = InferenceConfiguration(
 maxTokens: 4096,
 temperature: 0.0
)
// El thinking budget se ajusta aparte, según la profundidad de análisis que necesites
Resultado esperado: en tareas de razonamiento matemático o arquitectura de software, deberías ver respuestas más consistentes y con menos errores de lógica, a cambio de más latencia.
Ojo con esto: activar extended thinking en cada llamada, incluso para preguntas triviales, infla el costo sin mejorar la respuesta. Reservalo para lo que realmente lo necesita.
Paso 3: Conectá Claude 4 a tu flujo de trabajo real
Tenés tres caminos principales: la API directa de Anthropic, Amazon Bedrock, o Google Vertex AI. Si ya programás en Swift, Python o cualquier lenguaje con SDK de AWS, Bedrock usa el mismo Converse API para todos los modelos, lo que te permite escribir código una vez y cambiar de modelo después sin reescribir la lógica de integración.
El model ID para Bedrock es anthropic.claude-opus-4-20250514-v1:0 para Opus 4 y anthropic.claude-sonnet-4-20250514-v1:0 para Sonnet 4, según la documentación oficial de AWS. Si programás, Claude Code se instala corriendo /install-github-app desde dentro de la herramienta, lo que te habilita revisión de PRs, corrección de errores de CI y modificación de código directamente desde comentarios en GitHub.
// Instalar integración de Claude Code con GitHub
/install-github-app
Resultado esperado: Claude Code queda tageable en Pull Requests, respondiendo a comentarios de reviewers, arreglando errores de integración continua o modificando código sin que tengas que copiar y pegar nada manualmente.
Si estás levantando infraestructura propia para correr estos agentes (servidores, dominios, backend para tu producto), para hosting y dominios en Argentina podés mirar donweb.com en vez de armar todo desde cero con proveedores internacionales que complican la facturación local.
Paso 4: Calculá el costo real por tokens antes de escalar
Sumá tokens de entrada y salida estimados por tarea, multiplicá por el precio del modelo elegido, y proyectá volumen mensual antes de poner algo en producción. Un agente que corre cientos de veces por día con Opus 4 puede salir carísimo si lo que necesitabas era Sonnet 4. Tema relacionado: la skill ELI5 de Claude Code.
Una herramienta útil acá es el prompt caching: Anthropic permite cachear prompts por hasta una hora, lo que reduce el costo de llamadas repetidas con el mismo contexto base. Si tu agente reusa el mismo system prompt cientos de veces por día, esto no es un detalle menor.
Resultado esperado: tenés un número concreto de costo mensual estimado, no una sensación de “debería andar bien de precio”.
Resultado final
Al terminar estos pasos tenés un modelo Claude 4 elegido con criterio (no por moda), conectado a tu flujo de trabajo real, con el pensamiento extendido activado solo donde aporta, y un costo mensual proyectado en vez de una sorpresa en la factura. Para verificar que todo quedó bien configurado, corré una tarea de prueba representativa (un bug real, no un “hola mundo”) y compará el resultado contra lo que te daba tu modelo anterior.
¿Cuánto cuesta usar Claude Opus 4 y Claude Sonnet 4?
Claude Opus 4 cuesta USD 15 por millón de tokens de entrada y USD 75 por millón de tokens de salida. Claude Sonnet 4 cuesta USD 3 por millón de tokens de entrada y USD 15 por millón de salida, según confirma Anthropic en el comunicado oficial de lanzamiento, manteniendo los mismos precios que tenían los modelos Opus y Sonnet anteriores. Estos valores son los vigentes al lanzamiento (mayo de 2025); si estás presupuestando a octubre de 2026, verificá las tarifas actuales en la documentación oficial de Anthropic.
| Característica | Claude Opus 4 | Claude Sonnet 4 |
|---|---|---|
| Precio entrada (por millón de tokens) | USD 15 | USD 3 |
| Precio salida (por millón de tokens) | USD 75 | USD 15 |
| SWE-bench Verified | 72.5% | 72.7% |
| Terminal-bench | 43.2% | No reportado por Anthropic |
| Modelo predecesor directo | Sin predecesor con mismo nombre | Claude Sonnet 3.7 |
| Disponible en plan free | No | Sí |
| Disponible en API / Bedrock / Vertex AI | Sí | Sí |
¿Dónde está disponible Claude 4 además de la app de Claude?
Claude 4 está disponible en la API directa de Anthropic, en Amazon Bedrock y en Google Vertex AI, según confirman tanto Anthropic como el blog oficial de AWS. Esto te permite elegir dónde correrlo según la nube que ya uses en tu empresa, sin estar atado a un único proveedor.
En Amazon Bedrock específicamente, Claude Opus 4 está disponible en las regiones de Norteamérica (US East en Ohio y N. Virginia, y US West en Oregon). Claude Sonnet 4 tiene cobertura más amplia: además de Norteamérica, está en Asia-Pacífico (Hyderabad, Mumbai, Osaka, Seúl, Singapur, Sídney, Tokio) y en Europa (España), según el blog de AWS. También podés usar inferencia cross-region para que Bedrock elija automáticamente la región óptima dentro de tu geografía.
Claude Code, la herramienta de programación de Anthropic, pasó a disponibilidad general con esta misma generación. Tiene extensiones beta para VS Code y JetBrains que muestran las ediciones propuestas directamente en tus archivos, más un SDK extensible para armar tus propios agentes sobre el mismo motor que usa Claude Code.
¿Qué limitaciones tiene Claude 4?
Las fuentes oficiales de este lanzamiento no detallan el tamaño exacto de la ventana de contexto ni límites de rate específicos por plan, así que si necesitás ese dato puntual, consultá la documentación técnica actualizada de Anthropic antes de diseñar tu arquitectura.
Lo que sí queda claro en el comunicado es que Opus 4 es notablemente más caro que Sonnet 4 (cinco veces más en tokens de entrada), y que el uso de extended thinking con herramientas sigue en fase beta, lo que implica que puede cambiar de comportamiento entre versiones. Las cadenas de pensamiento completas (raw chain of thought) no están disponibles por defecto: si las necesitás para prompt engineering avanzado, tenés que contactar a ventas para acceder al Developer Mode. Complementá con la integración de Claude con Make.com.
¿Qué alternativas existen a Claude 4?
En el mercado de modelos de lenguaje de uso general conviven, además de la familia Claude de Anthropic, modelos como los de OpenAI y Google. No contamos en las fuentes de este artículo con benchmarks comparativos directos entre Claude 4 y esos modelos, así que evitamos inventar números de “quién gana”. Si estás evaluando opciones, lo más honesto es correr tu propio benchmark con tus tareas reales, porque los resultados cambian bastante según el tipo de tarea (código, redacción, análisis de datos).
Errores comunes
Elegir Opus 4 para todo y volarse el presupuesto
Pasa en el Paso 1, cuando no se define bien el criterio de selección de modelo. La causa es simple: Opus 4 “suena” mejor porque es el más potente, pero para tareas rutinarias eso solo significa pagar cinco veces más sin ganancia real en calidad. Solución: definí de antemano qué tareas son candidatas a Opus 4 (trabajo largo, alto riesgo) y cuáles van a Sonnet 4, y documentalo para que el equipo no improvise caso por caso.
Usar el model ID de Sonnet 3.7 y no ver las mejoras
Ocurre en el Paso 3, al migrar una integración vieja sin actualizar el identificador del modelo. Si tu código todavía apunta al ID de Sonnet 3.7, vas a seguir usando el modelo anterior aunque creas que estás en Claude 4. Solución: verificá explícitamente que el model ID en tu configuración sea anthropic.claude-sonnet-4-20250514-v1:0 o el equivalente de Opus 4, y no asumas que “actualizar el SDK” cambia el modelo por vos.
Activar extended thinking en cada llamada sin necesidad
Sucede en el Paso 2, cuando se configura un thinking budget alto por defecto para todas las consultas. El problema es que esto dispara latencia y costo en tareas que no lo necesitan, como respuestas conversacionales simples. Solución: segmentá tus endpoints o flujos por complejidad de tarea, y activá el pensamiento extendido solo donde el beneficio justifique el costo adicional.
No contemplar el límite geográfico de Bedrock
Pasa en el Paso 3 al desplegar en producción sin chequear regiones. Opus 4 solo está disponible en regiones de Norteamérica dentro de Amazon Bedrock, así que si tu infraestructura corre en Europa o Asia y necesitás Opus 4 específicamente, vas a tener que llamar a una región distinta a la de tu resto de servicios. Solución: revisá la disponibilidad regional antes de diseñar la arquitectura, o usá la inferencia cross-region que ofrece Bedrock para resolverlo automáticamente.
Preguntas Frecuentes
¿Qué es Claude 4 y para qué sirve?
Claude 4 es la generación de modelos de lenguaje de Anthropic lanzada en mayo de 2025, compuesta por Claude Opus 4 y Claude Sonnet 4. Sirve principalmente para programación avanzada, razonamiento complejo y agentes de IA que ejecutan tareas largas de forma autónoma, aunque también se usa para escritura, investigación y asistencia conversacional general.
¿En qué se diferencia Claude 4 de Claude 3?
Claude 4 agrega pensamiento extendido con uso de herramientas, memoria persistente mediante archivos locales y capacidad de trabajar de forma autónoma durante varias horas en tareas agentic complejas. La línea Claude 3.x, en cambio, no tenía esta combinación de razonamiento híbrido con uso de herramientas durante el proceso de pensamiento.
¿Cuáles son los modelos de Claude 4 (Opus, Sonnet, Haiku)?
Al momento del lanzamiento, Anthropic presentó solo dos modelos dentro de la generación Claude 4: Claude Opus 4 y Claude Sonnet 4. El comunicado oficial no menciona una versión Haiku dentro de esta generación, así que si necesitás un modelo liviano de la familia, conviene chequear directamente la documentación actualizada de Anthropic.
¿Cuánto cuesta usar Claude Opus 4 y Claude Sonnet 4?
Claude Opus 4 cuesta USD 15 por millón de tokens de entrada y USD 75 por millón de salida. Claude Sonnet 4 cuesta USD 3 por millón de entrada y USD 15 por millón de salida, los mismos precios que tenían los modelos Opus y Sonnet anteriores, según confirma Anthropic. Estos son los precios vigentes al lanzamiento (mayo de 2025); verificá tarifas actuales a octubre de 2026 antes de presupuestar.
¿Qué mejoras tiene Claude Sonnet 4 respecto a Sonnet 3.7?
Claude Sonnet 4 mejora en codificación, razonamiento y precisión para seguir instrucciones, alcanzando 72.7% en SWE-bench Verified. Funciona como reemplazo directo de Sonnet 3.7 en integraciones existentes, sin requerir rediseño de la arquitectura de la aplicación.
Conclusión
Claude 4 no es un simple incremento de versión: es la generación donde Anthropic apostó fuerte por agentes que trabajan solos durante horas, con memoria persistente y razonamiento que puede combinarse con herramientas externas. Si programás, la decisión práctica se reduce a esto: Sonnet 4 para el día a día (barato, rápido, suficiente para la mayoría de las tareas), y Opus 4 para los proyectos grandes donde necesitás que el modelo sostenga contexto y coherencia durante un trabajo largo, como el caso de Rakuten con sus 7 horas de refactorización continua.
Tiene sentido escalar a Opus 4 cuando ya probaste Sonnet 4 en producción y ves que las tareas complejas se te quedan cortas de contexto o de persistencia. Lo que sigue lógicamente después de este artículo es meterte a la documentación técnica actual de Anthropic para confirmar si salieron actualizaciones posteriores a esta generación, porque entre mayo de 2025 y octubre de 2026 es esperable que haya habido novedades que este artículo, basado en las fuentes del lanzamiento original, no cubre.