
En pocas palabras: Gemini 3.8 TTS es la familia de modelos de voz de Google que convierte texto en audio de uno o dos hablantes. Tiene dos modelos, Flash (130 idiomas) y Flash-Lite (101), en Preview desde el 28 de septiembre de 2026. GeminiTTS es una app independiente que los usa.
Gemini TTS es la familia de modelos de voz de Google que convierte texto en audio con uno o dos hablantes. La versión 3.8 llegó en septiembre de 2026 con dos modelos, Flash y Flash-Lite, y según la documentación de Google Cloud ambos están en etapa Preview.
Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) y Gemini 3.8 Flash-Lite TTS (gemini-3.8-flash-lite-tts) son modelos de texto a voz de Google. Los usás desde la Gemini API o desde Gemini Enterprise para generar audio de uno o dos hablantes, con estilo, acento y ritmo controlados por anotaciones en cada turno. Sirven para podcasts, audiolibros o asistentes de voz. GeminiTTS (con “TTS” pegado) es otra cosa: una app independiente que usa esos modelos.
En este artículo:
- En 30 segundos
- ¿Cuándo lanzó Google los modelos Gemini 3.8 TTS?
- ¿Qué diferencia hay entre Gemini 3.8 Flash TTS y Flash-Lite TTS?
- ¿Cómo se hace un diálogo de dos voces con Gemini TTS?
- ¿GeminiTTS es un producto de Google?
- ¿Qué está confirmado y qué no?
- ¿Para qué sirve Gemini TTS y qué límites tiene?
- ¿Qué errores se cometen al usar Gemini TTS?
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Google presentó Gemini 3.8 Flash TTS y Flash-Lite TTS en septiembre de 2026, ambos en Preview.
- Flash apunta a fidelidad y actuación (130 idiomas). Flash-Lite apunta a volumen y costo (101 idiomas).
- Los dos aceptan un hablante o varios, streaming, 30 voces predefinidas, Voice design y Voice replication.
- GeminiTTS (geminitts.app) no es de Google: es una app de terceros con 20 créditos gratis y descarga en WAV.
- Los dos modelos comparten esquema de request, así que pasar de uno a otro es cambiar el ID del modelo.
¿Cuándo lanzó Google los modelos Gemini 3.8 TTS?
Google presentó Gemini 3.8 Flash TTS y Flash-Lite TTS a fines de septiembre de 2026. La documentación de Google Cloud indica “Release date: September 28, 2026” y “Launch stage: Preview” para los dos modelos.
Ojo: si necesitás citar una fecha, citá la de la documentación oficial y aclará que es la de Google Cloud.
¿Existe entonces Gemini 3.8 TTS o es otra versión con nombre cambiado? Existe. La página de Flash-Lite TTS nombra como antecesor a gemini-3.1-flash-tts-preview y remite a una guía de migración. Para usar los nuevos modelos con la Gemini API, la documentación pide google-genai 2.25.0 o superior en Python, o @google/genai 2.24.0 o superior en JavaScript y TypeScript.
El post de dev.to del 7 de octubre de 2026 no es el lanzamiento. Es la reseña de un desarrollador sobre su app. Sobre eso hablamos en nuestra guía completa sobre Gemini.
¿Qué diferencia hay entre Gemini 3.8 Flash TTS y Flash-Lite TTS?
Flash TTS prioriza fidelidad de estudio, actuación expresiva y acentos regionales en 130 idiomas. Flash-Lite TTS prioriza rendimiento, baja latencia y costo, en 101 idiomas. Según Google Cloud, los dos comparten esquema de request y formato de prompting, y los dos soportan uno o varios hablantes.
| Característica | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| ID del modelo | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| Fortaleza según Google | Fidelidad, actuación, dialectos | Rendimiento, baja latencia, costo |
| Idiomas | 130 | 101 |
| Usos recomendados | Audiolibros, narración de estudio, diálogos complejos, pronunciaciones difíciles | Producción en volumen, agentes de voz en tiempo real, lectura en voz alta |
| Límite de entrada / salida | 8.192 / 16.384 tokens | 8.192 / 16.384 tokens |
| Streaming, Voice design, Voice replication | Soportados | Soportados |
| Etapa y región | Preview, global | Preview, global |
Las dos fichas listan 30 voces predefinidas y más de 2.000 voces curadas en la Extended Voice Library. La documentación tiene una sección de precios, pero las fuentes que revisamos no publican cifras, así que conviene consultarla directamente antes de presupuestar.
El flujo práctico es el que propone el autor de la app de terceros: iterás el guion con Flash-Lite y hacés la toma final con Flash. Tiene sentido porque, al compartir esquema, el cambio no toca tu código. Eso sí: que el flujo sea razonable no prueba que la diferencia de calidad justifique el costo extra. Eso lo medís vos con tu guion.
¿Cómo se hace un diálogo de dos voces con Gemini TTS?
Con la Gemini API configurás dos hablantes en speech_config.speakers y mandás cada turno como un ítem de texto aparte, con una anotación speech_metadata que indica el hablante y, si querés, el estilo de ese turno. La respuesta es audio WAV por defecto, según la guía oficial de Google.
El ejemplo de la documentación usa a Joe con la voz Puck y a Jane con la voz Kore. Joe pregunta “How’s it going today Jane?” con estilo “cheerful and friendly”, y Jane responde con estilo “calm and relaxed”. Un detalle que se pasa por alto: para un solo hablante, speech_config es un arreglo ([{"voice": "Kore"}]), y para varios es un objeto ({"speakers": [...]}). Confundirlos rompe la llamada.
- Voces predefinidas: hay 30, y también podés usar la Extended Voice Library, un ID de Voice design o uno de Voice replication.
- Etiquetas dentro del texto: Google Cloud documenta eventos vocales como
<laugh>,<sigh>y<short pause>. - Salida: el SDK entrega el WAV ya decodificado. En el ejemplo de Go, el audio crudo se arma como PCM de 24.000 Hz, mono y 16 bits.
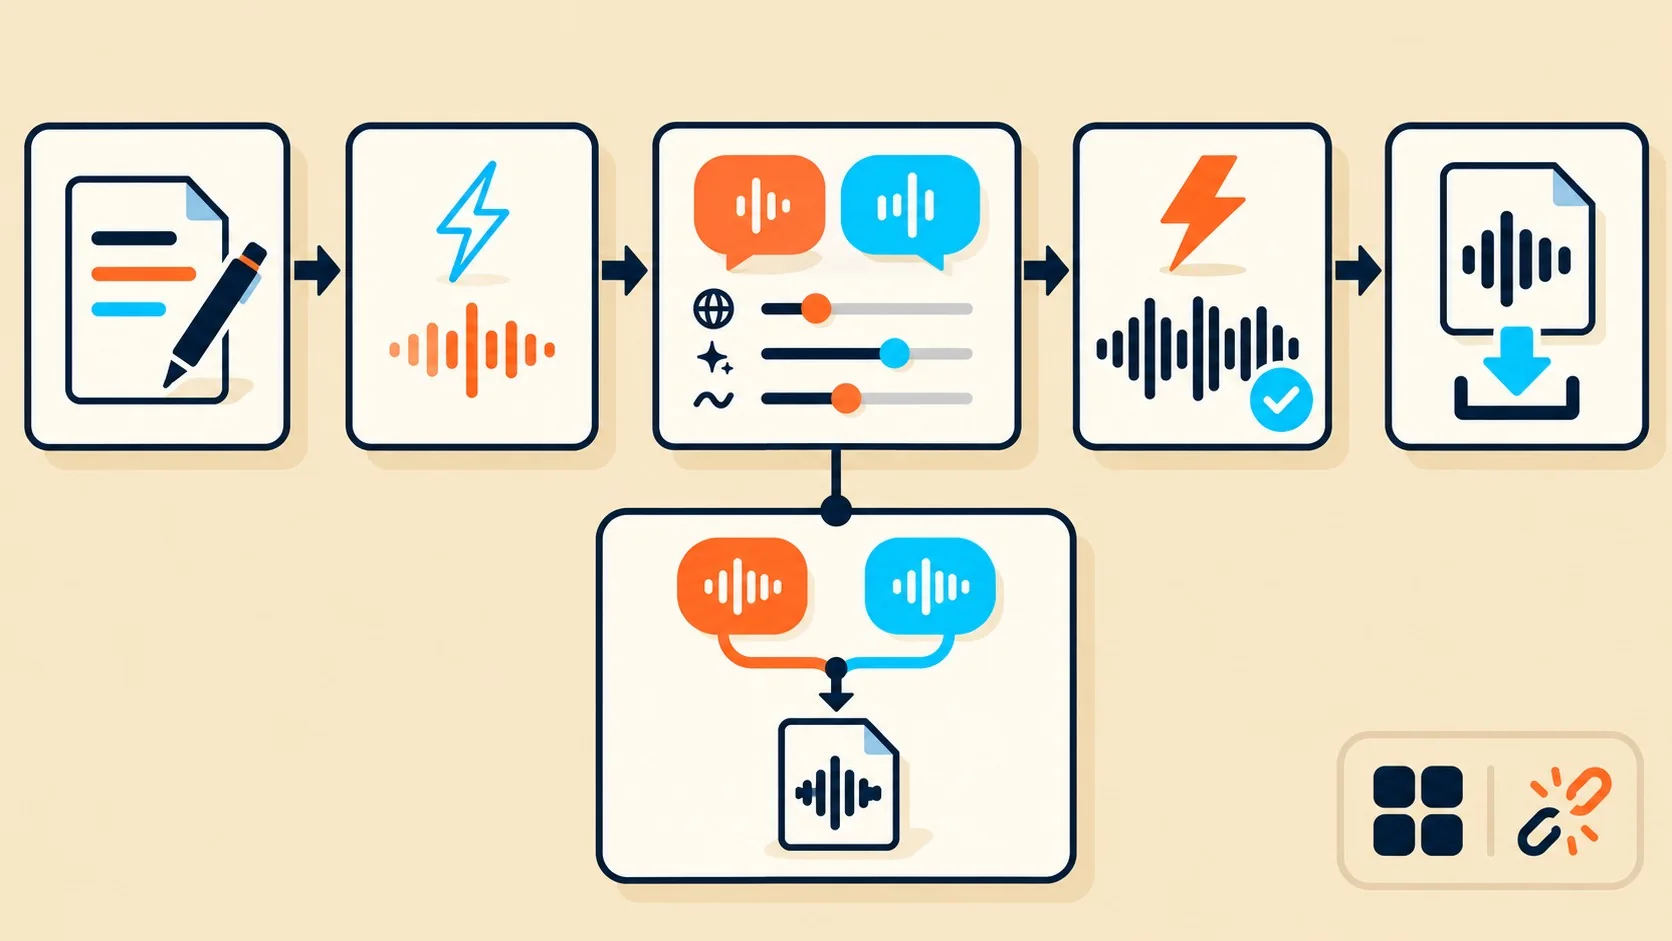
Si no querés tocar código, la app GeminiTTS arma lo mismo desde el navegador: escribís el diálogo una vez, asignás una voz a cada hablante y recibís un único archivo, sin pegar clips en un editor. Según el autor del post, el modelo se ocupa de los turnos y el ritmo. Nadie lo verificó de forma independiente, tomalo como declaración del desarrollador. Ya lo cubrimos antes en activar Gemini directamente en Chrome.
¿GeminiTTS es un producto de Google?
No. GeminiTTS (geminitts.app) es una app independiente construida sobre los modelos Gemini 3.8 TTS. El propio post de dev.to lo aclara en una nota: “it is not a Google product”. El nombre confunde (y sospecho que no es casualidad), pero quien responde por el servicio es su desarrollador, no Google.
Lo que el desarrollador declara de la app, y que no pudimos verificar por nuestra cuenta:
- Uso en el navegador: sin instalar nada y sin gestionar API key.
- Dos modelos: Flash para entrega expresiva y Flash Lite para borradores rápidos.
- 30 voces predefinidas: son las mismas 30 de Google. Las más de 2.000 de la Extended Voice Library son de la plataforma de Google, no de la app.
- Controles: acento, estilo y ritmo, más señales vocales cortas.
- Biblioteca y WAV: cada generación queda guardada y se descarga en WAV.
- Precio: modelo freemium con 20 créditos de inicio.
¿Qué está confirmado y qué no?
Confirmado por documentación de Google: los IDs de modelo, el estado Preview, los 130 y 101 idiomas, los límites de 8.192 tokens de entrada y 16.384 de salida, el soporte de streaming, de uno o varios hablantes, de Voice design y de Voice replication, y la disponibilidad global.
Declarado por el desarrollador de GeminiTTS, sin verificación independiente: el manejo de turnos y ritmo en el diálogo, los 20 créditos y el ahorro de tiempo frente a unir clips.
Pendiente o sin datos en las fuentes: precios por modelo, fecha de salida de Preview, pruebas comparativas de calidad entre Flash y Flash-Lite y muestras de audio de la app.
¿Para qué sirve Gemini TTS y qué límites tiene?
Gemini TTS sirve cuando necesitás que el audio diga exactamente el texto que escribiste, con control fino de estilo. Google lo distingue de la Live API, pensada para conversación interactiva y sin guion. Los casos que cita el post de dev.to son demos de producto, intros de podcast, explicadores de dos presentadores, clases de idiomas, accesibilidad (pasar posts a audio) y audio provisorio para juegos. Esto se conecta con lo que analizamos en integrar la API de Gemini con Node.js.
Los límites, en cambio, se ven rápido. El post es una reseña de autor, sin muestras comparativas ni mediciones. La app depende de créditos. Y ambos modelos siguen en Preview, o sea que Google puede cambiar comportamiento o condiciones antes de la versión estable.
Sobre Voice replication, la documentación de Google indica que está soportado en los dos modelos. Clonar la voz de alguien sin su permiso es un problema legal y ético, no una opción de configuración.
Ahora, un criterio de verificación que propongo como práctica editorial (no viene de las fuentes ni lo probamos nosotros): tomá un guion de 60 segundos con nombres propios, cifras y un par de palabras en inglés, generalo con Flash-Lite y con Flash usando la misma voz, y escuchá las dos versiones con auriculares. Anotá qué pronunciaciones falla cada una y si la diferencia justifica el costo de Flash en tu caso. Si la versión Lite alcanza, ahorraste. Si no, ya sabés por qué pagar la otra.
Un escenario hipotético para ubicarte: querés un onboarding de app con dos voces, una guía y un usuario, de unos 90 segundos. Escribís el guion, probás tres versiones con Flash-Lite hasta que el ritmo te cierre, y recién ahí gastás una generación con Flash. Con los 8.192 tokens de entrada que documenta Google, un guion largo probablemente haya que partirlo en tramos (inferencia mía, comprobalo con tu texto).
¿Qué errores se cometen al usar Gemini TTS?
- Pensar que GeminiTTS es de Google. Es una app de terceros. Si vas a subir datos sensibles, leé los términos del desarrollador, no los de Google.
- Usar Flash para todos los borradores. Gastás créditos o presupuesto en iteraciones que Flash-Lite resuelve. Reservá Flash para la toma final.
- Mezclar el formato de
speech_config. Un arreglo para un hablante y un objeto conspeakerspara varios. Si copiás un ejemplo y lo adaptás a medias, la llamada falla. - No actualizar el SDK. La guía pide
google-genai2.25.0 o superior en Python. Con una versión vieja, los ejemplos pueden no andar. - Asumir que 130 idiomas significa calidad pareja. Es una cifra de cobertura declarada por Google, no un resultado medido. Probá tu idioma y tu acento con un texto real.
Preguntas Frecuentes
¿Qué es Gemini 3.8 TTS?
Es la generación de modelos de texto a voz de Google formada por Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Convierten texto en audio de uno o varios hablantes y se controlan con estilo, acento y ritmo por turno. Ambos están en Preview según Google Cloud.
¿GeminiTTS es de Google?
No, GeminiTTS es una app independiente que usa los modelos Gemini 3.8 TTS. Su propio desarrollador aclara en el post que no es un producto de Google.
¿Cuál es la diferencia entre Gemini 3.8 Flash TTS y Flash-Lite TTS?
Flash TTS prioriza fidelidad, actuación y dialectos en 130 idiomas, mientras que Flash-Lite TTS prioriza rendimiento y costo en 101 idiomas. Comparten esquema de request, así que cambiás de uno a otro modificando el ID del modelo.
¿Cómo se hace un diálogo de dos voces con la API?
Se configuran dos hablantes en speech_config.speakers y se manda cada turno como un ítem de texto con una anotación speech_metadata que indica el hablante y el estilo opcional. La guía oficial usa como ejemplo a Joe con la voz Puck y a Jane con la voz Kore.
¿Se puede descargar el audio de Gemini TTS en WAV?
Sí, la salida por defecto de la API es WAV (audio/wav), según la documentación de Google. La app GeminiTTS también declara descarga en WAV desde su biblioteca de generaciones.
Conclusión
Lo que cambió es concreto: Google tiene dos modelos de voz 3.8 con el mismo esquema, uno para calidad (130 idiomas) y otro para volumen (101 idiomas), y los dos hacen diálogo de dos voces. Lo que no cambió es que siguen en Preview y que no hay precios ni pruebas independientes en las fuentes que revisé.
Qué hacer: si programás, actualizá el SDK, armá un diálogo de prueba con Joe y Jane y compará Flash-Lite contra Flash con tu propio guion. Si no programás, GeminiTTS es una forma rápida de probar, siempre recordando que es un servicio de terceros y que sus datos son autodeclarados. Antes de publicar nada con voz replicada, conseguí autorización por escrito de la persona.