
En pocas palabras: GPT-6.1 Terra es el LLM más barato que aprueba la clasificación de 77 intenciones bancarias (BANKING77) e iguala al modelo base GPT-6.1 Sol: acierta 84.0% a $0.000727 por tarea exitosa, un 42.8% menos que Sol, según el benchmark de Clearbar del 5/11/2026.
En un benchmark de 150 mensajes de BANKING77, GPT-6.1 Terra resultó el modelo más barato que supera la barra de aprobación e iguala al modelo base GPT-6.1 Sol, según el verdict publicado por Clearbar. El dato interesante no es tanto el ranking en sí, sino el método: cómo se llega a ese número y qué esconde un precio por token que, a simple vista, parece más barato.
GPT-6.1 Terra es un modelo de la familia GPT-6.1 de OpenAI, evaluado en un benchmark de clasificación de intenciones bancarias. BANKING77 es un dataset público de mensajes de clientes de bancos, con licencia CC BY 4.0, cuyo split de test tiene 3.080 filas, donde cada mensaje debe clasificarse en una de 77 etiquetas de intención posibles.
En este artículo:
- Resumen
- ¿Cómo se armó la comparación de los 10 modelos en BANKING77?
- ¿Cómo se mide el costo por tarea exitosa de un LLM más barato para clasificación bancaria?
- ¿Qué modelo resultó el más barato y cuál fue su precisión?
- ¿Por qué los modelos más baratos en precio no siempre son los más baratos en uso?
- Ejemplo hipotético: ¿cuánto pesa esto en un volumen real de mensajes?
- ¿Qué errores cometió GPT-6.1 Terra al clasificar los mensajes?
- Criterios para decidir si te conviene migrar de modelo
- ¿Se puede repetir este benchmark con datos propios?
- Qué está confirmado y qué no
- Preguntas Frecuentes
- Conclusión
- Fuentes
Resumen
- GPT-6.1 Terra clasifica el 84.0% de 150 mensajes bancarios a $0.000727 por tarea exitosa, 42.8% más barato que el modelo base GPT-6.1 Sol.
- El experimento completo con 10 modelos costó $0.58, corrido con precios de OpenRouter del 5/11/2026.
- GPT-6 Luna es 88% más barato ($0.00009) pero no está probado que iguale a Sol: falla 8 tareas que el base acierta.
- Mistral Large 4 tiene un precio por token más bajo que GPT-6.1 Terra, pero termina siendo el modelo más caro por tarea exitosa ($0.002274) por sus 106 reintentos.
- El script de re-run, el dataset y los precios están publicados para que cualquiera repita la comparación con su propia clave de OpenRouter.
¿Cómo se armó la comparación de los 10 modelos en BANKING77?
El equipo de Clearbar tomó 150 mensajes con semilla fija del split de test de BANKING77, que tiene 3.080 filas bajo licencia CC BY 4.0, y le pidió a cada uno de los 10 modelos que respondiera con una sola etiqueta de las 77 posibles. Nada de explicaciones, nada de texto extra: una etiqueta exacta o falla.
La corrida se hizo a temperatura 0, con hasta 2 reintentos cuando la respuesta no era una etiqueta válida, y contando el costo de cada intento (no solo el primero). Los precios se tomaron del listado de OpenRouter el 5/11/2026. Lo que más llama la atención: correr los 10 modelos contra las 150 tareas costó en total $0.58, según el artículo original de Grain64. Menos de un dólar para comparar diez LLMs en una tarea real, lo cual también dice algo: con ese presupuesto, no hay excusa para no correr tu propia validación antes de decidir en base a un ranking ajeno.
¿Cómo se mide el costo por tarea exitosa de un LLM más barato para clasificación bancaria?
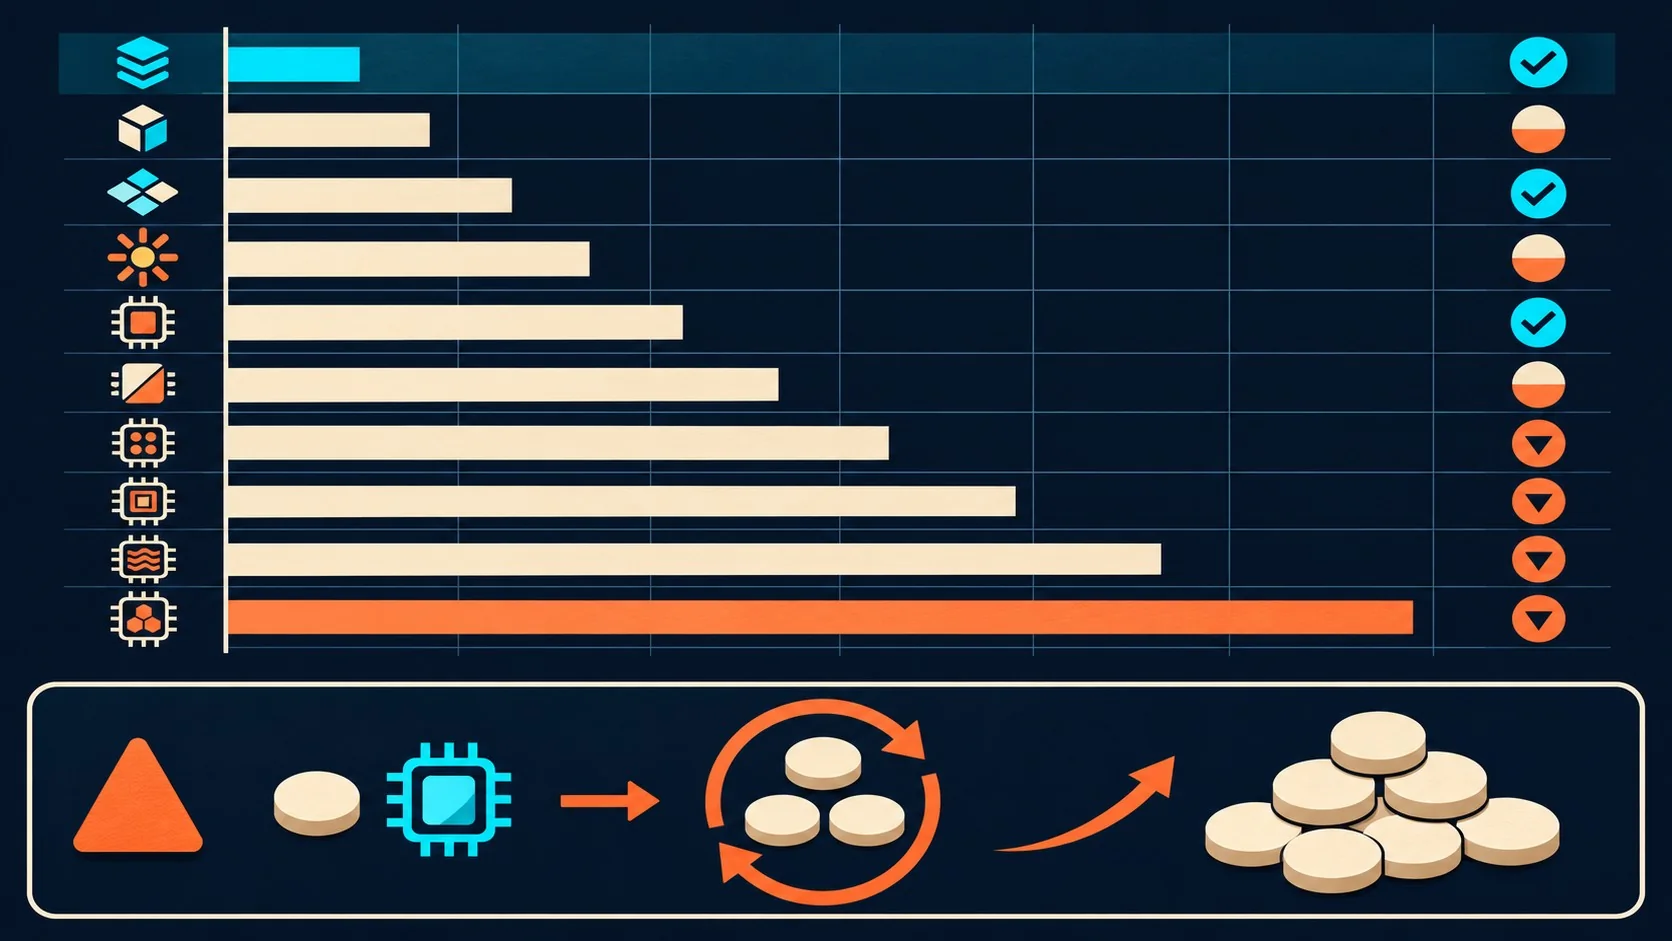
El costo por tarea exitosa se calcula dividiendo el gasto total en OpenRouter (incluyendo todos los reintentos) por la cantidad de tareas que efectivamente pasaron. Esta métrica reemplaza al precio por token, que ignora cuántos intentos necesitó cada modelo para llegar a una respuesta válida. Dicho en criollo: el precio de lista te dice cuánto cuesta pedirle algo al modelo, pero no cuánto te cuesta que el modelo te responda bien.
La barra de aprobación se fijó en 70% de aciertos. Un modelo “supera la barra” solo si el límite inferior de su intervalo de confianza de Wilson al 95% está en 70% o más. Si el intervalo cruza por debajo del umbral, queda “borderline”. Ahora bien, superar la barra no es lo mismo que igualar al modelo base: eso se mide con un test pareado que verifica si el modelo nuevo no es más de 5 puntos peor que el baseline en las mismas 150 tareas. Son dos afirmaciones distintas, y el verdict de Clearbar nombra específicamente la segunda para GPT-6.1 Terra. En nuestra guía completa de chatgpt profundizamos sobre esto.
¿Qué modelo resultó el más barato y cuál fue su precisión?
GPT-6.1 Terra acertó 126 de 150 tareas (84.0%, intervalo 77.3-89.0%) a $0.000727 por tarea exitosa, con 1.00 intentos promedio por tarea. El modelo base, GPT-6.1 Sol, acertó 129 de 150 (86.0%, intervalo 79.5-90.7%) a $0.001272. La diferencia de 2.0 puntos porcentuales entre ambos no alcanza para romper el margen de 5 puntos que exige el test pareado, así que Terra queda confirmado como match.
Dos modelos más baratos todavía merecen mención, aunque con matices. GPT-6 Luna pasa el 82.0% a $0.00009 por tarea exitosa (14 veces más barato que Sol), pero falló 8 tareas que Sol acertó y acertó 2 que Sol falló: con solo 150 filas, el test pareado no puede confirmar que esté dentro del margen de 5 puntos. Claude Haiku 5.5 pasa 80.0% a $0.000138, con la latencia más baja de toda la corrida (mediana de 249 ms), pero tampoco queda confirmado como match.
| Modelo | Pass rate | $ por tarea exitosa | Intentos por tarea | Estado |
|---|---|---|---|---|
| GPT-6.1 Sol (base) | 86.0% | $0.001272 | 1.00 | Supera la barra |
| GPT-6.1 Terra | 84.0% | $0.000727 | 1.00 | Supera, iguala a Sol |
| GPT-6 Luna | 82.0% | $0.000090 | 1.01 | Supera la barra |
| Claude Haiku 5.5 | 80.0% | $0.000138 | 1.03 | Supera la barra |
| DeepSeek V4.1 Flash | 78.7% | $0.000157 | 1.21 | Supera la barra |
| Qwen3.8 Flash | 77.3% | $0.000147 | 1.15 | Borderline |
| Gemini 3.5 Flash Lite | 75.3% | $0.000249 | 1.00 | Borderline |
| Llama 4 Maverick | 71.3% | $0.000125 | 1.00 | Borderline |
| Mistral Small (2603) | 68.0% | $0.000026 | 1.00 | Debajo de la barra |
| Mistral Large 4 | 63.3% | $0.002274 | 1.71 | Debajo de la barra |
¿Por qué los modelos más baratos en precio no siempre son los más baratos en uso?
Porque el precio por token no cuenta los reintentos, y los reintentos se pagan. DeepSeek V4.1 Flash superó la barra, pero necesitó 32 reintentos en las 150 tareas (1.21 intentos por tarea), terminó con 11 respuestas finales inválidas, y gastó el 31.3% de su presupuesto en reintentos. Resultado: su costo real por tarea exitosa ($0.000157) queda por encima del de Claude Haiku 5.5 ($0.000138), a pesar de tener un precio de token más bajo.
Qwen3.8 Flash gastó el 19.8% de su plata en reintentos y tuvo una latencia p95 de 6.7 segundos, nada despreciable si el caso de uso es atención al cliente en tiempo real. El caso extremo es Mistral Large 4: 106 reintentos en 150 tareas, 44.6% del gasto total en reintentos, y $0.002274 por tarea exitosa, la línea más cara de toda la tabla con apenas 63.3% de aciertos. Mistral Large 4 devolvió respuesta vacía en 45 de las 150 tareas, incluso después de los reintentos. Un modelo que falla por silencio, no por error de clasificación.
¿Y qué pasa si solo mirás el precio por token publicado? Exacto: pensás que Mistral Large 4 es una ganga y terminás pagando 3.1 veces más por acierto que con GPT-6.1 Terra. Ojo con eso al leer cualquier tabla de precios de LLMs: el número de lista y el número que termina en la factura pueden no tener nada que ver.
Ejemplo hipotético: ¿cuánto pesa esto en un volumen real de mensajes?
Nota: lo que sigue es un ejercicio numérico ilustrativo, no un dato medido por Clearbar ni por nadie. Usa los costos por tarea exitosa publicados en el benchmark, aplicados a un volumen inventado para que la diferencia se vea en pesos (o dólares) y no solo en porcentajes.
Pensemos en una fintech ficticia que clasifica automáticamente 20.000 mensajes de soporte por mes según su intención, usando el mismo tipo de etiquetas que BANKING77. Con GPT-6.1 Sol, y asumiendo que el costo por tarea exitosa se mantiene estable a ese volumen, el gasto rondaría los 20.000 × $0.001272 ≈ $25,44. Con GPT-6.1 Terra, el mismo volumen saldría 20.000 × $0.000727 ≈ $14,54: una diferencia de casi $11 mensuales, a cambio de resignar 2 puntos de pass rate (84.0% contra 86.0%) que el test pareado del benchmark no considera significativos.
Once dólares por mes no suena a gran ahorro en una fintech chica. Pero multiplicá ese volumen por diez (200.000 mensajes) y la diferencia pasa a rondar los $110 mensuales, sin tocar la calidad del servicio según la misma métrica. Ahí es donde el cálculo deja de ser anecdótico: la pregunta relevante no es “¿cuánto cuesta cada llamada?” sino “¿cuánto cuesta mi volumen real, con los reintentos que mi caso de uso efectivamente genera?”. Y esa cuenta solo la hacés corriendo tus propios mensajes, no extrapolando de 150 filas públicas.
¿Qué errores cometió GPT-6.1 Terra al clasificar los mensajes?
Los errores de Terra son mayormente confusiones entre etiquetas semánticamente cercanas, no fallas groseras de comprensión. Para el mensaje “How long does a card delivery take?”, Terra respondió card_delivery_estimate cuando la etiqueta correcta era card_arrival. Para “When will the card arrive?” pasó lo inverso: respondió card_arrival cuando la etiqueta esperada era card_delivery_estimate.
Ambas lecturas son razonables desde el punto de vista humano. En una tarea de 77 etiquetas, buena parte de los errores son casos límite donde la frontera entre dos categorías es difusa. Esto importa para quien evalúa el modelo con sus propios datos: la pregunta de “qué modelo elegir” depende de qué tan estrictas sean tus etiquetas y dónde pongas la barra, no de un ranking genérico. Si tus propias categorías tienen ese mismo tipo de solapamiento semántico (por ejemplo, “reclamo de cargo” versus “reclamo de cargo no reconocido”), conviene asumir de entrada que ningún modelo de esta lista va a llegar a 100%, y diseñar el flujo con una instancia de revisión humana para los casos límite.
Criterios para decidir si te conviene migrar de modelo
Más allá del ranking puntual de este benchmark, los datos de Clearbar dejan un método que sirve para cualquier migración de modelo, no solo para BANKING77. Antes de cambiar de proveedor en producción, conviene chequear estos cuatro puntos con tus propios ejemplos:
- Costo por tarea exitosa, no precio por token. Pedí (o calculá) el gasto total incluyendo reintentos, dividido por las tareas que realmente pasaron. Un modelo con precio de lista bajo puede terminar siendo el más caro de la tabla, como le pasó a Mistral Large 4 en este benchmark.
- Si el nuevo modelo “iguala” al que ya usás, no solo si “supera una barra”. Son pruebas distintas: superar un umbral mínimo de calidad no implica que el reemplazo rinda igual que tu modelo actual en las mismas tareas. Pedí el test pareado, no solo el pass rate.
- Latencia p95, no solo la mediana. Qwen3.8 Flash tenía buen pass rate pero una cola de latencia de 6.7 segundos en el peor 5% de los casos; eso puede ser inaceptable en un chat en vivo aunque la mediana sea decente.
- Tamaño de la muestra de validación. Con 150 filas, varios intervalos de confianza se superponen entre modelos consecutivos de la tabla. Si vas a decidir con tus propios datos, 100 ejemplos representativos de tu dominio real pesan más que un ranking genérico armado con mensajes en inglés de un dataset ajeno.
¿Se puede repetir este benchmark con datos propios?
Sí. El script de re-run, el prompt exacto y los precios usados están publicados en la página de verdict de clearbar.grain64.com, junto con el dataset de 150 filas en formato JSONL. Correr la comparación completa con los 10 modelos costó $0.58, así que replicarla con tu propia clave de OpenRouter no es una inversión grande.
Clearbar ofrece además una versión de acceso anticipado gratuito donde se pueden importar entre 10 y 100 pares de entrada/salida esperada propios, elegir hasta 6 modelos (incluyendo el que ya se usa) y obtener un verdict nombrado con costo por tarea exitosa, reintentos contados y ejemplos de fallas. Las llamadas a OpenRouter se pagan con clave propia; el análisis en sí no tiene costo en esta etapa.
Qué está confirmado y qué no
- Confirmado: GPT-6.1 Terra supera la barra del 70% y el test pareado muestra que no es más de 5 puntos peor que GPT-6.1 Sol, con p < 0.0001 según los datos publicados.
- Confirmado: el costo por tarea exitosa de Terra es $0.000727, un 42.8% menos que Sol, medido sobre las mismas 150 tareas.
- No confirmado: que estos resultados se mantengan en un dataset con etiquetas propias distintas a BANKING77, o con volúmenes de mensajes mucho mayores a 150. El cálculo de la sección anterior sobre 20.000 mensajes es una extrapolación propia, no una medición.
- No confirmado: que los precios de OpenRouter se mantengan estables; la propia página de verdict advierte que los precios cambian mes a mes.
Preguntas Frecuentes
¿Qué es GPT-6.1 Terra?
GPT-6.1 Terra es un modelo de lenguaje de la familia GPT-6.1 de OpenAI, evaluado en un benchmark de clasificación de intenciones bancarias donde acertó el 84.0% de 150 tareas a $0.000727 por tarea exitosa. Es la opción más barata que, además de superar la barra de aprobación, iguala estadísticamente al modelo base GPT-6.1 Sol.
¿Cuánto cuesta clasificar intenciones bancarias con inteligencia artificial?
Depende del modelo: en este benchmark el rango va desde $0.000026 por tarea exitosa (Mistral Small 2603, que queda debajo de la barra de calidad) hasta $0.002274 (Mistral Large 4). El modelo recomendado, GPT-6.1 Terra, cuesta $0.000727 por tarea exitosa.
¿Qué es el benchmark BANKING77?
BANKING77 es un dataset público de mensajes de clientes bancarios, con licencia CC BY 4.0, diseñado para clasificar cada mensaje en una de 77 etiquetas de intención distintas. Su split de test tiene 3.080 filas, de las cuales el benchmark de Clearbar usó 150 con semilla fija.
¿Por qué el precio por token no refleja el costo real de un LLM?
Porque no cuenta los reintentos necesarios cuando el modelo devuelve una respuesta inválida o vacía. DeepSeek V4.1 Flash, por ejemplo, gastó el 31.3% de su presupuesto en reintentos, lo que hizo que su costo real por tarea exitosa superara al de Claude Haiku 5.5 a pesar de tener un precio de token más bajo.
¿Qué modelo de IA es más barato que GPT-6.1 Sol para clasificación de intenciones?
GPT-6.1 Terra es 42.8% más barato que Sol por tarea exitosa ($0.000727 contra $0.001272) y mantiene un pass rate estadísticamente equivalente. GPT-6 Luna es todavía más barato ($0.00009), pero no está confirmado que iguale el desempeño de Sol en el mismo test pareado.
Conclusión
Lo que cambia con este benchmark es el punto de referencia para decidir qué modelo usar en clasificación bancaria: ya no alcanza con mirar el precio por token de una lista de OpenRouter, hay que medir el costo por tarea exitosa con reintentos incluidos. GPT-6.1 Terra queda como la opción que recorta un 42.8% el gasto de Sol sin perder equivalencia estadística, mientras que GPT-6 Luna es la alternativa a explorar si tu caso de uso tolera una caída de pass rate sin garantía de match.
Si tu empresa clasifica mensajes de clientes a volumen, el ejercicio concreto —y barato, como mostró el cálculo hipotético de más arriba— es correr tu propio set de 100 ejemplos contra 3 o 4 modelos candidatos antes de migrar en producción. El experimento completo de Clearbar costó $0.58: replicarlo con tus etiquetas reales sale más barato que una hora de debate interno sobre qué modelo conviene.