
En pocas palabras: Nodast, de Rafa San Pablo González, empata con un agente de texto bien armado en ediciones simples (772 vs. 581 tokens de entrada), pero gana en cambios estructurales: hasta 4,5 veces más barato al agregar un parámetro en 200 llamadas, y evita romper variables similares al renombrar.
Rafa San Pablo González, creador de Nodast, probó editar código con un árbol AST en vez de texto. Contra reescribir el archivo completo, ganó hasta 30 veces en costo. Contra un agente de texto bien armado, con grep, read y replace, empató en ediciones simples y ganó solo en renombrados y cambios que tocan muchos lugares. Lo interesante no es tanto el resultado final, sino que el propio autor desarmó su primer título llamativo cuando se dio cuenta de que la comparación no era justa. Eso, en un ecosistema donde cada benchmark parece diseñado para vender la herramienta, ya dice algo.
Nodast (Node + AST) es un formato experimental de edición de código con IA creado por Rafa San Pablo González y publicado en GitHub bajo licencia MIT. En vez de que el modelo reescriba texto, edita un árbol de sintaxis abstracta mediante S-expressions cortas; un checker con inferencia Hindley-Milner valida cada cambio antes de que un printer determinista genere el código TypeScript final.
En este artículo:
- En 30 segundos
- ¿Qué es la edición de código con IA basada en árboles, como la que propone Nodast?
- ¿Por qué la primera comparación de Nodast fue injusta?
- ¿Qué pasó cuando se comparó Nodast contra un agente de texto con buenas herramientas?
- ¿En qué casos la edición de código con IA basada en estructura tipo árbol gana frente al texto plano?
- ¿Qué limitaciones tiene Nodast hoy?
- ¿Qué sigue para el proyecto Nodast?
- Errores comunes al evaluar formatos de edición de código con IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- En una edición simple de una sola constante, Nodast empató con el agente de texto: 772 tokens de entrada contra 581, mismo tiempo (4,5-4,6 s).
- Renombrar una variable en un programa de 400 pasos salió más barato con Nodast: 907 in / 55 out en 4,4 s, contra 1.187 in / 80 out en 6,7 s del agente de texto.
- Agregar un parámetro en 200 llamadas costó unas 4,5 veces menos con Nodast: 2.182 in / 136 out contra 12.045 in / 174 out.
- El propio benchmark destapó un bug del checker: al sumar inferencia Hindley-Milner completa, los aciertos de escritura desde cero pasaron de 55/60 a 60/60.
- Nodast es de código abierto (MIT), vive en GitHub como R4F405/Nodast y tiene un motor espejo escrito en Rust.
¿Qué es la edición de código con IA basada en árboles, como la que propone Nodast?
La edición de código con IA basada en árboles consiste en que el modelo no toca texto directamente: propone cambios sobre nodos de un árbol de sintaxis, y un checker decide si esos cambios son válidos antes de que exista una sola línea de código fuente. Nodast lo implementa así: el modelo escribe S-expressions cortas, del tipo (let x (add 1 2) x), un checker con tipado Hindley-Milner las acepta o rechaza, y recién ahí un printer determinista las convierte en TypeScript real.
Para editar (no para escribir desde cero), cada nodo del árbol tiene un id, algo como n4:(add n5:v0 n6:7). El modelo trabaja con tres herramientas nada más: find para localizar nodos, show para ver un nodo y sus hijos, y edit para reemplazar, insertar, borrar, renombrar o agregar un parámetro. Un detalle clave: si el checker rechaza una edición, nada cambia en el archivo, lo que evita el típico problema de un parche a medio aplicar que te deja el código roto. Cubrimos ese tema en detalle en cómo funciona Claude en profundidad.
¿Qué es un diff estructurado y en qué se diferencia de un diff de texto plano?
Un diff estructurado edita nodos de un árbol que el modelo entiende como funciones, variables o llamadas, mientras que un diff de texto plano busca y reemplaza cadenas de caracteres sin saber si esa cadena aparece en otro lugar sin relación. Según el repositorio de Nodast en GitHub, esa diferencia es justamente la que explica por qué un replace-all de texto puede romper algo que no tenía nada que ver con el cambio pedido.
El ejemplo que usa el propio autor es elocuente: si tenés una variable rate y otra llamada rate_cap justo al lado, un agente de texto que haga replace-all de rate por scale termina convirtiendo rate_cap en scale_cap sin querer. Nodast, como sigue el scope real del árbol, nunca toca rate_cap.
Ejemplo hipotético: pensemos en un sistema de facturación cualquiera, con una variable cuota para el monto que paga cada cliente y otra, cuota_mora, para el recargo por pago tardío. Si alguien le pide a un agente de texto que renombre cuota a importe en todo el proyecto y ese agente resuelve el pedido con un replace-all literal, lo más probable es que cuota_mora termine convertida en importe_mora sin que nadie lo haya pedido. Según la lógica que describe el benchmark de Nodast, un sistema que sigue el árbol de scopes evitaría ese efecto colateral porque solo tocaría los usos que realmente resuelven a la variable cuota, no cualquier cadena que contenga esas letras.
¿Por qué la primera comparación de Nodast fue injusta?
La primera comparación fue injusta porque midió Nodast contra algo que nadie hace en serio: reescribir el archivo entero. En un archivo TypeScript de 500 líneas, cambiar una sola constante con Nodast costó 1.122 tokens de entrada y 57 de salida, en 4,5 segundos; reescribiendo el archivo completo fueron 5.559 de entrada y 5.513 de salida, en 36 segundos. Cien veces menos output, título llamativo, pero comparación floja.
El problema es simple: ningún agente de código serio edita reescribiendo el archivo entero. Al momento del benchmark, los agentes usaban grep, read y un replace de texto, según describe el posteo original en Dev.to. Comparar contra la reescritura completa es como comparar un auto de Fórmula 1 contra una carreta: gana, sí, pero no te dice nada útil sobre qué pasa contra un rival real. Y esto importa más allá de Nodast: cualquier benchmark de una herramienta nueva que no se moleste en construir el baseline más competitivo posible está, básicamente, midiendo contra la carreta. Vale la pena quedarse con esa sospecha metodológica la próxima vez que alguien te muestre un gráfico de barras espectacular.
¿Qué pasó cuando se comparó Nodast contra un agente de texto con buenas herramientas?
Contra un baseline justo, con el mismo archivo TypeScript, el mismo loop de herramientas y el mismo presupuesto de llamadas, Nodast empató. En el cambio de una sola constante en el archivo de 500 líneas, el agente de texto con grep, read y replace (con opción de replace-all y diagnósticos después de cada edición) usó 581 tokens de entrada contra 772 de Nodast, con el mismo output y el mismo tiempo.
¿Y entonces de dónde venía el ahorro que parecía tan grande al principio? De editar en partes en vez de reescribir todo, no del formato árbol en sí. Esa es la lección incómoda que el propio autor reconoce: un agente de texto con buenas herramientas consigue el mismo ahorro que Nodast en una edición puntual. El formato árbol, en ese caso, no aporta nada extra, y de hecho su prompt fijo pesa un poco más.
Esto deja un criterio que sirve más allá de este proyecto puntual: antes de evaluar si un formato nuevo (árbol, grafo, lo que sea) te conviene, hay que separar dos cosas que suelen venir mezcladas en el marketing de cualquier herramienta: el mecanismo que realmente ahorra recursos (en este caso, editar en pedazos chicos) y el empaquetado que lo presenta (en este caso, el árbol AST). Si el mecanismo de fondo ya lo tenés resuelto con tus herramientas actuales, pagar la complejidad de adoptar un formato nuevo entero por el mismo resultado no cierra. Complementá con seguir las sesiones de código en remoto.
¿En qué casos la edición de código con IA basada en estructura tipo árbol gana frente al texto plano?
El árbol gana en cambios que tocan muchos lugares a la vez y necesitan entender el scope del código, no en ediciones puntuales. Los dos casos medidos son renombrar una variable que convive con otra de nombre parecido, y agregar un parámetro a una función llamada muchas veces. Ahí es donde el texto plano empieza a sufrir, aunque tenga buenas herramientas.
Pensalo así: vos le pedís a tu agente que renombre rate a scale en un programa de 400 pasos, el agente hace un replace-all porque es lo más rápido, rompe rate_cap sin querer, se da cuenta, lo arregla, y recién ahí termina, todo eso mientras Nodast resolvió lo mismo en una sola edición sin tocar nada que no debía tocar.
Con gpt-6.1-sol, 5 corridas por tarea y todas las variantes correctas en cada corrida, a un costo de USD 2 por millón de tokens de entrada y USD 10 por millón de salida, estos fueron los números:
| Tarea | Nodast (herramientas) | Agente de texto (herramientas) | Reescritura completa |
|---|---|---|---|
Renombrar en 400 pasos, junto a rate_cap | 4,4 s · 907 in / 55 out | 6,7 s · 1.187 in / 80 out | 29 s · 4.975 in / 4.927 out |
| Agregar parámetro, 200 llamadas | 9,1 s · 2.182 in / 136 out | 13,7 s · 12.045 in / 174 out | 35 s · 7.432 in / 5.668 out |
| Cambiar una constante, 500 líneas | 4,6 s · 772 in / 61 out | 4,5 s · 581 in / 67 out | 33 s · 5.559 in / 5.513 out |
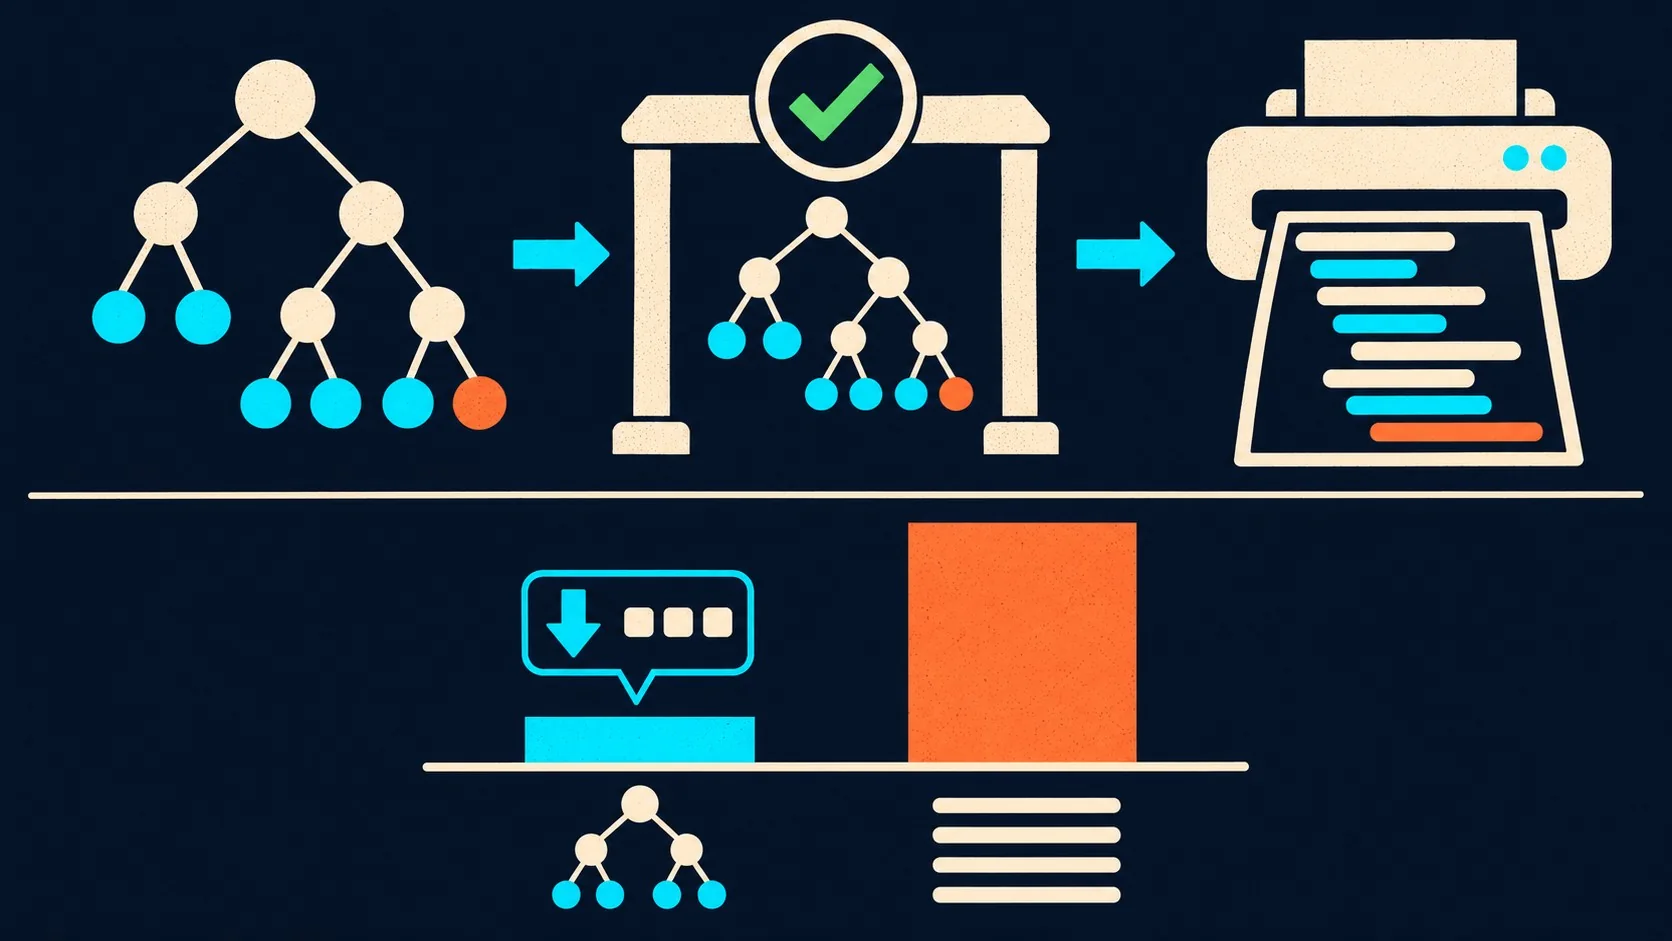
Agregar un parámetro en 200 llamadas salió unas 4,5 veces más barato con Nodast que con el agente de texto. El renombrado también fue más rápido y más barato, aunque la diferencia varió bastante entre corridas: el agente de texto a veces lo resolvió en 2 llamadas y otras veces necesitó 5, según detalla el README del proyecto.
Ejemplo hipotético: imaginemos una función calcularEnvio que un e-commerce llama en 200 puntos distintos del checkout, cada llamada con sus propios parámetros de peso y destino. Si mañana el negocio decide sumar un cupón de descuento y hay que agregarle un argumento nuevo a esa función en cada uno de esos 200 lugares, un agente de texto no puede resolverlo con un simple replace-all porque cada llamada es distinta; tendría que visitar call site por call site. Siguiendo la lógica que mide este benchmark para la tarea de param, un enfoque que entiende la estructura del código resolvería ese mismo pedido en una sola edición que actualiza la función y sus 200 llamadas de una vez, en vez de 200 intervenciones manuales.
¿Qué limitaciones tiene Nodast hoy?
Nodast todavía no sirve para programas reales porque su lenguaje es chico a propósito: números, booleanos, let, funciones, llamadas e if. Nada de strings, listas ni records por ahora. El benchmark, además, es sintético: cadenas largas de let y llamadas repetidas pensadas para aislar un tipo de edición a la vez, no código de un proyecto real. Relacionado: diferencias entre los modelos Sonnet y Opus.
Hubo un bug concreto que el propio benchmark dejó al descubierto. Escribiendo programas chicos desde cero, Nodast acertó 55 de 60 veces al primer intento, contra 60/60 de TypeScript plano. Las cinco fallas eran siempre la misma: el modelo escribía (fn (f) (f 5)), un programa perfectamente válido, y el checker lo rechazaba como “tipo ambiguo” porque no tenía genéricos. La “solución” fácil hubiera sido parchar el caso puntual, pero el autor fue por el camino correcto y reemplazó el checker por inferencia Hindley-Milner completa: una función ligada con let pasa a ser genérica, y ahí sí, 60/60 al primer intento, con 23 tokens de salida contra 25 de TypeScript. El modelo, eso sí, nunca escribe anotaciones de tipo.
Los resultados principales se midieron con un solo modelo fuerte, gpt-6.1-sol. MiniMax se usó durante el desarrollo, pero no entró en la tabla final. Un solo modelo no alcanza para sacar conclusiones generales, y vale tenerlo presente antes de citar estos números como si fueran una verdad universal sobre cualquier LLM.
¿Qué sigue para el proyecto Nodast?
Lo que viene, según el propio autor, es crecer el lenguaje hacia programas reales: strings, listas y records. También suma operaciones estructurales nuevas, como extraer una expresión a un let, y pide resultados con más modelos (un proveedor de Claude para el benchmark está marcado como “good first issue” en el repositorio).
El código, el benchmark y una demo offline (con pnpm demo, sin necesidad de API key) están publicados en GitHub bajo R4F405/Nodast, con licencia MIT. El motor de referencia está en TypeScript, pero hay una versión espejo escrita en Rust para quien prefiera ese stack.
Errores comunes al evaluar formatos de edición de código con IA
- Comparar contra la reescritura completa del archivo como si fuera el estándar actual. Casi ningún agente de producción reescribe archivos enteros; el baseline real es grep + read + replace, y contra eso las diferencias se achican mucho.
- Asumir que un formato estructural siempre gana por ser “más inteligente”. En una edición puntual, como cambiar una constante, Nodast empató con el agente de texto. La ganancia aparece solo en cambios que tocan muchos lugares a la vez.
- Confundir ahorro de tokens con mejora de calidad del código generado. Los benchmarks de este proyecto son sintéticos y miden costo y velocidad, no si el resultado final es mantenible en un proyecto real con strings, listas o records.
- Tomar un benchmark con un solo modelo como si fuera representativo de todos. Los números de la tabla salen de
gpt-6.1-sol; con otro modelo los tiempos y costos pueden moverse bastante.
Un criterio práctico, si estás evaluando si te conviene meter edición estructural en tu propio pipeline: corré tu agente de texto actual contra la misma tarea con el mismo presupuesto de llamadas, pero elegí específicamente una tarea de refactor que toque muchos lugares (un rename con nombres parecidos cerca, por ejemplo). Si ahí no ganás nada, probablemente la complejidad de armar un checker y un árbol propio no te cierre. Dicho de otra forma: no adoptes un formato nuevo por el ahorro que ya conseguís editando en pedazos chicos; adoptalo solo si tu caso de uso real se parece al rename o al param de este benchmark, con cambios que se repiten en decenas de lugares a la vez.
Preguntas Frecuentes
¿Qué es Nodast y para qué sirve?
Nodast es un formato experimental, creado por Rafa San Pablo González, que permite que un LLM edite código como un árbol de sintaxis en vez de como texto. Sirve para que el modelo proponga cambios estructurales (renombrar variables, agregar parámetros) que un checker valida antes de generar el código fuente final.
¿Por qué un LLM editando un árbol AST es mejor que reescribir el archivo?
Porque evita regenerar código que no cambió. En el benchmark de Nodast, cambiar una constante en un archivo de 500 líneas costó 772 tokens de entrada contra 5.559 de reescribir el archivo completo. Eso sí: contra un agente de texto bien armado con grep y replace, esa ventaja se achica a un empate.
¿En qué casos conviene usar edición estructural en vez de buscar y reemplazar texto?
Conviene cuando el cambio toca muchos lugares y depende del scope, como renombrar una variable que convive con otra de nombre parecido o agregar un parámetro a una función llamada cientos de veces. En esos casos, Nodast midió hasta 4,5 veces menos costo que un agente de texto equivalente.
¿Cuánto ahorra en tokens usar un formato de árbol para editar código?
Depende de la tarea: en una edición puntual no ahorra nada relevante (772 contra 581 tokens de entrada, prácticamente un empate). En agregar un parámetro a 200 llamadas, en cambio, el ahorro fue de 2.182 contra 12.045 tokens de entrada, unas 4,5 veces menos.
¿Nodast es de código abierto?
Sí, Nodast tiene licencia MIT y está publicado en GitHub como R4F405/Nodast. Incluye una demo offline que corre sin API key con el comando pnpm demo, y un motor espejo escrito en Rust además del TypeScript de referencia.
Conclusión
Lo que este experimento deja claro es que la edición de código con IA basada en árboles no es una bala de plata, y el propio autor lo admite en vez de venderla como tal (algo que no es tan común en este tipo de proyectos). Contra un agente de texto bien armado, la ventaja del árbol desaparece en ediciones puntuales y solo reaparece cuando el cambio toca muchos lugares y depende de entender el scope del código.
Si trabajás con agentes de código hoy, el dato útil no es “los árboles ganan”: es que la mayor parte del ahorro de tokens viene de editar en pedazos en vez de reescribir todo, algo que cualquier agente de texto decente ya puede hacer con las herramientas correctas. La edición estructural suma valor real recién en refactors que tocan decenas o cientos de lugares a la vez, como el rename o el agregado de parámetros medidos en este benchmark. Para todo lo demás, por ahora, un buen grep y un buen replace alcanzan. Y si alguna vez te ofrecen un benchmark con un solo número espectacular, preguntate primero contra qué lo compararon.