
En pocas palabras: No, reemplazar el modelo no alcanza. Según el análisis de dev.to del 6 de noviembre de 2026, los equipos que cambiaron GPT-4 por el modelo más nuevo sin modificar diseño de herramientas, manejo de fallos y observabilidad obtuvieron resultados igual de malos.
Un análisis publicado el 6 de noviembre de 2026 en dev.to sostiene algo incómodo: cambiar de modelo no arregla un agente de IA roto. El problema está en la arquitectura de agentes de IA, en el diseño de herramientas, el manejo de fallos y la observabilidad, no en qué LLM usás.
La arquitectura de agentes de IA es el conjunto de decisiones de diseño que determinan cómo un sistema basado en modelos de lenguaje elige qué hacer, maneja errores y sabe cuándo terminó una tarea. El modelo subyacente no define esa arquitectura, tampoco el framework que lo orquesta (LangChain, LangGraph o CrewAI). La definen el diseño de herramientas, el flujo de planificación y ejecución, y la forma en que el sistema recupera y usa el contexto.
En este artículo:
- En 30 segundos
- ¿Qué significa que un sistema sea un “agente de IA”?
- ¿Por qué cambiar de modelo no arregla un agente de IA que falla?
- Cómo diagnosticar tu propio caso antes de tocar nada
- ¿Qué patrones de arquitectura de agentes de IA funcionan en producción, más allá del framework?
- ¿Por qué el RAG devuelve resultados “técnicamente correctos pero inútiles”?
- ¿Qué deberían priorizar los equipos que construyen agentes de IA hoy?
- Errores comunes al diseñar un agente de IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un agente de IA de verdad tiene un objetivo, no una instrucción: decide el próximo paso, maneja fallos y sabe cuándo terminó, según el análisis publicado en dev.to el 6 de noviembre de 2026.
- Reemplazar GPT-4 por el modelo más nuevo sin tocar el diseño de herramientas da los mismos resultados.
- Tres patrones funcionan en cualquier framework: separar planificación de ejecución, separar retrieval de reasoning y hacer handoffs explícitos entre agentes.
- El chunking mal hecho en RAG devuelve resultados técnicamente correctos pero inútiles porque corta el contexto justo donde no debería.
- Antes de tocar el modelo o el chunking, conviene diagnosticar el síntoma: no es lo mismo un agente que inventa datos que uno que se traba en loop.
¿Qué significa que un sistema sea un “agente de IA”?
Un agente de IA es un sistema con un objetivo, no una instrucción: decide qué hacer a continuación, recupera el control cuando algo falla y sabe identificar cuándo terminó la tarea. Todo lo demás, según el análisis de dev.to, es una función con nombre bonito.
A fines de 2026, cualquier cosa se llama “agente”. Una función que llama a una herramienta, un chatbot con memoria, un script con un loop, todo entra en la misma bolsa. Esa dilución no es solo un problema de marketing. Lleva a errores de ingeniería reales: equipos que meten semanas de orquestación “agentic” sobre un pipeline que andaba bien con un prompt bien armado, y equipos que subestiman sistemas que sí necesitan esa complejidad (spoiler: la mayoría de lo que la gente llama agente en LinkedIn no pasa del primer nivel). En armar una recepcionista virtual con n8n profundizamos sobre esto.
- Interfaz de chat: si el sistema necesita que un humano le diga cada paso, no es un agente, es un chat con pasos extra.
- Recuperación de fallos: si el sistema puede fallar al llamar una herramienta y probar otra cosa en vez de romperse, ahí empieza a haber algo real.
- Descomposición de tareas: si puede partir un objetivo en subtareas y delegarlas, eso es lo que el análisis llama “la cosa real”.
Un criterio rápido para no perder tiempo discutiendo semántica: si podés escribir el flujo completo como un diagrama de flujo con un único camino (sin bifurcaciones que dependan de una decisión del sistema), no es un agente, es una automatización con un LLM adentro. No hace falta orquestación “agentic” para eso, y forzarla solo agrega puntos de falla.
¿Por qué cambiar de modelo no arregla un agente de IA que falla?
Cambiar de modelo no arregla un agente de IA que falla porque el problema casi nunca está en la capacidad de razonamiento del LLM. Está en el diseño de herramientas, en qué pasa cuando una herramienta devuelve basura y en si podés trazar por qué el agente tomó la decisión que tomó.
Según el análisis en dev.to, los equipos que consiguen buenos resultados no persiguen el último lanzamiento de modelo. Se obsesionan con tres cosas:
- Diseño de herramientas: qué puede llamar el agente y qué tan limpia es esa interfaz.
- Manejo de fallos: qué hace el sistema cuando una herramienta no devuelve nada útil.
- Observabilidad: si podés trazar por qué el agente decidió lo que decidió.
Los equipos con malos resultados hicieron otra cosa: reemplazaron GPT-4 por el modelo frontera más nuevo y esperaron un comportamiento distinto sin cambiar nada más en el sistema. ¿Funcionó? No. El modelo nuevo heredó los mismos problemas de arquitectura que tenía el viejo, porque el problema nunca estuvo ahí.
Cómo diagnosticar tu propio caso antes de tocar nada
Antes de decidir si el problema es el modelo, el chunking o la arquitectura, conviene separar el síntoma de la causa. No es lo mismo un agente que se queda trabado repitiendo el mismo paso que uno que responde con datos inventados. Esta tabla no sale de ninguna de las dos fuentes citadas tal cual: es una forma de ordenar lo que ambas describen por separado, pensada para decidir por dónde empezar a mirar.
- El agente responde con datos que no están en ningún documento: la causa probable es chunking que separó la información de su contexto necesario. Primero hay que revisar los límites del chunk y la metadata, no el modelo de embeddings.
- El agente se queda repitiendo el mismo paso sin avanzar: la causa probable es manejo de fallos ausente o mal diseñado. Primero hay que revisar qué hace el sistema cuando una herramienta devuelve un error o un vacío.
- No hay forma de saber por qué el agente tomó una decisión puntual: la causa probable es falta de observabilidad. Primero hay que instrumentar el trazado de decisiones antes de cambiar cualquier otra pieza.
- El agente funciona en la demo pero falla con casos reales del negocio: la causa probable es que el sistema nunca necesitó ser un agente. Primero hay que revisar si el flujo real tiene bifurcaciones que justifiquen una capa de decisión, o si un pipeline lineal alcanzaba.
- Cambiaste de modelo y el problema sigue igual: confirma que la causa nunca estuvo en el modelo. Primero hay que mirar diseño de herramientas y manejo de fallos, en ese orden.
La lógica detrás de esta tabla es simple: el síntoma te dice en qué capa del sistema mirar primero, no cuál arreglar en abstracto. Mirar la capa equivocada es la forma más común de gastar semanas “mejorando” algo que no era el problema.
¿Qué patrones de arquitectura de agentes de IA funcionan en producción, más allá del framework?
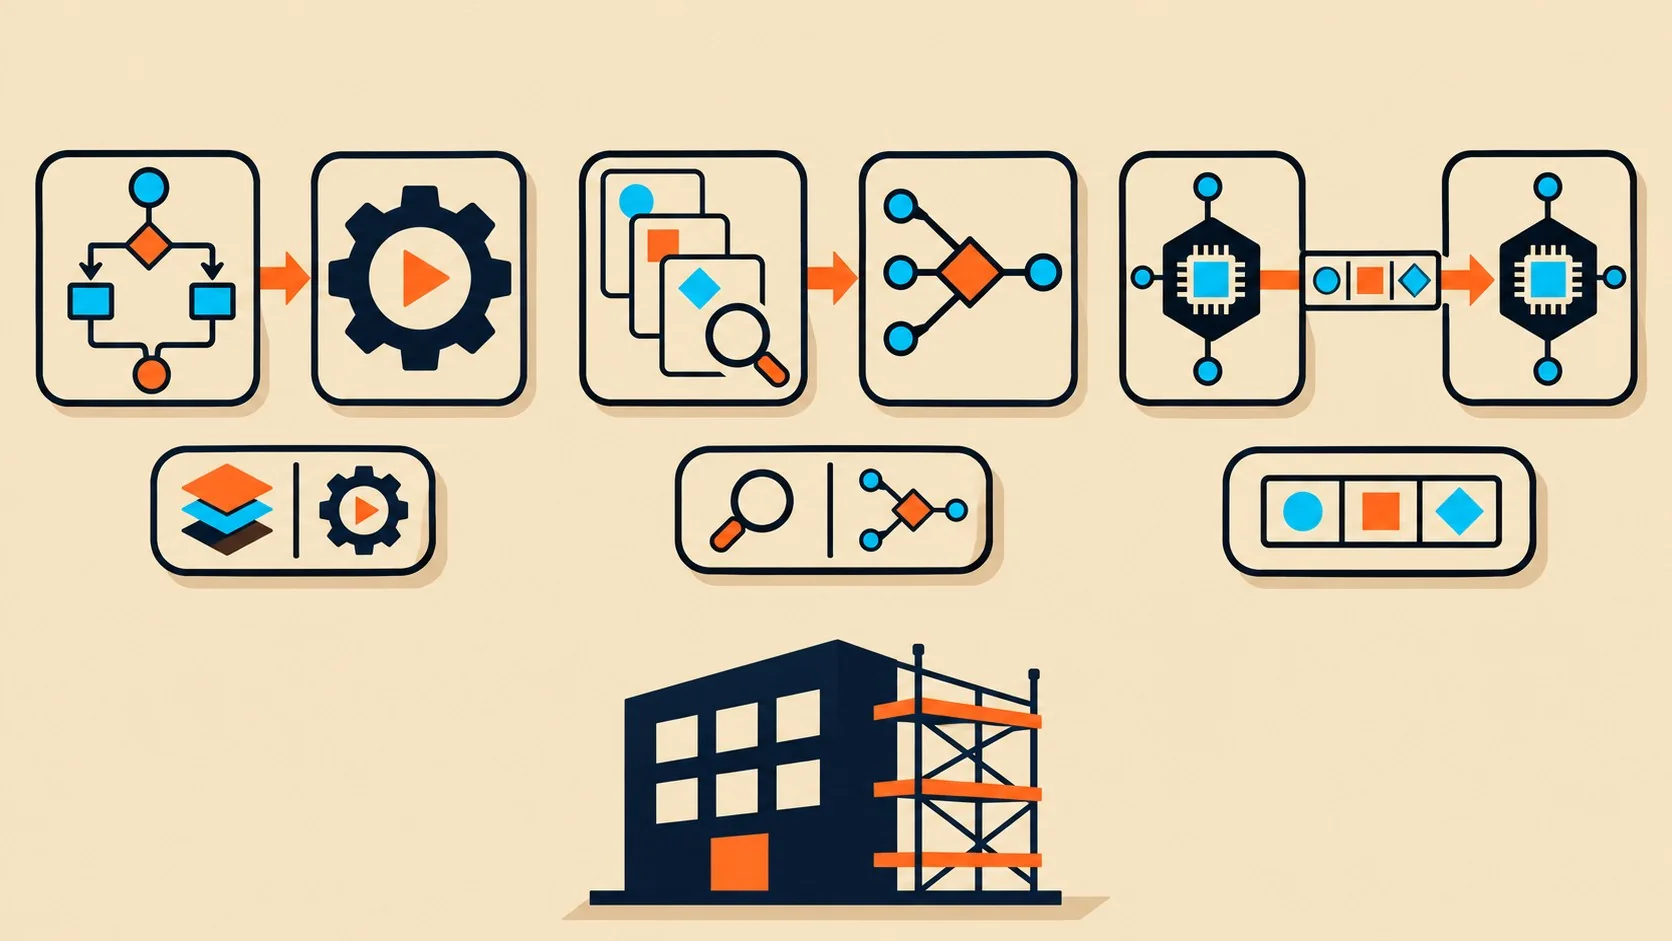
Tres patrones se repiten en cualquier stack que funcione en producción: separar planificación de ejecución, separar retrieval de reasoning y hacer handoffs explícitos entre agentes. El framework que elijas (LangChain, LangGraph, CrewAI, AutoGen, Semantic Kernel) importa menos que estos tres patrones.
La guerra de frameworks es ruido. Cada mes aparece una “solución definitiva” nueva y alguien escribe por qué la anterior ya murió. Lo que importa es el patrón, no la herramienta que lo implementa. Ya lo cubrimos antes en los riesgos de seguridad en agentes de IA.
- Plan-then-execute: un paso de razonamiento produce el plan, un paso separado lo ejecuta. No se mezclan.
- Retrieval separado del reasoning: buscar contexto y usar contexto son trabajos distintos. Mezclarlos confunde al sistema.
- Handoffs explícitos: cuando un agente le pasa trabajo a otro, ese traspaso queda estructurado y registrado, no es un string metido en un prompt.
El autor del análisis cuenta que reconstruyó la misma arquitectura en tres frameworks distintos (sí, en serio), con resultados parecidos en los tres casos, lo que confirma algo que cualquiera que haya migrado un proyecto de LangChain a LangGraph sospechaba: el framework es andamiaje, la arquitectura es el edificio.
Un criterio práctico para aplicar estos tres patrones sin perderse: si en tu sistema el paso que “piensa” y el paso que “ejecuta” viven en la misma función, separalos aunque sea artificialmente al principio. Lo mismo con retrieval y reasoning. Y si un agente le pasa trabajo a otro con un string suelto en el prompt, convertí ese traspaso en un objeto estructurado con campos fijos (qué se pide, con qué datos, qué se espera de vuelta), aunque al principio parezca sobreingeniería para un caso simple.
¿Por qué el RAG devuelve resultados “técnicamente correctos pero inútiles”?
El RAG devuelve resultados técnicamente correctos pero inútiles cuando los límites del chunk cortan el contexto en el lugar equivocado: un párrafo que solo tiene sentido junto al anterior se recupera aislado, y el modelo inventa lo que falta.
Ejemplo hipotético (ilustrativo, no un caso real): imaginá un contrato de alquiler partido en fragmentos fijos de 500 tokens cada uno. La cláusula 7 dice “en ese caso, el inquilino deberá notificar dentro de los 10 días hábiles”, pero “ese caso” se define en la cláusula 4, tres párrafos antes, que quedó en otro chunk. Si el usuario pregunta “¿cuántos días tengo para notificar?”, el sistema recupera la cláusula 7 sola, sin la 4. El modelo ve la referencia “en ese caso” sin saber a qué caso se refiere, y tiene dos salidas: contestar de forma vaga o completar el hueco con una suposición que puede ser incorrecta. En ningún momento falló el embedding ni el modelo “no entendió”: el chunk que se guardó estaba incompleto desde el principio.
Según la guía de Víctor Mollá en GuruSup, el chunk es la unidad mínima que tu agente puede recuperar: si partís mal, recuperás mal, y si recuperás mal, el modelo responde mal por potente que sea el modelo detrás.
- Overlapping windows: cada chunk comparte un trozo con el anterior para no dejar ideas huérfanas en el corte. En el ejemplo del contrato, un overlap generoso podría haber arrastrado parte de la cláusula 4 dentro del chunk de la cláusula 7.
- Semantic chunking: el corte se decide por salto temático, no por cantidad de caracteres. Hubiera detectado que la cláusula 4 y la 7 tratan el mismo tema y las hubiera mantenido más cerca.
- Parent-document retrieval: buscás con precisión en un chunk chico, pero le pasás al modelo el documento padre completo. En este caso, el “padre” sería la sección entera del contrato que incluye las cláusulas 4 a 7 juntas.
El arreglo real no está en ninguna de esas técnicas por separado. Está en repensar qué guardás: a veces lo correcto no es el texto crudo del documento, sino una representación estructurada de esa información (algunos equipos incluso le piden a un modelo que parta el documento de forma “inteligente”, agregando un resumen de contexto a cada fragmento). Un criterio simple para decidir cuál de las tres técnicas probar primero: si el problema son referencias cruzadas entre secciones lejanas (como el contrato del ejemplo), parent-document suele dar más resultado por menos esfuerzo que semantic chunking. Si el documento salta de tema sin avisar dentro de una misma sección, semantic chunking ataca mejor ese caso puntual. Si tu RAG devuelve resultados correctos pero inútiles, el problema casi seguro está en el chunking o en la metadata, no en el modelo de embeddings. Tema relacionado: la reescritura de código a Rust con IA.
¿Qué deberían priorizar los equipos que construyen agentes de IA hoy?
Los equipos que construyen agentes de IA hoy deberían priorizar gobernanza, observabilidad y manejo confiable de herramientas por encima de perseguir el próximo benchmark. Esa prioridad, según el análisis de dev.to, es la que separa a los sistemas que se pueden mantener de los que se rompen en silencio (que no es poco).
Los modelos van a seguir mejorando. Las ventanas de contexto van a seguir creciendo. El costo por token va a seguir bajando. Nada de eso cambia el desafío de ingeniería de fondo: construir sistemas en los que puedas confiar cuando nadie los está mirando.
¿Y eso qué habilidad requiere? Diseño de sistemas, no fine-tuning ni prompt engineering.
El punto es que la habilidad que va a importar en dos años es la de construir agentes de IA que otro ingeniero pueda mantener y en los que pueda confiar sin auditar cada decisión a mano. Eso está más cerca de la ingeniería de sistemas que de la investigación de modelos. Relacionado: cómo se comparan GPT-4o y Gemini 2.5.
Errores comunes al diseñar un agente de IA
- Llamar “agente” a cualquier script con loop: una función que llama una API con un if-else no decide nada ni maneja fallos. Es una automatización, no un agente, y tratarla como tal te hace sobre-ingenierizar algo simple.
- Agregar orquestación “agentic” donde no hace falta: hay equipos que gastaron semanas armando capas de decisión sobre un flujo que andaba perfecto con un prompt bien escrito. Si el flujo es lineal y previsible, no necesita un agente.
- Cambiar de modelo para arreglar un problema de arquitectura: swapear GPT-4 por el modelo frontera de turno sin tocar el diseño de herramientas ni el manejo de fallos deja los mismos bugs, con otro nombre en la factura.
- Ajustar el chunking a ojo en vez de medirlo: cambiar el tamaño del chunk por intuición, sin un set de preguntas reales y una métrica como context precision o faithfulness (RAGAS), es adivinar. Medí antes de decidir.
- Tratar todos los síntomas como si fueran el mismo problema: un agente que inventa datos y uno que se traba en loop no se arreglan de la misma forma. Diagnosticar el síntoma primero ahorra semanas de cambios en la capa equivocada.
Preguntas Frecuentes
¿Qué diferencia a un agente de IA de un chatbot normal?
Un agente de IA tiene un objetivo y decide los pasos para cumplirlo, maneja fallos en el camino y sabe cuándo terminó. Un chatbot normal responde a instrucciones una por una y necesita que un humano le diga qué hacer en cada turno.
¿Por qué mi agente de IA sigue fallando aunque cambié de modelo?
Porque el problema casi nunca está en el modelo: está en el diseño de herramientas, en el manejo de fallos y en la falta de observabilidad sobre por qué el sistema decide lo que decide. Cambiar de LLM sin tocar esos tres puntos deja la misma arquitectura rota con otro motor adentro.
¿Qué es el chunking en RAG y por qué falla?
El chunking es partir un documento en fragmentos antes de convertirlos en embeddings y guardarlos en una base vectorial. Falla cuando el corte separa un párrafo de la información que necesita para tener sentido, y el modelo termina inventando el contexto que falta.
¿Qué framework conviene usar para construir agentes de IA: LangChain, LangGraph o CrewAI?
Ninguno de los tres garantiza buenos resultados por sí solo: lo que importa es si implementás los patrones de plan-then-execute, retrieval separado del reasoning y handoffs explícitos, sin importar cuál framework uses. Quien reconstruyó la misma arquitectura en varios frameworks obtuvo resultados parecidos en todos.
¿Qué hay que mejorar en un agente de IA en vez de hacer fine-tuning?
Conviene mejorar el diseño de herramientas, el manejo de fallos y la observabilidad antes de pensar en fine-tuning. El fine-tuning ajusta el modelo, pero si la arquitectura alrededor está mal diseñada, el sistema sigue fallando igual.
Conclusión
La arquitectura de agentes de IA es lo que determina si un sistema funciona en producción, no el modelo que corre adentro. Si tu agente falla, el primer paso no es tocar nada: es diagnosticar el síntoma (¿inventa datos, se traba en loop, o nadie sabe por qué decidió lo que decidió?) para saber en qué capa mirar. Recién después tiene sentido revisar diseño de herramientas, manejo de fallos y observabilidad antes de gastar tiempo en swapear modelos o hacer fine-tuning. Lo mismo vale para el RAG: antes de cambiar de embedding, revisá cómo estás cortando y qué estás guardando. El criterio práctico que te queda para aplicar ya: la próxima vez que un agente se porte mal, no le cambies el cerebro, mirá primero cómo está armado el cuerpo.