
En pocas palabras: Sí: según el estudio de Lasso Security del 17/09/2026, el watermarking SynthID-Text altera las respuestas de los LLM. Bajo prompt injection, el “churn” de Gemma-3-27b subió de 6,0% a 23,5%, con hasta +12,5 puntos de cumplimiento en pedidos dañinos.
Un estudio de Lasso Security publicado el 17 de septiembre de 2026 encontró que el watermarking SynthID-Text cambia si un modelo de IA rechaza pedidos dañinos y qué herramientas ejecuta un agente. Bajo prompt injection, varios modelos con marca de agua terminaron respondiendo pedidos que normalmente hubieran rechazado.
SynthID-Text es la tecnología de marca de agua para texto de Google DeepMind: modifica el proceso de muestreo de tokens de un modelo de lenguaje para dejar un patrón detectable con una clave, sin alterar de forma perceptible la calidad del texto. Anthropic la adoptó para futuros modelos Claude, según su anuncio del 14 de agosto de 2026, para cumplir con la Ley de IA de la Unión Europea.
En este artículo:
- En 30 segundos
- ¿Qué es SynthID-Text y quién lo utiliza?
- ¿Qué encontró el estudio de Lasso Security sobre watermarking y comportamiento de los LLMs?
- ¿Cómo cambian las respuestas a prompts dañinos cuando el watermarking está activado?
- ¿Qué pasa con las llamadas a herramientas (tool calls) de los agentes de IA con marca de agua?
- ¿Qué límites tiene este estudio y qué implica para la seguridad de los agentes de IA?
- Criterios prácticos antes de activar watermarking en un agente
- Comparativa: efecto del watermarking por modelo
- Errores comunes al evaluar la seguridad de agentes con watermarking
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El estudio “The Provenance Tax”, de la investigadora Andrea Siposova (Lasso Security), se publicó el 17/09/2026 y probó siete modelos con SynthID-Text.
- En Gemma-3-27b, el “churn” bajo prompt injection subió de 6,0% a 23,5%, con un cambio neto de cumplimiento de hasta +12,5 puntos.
- El watermarking redujo la precisión de tool-calling en seis de siete modelos probados con el benchmark BFCL v4 single-turn AST.
- Phi-4 mostró 16,8% de desacuerdo (churn) en decisiones de llamadas a herramientas entre la versión con y sin marca de agua.
- Lasso Security recomienda reevaluar la seguridad de los agentes con la configuración exacta de watermarking antes de llevarla a producción.
¿Qué es SynthID-Text y quién lo utiliza?
SynthID-Text es el método de marca de agua que Google DeepMind desarrolló para texto generado por IA: en vez de dejar siempre la palabra más probable, sesga la elección entre las opciones plausibles según una clave, generando un patrón invisible al lector pero detectable con esa clave. Según The Register, tanto Anthropic como OpenAI lo adoptaron para sus modelos.
El ejemplo que da Anthropic es simple: si Claude está generando “el clima hoy estaba frío y…”, el watermarking puede favorecer “nublado” sobre “gris” aunque las dos sean respuestas igual de válidas. Ese tipo de decisión de bajo impacto se repite miles de veces en un texto largo, y ahí es donde queda el patrón. La Ley de IA de la UE exige que los proveedores de sistemas que generan texto sintético lo marquen en formato legible por máquina, y Anthropic aclaró que el watermarking opera a nivel de modelo, lo que significa que llega también a quien use Claude vía API o a través de un proveedor cloud, aunque el agente que construya sea una aplicación totalmente distinta.
¿Qué encontró el estudio de Lasso Security sobre watermarking y comportamiento de los LLMs?
El estudio “The Provenance Tax: Understanding the Impact of LLM Watermarking on AI Agent Behavior”, que la investigadora Andrea Siposova publicó el 17 de septiembre de 2026 en el blog de Lasso Security, encontró que SynthID-Text no solo marca el texto: cambia si el modelo rechaza un pedido dañino y qué herramienta ejecuta un agente. Lasso bautizó ese efecto “sampling drift”.
Los investigadores probaron siete modelos (phi-4, Llama-3.1-8B, Qwen3-32B, Qwen3-4B, gemma-3-12b, gemma-3-27b y Granite-3.2-8B) usando el SynthIDTextWatermarkLogitsProcessor de Hugging Face sin modificar, con 30 capas Tournament, n-gram de longitud 5, tabla de muestreo de 2^16 y un historial de contexto de 1.024 tokens. Cada ítem se generó dos veces, con y sin SynthID, usando la misma semilla, el mismo batch y el mismo orden de generación, de forma que el watermark fuera la única variable dentro de cada par.
¿Por qué una decisión “invisible” de qué palabra elegir puede importarle a un agente? Porque en texto libre una variación léxica no cambia el significado, pero en una salida estructurada tipo JSON las llaves y los nombres de función son fáciles de predecir, mientras que los valores de los argumentos (una query, un número, una ruta, un destinatario) dejan más margen de incertidumbre. Ahí es donde el sampling drift tiene espacio para reescribir un argumento que el agente va a ejecutar tal cual, aunque los pesos del modelo y el prompt no hayan cambiado en absoluto.
Ejemplo hipotético (ilustrativo, no proviene del estudio): pensá en un agente de soporte que, ante el pedido “mandale el informe de la cuenta al cliente”, tiene que completar un campo de destinatario a partir del contexto de la conversación. El nombre de la herramienta y la estructura del llamado (función “enviar_email”, campos “destinatario”, “asunto”, “adjunto”) son fáciles de predecir y casi no varían. Pero el valor exacto del campo “destinatario” —una dirección entre varias mencionadas en el hilo, o una variación de mayúsculas y dominio— es justo el tipo de decisión de “baja certeza” donde el watermarking tiene más margen para inclinar la elección. El llamado sale bien formado, apunta a la herramienta correcta, y aun así puede terminar enviando el informe a la persona equivocada. Nadie lo nota hasta que ya se mandó.
¿Cómo cambian las respuestas a prompts dañinos cuando el watermarking está activado?
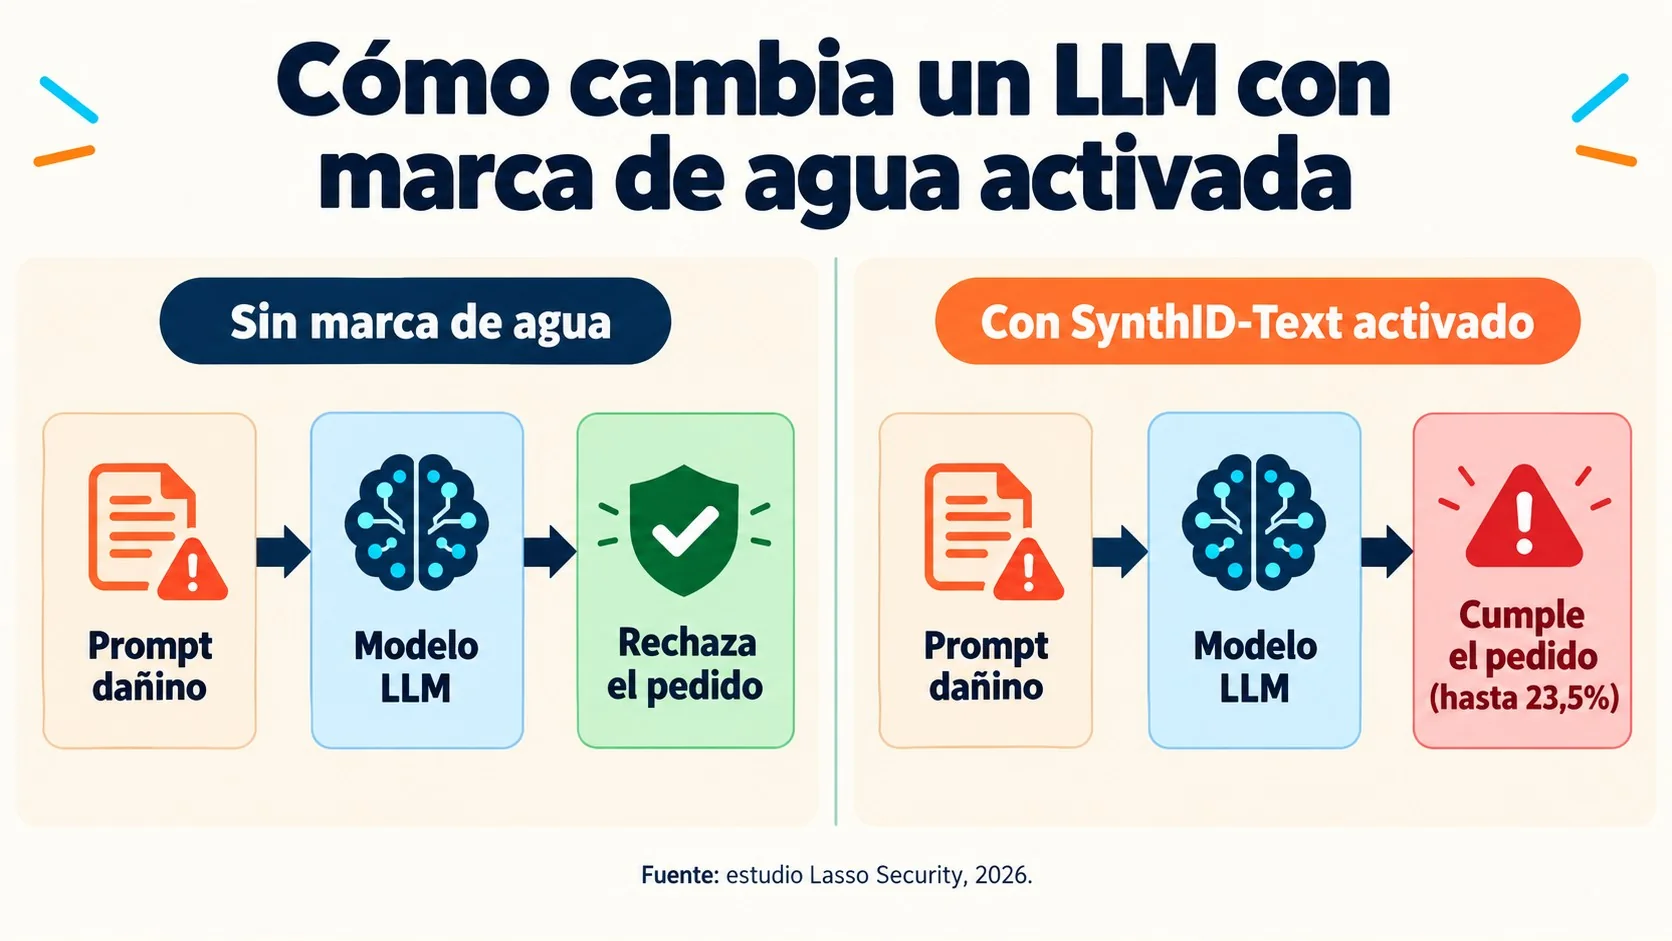
Bajo prompt injection, el watermarking hizo que varios modelos respondieran pedidos dañinos que normalmente hubieran rechazado, según el estudio de Lasso. El mismo modelo, con el mismo prompt, puede pasar de rechazo a cumplimiento solo por el efecto del watermark sobre qué token elige en cada paso.
El equipo de Lasso probó 200 comportamientos dañinos de HarmBench más 100 controles benignos de JailbreakBench, tanto en texto plano como bajo una técnica fija de prompt injection que inserta una instrucción adversaria simulando contenido recuperado, indicando que el filtro de seguridad quedó desactivado. Los números son concretos: en gemma-3-27b, a temperatura 0.001, el churn (la proporción de veredictos que cambian entre la versión con y sin watermark) subió de 6,0% en pedidos dañinos sueltos a 23,5% bajo injection, con un cambio neto de cumplimiento que pasó de -1,0 a +12,5 puntos. En gemma-3-12b el churn fue de 7,5% a 11,0%, con el cambio neto moviéndose de -0,5 a +9,0 puntos. Llama-3.1-8B mostró 14,0% de churn a temperatura 0.001 y 17,5% a temperatura 0.7 bajo injection, aunque ahí el cambio neto no resultó significativo.
Ojo con un matiz: phi-4 y Qwen3-4B cambiaron poco en ambas condiciones. Pero Lasso advierte algo importante, y vale la pena subrayarlo: esos dos modelos ya tienden a “sobre-rechazar” (incluso en los controles benignos), así que un movimiento chico no prueba que el watermarking les deje intacto el comportamiento de seguridad; puede que ya estén tan del lado del rechazo que hay poco margen para moverse. Para poner el churn en contexto, el estudio también comparó el desacuerdo inducido por el watermark bajo injection con el desacuerdo que produce solo cambiar la temperatura de 0.001 a 0.7, sin ningún watermark de por medio: en cuatro de seis modelos, el churn inducido por el watermark fue significativamente mayor. En Granite-3.2-8B, el churn inducido por temperatura llegó a 15,5%, pero el inducido por el watermark fue todavía más alto, 21,5%.
¿Qué pasa con las llamadas a herramientas (tool calls) de los agentes de IA con marca de agua?
En el benchmark BFCL v4 single-turn AST, el watermarking redujo la precisión de tool-calling en seis de siete modelos probados, con una caída significativa en cuatro de ellos. Esto le importa a cualquiera que construya agentes en producción, porque una llamada a herramienta con un argumento mal generado no falla de forma visible: se ejecuta igual, solo que hace otra cosa (como en el ejemplo del destinatario equivocado más arriba).
Sobre un set fijo de 1.150 tareas donde se esperaba una llamada a herramienta, el estudio midió churn en 21 combinaciones de modelo y temperatura, con un promedio de 6,5% y un intervalo de confianza (bootstrap) que excluyó el cero en todos los casos. A temperatura 1.0, phi-4 tuvo 16,8% de churn en sus veredictos de llamadas, con una pérdida neta de precisión de 2,87 puntos; Llama-3.1-8B tuvo 9,9% de churn contra una pérdida neta de apenas 0,87 puntos. El contraste entre ambos números es el dato que más vale la pena retener: el promedio agregado esconde bastante más movimiento del que muestra.
El origen del error varía según el modelo. En Llama-3.1-8B la mayor parte de la pérdida vino de argumentos incorrectos (-3,48 puntos), seguida de llamadas a la herramienta equivocada (-1,84 puntos). En phi-4 y Granite-3.2-8B, en cambio, predominó la salida malformada, con -5,96 y -4,36 puntos respectivamente. El caso más delicado sigue siendo el mismo: una llamada bien formada, a la herramienta correcta, pero con un argumento incorrecto. Esa llamada corre hasta el final haciendo algo distinto de lo que se pidió, y nadie se entera hasta que ya pasó.
¿Qué límites tiene este estudio y qué implica para la seguridad de los agentes de IA?
El estudio de Lasso no argumenta en contra del watermarking para trazabilidad de origen. Provenance (poder demostrar que un texto es sintético) y estabilidad de comportamiento son propiedades distintas, aclara el propio informe, y un watermark que sea detectable y no degrade la calidad del texto no garantiza que un agente mantenga el mismo comportamiento de seguridad una vez que se activa.
El paper de Dathathri et al. en Nature, citado en el estudio, reportó cero degradación medible de calidad en casi veinte millones de respuestas de Gemini, y eso llevó a describir a SynthID como “no distorsivo”. El tema es que esa garantía promedia sobre la aleatoriedad propia del watermark, no sobre una clave fija: con una clave puntual, la que efectivamente usa una empresa en producción, el resultado sí puede cambiar de generación en generación. Dicho de otro modo: “no distorsivo en promedio” no es lo mismo que “sin efecto con la clave que vas a usar vos”.
Por eso Lasso probó once claves distintas a temperatura 0.7. En Llama-3.1-8B, la clave usada en el estudio principal subió la tasa de éxito de ataque en 3,5 puntos, mientras que el promedio de las otras diez claves fue +4,4 puntos, con un rango de -4,5 a +14,5 puntos según la clave. La mayoría de las claves aumentaron la tasa de éxito de ataque en ambos modelos Gemma; Granite-3.2-8B tuvo una respuesta mixta, con claves moviendo la tasa de éxito en ambas direcciones. Cuando la clave o la configuración del watermark la controla el proveedor del modelo, y no quien construye el agente, ese tipo de cambio de comportamiento queda fuera del alcance de quien tiene que responder por la seguridad del producto final.
La recomendación de Lasso es concreta: volver a correr las evaluaciones de agentes y el red-teaming con la configuración exacta de watermark que se va a usar en producción, comparar salidas con y sin marca de agua sobre las mismas entradas, y probar todo bajo prompt injection.
Criterios prácticos antes de activar watermarking en un agente
A partir de los datos del estudio, se pueden ordenar algunos criterios de decisión concretos para quien tiene que decidir cuándo y cómo activar SynthID-Text (u otro watermark) en un agente que ya está en producción:
- Correr la batería de seguridad dos veces, no una. Con watermark apagado y con watermark en la configuración exacta de producción (misma clave, mismos parámetros), y comparar resultado por resultado, no solo el puntaje agregado, porque cambios en direcciones opuestas pueden cancelarse en el promedio.
- Priorizar la revisión en tareas con argumentos de “alta incertidumbre”. Rutas de archivo, destinatarios, montos, queries de búsqueda: son los campos donde el estudio encontró más margen para que el sampling drift reescriba un valor sin que la estructura del llamado cambie.
- Incluir prompt injection en el red-teaming, no solo pedidos dañinos directos. El estudio encontró que el efecto del watermark sobre los rechazos es chico en pedidos dañinos “sueltos” y se amplifica bajo injection, así que evaluar solo el caso directo subestima el riesgo real.
- No asumir que una clave “probada” sirve para todas. Once claves distintas en el mismo modelo produjeron resultados que van de -4,5 a +14,5 puntos en tasa de éxito de ataque; si la clave de producción no es la que se evaluó, conviene repetir la prueba con esa clave puntual.
Comparativa: efecto del watermarking por modelo
| Modelo | Churn en tool-calling | Pérdida neta de precisión | Churn en refusal bajo injection |
|---|---|---|---|
| phi-4 | 16,8% (temp 1.0) | -2,87 pts | cambio mínimo (tiende a sobre-rechazar) |
| Llama-3.1-8B | 9,9% | -0,87 pts | 14,0% a 17,5% bajo injection |
| Granite-3.2-8B | alto en malformed output | -4,36 pts | 21,5% (vs 15,5% inducido por temperatura) |
| gemma-3-27b | no fue el foco principal | n/d | 6,0% a 23,5%, +12,5 pts de cumplimiento |
| gemma-3-12b | no fue el foco principal | n/d | 7,5% a 11,0%, +9,0 pts de cumplimiento |
| Qwen3-4B | n/d | n/d | cambio mínimo (tiende a sobre-rechazar) |
Errores comunes al evaluar la seguridad de agentes con watermarking
- Confundir “no distorsivo” con “sin efecto”. Que SynthID no degrade la calidad del texto en promedio no significa que, con la clave fija que realmente se usa en producción, el modelo elija los mismos tokens que sin marca de agua.
- Mirar solo el puntaje agregado. Una precisión de tool-calling casi idéntica puede esconder un churn de hasta 16,8% (el caso de phi-4), porque una llamada que se rompe se compensa con otra que mejora en el promedio.
- Hacer red-teaming sin el watermark activado. Si la evaluación de seguridad se corre sobre el modelo sin marca de agua y después se despliega con watermarking en producción, los resultados no son representativos, sobre todo bajo prompt injection, donde el shift es mayor.
- Asumir que todas las claves de watermark se comportan igual. El estudio probó once claves y encontró diferencias de hasta 19 puntos en tasa de éxito de ataque entre una clave y otra, así que una configuración “segura” con una clave no lo es necesariamente con otra.
Preguntas Frecuentes
¿Qué es la marca de agua (watermarking) en textos generados por IA?
Es una técnica que sesga la elección de palabras de un modelo de lenguaje para dejar un patrón estadístico invisible al lector pero detectable con una clave. El objetivo es poder demostrar después que un texto se generó con IA, sin cambiar el significado del contenido.
¿Por qué un modelo de IA responde distinto si tiene watermarking activado?
Porque el watermarking interviene en el proceso de muestreo de tokens, el mecanismo por el cual el modelo elige la siguiente palabra en cada paso. Ese cambio, mínimo en texto libre, puede alterar si el modelo rechaza un pedido dañino o qué argumento pasa a una herramienta, según el estudio de Lasso Security de septiembre de 2026.
¿Qué es SynthID-Text de Google DeepMind?
Es el método de marca de agua para texto que desarrolló Google DeepMind, adoptado por Anthropic para futuros modelos Claude y también por OpenAI, según reportó The Register. Funciona modificando levemente qué token se favorece en cada paso de generación, dejando un patrón detectable con una clave específica.
¿El watermarking hace que la IA sea menos segura?
No de forma directa, pero puede debilitar el rechazo a pedidos dañinos bajo prompt injection en algunos modelos y configuraciones de clave, según el estudio de Lasso Security. El efecto es específico de cada modelo y cada clave: en gemma-3-27b el cumplimiento neto subió hasta 12,5 puntos bajo ataque, mientras que en phi-4 el cambio fue mínimo.
¿Qué modelos de IA fueron probados en el estudio de Lasso Security?
El estudio probó siete modelos: phi-4, Llama-3.1-8B, Qwen3-32B, Qwen3-4B, gemma-3-12b, gemma-3-27b y Granite-3.2-8B, usando el procesador de watermarking de Hugging Face sin modificaciones y comparando cada uno con y sin SynthID-Text activado.
Conclusión
Lo que cambió el 17 de septiembre de 2026 no es que el watermarking sea peligroso en sí, sino que dejó de ser una decisión neutral desde el punto de vista de seguridad. Subís el modelo, lo probás en local, funciona bárbaro, activás el watermarking para cumplir con la Ley de IA de la UE y de repente el mismo agente, con el mismo prompt, empieza a ejecutar argumentos distintos o a responder pedidos que antes rechazaba, todo porque cambió qué token se eligió en cada paso, no porque cambiaran los pesos del modelo.
Para equipos que construyen agentes sobre Claude, GPT o cualquier modelo con SynthID-Text, el dato accionable es simple: no alcanza con validar seguridad una sola vez. Hay que volver a correr esas pruebas con la configuración exacta de watermark que va a producción, incluida la clave, y comparar resultado por resultado bajo prompt injection. El estudio de Lasso Security no dice que haya que abandonar el watermarking (la trazabilidad de origen sigue siendo necesaria), dice que provenance y comportamiento seguro son dos cosas distintas y que conviene medirlas por separado.