
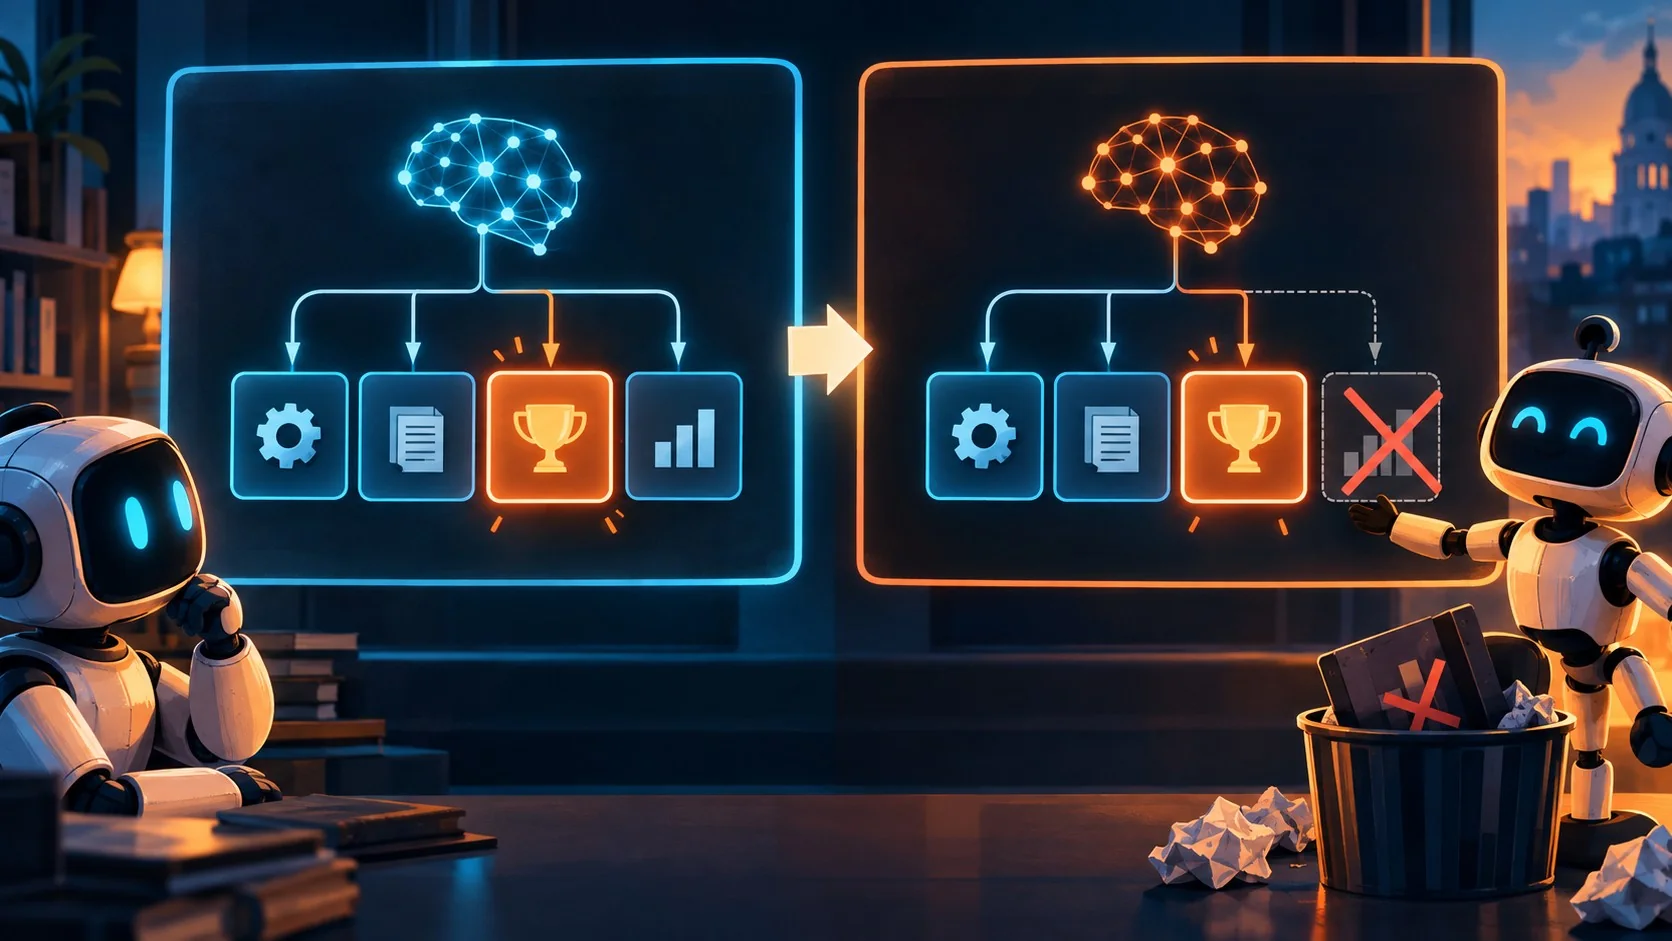
En pocas palabras: GRPO no elimina el reward model: según el paper de DeepSeekMath (2024), elimina el value model (critic). El reward model sigue evaluando cada output, igual que en PPO. GRPO reemplaza el baseline del critic por el promedio de un grupo de outputs muestreados para la misma pregunta.
GRPO no elimina el reward model: elimina el critic (value model). El paper de DeepSeekMath, publicado en 2024, muestra que GRPO reemplaza el value model por un baseline calculado con el promedio de un grupo de outputs, mientras el reward model sigue evaluando cada respuesta, tal como pasa en PPO.
GRPO (Group Relative Policy Optimization) es un algoritmo de reinforcement learning que Shao y compañía presentaron como “a variant of Proximal Policy Optimization (PPO)”, no como su reemplazo. En vez de entrenar un value model para calcular el baseline de cada respuesta, GRPO samplea un grupo de outputs para la misma pregunta, los puntúa con un reward model y usa el promedio de ese grupo como referencia.
En este artículo:
- En 30 segundos
- ¿Qué costaba mantener el critic en PPO según el paper de DeepSeekMath?
- ¿Qué reemplaza al critic en GRPO?
- ¿Cuántos modelos usa PPO comparado con GRPO?
- ¿El KL penalty desaparece en GRPO o solo cambia de lugar?
- ¿Por qué DeepSeek-R1 sí eliminó el reward model neuronal (y no fue por GRPO)?
- ¿Qué mostró el paper sobre la mejora real que aporta GRPO en razonamiento?
- Errores comunes al hablar de GRPO reward model
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- GRPO elimina el value model (critic), no el reward model: el reward model sigue evaluando cada output, según el paper de DeepSeekMath.
- PPO entrena 4 modelos (policy, reference, reward, value); GRPO entrena 3 (policy, reference, reward).
- El value model en PPO es “typically another model of comparable size as the policy model”, lo que dispara memoria y cómputo.
- DeepSeek-R1 sí sacó el reward model neuronal, pero por reward hacking en tareas de razonamiento, una decisión distinta a la de GRPO.
- DeepSeek-R1-Zero samplea 16 outputs por pregunta para calcular el baseline grupal, según el paper de DeepSeek-R1.
¿Qué costaba mantener el critic en PPO según el paper de DeepSeekMath?
El value model de PPO cuesta memoria y cómputo duplicado, porque el paper lo describe como “typically another model of comparable size as the policy model”. Eso implica entrenar dos redes grandes para terminar poniendo en producción una sola política.
Ahí no termina el problema. Hay un segundo costo que se menciona menos y que a mí me parece más interesante que el de la memoria: en RL para modelos de lenguaje, “usually only the last token is assigned a reward score by the reward model”. Una señal tan poco frecuente “may complicate the training of a value function that is accurate at each token”. Es decir, el critic no solo es caro, es difícil de entrenar bien, y las dos cosas suelen mencionarse por separado cuando en realidad van juntas.
Subís el policy model, lo hacés generar respuestas, entrenás en paralelo un value model del mismo tamaño para estimar qué tan buena es cada respuesta token a token, descubrís que la señal de reward solo llega al final de la secuencia y el value model no tiene con qué aprender bien esa asignación intermedia, y terminás pagando el doble de memoria por una estimación que ni siquiera es precisa.
¿Qué reemplaza al critic en GRPO?
Sampling. Para cada pregunta, GRPO genera un grupo de outputs, cada uno evaluado por el reward model (que sigue ahí, haciendo su trabajo de siempre), y usa el promedio del grupo como baseline en vez de un value model entrenado aparte. Relacionado: entender cómo razonan los modelos de lenguaje.
Las recompensas se normalizan “by subtracting the group average and dividing by the group standard deviation”. El advantage de cada output ya no depende de una estimación entrenada por separado: responde una pregunta relativa, ¿esta respuesta fue mejor o peor que sus hermanas dentro del mismo grupo?
Ese enfoque calza bien con cómo se construyen los reward models en primer lugar, porque se entrenan justamente con comparaciones entre outputs para la misma pregunta. No es casualidad, es coherencia de diseño.
Eso sí: nada de esto sale gratis. Ahora necesitás varias generaciones por pregunta en vez de una sola. DeepSeek-R1-Zero sampleó 16 outputs por pregunta para armar ese baseline grupal. GRPO cambia memoria por generación. Si estás limitado por memoria, es un buen trato. Si estás limitado por throughput, quizás no tanto.
¿Cuántos modelos usa PPO comparado con GRPO?
PPO necesita cuatro modelos entrenados o cargados en memoria: policy, reference, reward y value. GRPO reduce esa lista a tres: policy, reference y reward. El reward model está presente en las dos listas. Nunca se fue.
| Modelo | ¿Está en PPO? | ¿Está en GRPO? | Función |
|---|---|---|---|
| Policy | Sí | Sí | Genera las respuestas que se van a evaluar |
| Reference | Sí | Sí | Ancla para el término de regularización KL |
| Reward | Sí | Sí | Puntúa cada output generado |
| Value (critic) | Sí | No | Estimaba el baseline por token; GRPO lo reemplaza por el promedio del grupo |
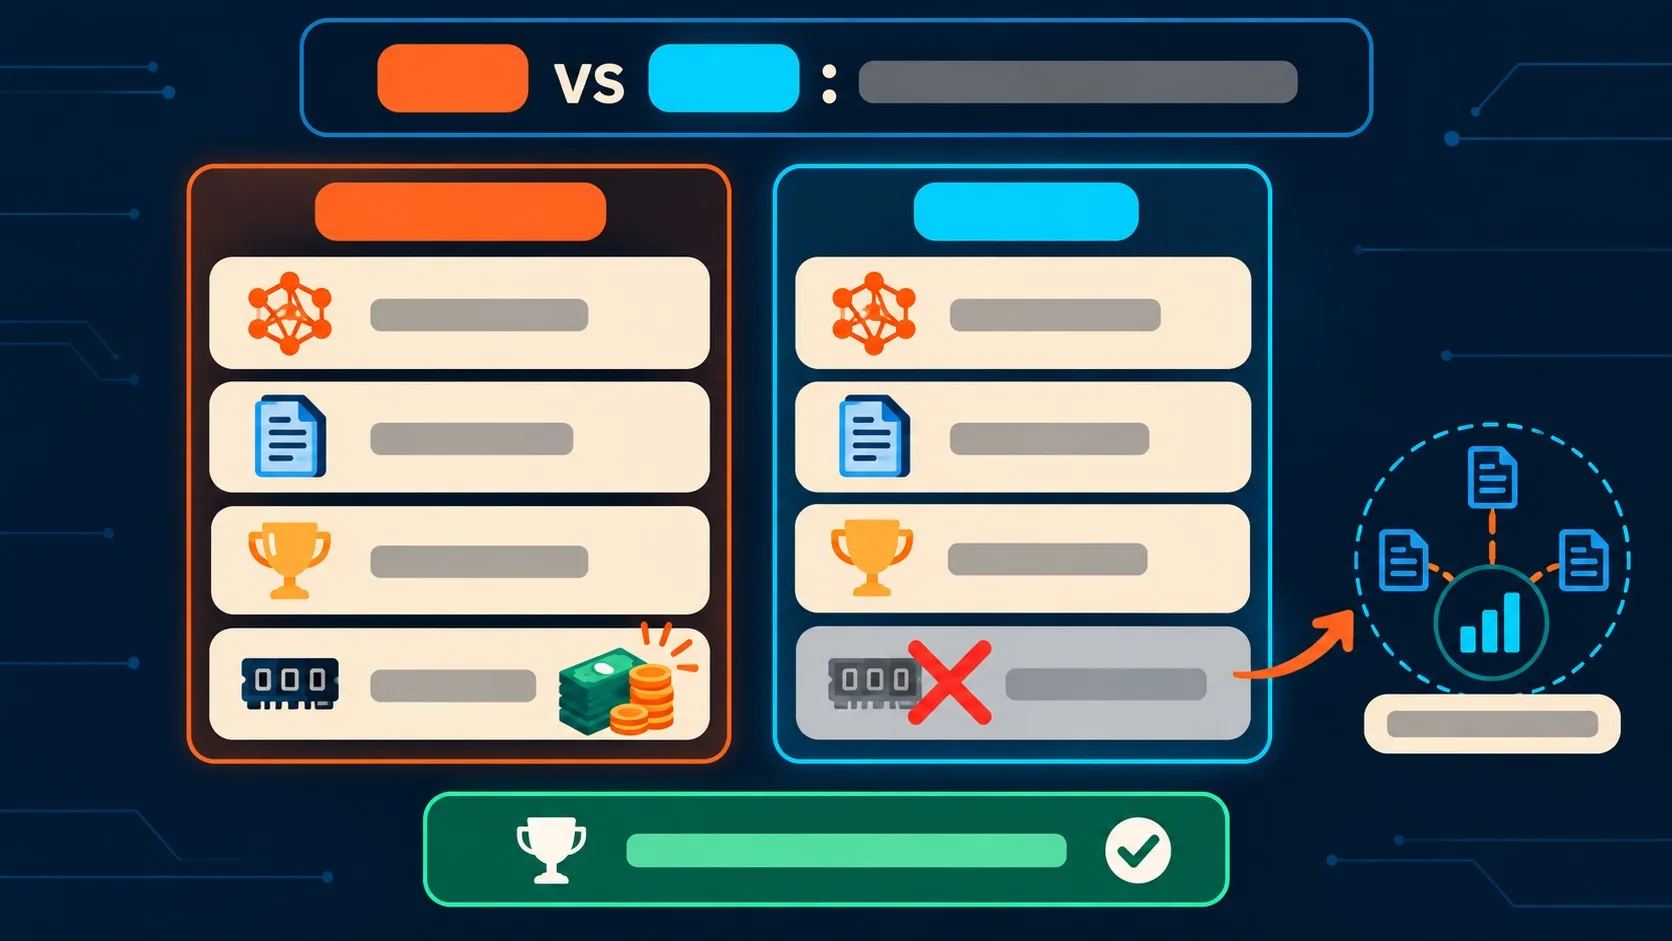
Cuando alguien dice que GRPO reward model ya no existe en el algoritmo, en general está confundiendo esa cuarta fila con la tercera. Son dos redes distintas con dos trabajos que no tienen nada que ver entre sí. Complementá con elegir entre Claude Sonnet y Opus.
¿El KL penalty desaparece en GRPO o solo cambia de lugar?
El KL penalty no desaparece en GRPO, cambia de dirección. PPO suma “a per-token KL penalty from a reference model in the reward at each token”. GRPO, en cambio, trabaja “instead of adding KL penalty in the reward” y “regularizes by directly adding the KL divergence” a la función de pérdida.
Misma idea, otra dirección postal. GRPO además usa un estimador no sesgado “which is guaranteed to be positive”, lo que le da una propiedad matemática que el término clásico de PPO no garantiza de la misma forma.
¿Entonces por qué tanta gente asume que GRPO tira el KL a la basura? Porque la explicación corta (“GRPO simplifica PPO”) suena mejor que la explicación exacta (“GRPO mueve el KL de la recompensa a la loss”). La versión corta viaja más rápido, pero viaja mal.
¿Por qué DeepSeek-R1 sí eliminó el reward model neuronal (y no fue por GRPO)?
DeepSeek-R1 eliminó el reward model neuronal para tareas de razonamiento porque “neural reward models are susceptible to reward hacking during large-scale reinforcement learning”, según el paper de DeepSeek-R1. Es una decisión de robustez, no de memoria, y aplica puntual a tareas de razonamiento.
Esa decisión suele mezclarse con la historia de GRPO porque las dos vienen del mismo laboratorio y aparecen en papers vecinos. Pero son cosas distintas: GRPO es un cambio de algoritmo que afecta al critic; el paso de rewards neuronales a rewards basados en reglas en R1 es un cambio de qué modelo puntúa las respuestas, motivado por el riesgo de que el policy aprenda a explotar los huecos del reward model en vez de mejorar de verdad.
Son dos decisiones separadas, tomadas por razones separadas, que terminan resumidas en la misma frase mal armada. Para más detalles técnicos, mirá armar un chatbot multi-modelo propio.
¿Qué mostró el paper sobre la mejora real que aporta GRPO en razonamiento?
El hallazgo más incómodo del paper de DeepSeekMath es que la mejora de GRPO parece limitada a hacer más confiable lo que el modelo ya sabía, no a ampliar lo que puede hacer. Los autores midieron Pass@K y Maj@K antes y después del entrenamiento con RL, y el resultado fue asimétrico: “RL enhances Maj@K’s performance but not Pass@K”.
Leelo despacio. El modelo mejoró para hacer aparecer, de forma confiable, una respuesta que ya era capaz de producir. No empezó a producir respuestas que antes estaban fuera de su alcance. Los propios autores atribuyen la ganancia a “boosting the correct response from TopK rather than the enhancement of fundamental capabilities”.
Esto no invalida a GRPO como técnica de ahorro de memoria (que lo es, y bien), pero sí achica bastante la afirmación que suele hacerse sobre RL fine-tuning como fuente de “capacidades nuevas”. Para un equipo evaluando si vale la pena meter GRPO en su pipeline, esto importa más que la reducción de modelos: la pregunta no es solo cuánta memoria vas a ahorrar, sino si tu caso de uso depende de que el modelo aprenda algo nuevo o de que deje de fallar en algo que ya sabía resolver a veces.
Errores comunes al hablar de GRPO reward model
- Confundir “eliminar el reward model” con “eliminar el critic”: son dos redes que hacen trabajos distintos. El reward model puntúa outputs; el value model estimaba el baseline. GRPO tocó solo el segundo.
- Asumir que GRPO reemplaza completamente a PPO: el propio paper lo llama “a variant of Proximal Policy Optimization (PPO)”, no un sucesor. GRPO conserva el clipped ratio y el reference model de PPO.
- Pensar que GRPO elimina la regularización KL: el término solo se mudó de la recompensa a la función de pérdida, con un estimador no sesgado garantizado positivo.
- Atribuir a GRPO la decisión de DeepSeek-R1 de usar rewards basados en reglas: esa fue una decisión de robustez contra reward hacking, específica de tareas de razonamiento, tomada por separado del diseño de GRPO.
Un criterio práctico, y esto ya es propuesta editorial nuestra, no algo que diga la fuente: antes de citar “GRPO elimina X”, fijate si X es el value model o el reward model. Si la frase no distingue entre los dos, probablemente esté mal armada, venga de donde venga.
Preguntas Frecuentes
¿GRPO elimina el reward model?
No. GRPO conserva el reward model igual que PPO: cada output del grupo generado se puntúa con él, y ese puntaje se usa para calcular el promedio del grupo como baseline. Lo que GRPO elimina es el value model (critic), la red que en PPO estimaba ese baseline por separado. En aislar tu modelo de IA autohospedado profundizamos sobre esto.
¿Qué diferencia hay entre el critic y el reward model?
El reward model puntúa qué tan buena es una respuesta completa, comparándola contra otras. El critic (value model) estimaba, token a token, cuánto valor futuro esperado tenía el estado actual de la generación, algo mucho más caro de entrenar bien porque la señal de reward suele llegar recién en el último token.
¿Por qué PPO necesita un value model y GRPO no?
PPO es actor-critic, así que necesita un value model entrenado junto a la policy para calcular el advantage de cada acción. GRPO reemplaza esa estimación entrenada por un cálculo estadístico directo: samplea varios outputs para la misma pregunta y usa el promedio y el desvío estándar del grupo como baseline, sin necesidad de entrenar una red aparte.
¿GRPO reemplaza completamente a PPO?
No, y el propio paper de DeepSeekMath lo aclara: GRPO es “a variant of Proximal Policy Optimization (PPO)”, no un algoritmo independiente. Mantiene el clipped ratio de PPO, el reference model, y solo cambia el critic por un baseline grupal y la ubicación del término KL.
¿Por qué DeepSeek-R1 eliminó los reward models neuronales?
DeepSeek-R1 sacó los reward models neuronales para tareas de razonamiento porque, según el paper, “neural reward models are susceptible to reward hacking during large-scale reinforcement learning”. Usó rewards basados en reglas en su lugar, una decisión de robustez separada de GRPO y limitada a razonamiento.
Conclusión
La confusión entre critic y reward model no es un detalle menor de vocabulario: cambia qué esperás que GRPO te resuelva. Si pensás que GRPO sacó el reward model de la ecuación, vas a subestimar cuánto cómputo seguís necesitando para puntuar cada output del grupo. Si entendés que lo que se fue es el value model, entendés también por qué GRPO necesita samplear varios outputs por pregunta (16 en el caso de DeepSeek-R1-Zero) en vez de generar uno solo.
Para quien esté evaluando meter GRPO en un pipeline de RL, la data del propio paper deja dos cosas claras y una pregunta abierta. Claras: el ahorro de memoria es real (un modelo menos entrenado) y el KL no desaparece, se reubica. Abierta: si tu caso de uso necesita que el modelo aprenda capacidades nuevas, el hallazgo sobre Pass@K sin mejora sugiere que RL con GRPO todavía no es la herramienta para eso, al menos no según lo que reportó este paper específico.
Fuentes
- GRPO doesn’t remove the reward model. It removes the critic – análisis original con todas las citas del paper
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models – paper original que introduce GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning – paper de DeepSeek-R1
- Proximal Policy Optimization Algorithms – paper original de PPO, Schulman et al.