
En pocas palabras: LongCat-2.5 es el modelo multimodal que Meituan lanzó el 2 de noviembre de 2026, con 1,6 billones de parámetros totales (48.000 millones activos por token), visión nativa a nivel de tokens y contexto de 1 millón de tokens, orientado a tareas agentic de largo horizonte vía chat y API.
En este artículo:
- En 30 segundos
- ¿Cuántos parámetros tiene LongCat-2.5 y qué arquitectura usa?
- ¿Cómo funciona la multimodalidad nativa de LongCat-2.5?
- ¿Qué tareas agentic puede resolver LongCat-2.5?
- ¿Qué limitaciones y datos faltan en el lanzamiento de LongCat-2.5?
- LongCat-2.5 y la estrategia de “chips domésticos, modelos domésticos” de Meituan
- Errores comunes al leer el anuncio de LongCat-2.5
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
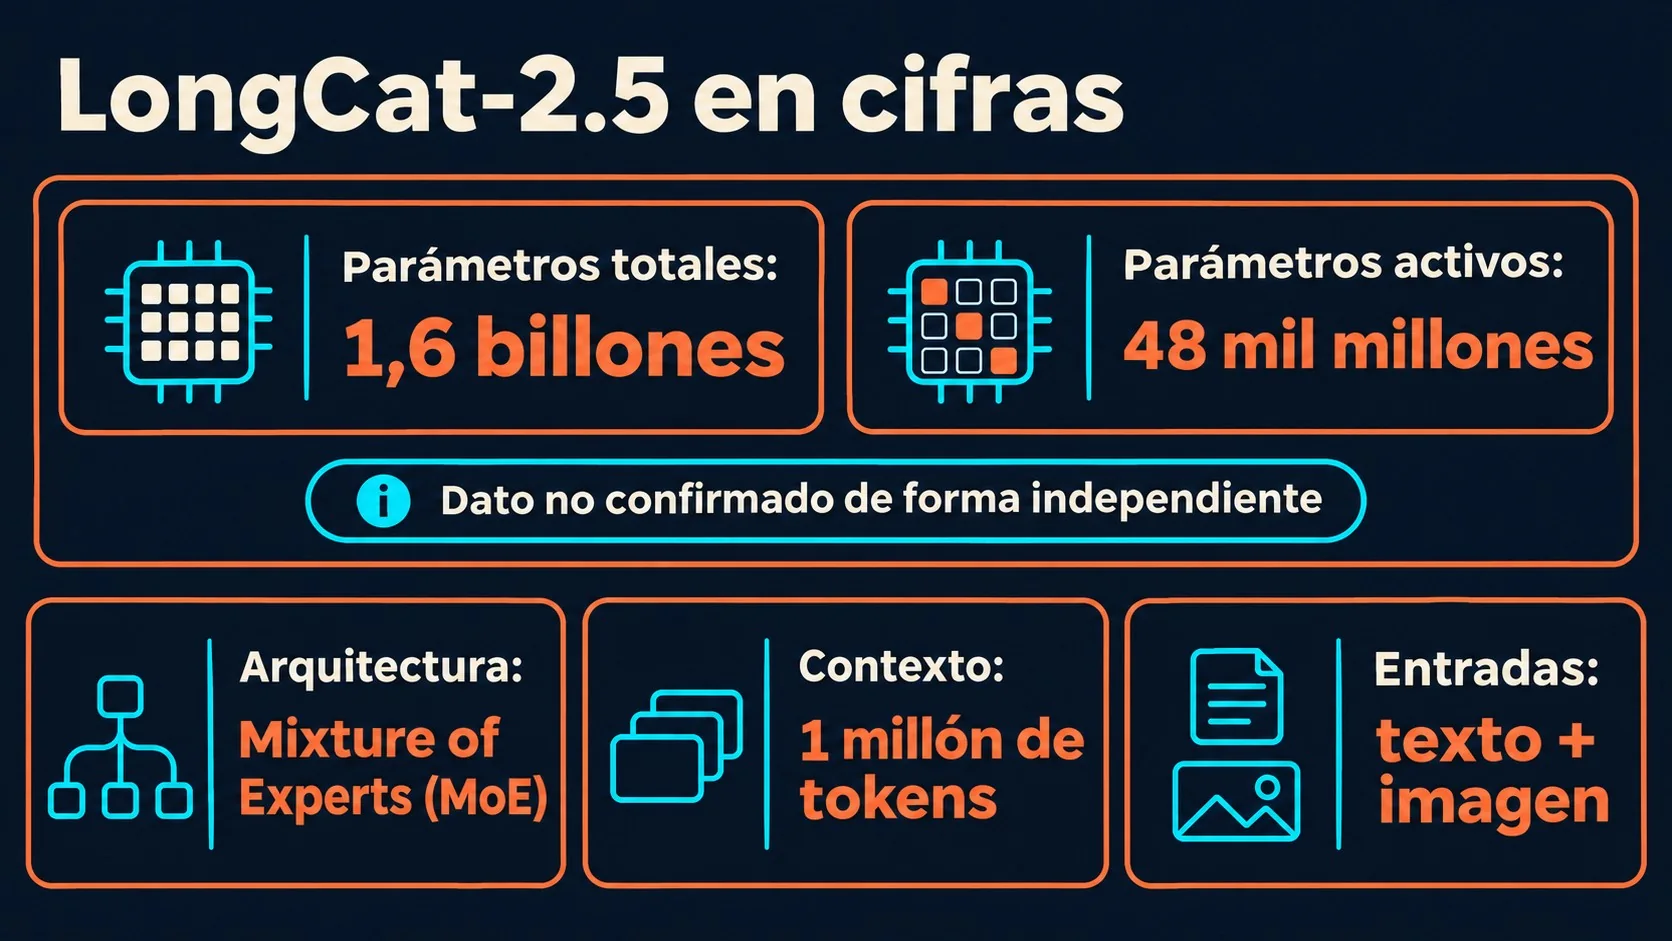
- 1,6 billones de parámetros totales, con ~48.000 millones activos por token (arquitectura Mixture of Experts).
- Contexto de 1 millón de tokens y salida máxima de 128.000 tokens, suficiente para un repositorio mediano completo.
- Visión integrada a nivel de tokens, sin encoder separado para imágenes.
- Benchmarks propios altos: BrowseComp 91,9, Terminal Bench v2.1 88,4, PaperBench 82,1.
- Sin pricing público todavía: el modelo es API-only por ahora, vía la plataforma de Meituan.
LongCat-2.5 es un modelo de lenguaje multimodal que desarrolló Meituan, la empresa china de delivery y servicios locales que también construye modelos de IA bajo la marca LongCat. Según la ficha técnica de LongCat AI, usa arquitectura Mixture of Experts y está diseñado para completar tareas agentic de largo plazo: proyectos de código enteros, navegación web, hojas de cálculo y flujos de diseño visual.
¿Cuántos parámetros tiene LongCat-2.5 y qué arquitectura usa?
LongCat-2.5 tiene 1,6 billones de parámetros totales, de los cuales entran en juego unos 48.000 millones por cada token procesado, gracias a su arquitectura Mixture of Experts. Esa relación entre parámetros totales y activos es la que le permite escalar sin que cada inferencia salga carísima en cómputo.
El modelo soporta una ventana de contexto de 1 millón de tokens y una salida máxima de 128.000 tokens, según detalla el reporte de Emergent sobre el lanzamiento. En la práctica, eso significa que un agente puede mantener en memoria de trabajo un codebase entero, varias pestañas de navegador abiertas y un flujo de varios pasos sin perder el hilo (algo que, si alguna vez probaste automatizar una tarea larga con un modelo de contexto chico, sabés lo frustrante que es cuando el modelo “olvida” lo que pasó diez pasos atrás).
Meituan entrenó el modelo en aceleradores chinos domésticos y aplicó cuantización W4A4 con recuperación de precisión basada en FlatQuant. Según el sitio oficial de LongCat AI, esto le da una ganancia de +43,3% en throughput de prefill y +42,77% en decode frente a W8A8. Ojo: son cifras del propio fabricante, comparando contra su propia cuantización anterior, no un benchmark independiente.
¿Cómo funciona la multimodalidad nativa de LongCat-2.5?
La multimodalidad nativa de LongCat-2.5 convierte las señales visuales en tokens discretos multi-nivel (RVQ sobre features SAE de resolución nativa, heredado de la línea LongCat-Next), de modo que el modelo procesa imagen y texto con el mismo vocabulario y el mismo objetivo de entrenamiento. No hay un módulo de visión aparte que después se “pega” al modelo de lenguaje.
La diferencia con un enfoque de encoder separado es más práctica de lo que parece. Ponele que le mostrás a un agente una captura de pantalla de un formulario roto: en vez de pasar esa imagen por un pipeline de visión que después le describe la escena al modelo de texto, LongCat-2.5 razona sobre la imagen dentro del mismo loop que escribe el código de la corrección. Meituan lo llama “visual coding”, y según su propio sitio es el motor detrás de las demos de modelado 3D y diseño creativo que mostró la empresa.
Esto viene de la familia LongCat-Next, que ya había liberado el framework DiNA y el tokenizador dNaViT para unificar imagen, audio y texto en un solo espacio de tokens. LongCat-2.5 toma esa base y la orienta a tareas de agente en vez de solo generación o comprensión multimodal general.
¿Qué tareas agentic puede resolver LongCat-2.5?
LongCat-2.5 está pensado para terminar proyectos completos, no solo responder preguntas o generar fragmentos de código sueltos: trabajo en terminales, navegadores, hojas de cálculo y herramientas de diseño, todo dentro del mismo razonamiento de agente. El equipo de LongCat resume la diferencia con su versión anterior así: “LongCat-2.0 se construyó para escribir y editar código, LongCat-2.5 se construyó para terminar proyectos”, según la ficha técnica de LongCat AI.
Para entrenar esto, Meituan convirtió fallas reales de agentes en tareas reproducibles: minó pull requests e issues de GitHub para armar entornos sintéticos con verificación fail-to-pass y pass-to-pass, usó rollouts asíncronos parciales con gradientes acotados por staleness, y metió protecciones contra reward hacking. Dicho de otra forma: en vez de solo mostrarle al modelo ejemplos de código perfecto, le mostraron errores de verdad y lo entrenaron a recuperarse de ellos.
El modelo también soporta entrenamiento mixto entre distintos “harnesses” de agente (Claude Code, Codex, Hermes, OpenClaw, OpenCode y Kilo Code), algo que en la práctica se traduce en cambiar la base URL y listo. En benchmarks propios, LongCat-2.5 saca 91,9 en BrowseComp, 88,4 en Terminal Bench v2.1, 82,1 en PaperBench y 65,1 en AutomationBench (una ventaja de 10 puntos sobre la competencia), según el propio reporte de LongCat. Contra su predecesor, la mejora es grande: en Terminal Bench v4.0 pasó de 3,0 a 38,5, y en DeepSWE v1.1 de 9,7 a 64,6.
¿Son esos números comparables con benchmarks de terceros tipo SWE-bench verificado por fuera de Meituan? Todavía no hay esa validación independiente. Son los números que publica LongCat comparando contra su propio modelo anterior.
¿Qué limitaciones y datos faltan en el lanzamiento de LongCat-2.5?
Al momento de este anuncio, LongCat-2.5 no tiene pricing público ni límites de uso confirmados: el acceso se maneja solo a través del chat y la API de Meituan. Eso cambia el análisis de disponibilidad respecto a LongCat-2.0, que sí es open source.
- Confirmado: lanzamiento el 2 de noviembre de 2026, 1,6T parámetros totales, ~48B activos, contexto de 1M tokens, salida de 128K, disponible ya vía chat y API de Meituan.
- Confirmado: entrenamiento en aceleradores chinos domésticos con cuantización W4A4.
- Pendiente: distribución en GitHub y Hugging Face, anunciada pero sin fecha.
- Pendiente: pricing, rate limits y verificación independiente de los benchmarks.
Si estás evaluando si migrar un workflow de agentes a LongCat-2.5, un criterio práctico antes de comprometer infraestructura: corré el mismo set de tareas que ya usás para medir tu stack actual (no el benchmark que publica el fabricante) y compará tiempos y tasa de error en condiciones reales, no solo en la demo. Mientras no haya pricing público, cualquier cálculo de costo por token es especulación.
LongCat-2.5 y la estrategia de “chips domésticos, modelos domésticos” de Meituan
LongCat-2.5 es la continuación de una apuesta que Meituan viene haciendo desde LongCat-2.0: entrenar modelos de escala trillón de parámetros en hardware chino, sin depender de aceleradores importados. LongCat-2.0, lanzado como open source, fue el primer modelo de esa escala en completar entrenamiento e inferencia en un cluster de 50.000 placas domésticas, según describe el propio sitio de LongCat.
La diferencia clave entre las dos versiones no es solo de capacidad. LongCat-2.0 quedó disponible con pesos abiertos en longcat.ai y OpenRouter, donde según la misma fuente está entre los tres modelos más usados globalmente por volumen de llamadas. LongCat-2.5, en cambio, ships API-only por ahora, algo que contrasta con esa estrategia de apertura y que probablemente tenga más que ver con que todavía es una “preview” que con un cambio de filosofía.
El contexto más amplio: Meituan compite en el mismo terreno que DeepSeek V4 y otros proveedores chinos que apuestan a modelos agentic multimodales con contexto largo, en una carrera donde el acceso a chips de punta importados sigue restringido. La “innovación” que vende LongCat no es solo el tamaño del modelo, sino la idea de que el RL de largo horizonte rinde más que simplemente sumar más tokens de preentrenamiento a esta escala, según plantea el propio sitio de LongCat AI.
Errores comunes al leer el anuncio de LongCat-2.5
- Confundir LongCat-2.5 con LongCat-2.0. El 2.0 es open source y está disponible en longcat.ai y OpenRouter; el 2.5 por ahora es API-only vía Meituan, sin pesos públicos.
- Tomar los benchmarks como validación independiente. Las cifras de BrowseComp, Terminal Bench y PaperBench vienen del propio reporte de LongCat, comparando contra su modelo anterior, no contra una evaluación de terceros.
- Asumir que “nativo multimodal” implica arquitectura nueva desde cero. El tokenizador de visión (RVQ sobre SAE) viene heredado de LongCat-Next, no es un desarrollo exclusivo de esta versión.
- Esperar un precio fijo por token ya. Meituan no publicó pricing ni rate limits al momento del lanzamiento; cualquier estimación de costo circulando por ahí es especulación.
Preguntas Frecuentes
¿Qué es LongCat-2.5 y quién lo desarrolló?
LongCat-2.5 es un modelo de lenguaje multimodal que Meituan lanzó el 2 de noviembre de 2026, orientado a tareas agentic de largo horizonte como codificación, navegación web y diseño. Lo desarrolló el equipo de LongCat dentro de Meituan, la misma empresa china de delivery y servicios locales que ya había liberado LongCat-2.0 y LongCat-Next.
¿Cuántos parámetros tiene LongCat-2.5?
LongCat-2.5 tiene 1,6 billones de parámetros totales, con aproximadamente 48.000 millones activos por cada token procesado. Usa arquitectura Mixture of Experts, lo que le permite mantener ese tamaño total sin que cada inferencia active todos los parámetros a la vez.
¿Qué significa que un modelo sea “nativamente multimodal”?
Significa que el modelo representa imágenes y texto con el mismo vocabulario de tokens desde el diseño de la arquitectura, en vez de usar un encoder de visión separado que después traduce la imagen a texto. En LongCat-2.5, eso se logra con tokens discretos multi-nivel (RVQ sobre features SAE de resolución nativa) heredados de LongCat-Next.
¿Dónde se puede acceder o probar LongCat-2.5?
Por ahora, LongCat-2.5 está disponible a través del chat online y la API de Meituan. La empresa anunció planes de distribución en GitHub y Hugging Face, pero sin fecha confirmada al momento del lanzamiento, y tampoco publicó pricing público.
¿En qué se diferencia LongCat-2.5 de otros modelos agentic chinos?
La diferencia principal está en la combinación de contexto de 1 millón de tokens, visión integrada a nivel de tokens y entrenamiento basado en fallas reales de agentes convertidas en tareas reproducibles. Compite directamente con modelos como DeepSeek V4 en el espacio de agentes multimodales de largo contexto, aunque a diferencia de su propio LongCat-2.0, por ahora no tiene versión open-weight.
Conclusión
LongCat-2.5 confirma que Meituan no se conforma con un modelo de lenguaje grande más: apuesta a que el RL de largo horizonte sobre fallas reales de agentes rinde más, a igual escala de parámetros, que seguir sumando datos de preentrenamiento. Los saltos que muestra contra LongCat-2.0 (de 9,7 a 64,6 en DeepSWE, de 3,0 a 38,5 en Terminal Bench v4.0) son demasiado grandes para ignorarlos, aunque vengan del propio fabricante.
Si tu equipo evalúa modelos para automatizar tareas de agente con componente visual (revisar mockups, leer dashboards, trabajar con capturas de pantalla), LongCat-2.5 entra en la conversación. Pero mientras no haya pesos abiertos, pricing público ni benchmarks de terceros, lo prudente es tratarlo como una opción en evaluación, no como un reemplazo confirmado de lo que ya tenés funcionando.