Actualizado el 23/08/2026: Sumamos el análisis técnico del mecanismo interno de la marca de agua Claude: en qué paso exacto de la generación se aplica el sesgo sobre los tokens y en qué se diferencia de una firma digital tradicional.
En pocas palabras: Desde mediados de agosto de 2026, Anthropic marca el texto que genera Claude con un sesgo estadístico en la elección de tokens según una clave secreta —no caracteres invisibles ni metadata—. Es global, obligatoria y sin opción de desactivarla, por el Article 50 de la EU AI Act.
Anthropic empezó a marcar todo el texto que genera Claude a mediados de agosto de 2026. La marca no son caracteres invisibles ni metadata pegada al archivo: es un sesgo estadístico en cómo el modelo elige las palabras. Responde al Article 50 de la EU AI Act, que entró en vigor el 2 de agosto, y aplica de forma global sin opción de desactivarla.
La marca de agua Claude es una técnica de watermarking estadístico que Anthropic incrusta en los textos que generan sus modelos. Funciona sesgando la selección de tokens según una clave secreta, sin agregar símbolos ocultos ni etiquetas al documento. Su propósito es señalar que Claude procesó ese contenido, aunque no distinga si lo redactó de cero o solo lo corrigió.
En 30 segundos
- Qué pasó: desde mediados de agosto de 2026 Anthropic marca todo el texto que produce Claude, de forma global y obligatoria.
- Cómo: el texto usa una marca estadística (sesgo en la elección de tokens).
- El detalle incómodo: la marca dice “Claude procesó esto”, no “Claude lo escribió”. Si le pedís que te traduzca o corrija un texto tuyo, queda marcado igual.
- Detección: hace falta un detector con la clave secreta (solo Anthropic la tiene).
- Por qué: el disparador es el Article 50 de la EU AI Act, que obliga a marcar contenido sintético.
Anthropic es una empresa estadounidense de investigación en inteligencia artificial fundada en 2021 por investigadores incluyendo Dario Amodei. Desarrolla modelos de lenguaje grandes como Claude, enfocada en seguridad e interpretabilidad de sistemas de IA.
¿Por qué Anthropic implementó la marca de agua Claude Anthropic desde agosto de 2026?
Por regulación europea. El disparador es el Article 50 de la EU AI Act, que entró en vigor el 2 de agosto de 2026 y obliga a los proveedores de IA a marcar el contenido generado de forma artificial para que sea identificable como tal. Anthropic lo anunció a mediados de agosto de 2026.
El detalle que casi nadie leyó bien: aplica global. No es un feature para la UE que vos podés esquivar con una VPN. Si usás Claude desde Buenos Aires, tu texto también sale marcado. En nuestra guía completa sobre Claude profundizamos sobre esto.
¿Cómo funciona la marca de agua estadística de Claude?
La marca viaja en el patrón de palabras, no en el archivo. En cada paso de generación, el modelo divide su vocabulario en dos grupos (llamémoslos tokens “verdes” y “rojos”) usando una clave secreta, y sesga la elección hacia los verdes. Como el sesgo es sutil y depende de la clave, el texto se lee normal, pero un detector con esa misma clave puede medir cuántos tokens verdes hay y calcular la probabilidad de que lo haya escrito Claude. Esto se conecta con lo que analizamos en cómo se compara con Gemini 2.5.
¿Es lo mismo que los caracteres invisibles?
No, y esta confusión es la más común. La marca estadística no mete espacios raros, caracteres Unicode invisibles ni etiquetas HTML. Si abrís el texto y buscás símbolos escondidos, no vas a encontrar nada. La “firma” está en la frecuencia con que aparecen ciertas palabras, algo que solo se detecta corriendo un análisis estadístico sobre el conjunto del texto. Por eso necesitás un mínimo de longitud: los tramos muy cortos quedan exentos porque no hay suficiente material para que la estadística sea confiable.
¿Cómo funciona técnicamente la marca de agua Claude en la generación de texto?
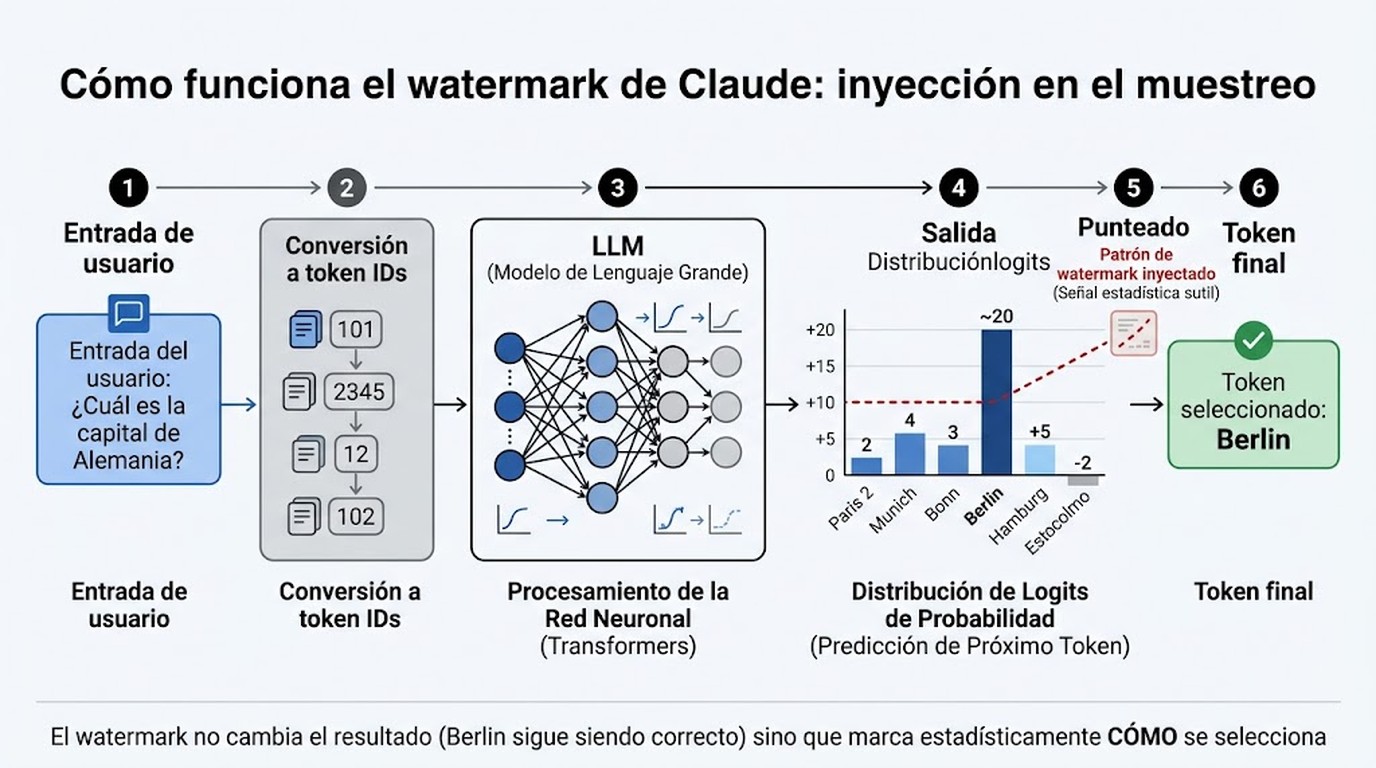
La marca de agua Claude se aplica en el momento exacto en que el modelo elige la siguiente palabra. No es un sello que se estampa sobre el archivo terminado: modifica las probabilidades de selección de cada token mientras el texto se está escribiendo. Por eso ningún editor, inspector de archivos o antivirus la va a encontrar buscando dentro del documento.
Para ubicar ese momento, conviene repasar cómo escribe un modelo de lenguaje. Todo arranca con la tokenización: Claude parte tu prompt en fragmentos llamados tokens, que pueden ser palabras completas, pedazos de palabras o signos de puntuación. La frase “La capital de Alemania es” se convierte en una secuencia de IDs numéricos que la red neuronal sí puede procesar.
- Tokenización: el texto de entrada se divide en tokens, cada uno con su ID numérico. Es la unidad mínima con la que el modelo trabaja.
- Logits: la red neuronal calcula un puntaje para cada token posible del vocabulario, que ronda las decenas de miles de opciones.
- Probabilidades: esos puntajes se convierten en porcentajes que suman 100%. Después de “La capital de Alemania es”, “Berlín” concentra la mayor parte y alternativas como “Múnich” se reparten el resto.
- Muestreo: el sistema sortea el siguiente token respetando esas probabilidades, con un margen de azar regulado por la temperatura del modelo.
El watermark interviene en ese último paso, el muestreo. Según el análisis técnico de Sebastian Raschka, la clave secreta de Anthropic alimenta una función pseudoaleatoria que, combinada con el contexto de la conversación, define en cada instante qué tokens quedan del lado favorecido. Esa dependencia doble —clave más contexto— es lo que impide reconstruir el patrón desde afuera: sin la clave no sabés qué tokens mirar, y el reparto cambia con cada frase.
La consecuencia práctica es contraintuitiva. No hay nada agregado al archivo, así que inspeccionarlo no sirve de nada. La marca está distribuida en miles de decisiones de selección que, tomadas una por una, parecen completamente normales. Recién el análisis conjunto de la secuencia completa deja ver el sesgo.
¿La marca de agua persiste al copiar, pegar y editar el texto?
Sobrevive al copiar y pegar, pero se erosiona con la edición fuerte. Como la marca vive en la distribución de tokens y no en el archivo, mover el texto de un lado a otro no la borra. Lo que sí la degrada es reescribir en serio: parafrasear a fondo, traducir a otro idioma o mezclar el texto de Claude con párrafos escritos por vos diluye la señal hasta que el detector deja de estar seguro.
Ponele que le pedís a Claude un borrador de 600 palabras, cambiás la mitad de las oraciones a mano y le sumás dos párrafos propios. Lo más probable es que la marca quede tan débil que el score resulte ambiguo. Relacionado: las diferencias entre Sonnet y Opus.
Traducido: no es una firma indeleble. Es una probabilidad que baja a medida que el texto se aleja del original.
¿Se puede detectar y remover la marca de agua de Claude?
Detectarla requiere la clave secreta que solo tiene Anthropic, y a agosto de 2026 no hay detector público disponible. Sin esa herramienta, un docente, un editor o una plataforma no puede verificar por su cuenta si un texto salió de Claude. Complementá con Claude vs GPT-4O en características.
Acá viene lo bueno (o lo incómodo): removerla es más fácil que detectarla. Como la marca se disuelve con la paráfrasis y la traducción, cualquiera con ganas de borrarla pasa el texto por otro modelo o lo reescribe y listo. La barrera técnica para limpiar la marca es más baja que la barrera para probarla.
¿Eso la hace inútil? No del todo, pero sí frágil justo contra quien más querría evadirla.
El problema de fondo: la marca no prueba que Claude escribió el texto
La marca solo indica que Claude procesó el contenido, no que lo redactó. Y esa diferencia lo cambia todo. Si le pedís a Claude que te corrija la ortografía de un ensayo tuyo, que te traduzca un párrafo o que te resuma un PDF, el output sale marcado igual que si lo hubiera escrito de cero. El detector no distingue entre “Claude es el autor” y “Claude pasó los ojos por acá”.
Pensá en los casos reales: un estudiante que escribe su trabajo y solo lo pasa por Claude para pulir la gramática queda marcado como si hubiera hecho trampa. Un traductor profesional que usa Claude como asistente también. La marca dice “esto tocó un modelo de IA”, que no es lo mismo que “esto lo generó una IA”, y toda la utilidad de un watermark depende de que esa distinción importe. Sobre eso hablamos en GPT-5 y Anthropic lado a lado.
¿Por qué Ben Thompson dice que es “peor de lo que parece”?
Porque genera una falsa sensación de solución. El argumento central de Ben Thompson en Stratechery es filosófico antes que técnico: el watermark parece resolver el problema de identificar la “IA slop”, pero en realidad crea una ilusión sin resolver la pregunta que importa, que es quién escribió de verdad el texto.
El punto: la marca implica un consentimiento y un control que el usuario no tiene. Es obligatoria, global y sin opt-out. Vos generás un texto, Claude lo firma sin preguntarte, y esa firma queda pegada a algo que quizás escribiste vos y solo mandaste a revisar.
Hay un segundo riesgo del que se habló poco. Si el mundo empieza a asumir que “sin marca = humano” y “con marca = IA”, los falsos negativos se vuelven peligrosos: alcanza con parafrasear para lavar la marca y pasar por humano, mientras el que usó Claude de forma honesta para corregir queda escrachado. La “seguridad” que promete el sistema premia justo al que la esquiva. Lo explicamos a fondo en integrar Claude con Make.com.
Marca de agua: Claude vs ChatGPT vs Gemini
Anthropic quedó como el primero de los grandes en marcar texto de forma global y obligatoria. OpenAI y Google se movieron antes en imágenes que en texto. Este es el estado a agosto de 2026, con la salvedad de que las políticas cambian rápido.
| Proveedor | Marca en texto | Marca en imágenes | Detector público |
|---|---|---|---|
| Claude (Anthropic) | Sí, estadística, global y obligatoria (ago 2026) | — | No todavía |
| Gemini (Google) | SynthID-Text existe; despliegue parcial según reportes | Sí, SynthID en imágenes, audio y video | SynthID con acceso limitado |
| ChatGPT (OpenAI) | Sin watermark de texto público desplegado | Metadata de procedencia C2PA en imágenes | No para texto |
¿En qué se diferencia la marca de agua de Claude de una firma digital?
Una firma digital valida integridad: cualquier modificación del documento, hasta un espacio cambiado, la rompe. La marca de agua Claude funciona al revés: es probabilística, tolera ediciones leves y no acredita autoría, solo indica qué modelo pasó por el texto.
En un PDF firmado, el sistema calcula un hash del contenido y lo cifra con una clave privada. Cualquiera con la clave pública puede verificar que el archivo está intacto y quién lo firmó. Es un esquema binario, sin grises: válido o inválido.
El watermark estadístico eligió otro camino porque el texto no se comporta como un documento cerrado. Se copia, se pega, se reformatea y se recorta todo el tiempo; un marcador criptográfico moriría en el primer ctrl+v. Y forzar palabras específicas para meter una firma degradaría la redacción, algo que un modelo comercial no puede permitirse. Según la posición oficial de Anthropic, el objetivo es identificar contenido sintético sin castigar la calidad del output.
Esa flexibilidad es fortaleza y talón de Aquiles a la vez. La marca sobrevive al uso normal del texto pero cede ante quien la reescribe con intención. Una firma digital sería más difícil de lavar y más fácil de verificar; también volvería imposible editar nada. Entre ambos extremos, Anthropic optó por lo estadístico, y la discusión sobre si fue la elección correcta sigue abierta.
Qué está confirmado y qué no
- Confirmado: Anthropic anunció el watermarking a mediados de agosto de 2026 y aplica a todo el texto de Claude, a nivel global.
- Confirmado: el disparador es el Article 50 de la EU AI Act, vigente desde el 2 de agosto de 2026.
- Confirmado: los textos usan marca estadística en tokens; los tramos muy cortos quedan exentos.
- No confirmado: qué tan resistente es la marca ante ediciones combinadas (paráfrasis más traducción más mezcla). No hay verificación independiente todavía.
Errores comunes sobre la marca de agua de Claude
- Creer que son caracteres invisibles: no lo son. La marca de texto es estadística, no un símbolo oculto que podés buscar y borrar con un reemplazo.
- Pensar que prueba autoría: la marca dice que Claude procesó el contenido, no que lo escribió. Corregir o traducir con Claude deja marca igual.
- Asumir que es indeleble: se erosiona con paráfrasis fuerte, traducción o mezcla con texto propio. Persiste al copiar y pegar, no a la reescritura seria.
- Suponer que ya podés detectarla: a agosto de 2026 no hay detector público, así que ningún tercero puede verificar por su cuenta.
- Creer que solo afecta a Europa: aplica global. No depende de tu ubicación ni podés desactivarla.
Preguntas Frecuentes
¿Qué es la marca de agua de Claude?
Es una técnica de watermarking que Anthropic incrusta en los textos generados por Claude para señalar que son contenido de IA. En texto es un sesgo estadístico en la elección de palabras según una clave secreta. Arrancó a mediados de agosto de 2026. Más contexto en Claude frente a Google.
¿Se puede remover la marca de agua de un texto?
Sí, se degrada con edición fuerte. Parafrasear a fondo, traducir a otro idioma o mezclar el texto con párrafos propios diluye la señal hasta que el detector deja de estar seguro. Copiar y pegar tal cual, en cambio, no la borra porque la marca vive en el patrón de tokens, no en el archivo.
¿La marca de agua prueba que Claude escribió el texto?
No. Solo indica que Claude procesó ese contenido, sin distinguir entre redactarlo desde cero y corregir, traducir o resumir un texto que escribiste vos. Esa es la crítica central: un ensayo humano solo pulido con Claude sale marcado igual que uno generado por completo por la IA. Más contexto en acceder a Claude 3 Opus vía API.
¿Cómo saber si un texto tiene la marca de Claude?
Por ahora no podés, salvo que seas Anthropic. La detección necesita la clave secreta que solo tiene la empresa.
¿Puedo desactivar la marca de agua en Claude?
No. La marca es obligatoria, global y sin opción de opt-out, tanto para usuarios de la app como para quienes consumen la API. Aplica a todos los outputs sin importar el país desde donde uses Claude.
¿La marca de agua de Claude afecta la calidad del texto?
El sesgo está diseñado para ser imperceptible: empuja la elección hacia ciertos tokens sin imponer palabras forzadas ni frases raras. Existe un trade-off técnico entre la fuerza de la marca y la naturalidad de la redacción, y el ajuste busca que la lectura no se note. En textos largos, el efecto acumulado de miles de elecciones sesgadas es justo lo que le da señal al detector.
¿La marca de agua funciona en textos escritos en español?
Sí. El mecanismo opera sobre tokens, no sobre un idioma en particular, así que las respuestas de Claude en español salen marcadas igual que las que produce en inglés. Lo que cambia es la confiabilidad de la detección: cuantas más palabras tenga el texto, más señal estadística acumula y menos ambiguo resulta el score del detector.
Conclusión
El estado de la cuestión a fines de agosto de 2026: la marca de agua Claude lleva un par de semanas activa sobre todos los outputs, funciona como un sesgo estadístico aplicado durante la generación y no se puede apagar desde ningún país. Técnicamente es un diseño elegante; en la práctica, todavía no entrega lo que la gente espera de ella.
Por qué importa: cubre el requisito del Article 50 de la EU AI Act, pero no prueba autoría, no distingue entre un texto escrito por Claude y uno solo corregido por él, y sigue sin detector público. La brecha entre “Claude procesó esto” y “Claude lo escribió” sigue siendo el punto débil del sistema.
Qué mirar de acá en adelante: las primeras pruebas independientes de robustez ante ediciones combinadas y si OpenAI y Google responden con marcas propias en texto. Mientras tanto, si trabajás con contenido, seguí documentando tu proceso y tratá la marca como una señal débil, nunca como una prueba.