
En pocas palabras: No existe un carácter escondido para borrar: la marca de agua de Claude es un patrón estadístico tejido en la elección de palabras del modelo, según el Claude Help Center. No se puede “remover” sin reescribir el texto, ya que no altera significado ni legibilidad y viaja al copiar y pegar.
Si buscaste “Claude watermark remover” pensando que hay un carácter escondido para borrar, la respuesta oficial de Anthropic te va a sorprender: la marca de agua Claude no es un carácter Unicode agregado al texto, sino un patrón estadístico tejido en la elección de palabras del modelo, según confirma el Claude Help Center.
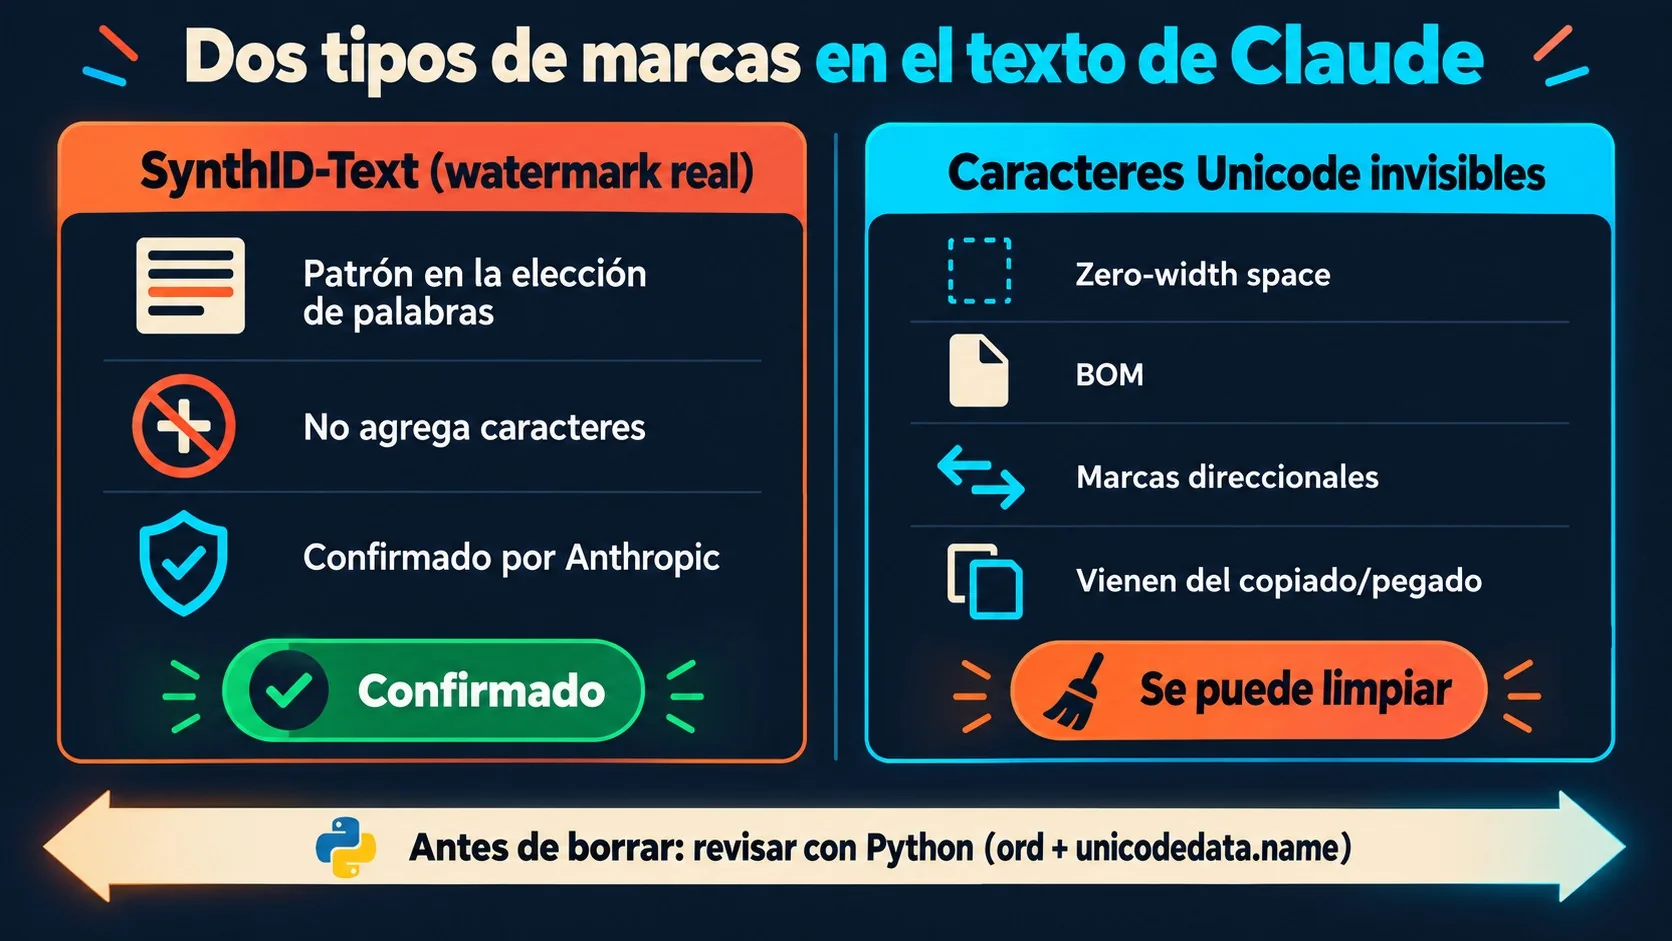
La marca de agua de Claude es el mecanismo que Anthropic empezó a implementar para cumplir con el Reglamento de IA de la Unión Europea (el Código de Prácticas del Artículo 50(2)). Consiste en modificar sutilmente las probabilidades con las que el modelo elige cada palabra, sin insertar caracteres especiales ni tocar el significado o la legibilidad del texto generado.
En este artículo:
- En 30 segundos
- ¿Claude agrega realmente marcas ocultas a su texto?
- ¿Cómo marca Claude el contenido generado?
- ¿Qué modelos de Claude ya tienen el watermark activo?
- ¿Por qué aparecen caracteres Unicode invisibles al copiar texto de Claude?
- ¿Cómo detecto caracteres Unicode ocultos en un texto?
- ¿Cómo limpio el texto sin alterar su significado?
- ¿Qué riesgos tienen las herramientas online de “Claude watermark remover”?
- ¿Qué hago si la limpieza cambia el significado del texto?
- ¿Qué está confirmado sobre la marca de agua de Claude y qué todavía no?
- Errores comunes al lidiar con marcas ocultas en texto de Claude
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La marca de agua real de Claude es un patrón lingüístico invisible en la elección de palabras, no un carácter Unicode agregado, según el Claude Help Center.
- Los modelos lanzados desde el 2 de agosto de 2026 en la UE traen watermarking desde el día uno; Anthropic prometió sumar a los modelos anteriores antes del 2 de diciembre de 2026.
- La detección oficial del watermark está en vista previa privada, limitada por ahora a reguladores, medios, fact-checkers e investigadores independientes.
- Los caracteres Unicode invisibles (zero-width spaces, BOM, word joiners) que aparecen al copiar texto de Claude vienen del navegador o editor de destino, no del modelo en sí.
- Ningún “Claude watermark remover” de terceros puede confirmar que borra el watermark real porque Anthropic todavía no publicó el método técnico completo.
¿Claude agrega realmente marcas ocultas a su texto?
No, al menos no en el sentido que sugieren varios sitios que venden “limpiadores”. El watermark de Claude no inserta zero-width spaces ni ningún carácter extra: es una técnica que altera la probabilidad con la que el modelo elige cada palabra, sin cambiar un solo byte visible del texto.
Acá está la confusión que circula. Un artículo de terceros publicado en dev.to explica, con razón, que los caracteres Unicode invisibles pueden viajar en un texto copiado. El problema es que ese mismo artículo desliza, casi de pasada, que un “Claude watermark remover” browser-based sirve para “limpiar” ese texto. Ojo con esto: limpiar caracteres Unicode no tiene nada que ver con remover la marca de agua real de Anthropic. Son dos capas completamente distintas del problema.
La marca de agua real no se puede ver, no se puede copiar como carácter y, por ahora, tampoco se puede verificar de forma pública. ¿Alguien confirmó de forma independiente que algún removedor online borra esa marca? Todavía no, porque el método técnico completo ni siquiera está publicado.
¿Cómo marca Claude el contenido generado?
Claude usa una técnica de watermarking propia para marcar su texto generado. La idea central: el modelo tiene, en cada paso de generación, varias palabras candidatas con probabilidades parecidas; el watermark inclina esa elección de forma imperceptible, dejando una firma estadística que solo un detector especializado puede leer. Sobre eso hablamos en cómo la marca de agua identifica contenido generado.
Según el Claude Help Center, esta marca “viaja con el texto cuando se copia y pega en otro lugar, y puede persistir a través de algunas ediciones”. Eso es lo que la hace útil para trazabilidad, y también lo que la hace inútil de “borrar” con un limpiador de Unicode: no hay ningún código de punto que remover porque el watermark no vive en los caracteres, vive en el patrón lingüístico completo.
Anthropic aplica esta marca en Claude Platform (API), Claude, Claude Code, Claude Cowork y Claude Tag, en cualquier lugar del mundo donde se ofrezca el modelo. Cuando Claude genera un archivo compatible (PNG o JPEG, por ejemplo), suma además Content Credentials bajo el estándar C2PA, la misma metodología de procedencia que usa buena parte de la industria.
¿Qué modelos de Claude ya tienen el watermark activo?
No todos los modelos tienen la misma cobertura todavía. Los lanzados a partir del 2 de agosto de 2026 soportan marcado desde el lanzamiento; los anteriores están en proceso de sumarse, con fecha límite comprometida para el 2 de diciembre de 2026, según el mismo comunicado oficial.
| Modelo | Watermark en Claude/API | Watermark en AWS, Google Cloud o Microsoft Foundry | Content Credentials (C2PA) en archivos |
|---|---|---|---|
| Claude Opus 5 | Sí | Gradual desde 14/09/2026, completo en una semana | Sí |
| Claude Fable 5.1 | Sí | Sí | Sí |
| Claude Sonnet 5 | Sí | No | No |
| Claude Haiku 4.5 | Sí | No | No |
| Claude Opus 4.5 | Sí | No | No |
¿Por qué aparecen caracteres Unicode invisibles al copiar texto de Claude?
Esos caracteres vienen del recorrido del texto entre aplicaciones, no del modelo. Cuando una respuesta de Claude pasa de un navegador a un editor de texto enriquecido y de ahí a una herramienta de código, puede arrastrar espacios de ancho cero, word joiners, marcas de orden de bytes (BOM) o controles direccionales que ya estaban en el origen: una página web, un editor rich-text o una conversión de archivo.
Nada de esto significa que todo carácter no-ASCII sea sospechoso. Los acentos, los emoji y buena parte de los sistemas de escritura del mundo dependen de Unicode para existir. El objetivo, según la guía de dev.to, es una limpieza puntual, no reducir el texto a caracteres básicos en inglés.
Fijate en estas señales típicas de que algo invisible se coló en tu texto:
- Fallas de búsqueda: buscás una palabra que ves perfectamente en pantalla y el buscador no la encuentra.
- Saltos raros del cursor: el cursor se mueve de forma inconsistente entre letras que parecen contiguas.
- Conteos de caracteres que no cierran: el editor cuenta más caracteres de los que ves a simple vista.
¿Cómo detecto caracteres Unicode ocultos en un texto?
Guardá una copia intacta del texto antes de tocar nada. Después, inspeccioná el fragmento sospechoso con un editor Unicode-aware o un script corto que imprima cada punto de código, comparando siempre el resultado limpio contra el original antes de sobrescribir cualquier cosa. Tema relacionado: guía completa con todo sobre Claude.
En Python, esto se resuelve con dos funciones básicas: ord(caracter) te da el valor numérico de cada carácter, y unicodedata.name(caracter, 'unknown') te devuelve una etiqueta legible de qué es ese carácter. Corrés esto sobre una muestra corta, no sobre toda la conversación de una, y anotás qué código sacaste y por qué. El paso final es volver a pasar el texto por la aplicación que originalmente lo había rechazado, para confirmar que el problema desapareció.
¿Cómo limpio el texto sin alterar su significado?
La forma segura es armar una allowlist: un conjunto acotado de caracteres conocidos como problemáticos, y nada más. Se preservan saltos de línea, espacios normales, puntuación, acentos y emoji, salvo que el formato de destino exija otra cosa.
El tema es que la limpieza automática tiene que asistir la edición, no reescribirla en silencio. Revisá el resultado a mano. Un script que borra “todo lo raro” sin criterio puede llevarse por delante contenido legítimo en otros idiomas o formatos de texto que sí necesitan esos caracteres para funcionar.
¿Qué riesgos tienen las herramientas online de “Claude watermark remover”?
El riesgo principal es que prometen algo que no pueden cumplir. Como Anthropic no publicó el método completo de detección de su watermark, ningún tercero está en condiciones de confirmar que su herramienta “remueve” esa marca real, según se desprende de las propias limitaciones que reconoce el Claude Help Center.
Lo que en el mejor de los casos hacen estas herramientas es limpiar caracteres Unicode visibles a nivel de código, el mismo trabajo que podés hacer vos con un script de diez líneas. Subís tu texto a un conversor online, le pedís que “limpie” la marca de agua, te devuelve algo visualmente idéntico, lo pegás en tu documento y quedás con la sensación de haber resuelto el problema, cuando en realidad lo único que tocó fue un puñado de caracteres invisibles que ni siquiera son el watermark de verdad. Ya lo cubrimos antes en diferencias entre los modelos Sonnet y Opus.
Hay un riesgo adicional, menos comentado: pegar texto sin revisar en una herramienta de terceros que no conocés implica mandarle ese contenido a un servidor ajeno. Si el texto tiene información sensible, ese paso solo suma un problema nuevo al que ya tenías.
¿Qué hago si la limpieza cambia el significado del texto?
Deshacé la operación de inmediato y compará ambas versiones lado a lado. Tratá cada limpieza como reversible desde el arranque: guardá el original, documentá qué regla aplicaste y validá el resultado final en el lugar donde realmente se va a usar.
Los caracteres de control importan en contextos específicos. En texto right-to-left, las marcas direccionales cumplen una función real. En código o archivos de datos, algunos caracteres de control tienen significado propio y borrarlos rompe el archivo. El texto invisible sigue siendo dato: sacá solo lo que entendés, y nada más. Lo complementamos en el caso de Azure DevOps MCP y Claude.
¿Qué está confirmado sobre la marca de agua de Claude y qué todavía no?
Hay una parte de esto respaldada por comunicados oficiales de Anthropic y otra parte que sigue en desarrollo. Separarlas evita expectativas que hoy no se pueden cumplir. En qué puede probar realmente esta marca profundizamos sobre esto.
- Confirmado: Anthropic firmó el Código de Prácticas del Artículo 50(2) del Reglamento de IA de la UE sobre transparencia de contenido generado por IA.
- Confirmado: los modelos lanzados desde el 2 de agosto de 2026 soportan marcado desde el día del lanzamiento, y el resto de los modelos tendrá watermark antes del 2 de diciembre de 2026.
- Confirmado: la detección de watermark existe hoy en vista previa privada, disponible solo para organizaciones elegibles bajo la ley europea (reguladores, medios, fact-checkers, investigadores independientes).
- No confirmado: Anthropic todavía no publicó la metodología técnica completa de marcado y detección; prometió “guía técnica más detallada conforme esté disponible”.
- No confirmado: no hay evidencia pública, propia ni de terceros, de que alguna herramienta externa logre remover el watermark real de un texto.
Errores comunes al lidiar con marcas ocultas en texto de Claude
- Confundir el watermark real con caracteres Unicode invisibles: son dos capas distintas del problema; limpiar una no toca la otra.
- Pegar texto de Claude directo en sistemas sensibles a espacios sin revisar antes: conviene pasar primero por un chequeo con allowlist en vez de descubrir el problema en producción.
- Confiar en un “remover” online sin código abierto ni verificación independiente: mejor correr un script propio con
ord()yunicodedata.name()sobre una muestra corta. - Sobrelimpiar y borrar acentos o emoji legítimos: la limpieza debe apuntar solo a los caracteres identificados como problemáticos, no a todo lo que no sea ASCII básico.
Preguntas Frecuentes
¿Claude pone marca de agua a los textos que genera?
Sí, en los modelos que ya soportan la función. Anthropic embebe un patrón estadístico imperceptible en la elección de palabras del texto generado, sin agregar caracteres visibles ni invisibles adicionales, según confirma el Claude Help Center.
¿Cómo elimino caracteres invisibles de un texto copiado de Claude?
Guardá una copia original, inspeccioná el texto con un script en Python usando ord() y unicodedata.name() para identificar cada carácter sospechoso, y borrá solo los que confirmes como problemáticos con una lógica de allowlist.
¿Es seguro usar un “Claude watermark remover” online?
No hay garantía de que esas herramientas hagan lo que prometen, porque el método real de watermarking de Anthropic no está publicado. En el mejor de los casos limpian caracteres Unicode visibles a nivel de código, no la marca de agua lingüística.
¿Por qué falla la búsqueda o el conteo de caracteres en un texto pegado desde Claude?
Porque el texto arrastró caracteres invisibles heredados del navegador, editor o conversión de archivo por donde pasó antes de llegar a vos, como zero-width spaces o marcas de orden de bytes, no porque Claude los haya insertado.
Conclusión
La marca de agua de Claude y los caracteres Unicode invisibles son dos problemas distintos que la web mezcló en uno solo. La primera es un mecanismo lingüístico de Anthropic para cumplir con la normativa europea, sin caracteres que remover. Los segundos son basura de formato heredada del recorrido del texto entre aplicaciones, y esos sí se pueden limpiar con un script bien acotado.
Si te ofrecen un “Claude watermark remover” que promete borrar la marca real, tomalo con pinzas: nadie fuera de Anthropic puede confirmar eso hoy. Lo que sí podés hacer, con total seguridad, es armar tu propio proceso de limpieza de Unicode con Python, documentar qué sacás y validar siempre contra el original antes de dar por cerrado el trabajo.