En pocas palabras: Se logra guardando el embedding junto al ítem en DynamoDB, usando su búsqueda vectorial nativa (agosto de 2026) más embeddings de Amazon Bedrock (Titan V2), sin base de datos vectorial dedicada ni pipeline de sincronización externo.
Armás un agente en AWS Lambda, lo probás, le contás algo importante en la sesión 1 y en la sesión 2 el bicho no tiene la menor idea de qué le estás hablando. Le preguntás el nombre del cluster de producción y te devuelve, literal, un pedido de que se lo repitas. Eso es lo que documentó un desarrollador en un post técnico publicado en dev.to, y la solución que armó usa memoria semántica para agentes de IA con búsqueda vectorial nativa de DynamoDB, sin sumar una base de datos vectorial dedicada ni un pipeline de sincronización.
La memoria semántica en agentes de IA es la capacidad de un sistema de recuperar información pasada por significado, no por coincidencia exacta de palabras, incluso entre ejecuciones que no comparten ningún contexto previo. Se implementa guardando un embedding vectorial junto al dato original y buscando por similitud de significado. Amazon DynamoDB agregó esta búsqueda de forma nativa en agosto de 2026, sin pipeline externo.
En este artículo:
- En 30 segundos
- ¿Por qué un agente de IA pierde el contexto entre conversaciones?
- Ejemplo hipotético: un bot de soporte que no te hace repetir el reclamo
- ¿Qué diferencia hay entre state, session y memoria a largo plazo en un agente de IA?
- ¿Cómo funciona la búsqueda vectorial nativa de DynamoDB?
- ¿Es obligatorio usar una base de datos vectorial dedicada para hacer RAG?
- Criterios para decidir entre DynamoDB Vectors y una vector DB dedicada
- ¿Cómo se generan los embeddings con Amazon Titan y Bedrock?
- ¿Cómo se conecta el store de memoria al agente Strands Harness?
- ¿DynamoDB Vectors es más rápido o más barato que S3 Vectors?
- ¿Qué significa esto para equipos que operan infraestructura en Latinoamérica?
- Errores comunes al implementar memoria semántica sin vector database
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- DynamoDB ahora tiene búsqueda vectorial nativa: el embedding vive en el mismo ítem, un solo PutItem guarda dato y vector juntos, sin segundo servicio.
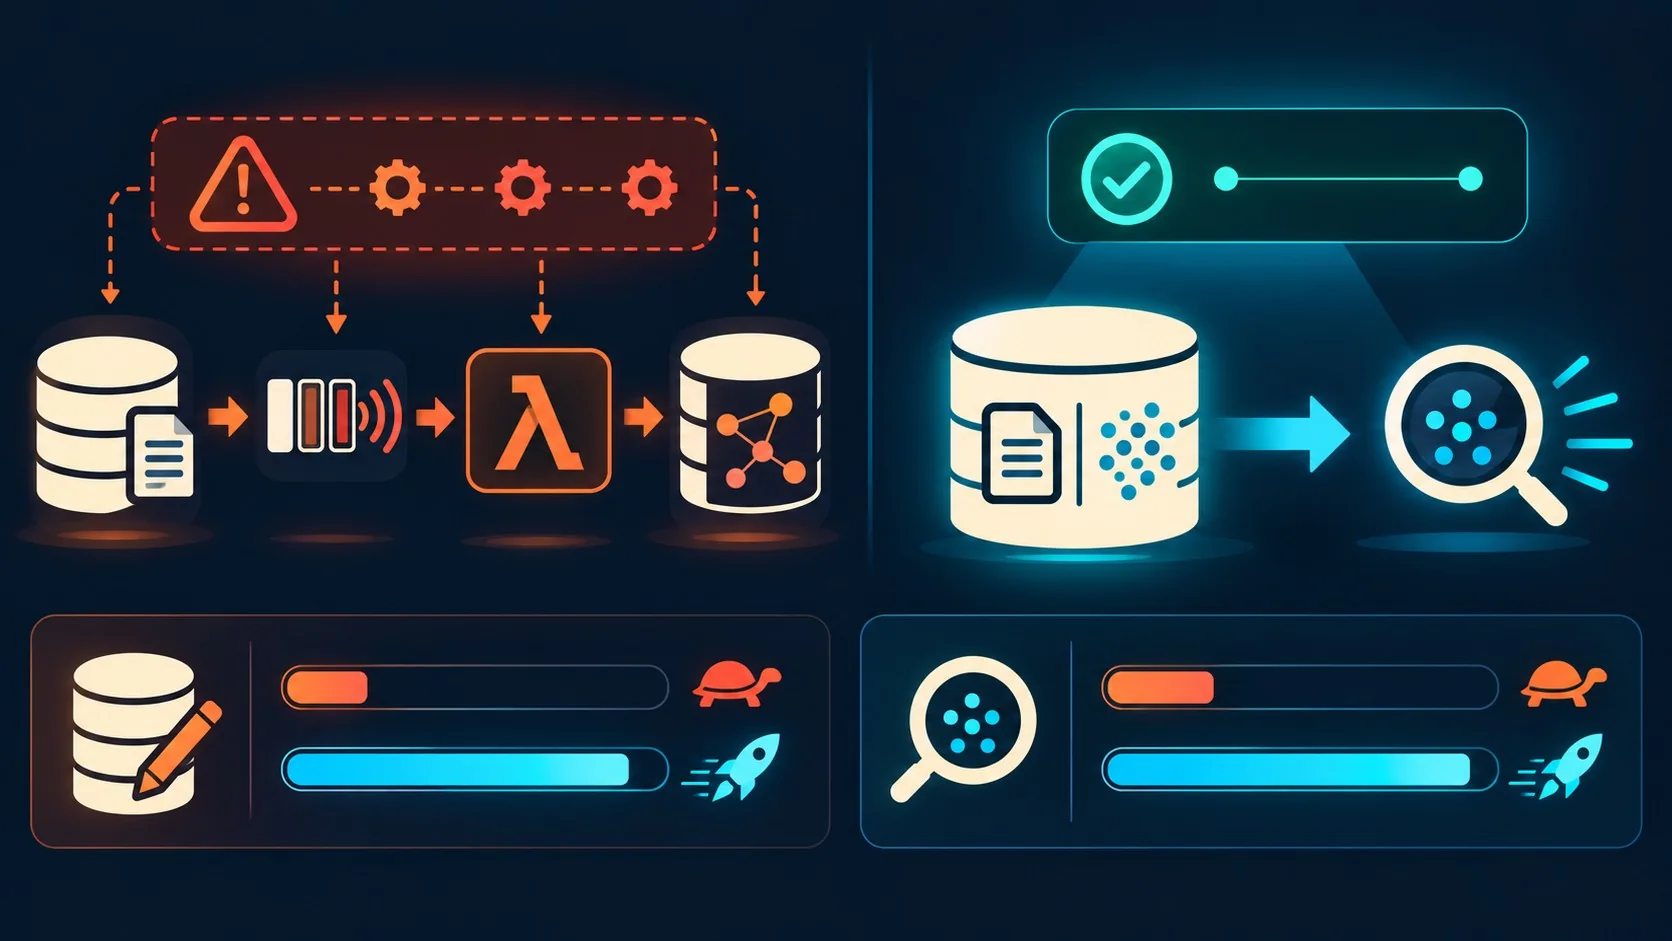
- Es más rápido que un store dedicado: en pruebas sobre us-east-1, DynamoDB Vectors fue ~2.5x más veloz escribiendo (121.05 ms vs 304.36 ms, p50) y ~1.4x más veloz buscando (122.09 ms vs 167.15 ms, p50) que S3 Vectors.
- Los embeddings salen de Amazon Titan Text Embeddings V2: vía Bedrock, con 1024 dimensiones y normalización a vector unitario.
- Hay tres capas de memoria distintas: state, session y memoria a largo plazo, y mezclarlas es la causa típica de que un agente “recuerde lo que no debe y olvide lo que sí”.
- Requiere Boto3 actualizado: la versión 1.43.64 o superior del SDK de Python para AWS agrega soporte de VectorIndexes en DynamoDB.
¿Por qué un agente de IA pierde el contexto entre conversaciones?
Un agente pierde el contexto entre conversaciones porque el contenedor que lo ejecutó murió y el que lo reemplaza no tiene forma de saber qué pasó antes. En AWS Lambda esto no es una metáfora: cada invocación puede correr en un contenedor nuevo, así que cada turno es, en la práctica, un agente recién nacido sin cuaderno y sin memoria.
El ejemplo real que muestra el post es este intercambio, tomado de una ejecución de demo.py:
- Usuario, en la sesión 2: “¿Cómo se llama mi cluster de producción y en qué región está?”
- El agente llama a una tool, no encuentra nada, y responde pidiendo que le repitan el dato.
Nunca vio esa conversación. No es un bug de razonamiento, es arquitectura: sin memoria persistente, cada sesión arranca de cero. ¿Y a quién le pega esto? A cualquiera que corra agentes serverless, donde el ciclo de vida del cómputo es más corto que el de la conversación real con el usuario.
¿Qué es la memoria semántica en agentes de IA?
Es la capa que guarda hechos, preferencias y decisiones pasadas de forma durable y los recupera por significado, no por coincidencia textual. Si en una conversación le contaste al agente que preferís desplegar los martes a la mañana y semanas después le preguntás “¿cuándo conviene lanzar el release?”, la memoria semántica encuentra ese dato aunque no comparta ni una palabra con la pregunta. Complementá esto corriendo modelos localmente con Ollama.
Ejemplo hipotético: un bot de soporte que no te hace repetir el reclamo
Ejemplo hipotético (no es un caso real ni un dato del post, es solo para bajar el problema a algo cotidiano): pensá en un bot de soporte técnico de hosting que atiende consultas por chat. El lunes, un cliente le cuenta que su plan actual no soporta tareas cron, y el bot le explica que necesita subir de plan. Esa conversación se cierra. El miércoles, mismo cliente, sesión nueva —otro contenedor, cero memoria compartida—, y escribe: “¿por qué mi tarea programada no corre nunca?” Sin memoria semántica, el bot no tiene forma de conectar esa pregunta con la limitación que ya le habían explicado dos días antes, así que vuelve a pedir el diagnóstico desde cero. Es exactamente el mismo fallo que describe el post con el cluster de producción, solo que puesto en un caso de atención al cliente en vez de infraestructura.
Con un store como el descripto en el post —el embedding de “mi plan no soporta cron jobs” guardado junto al ítem en DynamoDB— la pregunta del miércoles, aunque no comparte ninguna palabra clave con la del lunes, dispara una búsqueda por significado que sí encuentra el antecedente. El bot puede responder directo en vez de reabrir el caso. La diferencia entre un bot que “parece tener memoria” y uno que la tiene de verdad está, casi siempre, en si alguien implementó esta capa o no.
¿Qué diferencia hay entre state, session y memoria a largo plazo en un agente de IA?
Son tres capas con ciclo de vida distinto y mezclarlas es el error de diseño más común. State es un key/value que usan tu app y tus tools entre requests, no va al modelo salvo que vos lo inyectes. Session es el historial de una conversación puntual y sí forma parte del contexto que recibe el modelo. Memoria a largo plazo son datos durables, recuperados por significado, que persisten entre ejecuciones sin relación entre sí, para siempre, y se inyectan antes de cada turno.
| Capa | Qué es | Duración | ¿Va al modelo? |
|---|---|---|---|
| State | key/value de app y tools | Entre requests | No, salvo inyección manual |
| Session | Historial de una conversación | Hasta que se deje de reanudar ese id | Sí, es el contexto |
| Memoria a largo plazo | Datos durables por significado | Entre ejecuciones sin relación, para siempre | Se inyecta antes de cada turno |
Pensalo como un asistente personal al que reemplazan por otra persona cada vez que le hablás: state es la nota adhesiva sobre el escritorio, session es el cuaderno de la reunión de hoy, y la memoria a largo plazo es que el asistente de verdad se acuerde de tu preferencia semanas después, aunque la formules con otras palabras. El framework Strands Harness expone justo dos interruptores para esto: session para reanudar una conversación puntual y memory para llevar datos entre todas las ejecuciones. Son ortogonales, uno sobrevive al teardown de Lambda y el otro sobrevive a todo.
¿Cómo funciona la búsqueda vectorial nativa de DynamoDB?
La búsqueda vectorial nativa de DynamoDB guarda el vector como un atributo más del ítem, en la misma tabla que tus datos operacionales, así que un solo PutItem escribe el dato y su embedding juntos, y una sola llamada a SearchVectors busca por significado. No hay segundo servicio ni pipeline de sincronización corriendo aparte.
El índice se declara al crear la tabla, no después: agregarlo sobre una tabla que ya tiene ítems dispara un backfill que pagás en tiempo de reloj. Según el ejemplo del post, la declaración necesita que Dimensions coincida con la salida del modelo de embeddings (1024 para Titan V2) y que DistanceFunction coincida con cómo generaste los vectores (COSINE para embeddings normalizados a longitud unitaria). Si estos dos valores no calzan, la búsqueda devuelve resultados vacíos sin avisar nada —y ese silencio es, en la práctica, el bug más difícil de diagnosticar de todo el setup. Tema relacionado: montar un agente local con Hermes Desktop.
Ojo con algo que no es obvio: BillingMode tiene que ser PAY_PER_REQUEST. Es obligatorio para usar índices vectoriales, no una opción entre varias. Y que DescribeTable reporte ACTIVE no significa que el endpoint de búsqueda ya responda, tema que retomo más abajo porque fue justo uno de los dolores de cabeza reales de la implementación.
¿Es obligatorio usar una base de datos vectorial dedicada para hacer RAG?
No. Según el anuncio oficial de AWS del 5 de agosto de 2026, DynamoDB ahora resuelve búsqueda vectorial de forma nativa, así que para RAG, memoria de agentes o recomendaciones ya no hace falta correr un segundo motor solo para eso.
El enfoque clásico arma DynamoDB más Streams más un worker Lambda que sincroniza contra un motor de búsqueda vectorial externo, con la latencia extra que trae la consistencia eventual de ese pipeline. La ruta nativa se queda con una sola pieza: la tabla, sin sincronización, con búsquedas que el post reporta en milisegundos de un dígito dentro de la misma región. El blog oficial de AWS lista los casos de uso típicos: búsqueda semántica, motores de recomendación, RAG, memoria de agentes y detección de fraude o anomalías, todos corriendo sobre datos que ya vivían en DynamoDB.
Eso sí: esto no mata a las vector DB dedicadas en todos los escenarios. Si tu operación ya corre en DynamoDB y solo necesitás sumar recuperación semántica, evitarte un segundo servicio es un golazo. Si tu stack no tiene nada que ver con DynamoDB, migrar todo solo para esto no te cierra.
Criterios para decidir entre DynamoDB Vectors y una vector DB dedicada
Con lo que muestran las dos fuentes se puede armar una checklist simple, para no tener que pensarlo de cero cada vez que aparece este dilema:
- Tu dato operacional ya vive en DynamoDB: sumar el índice vectorial evita levantar y pagar un segundo servicio solo para búsqueda semántica.
- Estás arrancando un proyecto nuevo, sin infraestructura de vectores previa: menos piezas móviles significa menos cosas que puedan romperse en producción. Empezar nativo es el camino de menor fricción.
- Ya operás una vector DB dedicada en producción, con SLAs conocidos y equipo que la sabe operar: el ahorro de latencia que reporta el benchmark no siempre justifica una migración. Cambiar de motor tiene un costo de por sí.
- Tu volumen de escrituras y búsquedas es chico o moderado: el costo de las dos llamadas facturables por operación (Bedrock más DynamoDB) es marginal. Con volúmenes muy grandes, ese cálculo merece hacerse antes, no después de migrar.
- Necesitás filtros de búsqueda muy sofisticados sobre múltiples campos: vale la pena revisar qué tan madura está la función de filtrado inline de DynamoDB Vectors para tu caso puntual antes de asumir que cubre lo mismo que un motor especializado.
Ninguno de estos criterios reemplaza medir con tu propia carga real. Son un punto de partida para no arrancar la discusión en cero, no un veredicto cerrado.
¿Cómo se generan los embeddings con Amazon Titan y Bedrock?
DynamoDB almacena y busca vectores, pero no los genera: ese trabajo lo hace tu código llamando a Amazon Bedrock. El helper del post invoca el modelo amazon.titan-embed-text-v2:0 con dimensions=1024 y normalize=True, lo que produce vectores de longitud unitaria, justo lo que necesita una búsqueda por COSINE. Sobre eso hablamos en bajar drásticamente el gasto en APIs de LLM.
Cada escritura semántica y cada búsqueda terminan siendo dos llamadas facturables, una a Titan y otra a DynamoDB. Por eso el rol de IAM necesita el permiso bedrock:InvokeModel, no alcanza con darle acceso solo a DynamoDB. Es un detalle chico que, si te lo saltás, te puede dejar media tarde buscando por qué el agente tira error de permisos en un lugar que ni se te ocurrió mirar.
¿Cómo se conecta el store de memoria al agente Strands Harness?
Se conecta implementando el protocolo MemoryStore de Strands con dos métodos, add() y search(), y pasando ese store al constructor del agente con memory={"stores": [store]}. El Harness queda dueño de la inyección de contexto y de la tool search_memory, vos solo le das el backend.
El método add() genera el embedding del contenido y lo guarda como vector buscable en una sola escritura. El método search() genera el embedding de la consulta y devuelve las memorias más parecidas por significado, acotadas a un tenant mediante la partition key. Cuando ese mismo store se conecta a un agente real, el flujo completo se ve así: el usuario pregunta por una preferencia de timing para el próximo release, el Harness llama a search_memory, saca la preferencia guardada semanas antes en otra conversación, y se la inyecta al modelo antes de que responda. En el ejemplo documentado, el score de similitud coseno entre la pregunta (“when does this user like to ship releases?”) y el dato guardado (“deployments to happen on Tuesday mornings”) dio 0.6665, pese a no compartir ninguna palabra de contenido.
¿DynamoDB Vectors es más rápido o más barato que S3 Vectors?
Según el benchmark del post, DynamoDB Vectors fue más rápido que S3 Vectors tanto escribiendo como buscando, medido en us-east-1 con 30 embeddings de Titan V2 (1024 dims) y 30 búsquedas con TopK=5, corridas desde fuera de AWS, así que los números incluyen el round trip cliente-región. En el uso de Rust en agentes de código profundizamos sobre esto.
| Store | Write p50 | Write p95 | Search p50 | Search p95 |
|---|---|---|---|---|
| DynamoDB Vectors | 121.05 ms | 130.24 ms | 122.09 ms | 140.87 ms |
| S3 Vectors | 304.36 ms | 401.06 ms | 167.15 ms | 257.27 ms |
La diferencia en escritura (~2.5x) es más marcada que en búsqueda (~1.4x). Tomalo con pinzas: es un benchmark de un solo autor, con una muestra chica y corrido desde fuera de la VPC, no un paper con revisión de terceros. Sirve como orden de magnitud, no como número definitivo para tu caso. Si tu carga real tiene otro volumen o corre dentro de la misma VPC, la brecha probablemente cambie, y el único modo de saberlo es medirlo vos mismo con tu tráfico.
¿Qué significa esto para equipos que operan infraestructura en Latinoamérica?
Para un equipo en Argentina o la región, el punto práctico es la latencia de red hacia la región de AWS elegida: los números de arriba ya incluyen ese round trip, así que corriendo desde fuera de us-east-1 vas a sumar milisegundos extra sobre esa base. Un criterio simple para decidir dónde correr el cliente: si tus usuarios finales están mayormente en Latinoamérica pero tu backend habla con una región de AWS en EE.UU., esa latencia de ida y vuelta va a pesar más en el search p95 que en el p50, porque es justo la cola la que sufre más con distancias largas. Vale la pena medir ese round trip real antes de asumir que los números del benchmark aplican tal cual a tu arquitectura.
Si parte de tu stack necesita hosting o dominios locales por fuera del agente en sí, tener esa infraestructura con un proveedor argentino como donweb.com te evita saltos de latencia innecesarios para la parte del sitio que no vive en AWS.
Errores comunes al implementar memoria semántica sin vector database
El primero, y el que más tiempo hizo perder según el propio post, es escribir sin await. Los métodos add() y search() son async, y una escritura sin await devuelve una corrutina y no hace nada, sin excepción, sin fila, sin error visible. Corrés la demo, no explota nada, y la tabla queda vacía. Es el tipo de bug que te hace dudar de vos mismo antes de dudar del código.
- Confiar en que DescribeTable diga ACTIVE: el estado de la tabla puede estar ACTIVE mientras el endpoint de búsqueda todavía no responde. La corrección es hacer polling con una llamada real a
SearchVectorshasta ver un resultado, no solo chequear el status de la tabla. - Descuidar que Dimensions y DistanceFunction coincidan: si el número de dimensiones del índice no matchea con el modelo de embeddings, o la función de distancia no coincide con cómo se generaron los vectores, la búsqueda devuelve resultados vacíos o irrelevantes sin tirar error.
- Agregar el índice vectorial después de cargar datos: declararlo al crear la tabla evita un backfill que se paga en tiempo de reloj sobre datos ya existentes.
- Olvidar el permiso de Bedrock: darle al rol de IAM acceso solo a DynamoDB y no a
bedrock:InvokeModelrompe la generación de embeddings en el peor momento.
Preguntas Frecuentes
¿Por qué un agente de IA pierde el contexto entre conversaciones?
Porque en plataformas serverless como AWS Lambda el contenedor que ejecutó el turno anterior puede morir antes del siguiente, y sin una capa de memoria persistente cada invocación arranca sin saber nada de lo anterior. La solución es separar la sesión (una conversación puntual) de la memoria a largo plazo (datos durables recuperados por significado).
¿Cómo funciona la búsqueda vectorial nativa de DynamoDB?
El embedding se guarda como un atributo más del ítem en la misma tabla operacional, con un índice vectorial declarado en la creación de la tabla que define dimensiones y función de distancia. Una sola llamada a SearchVectors devuelve los ítems más parecidos por significado, sin pipeline de sincronización contra un motor externo.
¿Qué diferencia hay entre state, session y memoria a largo plazo en un agente de IA?
State es información key/value entre requests que no llega al modelo salvo inyección manual, session es el historial de una conversación puntual que sí forma parte del contexto, y memoria a largo plazo son datos durables recuperados por significado que se inyectan antes de cada turno, sin importar si la conversación actual tiene algo en común con la anterior.
¿Es obligatorio usar una base de datos vectorial dedicada para hacer RAG?
No, desde agosto de 2026 DynamoDB soporta búsqueda vectorial nativa, con lo cual se puede hacer RAG, memoria de agentes o búsqueda semántica usando una sola tabla como store operacional e índice vectorial a la vez. Sigue teniendo sentido una vector DB dedicada en escenarios que no usan DynamoDB como base, o donde ya hay una operando con SLAs conocidos.
¿DynamoDB Vectors es más rápido o más barato que S3 Vectors?
En el benchmark medido en us-east-1 con 30 escrituras y 30 búsquedas TopK=5, DynamoDB Vectors fue aproximadamente 2.5 veces más rápido escribiendo (121.05 ms contra 304.36 ms de p50) y 1.4 veces más rápido buscando (122.09 ms contra 167.15 ms de p50) que S3 Vectors. Es una muestra chica de un solo test, no un benchmark independiente a gran escala.
Conclusión
Lo que cambió es concreto: ya no hace falta levantar un segundo servicio solo para que un agente recuerde cosas por significado. Si tu operación ya vive en DynamoDB, sumar el índice vectorial en la creación de la tabla y conectar el store al Strands Harness resuelve el problema con una sola pieza de infraestructura menos. El trade-off real está en la latencia de red según dónde corras el cliente, en las dos llamadas facturables por cada escritura o búsqueda (Titan más DynamoDB), y en la disciplina de separar bien state, session y memoria a largo plazo antes de escribir una línea de código. Si vas a probarlo, arrancá midiendo tu propio caso, con la checklist de arriba como filtro inicial: el benchmark de un post es un punto de partida, no un veredicto.