En pocas palabras: Mixer es un editor 3D open source (licencia MIT) de Artem Podloboshnikov que convierte texto en archivos GLB usando LLMs locales como Ollama, LM Studio o un llama-server integrado. Pesa cerca de 567 MB y corre en Windows, Linux y Mac sin depender de internet.
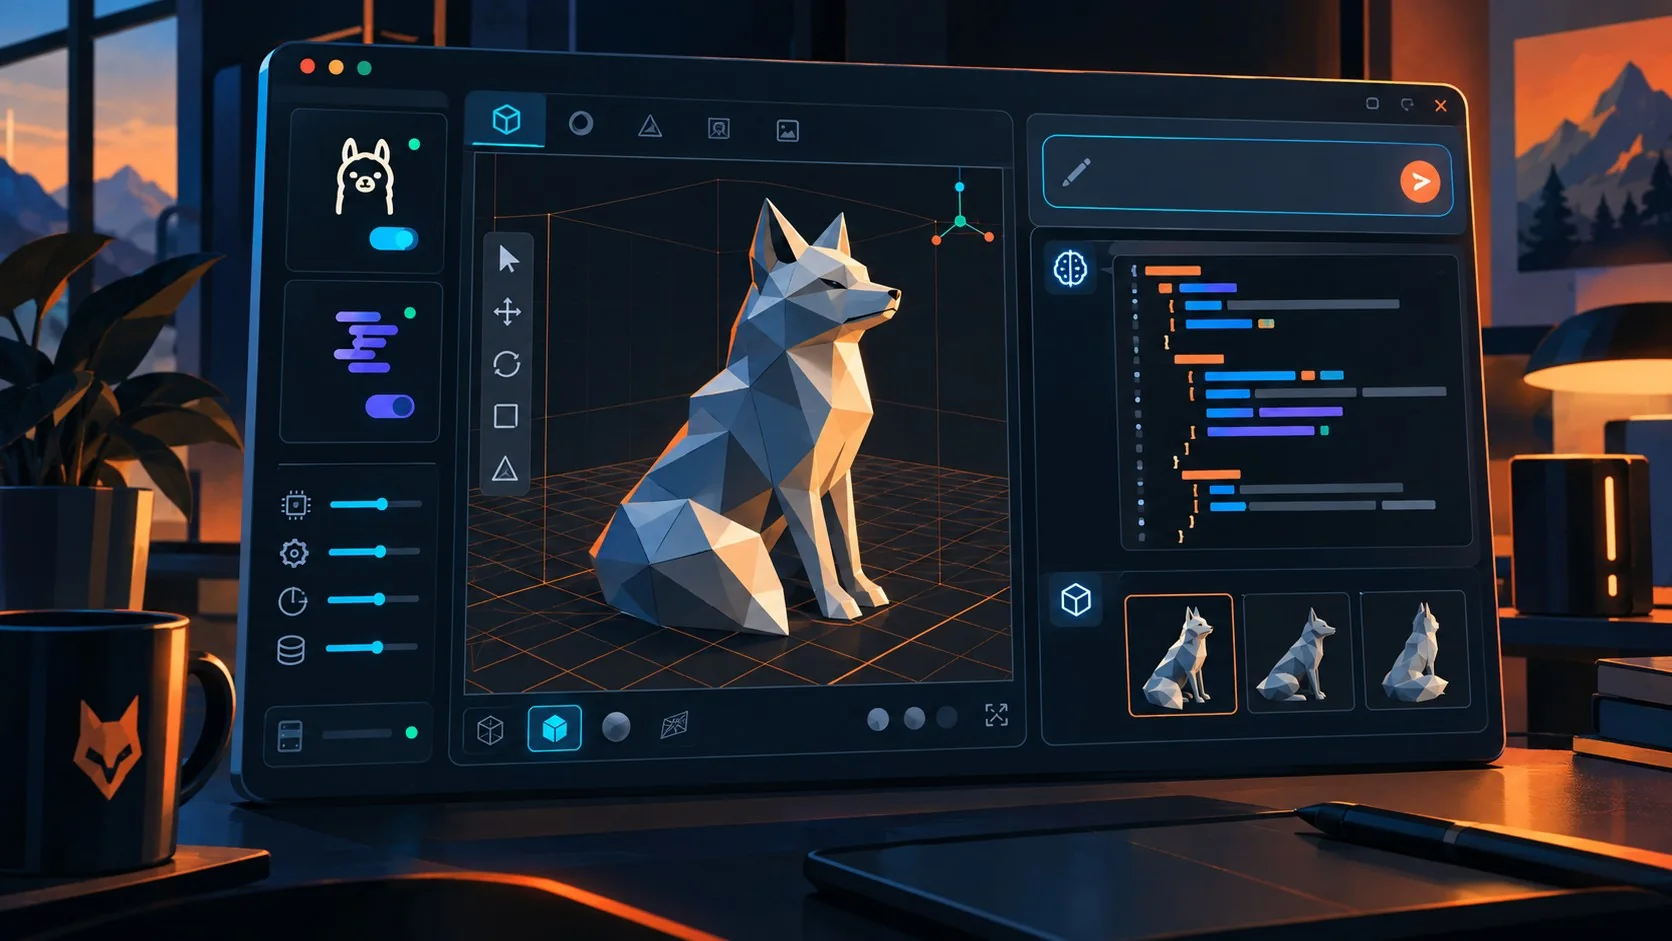
Mixer es una aplicación de escritorio construida con Tauri v2, SvelteKit y Rust: es un editor 3D con IA local donde vos describís en texto qué querés crear o modificar, y un LLM (local o en la nube) genera un manifiesto JSON que la app convierte en archivo GLB. Lo desarrolla Artem Podloboshnikov bajo licencia MIT, con el código publicado en GitHub.
En este artículo:
- En 30 segundos
- ¿Cómo convierte Mixer un texto en un modelo 3D?
- ¿Qué LLMs locales soporta Mixer?
- ¿Para quién está pensado este editor y para quién no?
- Criterios para decidir si Mixer te sirve o no
- ¿Qué se puede hacer además de generar desde cero?
- ¿Cuánto pesa Mixer y qué licencia tiene?
- ¿Qué límites tiene hoy el editor?
- Errores comunes al usar Mixer
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Mixer es un editor 3D con IA local, open source (licencia MIT), que genera archivos GLB a partir de texto: el LLM escribe el manifiesto JSON, no “dibuja”.
- Se conecta a Ollama, LM Studio o a un llama-server integrado en la propia app, sin depender de internet.
- También acepta proveedores cloud como OpenAI, Anthropic y OpenRouter para quien prefiera modelos más grandes.
- El instalador pesa alrededor de 567 MB por el llama-server embebido, con builds para Windows (.exe), Linux (.deb) y Mac (.dmg).
- Permite subir referencias 3D o un modelo propio y editarlo por nodo, por segmento de animación, o ambos a la vez.
¿Cómo convierte Mixer un texto en un modelo 3D?
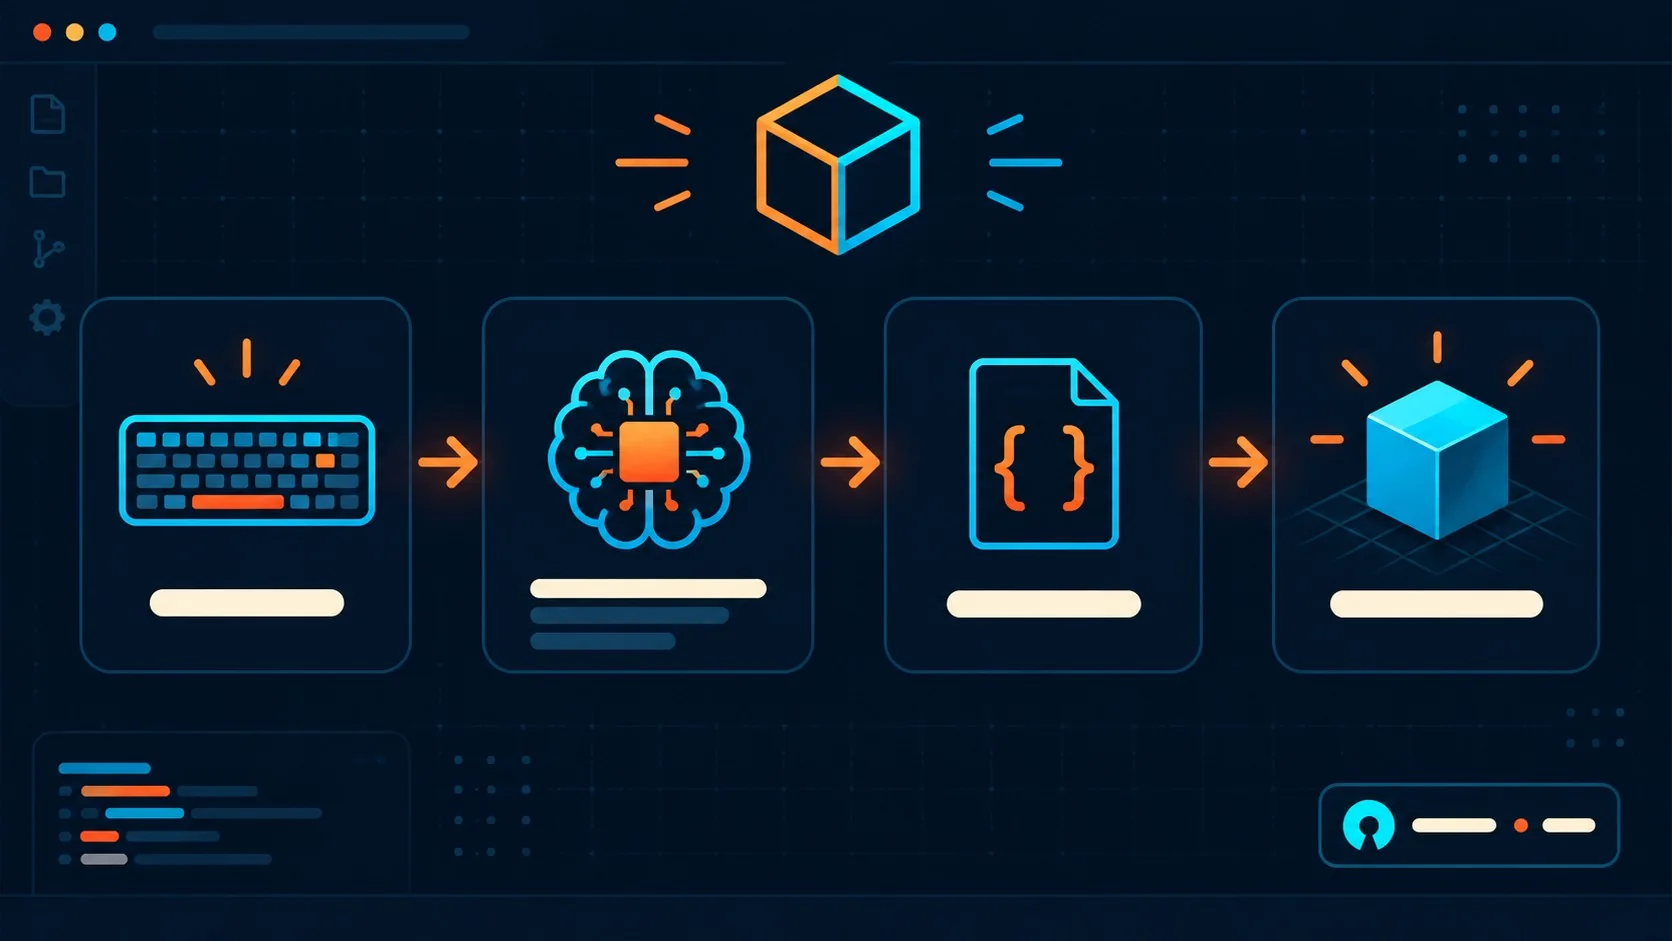
Mixer no le pide al LLM que dibuje nada. Le pide que escriba un manifiesto en JSON con nodos, posiciones, índices y, si hace falta, animaciones, y la aplicación traduce ese JSON directo a un archivo GLB. Es como si dictaras por teléfono a un escultor y él fuera tallando según tus indicaciones, según describe el propio post original del desarrollador en dev.to.
El formato de abajo es concreto. Cada nodo lleva positions (un array plano de floats en tríos x, y, z) e indices (los tríos de vértices que forman cada triángulo). Si el modelo necesita moverse, las animaciones se describen con channels que apuntan a un nodo y un path (traslación, rotación o escala), donde la rotación siempre usa cuaterniones en formato [x,y,z,w]. La app parsea esa respuesta, extrae el JSON aunque venga envuelto en markdown, y guarda el GLB en la carpeta de exportación que configuraste.
Esto tiene una implicancia práctica que vale la pena entender: como la salida es texto estructurado (JSON) y no un render, cualquier LLM que sepa escribir JSON válido puede en teoría generar geometría, incluso uno chico corriendo local. La contracara es que ese mismo modelo tiene que “imaginar” en números las coordenadas de un objeto tridimensional sin ver nada, algo bastante distinto a generar una imagen. Por eso la calidad depende tanto del tamaño del modelo: no es solo cuestión de fluidez del lenguaje, es razonamiento espacial puro escrito en floats.
Ejemplo hipotético (ilustrativo, no una prueba realizada): imaginemos que le pedís a Mixer “hacé una silla simple de cuatro patas”. El LLM tendría que generar nodos con posiciones para el asiento y cada pata, más los índices que arman los triángulos de cada superficie. Con un modelo grande, es esperable que la geometría resultante tenga proporciones razonables entre patas y asiento. Con un modelo local chico, es más probable que aparezcan patas de largo desparejo o vértices que no cierran bien la malla, simplemente porque generar coordenadas 3D coherentes a partir de texto es una tarea de razonamiento espacial exigente. Este es un escenario hipotético para ilustrar el mecanismo, no un resultado verificado.
¿Y si el LLM se equivoca en la geometría? Pasa. La calidad depende directamente de la capacidad del modelo que estés usando, así que con un modelo chico como qwen3:4b corriendo en Ollama, no esperes la misma prolijidad que con un modelo cloud grande.
¿Qué LLMs locales soporta Mixer?
Mixer ofrece tres caminos para correr un LLM local sin tocar la nube: conectarte a Ollama con un botón, tirarle una carpeta de modelos .gguf para que arranque el llama-server que viene integrado, o apuntar a LM Studio de forma manual. Los tres funcionan sin conexión a internet una vez que tenés el modelo descargado. Ya lo cubrimos antes en configurar tu propio entorno de IA local.
Con Ollama, el flujo es ollama pull qwen3:4b seguido de ollama serve, y después en Settings → Local models → puerto 11434 → botón “Ollama” para que la app detecte el servicio arrancado. Con LM Studio tenés que habilitar el Local Server (puerto 1234 por defecto), cargar un modelo ahí, y recién ahí conectar desde Mixer, ojo que este paso es totalmente manual. La tercera opción, el llama-server embebido, arranca como sidecar dentro de la propia app y suma aceleración por GPU vía -ngl cuando detecta librerías CUDA instaladas.
Lo interesante es que Mixer no se cierra a lo local. También soporta proveedores cloud (OpenAI, Anthropic, OpenRouter) usando un cliente unificado basado en el SDK de OpenAI, según detalla el repositorio en GitHub. Eso te da margen para arrancar con un modelo cloud potente y después migrar a local cuando ya tengas el flujo probado.
¿Para quién está pensado este editor y para quién no?
Mixer está pensado para quien no tiene acceso a modelos top de gama que hacen 3D directo en el chat, no es artista 3D profesional y prefiere trabajar con LLMs locales. El propio desarrollador lo dice sin vueltas en su publicación: “esto es para vos si no tenés acceso a modelos top-tier, no sos un artista 3D profesional y te gustan los LLMs locales”.
Del otro lado está claro también. Si abrís Blender todos los días, subdividís mallas sin pensarlo y estás cómodo con ese flujo, Mixer no te va a resolver nada nuevo. El propio autor lo aclara: “no es para vos si estás subdiviendo en Blender todos los días y estás cómodo con eso”. Sobre eso hablamos en un agente de IA local gratuito.
Es una herramienta pensada para el que abre Blender una vez cada seis meses, mira los botones, y se acuerda de que se olvidó dónde estaba el extrude (spoiler: le pasa a casi todos). Ahí Mixer funciona como puente entre la idea y el objeto 3D, sin pasar por la curva de aprendizaje de un software de modelado tradicional.
Criterios para decidir si Mixer te sirve o no
Más allá de la descripción del propio autor, hay algunas preguntas concretas que pueden ayudarte a decidir antes de instalar los 567 MB:
- ¿Necesitás precisión geométrica o solo una base rápida? Si el objeto final va a un pipeline profesional (juego, render de producto, impresión 3D exacta), Mixer sirve como punto de partida para después pulir en Blender, no como herramienta final. Si lo que buscás es un placeholder o un boceto 3D rápido, ahí sí encaja directo.
- ¿Tu hardware banca un modelo local decente? Con GPU y librerías CUDA disponibles, el llama-server embebido acelera vía
-ngly podés probar modelos algo más grandes que un simple 4B. Sin GPU, es esperable que la geometría generada sea más básica, según lo que ya vimos sobre el vínculo entre tamaño de modelo y calidad del resultado. - ¿Vas a editar por nodo o vas a regenerar todo de una? Si tu flujo implica ajustar partes puntuales de un modelo (una pata, un brazo, un segmento de animación), la edición granular por nodo es la función que más rinde. Si solo generás objetos completos desde cero cada vez, esa granularidad no te aporta tanto.
- ¿Te importa que los datos no salgan de tu máquina? Si el criterio es privacidad o simplemente no depender de una API paga, la combinación con Ollama o el llama-server local cumple ese objetivo sin matices. Si priorizás calidad por sobre todo, conectar un proveedor cloud desde la misma app es la opción más directa.
¿Qué se puede hacer además de generar desde cero?
Mixer permite subir modelos de referencia y un objeto propio para editarlo, además de generar geometría nueva desde un prompt en blanco. Estas dos funciones amplían bastante el uso real de la herramienta más allá del “escribí y aparece un cubo”.
- Referencias no editables: podés cargar modelos que sirven de inspiración de estilo y estructura. Cada referencia se describe automáticamente (cantidad de mallas, vértices, triángulos, bounding box, lista de animaciones y nombres de nodos) y esa descripción se inyecta en el prompt del sistema del LLM.
- Geometría simplificada opcional: si tenés muchas referencias y el contexto del modelo es chico, podés activar la extracción de geometría simplificada con downsampling uniforme. La cantidad de vértices por nodo se configura desde la interfaz.
- Modo edición sobre un modelo propio: subís un GLB o GLTF existente y pasás a modo edición para modificarlo con instrucciones de texto, en vez de arrancar de cero.
- Edición granular por nodo o segmento: según qué tengas seleccionado (un nodo, un segmento de tiempo, ambos, o nada), la app decide qué geometría sale del modelo activo hacia el LLM y qué se preserva intacto.
Esa lógica de selección es la parte menos obvia del proyecto. Seleccionás un nodo y se va la geometría de todo el modelo activo, del nodo seleccionado y de las referencias; seleccionás nodo más segmento y encima se va la animación de ese tramo puntual. Cambiar el modelo activo resetea nodo y segmento, así que si vas y venís entre modelos sin prestar atención, terminás editando algo que no querías. Complementá con reducir costos frente a las APIs en la nube.
¿Cuánto pesa Mixer y qué licencia tiene?
El instalador de Mixer pesa alrededor de 567 MB, según reconoce el propio desarrollador en su publicación, y esa mole corresponde casi por completo al llama-server que viene embebido dentro del programa. Tauri v2 en sí es liviano (corre sobre Rust), así que si compilás la versión sin el servidor incluido, el tamaño baja bastante.
El proyecto tiene licencia MIT: podés hacer fork, romperlo, mandarle un pull request. El código fuente completo está en github.com/ArtemPodloboshnikov/Mixer, con builds listos para descargar en la sección de Releases para Windows (.exe), Linux (.deb) y Mac (.dmg). Si preferís compilarlo vos mismo, el flujo es clonar el repo, correr npm install y después npm run tauri dev para desarrollo o npm run tauri build para producción.
¿Qué límites tiene hoy el editor?
Mixer es un proyecto en desarrollo activo y su propio creador lo dice de manera literal: lo va ampliando a medida que se topa con limitaciones, y recomienda apretar “Update” cada tanto porque puede haber novedades. No es un producto terminado con roadmap fijo, es el trabajo de una sola persona que lo va parchando según sus propias necesidades.
La calidad de lo que generás está atada al modelo que elegiste. Un modelo local chico como qwen3:4b va a devolver geometrías más simples que un modelo cloud grande, sencillamente porque tiene menos capacidad para razonar sobre estructuras complejas. Tampoco hay garantía de soporte oficial: es software open source hecho por una persona, así que si te trabás, la vía es abrir un issue en GitHub o directamente meter mano en el código. En proteger tu modelo con firewall y nginx profundizamos sobre esto.
Errores comunes al usar Mixer
- Esperar la misma calidad con cualquier modelo: un modelo local de 4B parámetros no genera geometría con la misma prolijidad que un modelo cloud grande. Si podés, probá primero con OpenAI o Anthropic para calibrar qué esperar, y después bajá a local sabiendo la diferencia.
- Subir demasiadas referencias sin simplificar: si cargás varias referencias con geometría completa y el contexto del modelo es chico, el LLM se queda sin espacio para procesar el prompt. La corrección es activar el downsampling en Settings y bajar el límite de vértices por nodo.
- Confundir qué se edita según la selección: si no seleccionás ningún nodo, la geometría de las referencias no sale del modelo activo, y eso genera resultados que parecen “no tener en cuenta” lo que subiste. Seleccioná explícitamente el nodo o el segmento antes de pedir un cambio.
- No actualizar la app: como el proyecto cambia seguido según reconoce el propio autor, quedarte con una build vieja te deja afuera de correcciones y features nuevas sin darte cuenta.
Preguntas Frecuentes
¿Qué es Mixer, el editor 3D con IA local?
Mixer es una aplicación de escritorio open source que convierte descripciones de texto en modelos 3D, usando un LLM que escribe un manifiesto JSON en vez de dibujar geometría directamente. Está hecha con Tauri v2, SvelteKit y Rust, con licencia MIT, y la desarrolla Artem Podloboshnikov.
¿Cómo funciona un editor 3D que convierte texto en modelo 3D?
El usuario escribe una instrucción, el LLM genera un JSON con nodos (posiciones, índices, material) y opcionalmente animaciones, y Mixer convierte automáticamente ese JSON en un archivo GLB exportado a la carpeta configurada. No hay dibujo manual de por medio: todo pasa por la generación de ese manifiesto.
¿Necesito conexión a internet para usar Mixer?
No, si usás Ollama, LM Studio o el llama-server integrado en la app, Mixer corre por completo local sin depender de internet. La conexión solo hace falta si elegís un proveedor cloud como OpenAI, Anthropic u OpenRouter.
¿Qué modelos de IA soporta Mixer (Ollama, LM Studio, llama.cpp)?
Mixer soporta Ollama (puerto 11434), LM Studio (puerto 1234) y un llama-server basado en llama.cpp que corre embebido dentro de la propia aplicación como sidecar. También soporta proveedores cloud como OpenAI, Anthropic y OpenRouter mediante un cliente unificado.
¿Mixer es gratis y de código abierto?
Sí, Mixer es gratis y de código abierto bajo licencia MIT, con el código fuente completo disponible en GitHub para fork, modificación o pull requests. El proyecto acepta donaciones opcionales por crypto o transferencia, pero no cobra nada por usarlo.
Conclusión
Mixer llena un hueco puntual: el de quien quiere un modelo 3D rápido, sin abrir Blender ni acordarse de dónde está el extrude, y prefiere que la IA corra en su propia máquina en vez de mandar datos a un servidor ajeno. No compite con un software de modelado profesional, ni pretende hacerlo.
Lo que hace bien es concreto: tres formas distintas de conectar un LLM local, edición granular por nodo o animación, y exportación a formatos estándar como GLB, GLTF, OBJ, PLY y STL. Lo que todavía no tiene es la madurez de un proyecto con equipo detrás, así que si lo probás, hacelo con la expectativa de una herramienta en desarrollo activo, no de un producto terminado. Si te interesa, lo lógico es arrancar con un modelo chico en Ollama, ver qué tan lejos llega la geometría que te devuelve usando los criterios de arriba, y recién después decidir si vale la pena sumar un modelo más grande o pasar a cloud.