En pocas palabras: Un desarrollador construyó una app RAG con Next.js, desplegada en Vercel, usando el modelo de embeddings de Gemini para búsqueda por similitud en memoria, sin base de datos vectorial dedicada ni backend propio, funcionando enteramente en infraestructura de tier gratuito.
Un desarrollador armó una app RAG (Retrieval-Augmented Generation) completa usando el modelo de embeddings de Gemini, Next.js y Vercel, sin pagar un peso de infraestructura: nada de base de datos vectorial dedicada, nada de backend propio. Todo corre en el tier gratuito, con búsqueda por similitud en memoria y carga de documentos en tiempo real, según el proyecto publicado en Dev.to.
RAG con Gemini es la combinación de un modelo de embeddings de Google (que convierte texto en vectores numéricos) con un modelo de chat que genera respuestas usando solo el contenido recuperado de tus propios documentos, en vez de depender del conocimiento general con el que fue entrenado. El objetivo es simple: que la IA responda con lo que vos le diste de leer, no con lo que “cree” saber.
En este artículo:
- En 30 segundos
- ¿Qué es RAG (Retrieval-Augmented Generation) y cómo funciona?
- ¿Cómo se construyó esta app RAG con el modelo de embeddings de Gemini?
- Ejemplo hipotético: así se vería este patrón en un caso chico
- ¿Qué la diferencia de un chatbot genérico? Transparencia y carga de documentos en vivo
- Criterios de decisión: ¿búsqueda en memoria o base vectorial dedicada?
- ¿Qué límites tiene esta implementación gratuita de RAG?
- ¿Qué lecciones deja este desarrollo para armar tu propio sistema RAG?
- Errores comunes al construir un sistema RAG
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La app RAG se construyó con Next.js, se desplegó en Vercel y usa exclusivamente infraestructura de tier gratuito, sin backend dedicado.
- Cada documento se divide en fragmentos superpuestos, se convierte en vectores con el modelo de embeddings de Gemini y se compara por similitud de coseno contra la pregunta del usuario.
- No hay base de datos vectorial externa: la búsqueda por similitud corre en memoria, algo que solo funciona bien con conjuntos de documentos chicos o medianos.
- El sistema muestra qué documentos fundamentan cada respuesta y permite subir archivos .txt en vivo, sin redeploy, para verificar en tiempo real que no está inventando nada.
- El paper original de RAG, publicado por Patrick Lewis y su equipo en 2020, es la base teórica de todo este patrón de arquitectura.
¿Qué es RAG (Retrieval-Augmented Generation) y cómo funciona?
RAG funciona combinando dos memorias: una paramétrica (lo que el modelo aprendió durante el entrenamiento) y otra no paramétrica (un índice de documentos que consultás en el momento). Esta idea la formalizó el paper de Patrick Lewis y coautores en arXiv, publicado originalmente el 22 de mayo de 2020 y revisado por última vez en abril de 2021, donde combinaron un modelo seq2seq preentrenado con un índice vectorial denso de Wikipedia.
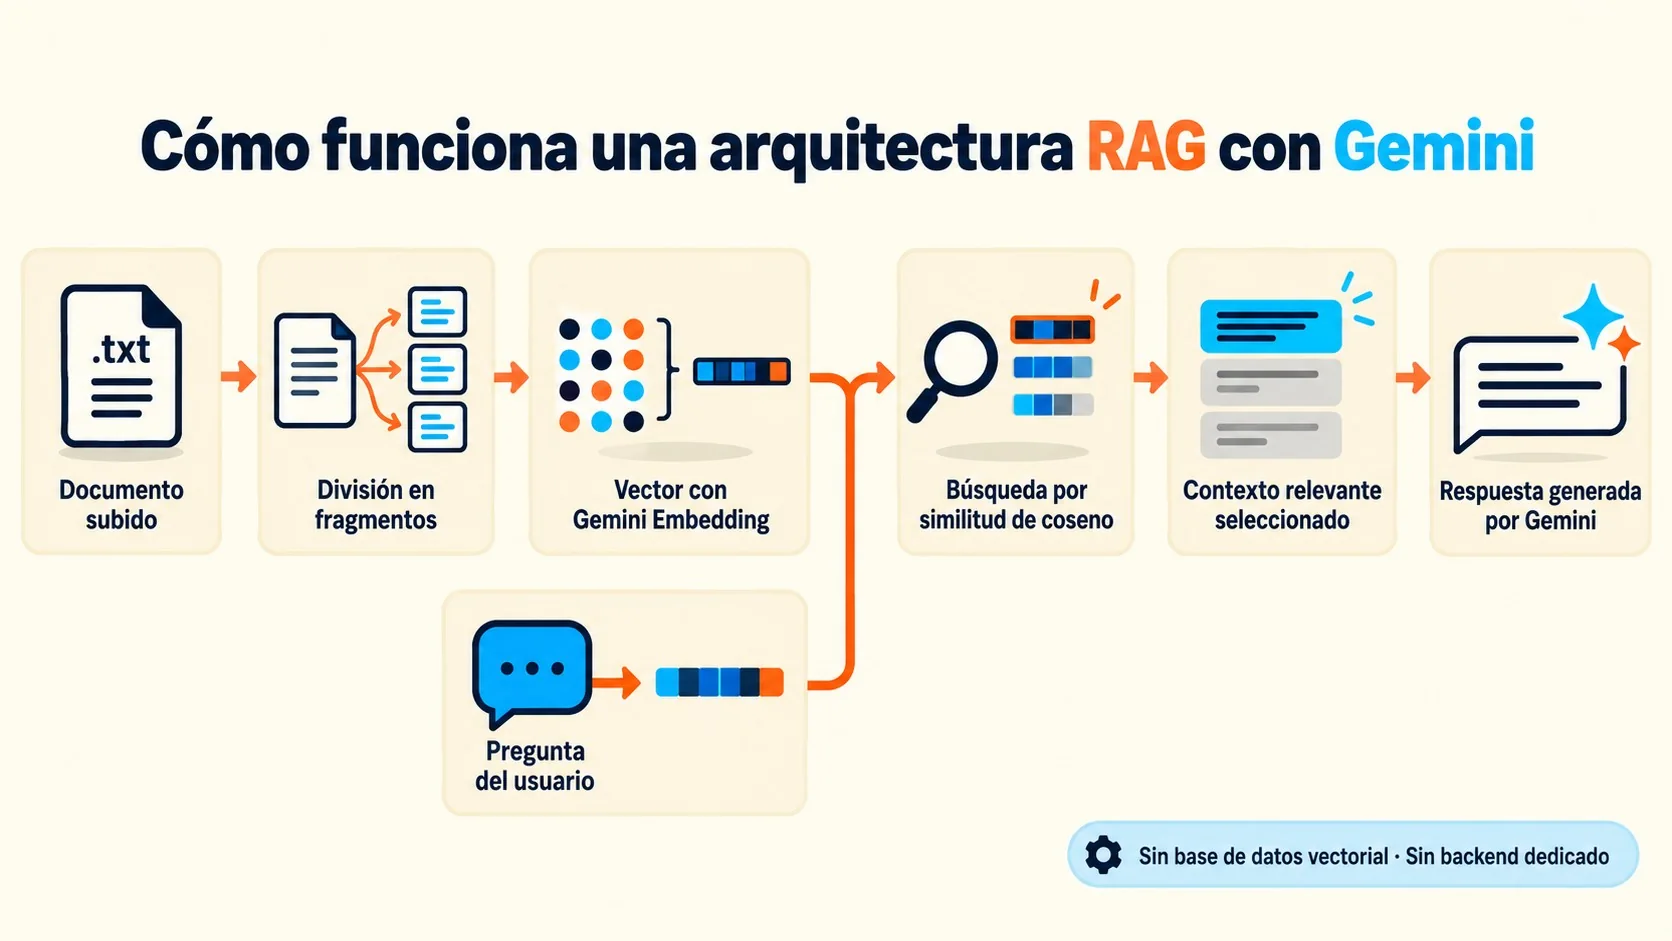
En la práctica, el flujo tiene cuatro pasos. Primero, tus documentos se parten en fragmentos (chunks) que se superponen un poco entre sí para no perder contexto en los bordes. Después, cada fragmento se convierte en un vector numérico. Cuando alguien hace una pregunta, esa pregunta también se vectoriza con el mismo modelo, y se calcula similitud de coseno contra todos los fragmentos guardados para encontrar los más relevantes. Por último, esos fragmentos ganadores se insertan en un prompt restringido y el modelo de chat genera la respuesta usando solo ese contexto, sin inventar nada por fuera de lo que tiene enfrente.
¿Y si la respuesta no está en los documentos? Ahí es donde se nota si el sistema está bien armado o no. Un RAG bien diseñado le dice al usuario que no tiene esa información, en vez de fabricar (alucinar, le dicen) una respuesta que suena convincente pero es falsa. Cubrimos ese tema en detalle en entender cómo funciona gemini en profundidad.
¿Cómo se construyó esta app RAG con el modelo de embeddings de Gemini?
La app se construyó con Next.js en el frontend y se desplegó en Vercel, usando el modelo de embeddings de Gemini para vectorizar tanto los documentos como las preguntas del usuario, todo sobre infraestructura de tier gratuito. El proyecto nació como parte de una pasantía que exigía combinar cuatro habilidades en un solo producto funcional: uso de API de LLM, ingeniería de prompts, construcción de un pipeline de retrieval y despliegue full-stack, tal como lo cuenta el propio desarrollador en su publicación original.
Para la vectorización, la documentación oficial de Google AI for Developers ofrece dos caminos según qué modelo uses. Con gemini-embedding-001 podés especificar el task_type directamente en el método embedContent, algo clave para RAG: usás RETRIEVAL_DOCUMENT para indexar tus fragmentos y RETRIEVAL_QUERY para la pregunta del usuario, porque no es lo mismo optimizar un vector para “esto es un documento que puede ser buscado” que para “esto es una pregunta que busca algo”. El modelo más nuevo, gemini-embedding-2, va un paso más allá: es multimodal, mapea texto, imagen, video, audio y documentos en un mismo espacio vectorial, y cubre más de 100 idiomas.
Subís el documento, lo trozás en chunks, generás los embeddings, guardás todo en memoria, hacés la pregunta, comparás vectores y el modelo de chat te devuelve una respuesta anclada en tu texto: ese es el ciclo completo, y lo interesante es que ninguno de esos pasos requiere una base de datos vectorial pesada, porque para documentos chicos la búsqueda en memoria alcanza y sobra.
Ejemplo hipotético: así se vería este patrón en un caso chico
Ejemplo hipotético (no es un caso real ni documentado, es solo para ilustrar el patrón): imaginá que tenés cinco o seis documentos con las políticas internas de un equipo chico —vacaciones, gastos, onboarding— y querés que alguien pueda preguntar “¿cuántos días de licencia me corresponden?” y recibir una respuesta basada exclusivamente en esos textos, no en lo que Gemini “sabe” de licencias laborales en general.
Siguiendo la misma arquitectura del proyecto de Dev.to, el flujo sería: cortás cada documento en fragmentos con algo de superposición entre ellos (para que una frase que queda partida en el borde de un chunk no pierda sentido), generás el embedding de cada fragmento con RETRIEVAL_DOCUMENT como task_type, y guardás todo en un array en memoria porque estamos hablando de un puñado de archivos, no de miles. Cuando alguien pregunta, vectorizás esa pregunta con RETRIEVAL_QUERY, comparás por similitud de coseno contra los fragmentos guardados, y le pasás los dos o tres más relevantes al modelo de chat con la instrucción explícita de responder solo con eso o decir que no sabe. Si el dato de “días de licencia” no está en ninguno de los documentos subidos, la respuesta correcta del sistema es admitir que no lo tiene, no inventar un número que suene plausible.
Este ejemplo no reemplaza probar el patrón con tus propios documentos, pero sirve para ver dónde entra cada pieza técnica que menciona la fuente: chunking con overlap, task_type correcto según si es documento o consulta, y un prompt que prioriza la honestidad sobre la fluidez.
¿Qué la diferencia de un chatbot genérico? Transparencia y carga de documentos en vivo
La diferencia central es que esta app muestra explícitamente qué documentos sustentan cada respuesta, en vez de funcionar como una caja negra. Cualquier chatbot genérico te da una respuesta y listo; acá el usuario puede ver la fuente exacta que el sistema usó para construir esa respuesta, lo cual convierte al retrieval en algo verificable y no en un acto de fe.
Hay una función particular que vale la pena remarcar: la carga de archivos .txt en tiempo real. Cualquier usuario puede subir su propio documento y consultarlo al instante, sin necesidad de redesplegar la aplicación ni tocar el código. ¿Para qué sirve esto en la práctica? Para que vos mismo confirmes, en el momento, que la respuesta sale de lo que subiste y no del conocimiento previo del modelo (spoiler: si subís un documento con datos falsos a propósito y el bot te los repite, sabés que el sistema está funcionando como debería). En activar gemini directamente desde chrome profundizamos sobre esto.
Esa transparencia resuelve un problema real de confianza. Si alguna vez usaste un asistente de IA para consultar información específica de tu empresa, sabés lo incómodo que es no poder verificar de dónde salió el dato.
Criterios de decisión: ¿búsqueda en memoria o base vectorial dedicada?
La fuente original es clara en que la búsqueda en memoria “es suficiente para conjuntos de documentos chicos a medianos”, pero no da un número exacto a partir del cual conviene migrar. En vez de inventar un umbral que no está respaldado por ninguna fuente, tiene más sentido pensar el corte según estas preguntas:
- ¿Cuántas veces vas a re-vectorizar todo? Si los documentos cambian poco (políticas internas, manuales, FAQs estáticas), la búsqueda en memoria amortiza bien el costo de recalcular embeddings cada vez que arranca el servidor. Si tus documentos cambian todo el tiempo, un índice persistente evita reprocesar todo en cada deploy.
- ¿Cuántas consultas simultáneas esperás? Comparar el vector de una pregunta contra todos los fragmentos uno por uno (fuerza bruta) escala mal cuando hay muchos usuarios preguntando al mismo tiempo, porque cada consulta repite ese barrido completo.
- ¿Necesitás que el sistema sobreviva a un reinicio del servidor? Si la búsqueda vive solo en memoria RAM del proceso, perdés el índice cada vez que el deployment se reinicia o escala a una nueva instancia (algo común en plataformas serverless como Vercel). Una base vectorial persistente no tiene ese problema.
- ¿El equipo tiene capacidad para mantener infraestructura extra? Sumar una base vectorial dedicada implica otro servicio para monitorear, versionar y pagar. Si el proyecto es una prueba de concepto o una herramienta interna chica, ese costo operativo puede no justificarse todavía.
En resumen: no hay un número mágico de documentos que marque el límite, pero sí hay señales de arquitectura (persistencia, concurrencia, frecuencia de cambio) que indican cuándo ya no alcanza con un array en memoria.
¿Qué límites tiene esta implementación gratuita de RAG?
El límite principal es de escala: la búsqueda por similitud en memoria solo funciona bien con conjuntos de documentos chicos o medianos, porque no hay índice vectorial optimizado detrás. Apenas la cantidad de fragmentos crece, cada consulta implica comparar el vector de la pregunta contra todos los vectores guardados uno por uno, sin los atajos de indexación que ofrece una base vectorial dedicada.
Tampoco hay backend propio ni base de datos vectorial externa. Eso significa cero costo de infraestructura, pero también significa que si en algún momento el proyecto necesita escalar a producción con muchos más documentos o usuarios concurrentes, va a hacer falta migrar a algo con backend persistente y capacidad de indexación real.
Otro punto que no es menor: al ser todo infraestructura gratuita, hay límites de uso de API que un proyecto personal o de demostración puede tolerar sin problema, pero que un producto con tráfico real va a chocar tarde o temprano. Sobre eso hablamos en integrar la api de gemini con node.js.
¿Qué lecciones deja este desarrollo para armar tu propio sistema RAG?
Lo más rescatable de lo que cuenta el desarrollador es que la calidad del retrieval pesa más que el fraseo del prompt. La estrategia de chunking (cómo cortás los documentos) y la cantidad de fragmentos que devolvés en cada búsqueda tuvieron más impacto en la precisión de las respuestas que cualquier ajuste fino al texto de instrucción del modelo. Tiene sentido si lo pensás desde la arquitectura RAG que describe el paper de Lewis: si el mecanismo de retrieval trae fragmentos irrelevantes, no hay prompt que arregle eso, porque el modelo solo puede generar en base a lo que efectivamente recibió.
Sobre ingeniería de prompts, la conclusión fue medio contraintuitiva: no se trató de encontrar la frase mágica, sino de imponer restricciones de comportamiento estrictas, en particular instruir al modelo para que reconozca cuando no sabe algo en vez de inventar una respuesta. Esa restricción, “si no está en el documento, decime que no sabés”, resultó más efectiva que cualquier técnica sofisticada de prompt engineering.
Hay también una lista de requisitos que no tienen nada que ver con IA pero que definen si un proyecto llega a producción o se queda en demo: manejo de errores cuando fallan las llamadas a la API, estados de carga claros mientras el sistema busca y genera la respuesta, y credenciales de API guardadas fuera del control de versiones. Ninguno de estos puntos es glamoroso. Todos son obligatorios. Tema relacionado: comparar claude 3 con gemini 2.5.
Errores comunes al construir un sistema RAG
- Cortar los chunks sin superposición. Si dividís el documento en bloques que no se solapan, perdés contexto justo en los bordes de cada fragmento, y el modelo termina recuperando información incompleta.
- Mezclar task_type de query y documento. Con gemini-embedding-001, si embebés tus documentos con RETRIEVAL_DOCUMENT pero la pregunta con un task_type distinto al recomendado, la similitud de coseno se degrada y el retrieval empeora sin que sea obvio por qué.
- No restringir el prompt final. Si le pasás el contexto recuperado al modelo pero no le indicás explícitamente que solo use esa información, el modelo puede combinar lo recuperado con su conocimiento general y ahí perdés la trazabilidad que hace confiable al sistema.
- Guardar credenciales de API en el código. Subir la API key de Gemini al repositorio, aunque sea “solo para probar”, es un error que después cuesta caro revertir.
- Confiar en búsqueda en memoria para volúmenes grandes. Funciona perfecto para un puñado de documentos, pero si tu proyecto crece, vas a necesitar una base vectorial real antes de lo que pensás.
Preguntas Frecuentes
¿Qué es RAG y cómo funciona en inteligencia artificial?
RAG (Retrieval-Augmented Generation) es una arquitectura que combina un modelo de lenguaje con un mecanismo de búsqueda sobre documentos externos, propuesta originalmente por Patrick Lewis y su equipo en el paper de 2020. El modelo recupera los fragmentos más relevantes para una pregunta y genera la respuesta basándose en ese contexto, en vez de depender solo de lo que aprendió durante el entrenamiento.
¿Cómo se usa el modelo de embeddings de Gemini para armar un sistema RAG?
Se usa el método embedContent para convertir cada fragmento de documento y cada pregunta en vectores numéricos, especificando el task_type correcto (RETRIEVAL_DOCUMENT para el contenido a indexar, RETRIEVAL_QUERY para las consultas) si trabajás con gemini-embedding-001, tal como lo detalla la documentación oficial de Gemini API. El modelo más nuevo, gemini-embedding-2, agrega soporte multimodal para texto, imagen, video y audio en un mismo espacio vectorial.
¿Se puede construir una app RAG gratis sin base de datos vectorial?
Sí, siempre que el volumen de documentos sea chico o mediano. El proyecto documentado en Dev.to usa búsqueda por similitud en memoria en vez de una base vectorial dedicada, y corre entero sobre infraestructura de tier gratuito con Next.js y Vercel, sin backend propio ni suscripciones pagas.
¿Qué diferencia hay entre un chatbot RAG y un chatbot común?
Un chatbot RAG ancla sus respuestas en documentos específicos que podés verificar, mostrando qué fuente usó para cada respuesta y declinando contestar si la información no está disponible. Un chatbot común responde solo con lo que aprendió en su entrenamiento general, sin capacidad de citar ni verificar de dónde sacó el dato.
¿Qué errores hay que evitar al construir un sistema RAG?
Los errores más frecuentes son cortar los chunks sin superposición (lo que pierde contexto en los bordes), no restringir el prompt final para que use solo el contexto recuperado, y guardar credenciales de API directamente en el código. La calidad del chunking y de la recuperación suele importar más que el fraseo exacto del prompt.
Conclusión
Lo que muestra este proyecto es que armar un sistema RAG funcional ya no requiere presupuesto de infraestructura ni un equipo de ingeniería de datos. Con el modelo de embeddings de Gemini, Next.js, Vercel y un poco de criterio para el chunking, un desarrollador solo llegó a un producto público y verificable, sin base de datos vectorial ni backend dedicado. Eso sí: esa misma simplicidad es la que marca el techo del proyecto, porque en cuanto el volumen de documentos crece, la búsqueda en memoria deja de alcanzar y hay que migrar a infraestructura real. Si estás pensando en tu propio sistema RAG, el consejo concreto es empezar por acá: probá con documentos chicos, medí la calidad del retrieval antes de tocar el prompt, y recién después —usando criterios como persistencia y concurrencia, no una corazonada— evaluá si necesitás escalar la infraestructura.