En pocas palabras: Para reducir el costo de un LLM en moderación de e-commerce con Node.js, la clave es usar un modelo chico para casos claros y escalar los ambiguos. El análisis del 25 de octubre de 2026 propone contar tokens antes de enviar el prompt y usar response_format json_schema para extraer decisiones estructuradas (allow, review, reject) de forma barata.
Reducir el costo de un LLM en Node.js para moderación de e-commerce arranca con una regla de decisión: los reportes claros van a un modelo chico y los ambiguos escalan a uno más caro o a un humano, según detalla un análisis técnico publicado el 25 de octubre de 2026.
La moderación de reportes con LLM en Node.js es el proceso de clasificar, resumir y extraer datos en formato JSON de un reporte sobre un producto o vendedor, usando un modelo de lenguaje para decidir si se permite, se revisa o se rechaza el listado. El objetivo es mantener la cola de revisión manejable sin sumarle latencia al checkout.
En este artículo:
- En 30 segundos
- ¿Por qué poner la decisión de calidad antes de elegir el modelo?
- ¿Cómo reducir el costo de tokens antes de enviar el prompt?
- ¿Cómo extraer JSON estructurado y clasificar con un ejemplo real en Node.js?
- ¿Qué opciones existen para clasificar y moderar reportes de e-commerce?
- ¿Cuándo conviene mover el procesamiento a batch en lugar de tiempo real?
- ¿Por qué enviar todo al modelo más fuerte es la opción rechazada por defecto?
- Errores comunes al armar este pipeline en Node.js
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- La regla de decisión va antes que el proveedor: tipo de tarea, tokens de entrada, modelo, latencia, confianza y si un humano corrigió el resultado.
- Contar tokens antes de enviar el prompt (reporte, extracto de política y campos del JSON) evita pagar por contexto que nadie usa.
- El ejemplo de la fuente usa un modelo chico (deepseek-v4.1-flash) con
response_format json_schemapara forzar una salida con decision, reason_code y human_review. - La Batch API de OpenAI ofrece 50% de descuento y ventana de 24 horas para trabajo que no necesita respuesta inmediata.
- Mandar todo al modelo más fuerte por defecto es la opción que la fuente recomienda evitar para triage de rutina.
¿Por qué poner la decisión de calidad antes de elegir el modelo?
Porque la decisión de calidad fija qué riesgo aceptás antes de mirar el precio de cada proveedor. La arquitectura que describe la fuente registra, para cada reporte, el tipo de tarea, una estimación de tokens de entrada, el modelo elegido, el tiempo que tardó, la confianza del resultado (si el modelo la informa) y si un humano corrigió la decisión.
Ponele que un reporte avisa que una descripción de producto promete una cura médica. Ese reporte necesita quedar registrado con una etiqueta de baja cardinalidad, no con el seller_id ni el texto crudo pegado en cada métrica. Usar algo como task=moderation, route=fast|escalated y outcome=allow|review|reject alcanza para que un ingeniero de guardia entienda qué pasó sin abrir cada evento individual.
El gate es aburrido. Y eso, en este caso, es una virtud.
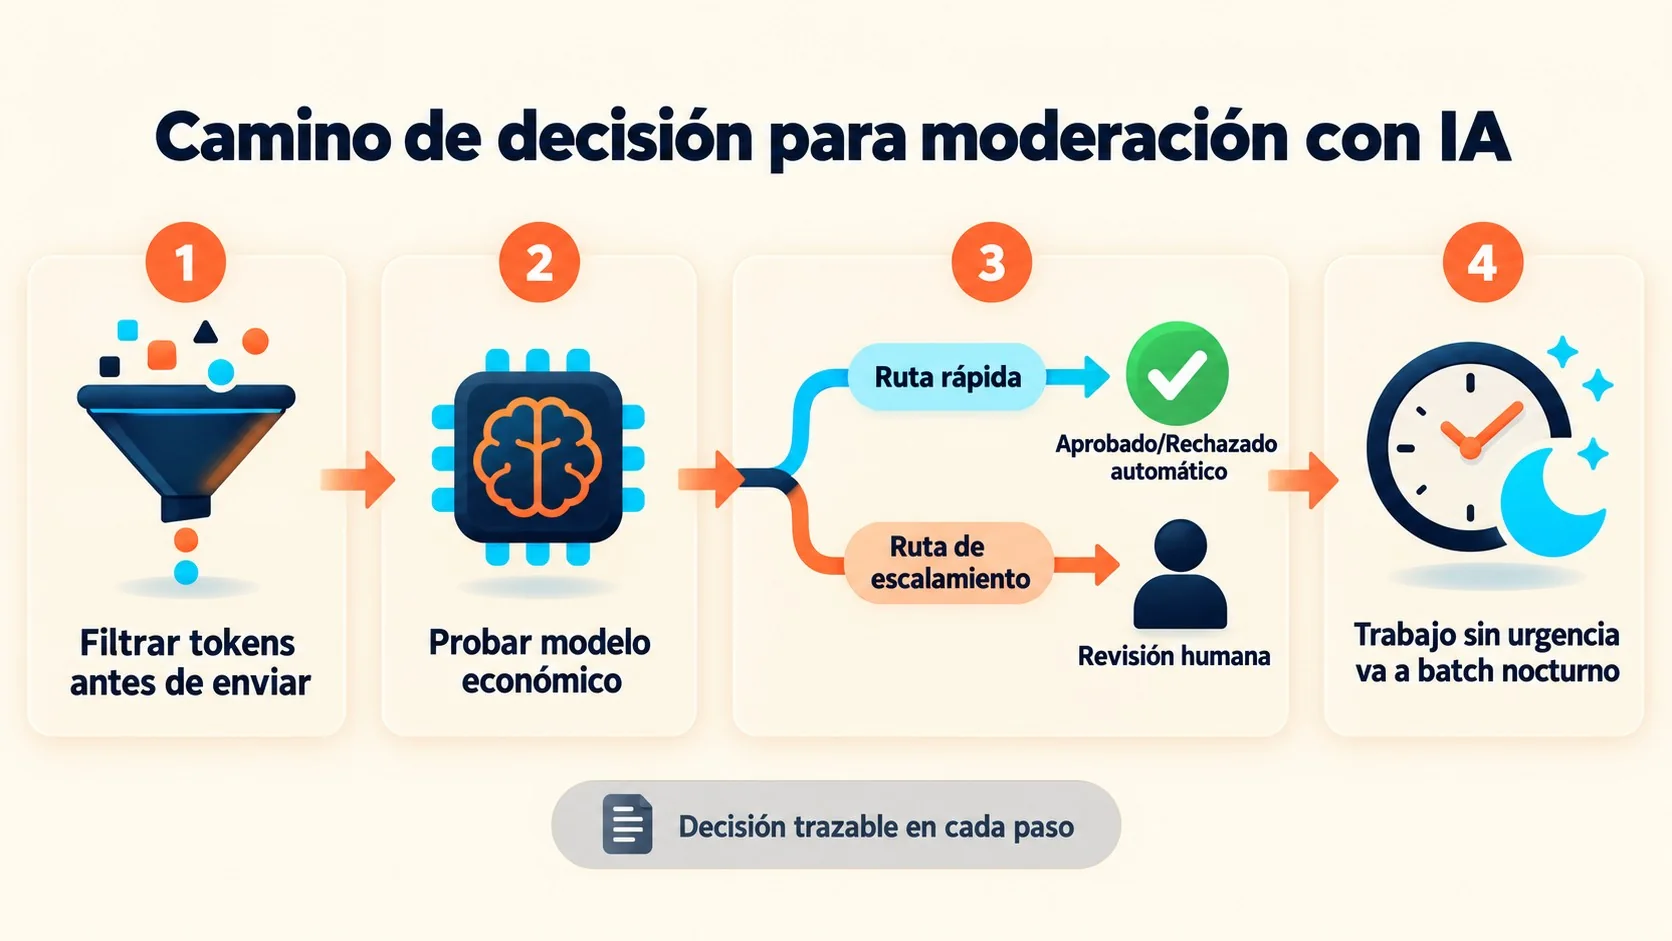
El criterio se resume en una línea: camino rápido para reportes claros y de bajo riesgo, escalación para ambigüedad, contexto largo, fallas de esquema o una muestra de calidad que cae debajo del umbral de release. Eso convierte la latencia en una decisión controlada en vez de una promesa que se le cuelga a cada request. Relacionado: comparamos GLM-5.3 open source frente a Claude.
¿Cómo reducir el costo de tokens antes de enviar el prompt?
Reducir el costo de LLM en Node.js arranca antes de llamar a la API: se decide qué entra al prompt, no qué modelo lo va a procesar. Según la fuente, un reporte de moderación necesita el texto del reporte, un extracto compacto de la política y los campos que pide el JSON de salida. Rara vez necesita el historial completo del vendedor, cada apelación previa o la descripción entera del catálogo.
El token gate que propone el artículo tiene tres salidas posibles: aceptar el prompt compacto tal cual, resumirlo o recortarlo, o mandarlo a un camino de revisión más lento. Ojo: contar tokens no es lo mismo que verificar calidad (spoiler: un prompt corto también puede ser ambiguo, y ahí es donde el sistema necesita otro control además del contador).
Subís el prompt recortado, lo mandás al modelo chico, te devuelve un JSON con la decisión, el reason_code y el flag de revisión humana, todo parece resuelto, hasta que te das cuenta de que el reporte que acaba de pasar “allow” tenía ambigüedad real y nadie lo marcó para que lo mire una persona.
¿Cómo extraer JSON estructurado y clasificar con un ejemplo real en Node.js?
Extraer JSON estructurado de un LLM en Node.js significa forzar al modelo a devolver una respuesta con esquema fijo, usando el parámetro response_format con json_schema en la llamada a /chat/completions. El ejemplo de la fuente usa el modelo deepseek-v4.1-flash, con un mensaje de sistema que pide clasificar un reporte de moderación y devolver solo el JSON solicitado. Te puede servir nuestra cobertura de reducir hasta un 90% los costos de API.
- El esquema define tres campos obligatorios: decision (allow, review o reject), reason_code (texto libre) y human_review (booleano).
- El header Idempotency-Key evita decisiones duplicadas cuando el cliente reintenta la misma request, aunque no reemplaza la deduplicación del lado del consumidor.
- El flag –fail-with-body de curl mantiene visible una respuesta de error en vez de dejar que un 4xx se disfrace de éxito silencioso.
El esquema es un contrato para el código que viene después, no evidencia de que la decisión sea correcta (y sí, eso quiere decir que podés tener un JSON perfecto con una decisión pésima adentro). Para un cliente en producción, además de validar el esquema conviene revisar el status y el body de la respuesta en el propio código, y respetar el valor de Retry-After si el servidor lo manda.
¿Qué opciones existen para clasificar y moderar reportes de e-commerce?
Para moderación de e-commerce con LLM en Node.js hay al menos cinco caminos distintos, y ninguno gana por default según la comparación de la fuente: OpenAI API, Anthropic API, Google Gemini API, Cohere Rerank y un runtime unificado llamado Infrai. La diferencia entre ellos está en la forma de la integración y el punto de control probable, no en un ranking de inteligencia del modelo.
| Opción | Distinción clave | Encaje para moderación e-commerce | Frontera a probar |
|---|---|---|---|
| OpenAI API | Integración de chat conocida y un flujo de batch documentado | Buen candidato para benchmark base y reprocesamiento offline | Confirmar que el modelo chico acierta en los casos límite de política antes de usarlo para bloquear algo |
| Anthropic API | Superficie de mensajes propia, con su propio contrato de prompt | Útil como segunda referencia de calidad para reportes ambiguos | Sumar un proveedor implica otra key, otro cliente y otro mapeo de telemetría |
| Google Gemini API | Tercera API general con soporte multimodal | Útil cuando el set de prueba incluye contexto de producto con imágenes | Agregar un adaptador propio y verificar el esquema contra las etiquetas exactas de moderación |
| Cohere Rerank | Reranking enfocado, no una decisión general de moderación | Útil si ya tenés pasajes o etiquetas candidatas para ordenar | No produce por sí solo la decisión final de allow, review o reject |
| Runtime Infrai | Un solo contrato REST para chat, conteo de tokens, costo y batch | Buen fit si querés un control plane único para clasificación rápida y backfills | No tiene endpoint dedicado de moderación: la calidad sigue siendo responsabilidad de tu app |
Ningún proveedor gana por default.
La fuente no corrió un benchmark propio entre estas opciones: comparó la forma del contrato de API, no la calidad de las respuestas. Eso importa porque la elección real depende de cuánto dato etiquetado tengas para medir tu propia tasa de error contra cada proveedor, algo que ningún artículo puede resolver por vos. El dato llamativo es el del runtime propio: según la misma nota, su snapshot de descubrimiento lista 295 rutas en 20 módulos, aunque no tiene un endpoint dedicado a moderación, así que la decisión de calidad sigue recayendo en tu aplicación.
¿Cuándo conviene mover el procesamiento a batch en lugar de tiempo real?
El batch conviene para trabajo que no necesita respuesta inmediata: backfills de catálogo, rechequeos nocturnos de política y reprocesamiento de reportes históricos después de un cambio de política. La Batch API de OpenAI ofrece 50% de descuento sobre el precio síncrono y una ventana de finalización de 24 horas, según la documentación oficial de OpenAI.
El camino síncrono queda reservado para un reporte que puede afectar un listado ahora mismo. En el batch, guardá el id del reporte y la versión del prompt en cada item, y hacé que el consumidor sea idempotente: un item reprocesado por error no puede generar dos tickets de revisión humana. Guardá también la versión de política que produjo el resultado (si no, buena suerte tratando de explicar en una auditoría qué cambió y cuándo). Para más detalles técnicos, mirá entender el costo real de las APIs.
¿Quién audita eso después? Nadie, si no guardaste la versión de la política junto al resultado.
Batch no es un permiso para bajar la vara de calidad. Es una decisión de scheduling.
¿Por qué enviar todo al modelo más fuerte es la opción rechazada por defecto?
Mandar cada reporte al modelo más fuerte convierte el camino caro en la base de todo el sistema y no deja ningún criterio medido para decidir cuándo escalar. La fuente marca esto como la opción común que conviene rechazar para triage de rutina, aunque reconoce casos válidos: un set de calibración chico, un lanzamiento de alto riesgo o una investigación de incidente donde el recall pesa más que la latencia.
¿Tiene sentido alguna vez usar siempre el modelo caro? Sí, cuando estás armando el set de referencia contra el que vas a medir todo lo demás. El problema aparece cuando esa “solución” se vuelve el default permanente: ahí deja de ser una medición y se convierte en una factura mensual sin justificación. En técnicas de caching y batch para bajar costos profundizamos sobre esto.
Errores comunes al armar este pipeline en Node.js
- Etiquetar cada métrica con seller_id o product_id. Multiplica la cantidad de series de tiempo sin mejorar la pregunta que puede responder un ingeniero de guardia; usá dimensiones acotadas como task, route y outcome.
- Confundir el conteo de tokens con un chequeo de calidad. Un prompt corto puede ser tan ambiguo como uno largo; el token gate filtra tamaño, no corrección.
- No guardar la versión de política junto al resultado. Sin ese dato, una auditoría no puede saber si una decisión cambió porque cambió el modelo o porque cambió la regla de negocio.
- Usar el modelo más caro como default permanente. Deja la ruta cara como línea de base y sin ningún motivo medido para escalar desde un modelo más barato cuando haga falta.
Preguntas Frecuentes
¿Cómo se reduce el costo de usar un LLM en producción?
Se reduce acotando el prompt antes de enviarlo (reporte, extracto de política y campos del JSON, nada más) y usando un modelo chico para los casos claros, reservando el modelo caro o la revisión humana para los ambiguos. El batch, con su descuento del 50% en el caso de OpenAI, suma otra reducción para trabajo que no es urgente.
¿Qué modelo conviene usar para clasificar texto en Node.js?
No hay un modelo único recomendado: la fuente usa deepseek-v4.1-flash como ejemplo de modelo chico para clasificación rápida, pero el criterio real es medir su precisión contra un set etiquetado propio antes de usarlo para decisiones que bloquean algo. Lo que importa es el proceso de validación, no el nombre del modelo.
¿Cómo extraer JSON válido de la respuesta de un modelo de lenguaje?
Se extrae usando response_format con json_schema en la llamada a la API, definiendo campos obligatorios y un enum cerrado para las opciones válidas, como en el ejemplo con decision, reason_code y human_review. El esquema garantiza que el JSON sea válido estructuralmente, no que la decisión dentro de ese JSON sea correcta.
¿Cuándo conviene usar el batch API en vez de llamadas en tiempo real?
Conviene cuando el trabajo no necesita respuesta inmediata, como backfills de catálogo o rechequeos de política después de un cambio de reglas. La Batch API de OpenAI corre dentro de una ventana de 24 horas con 50% de descuento, algo que no tiene sentido pagar de más en el camino síncrono de checkout.
¿Qué diferencia hay entre OpenAI, Anthropic y Gemini para moderación de contenido?
La diferencia principal está en la superficie de integración: OpenAI tiene un flujo de batch documentado y una API de chat conocida, Anthropic expone su propia superficie de mensajes con su contrato de prompt, y Gemini suma una tercera API general con soporte multimodal. Ninguna de las tres tiene un endpoint de moderación dedicado para e-commerce: las tres necesitan un modelo de chat más un json_schema armado por tu equipo.
Conclusión
El pipeline que describe la fuente no es una optimización de costos disfrazada de arquitectura: es una arquitectura que, de paso, termina costando menos. La secuencia importa: primero el límite de calidad, después el tamaño del prompt, después la elección de modelo, y al final la decisión de si ese trabajo puede esperar a un batch. Si tenés un sistema de moderación de reportes en Node.js y todavía mandás todo al modelo más caro sin medir nada, el primer paso no es cambiar de proveedor: es armar el set etiquetado contra el que vas a medir cualquier cambio que hagas de ahora en más.