
En pocas palabras: La revisión humana es la última defensa contra los pull requests de agentes: según Max Quimby (dev.to, octubre de 2026), escriben el 27,6% de los PRs de GitHub y su código compila, pero viola contratos de API y dependencias entre servicios que el CI no detecta.
Según un análisis de Max Quimby en dev.to (principios de octubre de 2026), los agentes de IA escriben el 27,6% de los pull requests de GitHub, contra menos del 1% catorce meses antes. Con ese volumen, la revisión de código de agentes IA es el único filtro de calidad que queda.
La revisión de código de pull requests de agentes de IA es el control humano que decide si un cambio propuesto por una herramienta como Claude Code, Codex o Cline entra a la rama principal. Sirve para detectar lo que el CI no ve: contratos de API violados, dependencias entre servicios y decisiones de arquitectura que no están escritas en el repositorio. Es una tarea de los mantenedores y del equipo que conoce el sistema.
En este artículo:
- En 30 segundos
- ¿Qué porcentaje de los pull requests de GitHub escriben los agentes de IA?
- ¿Cómo abre pull requests un agente de codificación?
- ¿Por qué los pull requests de agentes se aceptan casi igual que los humanos pero fallan distinto?
- ¿Por qué la revisión de código de agentes IA es la última línea de defensa?
- ¿Cuáles son los cuatro modos de falla de los pull requests de agentes y cómo se frenan?
- ¿Qué cambiar esta semana en el CI y en el proceso de revisión?
- ¿Qué tan confiables son estos números y qué está confirmado?
- Errores comunes al revisar PRs de agentes
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El 27,6% de los PRs de GitHub los escriben agentes y el 41% del código nuevo tiene IA, según Quimby y el Agentic Coding Trends Report 2026 de Anthropic (cifras de segunda mano).
- La aceptación parece parecida (83,77% agentes contra 91,01% humanos), pero las fallas son otras: código que compila y rompe contratos, dependencias o arquitectura.
- En el relevamiento de New Relic, el 94% de los líderes ve mejor calidad del código de IA al revisarlo y el 78% reporta más incidentes una vez en producción.
- Las defensas que se proponen: tests de contrato, tests de propiedades, canary, auto-merge solo de cambios chicos y medir retrabajo en lugar de aceptación.
- Las cifras son autoinformadas y llegan de segunda mano. Antes de apostar, medí los números de tu propio repo.
¿Qué porcentaje de los pull requests de GitHub escriben los agentes de IA?
El 27,6%, según el análisis de Max Quimby en dev.to, que lo compara con menos del 1% de catorce meses antes. El Agentic Coding Trends Report 2026 de Anthropic, citado en ese mismo análisis, calcula que el 41% del código nuevo tiene IA. Son cifras de segunda mano: la nota que las resume aclara que no recuperó los reportes originales.
Tomalo con pinzas, pero la dirección es clara. Cuando más de un cuarto de los PRs viene de un agente, la revisión humana deja de ser un control entre varios. Otro dato del reporte de Anthropic, según Quimby: los desarrolladores pueden delegar por completo solo entre el 0% y el 20% de las tareas, y aun así el 41% del código lo escribe una IA. Ese hueco lo llena una supervisión que muchas veces es superficial.
¿Cómo abre pull requests un agente de codificación?
Un agente de codificación recibe una instrucción en lenguaje natural, edita archivos, corre tests y linters, usa git y arma el commit y el pull request sin que nadie tipee el diff. El estudio de arXiv sobre Claude Code describe ese flujo y cuenta que la descripción del PR sale marcada con la frase “Generated with Claude Code”.
Esa marca importa para medir. Los autores la usaron para encontrar 567 PRs en 157 proyectos open source. Mi inferencia: si en tu equipo alguien borra la marca, o usan un agente que no la deja, tu conteo interno de PRs de agentes va a quedar corto. Conviene etiquetarlos vos.
¿Por qué los pull requests de agentes se aceptan casi igual que los humanos pero fallan distinto?
Porque los agentes casi no cometen typos ni errores de sintaxis: producen código que compila y viola algo que no tenían a la vista. La tasa de aceptación que cita Quimby es 83,77% para agentes y 91,01% para humanos. La brecha es chica y tapa el tipo de falla, que según el análisis se concentra en tres lugares:
- Contratos de API que el agente nunca vio. No estaban en el archivo que le diste.
- Dependencias entre servicios. Solo existen en el sistema corriendo.
- Decisiones de arquitectura. Viven en la cabeza del equipo, no en el repo.
Para más detalles técnicos, mirá reescritura de código a Rust con agentes.
Hay más datos de contexto. Un estudio MSR 2026 citado en el análisis encontró que el 23% de los PRs de agentes rechazados eran duplicados, abiertos mientras otra persona ya trabajaba en el mismo issue, y que cerca del 28% se mergea casi al instante (cambios chicos y bien acotados). Según el blog de ingeniería de Stack Overflow, también citado por Quimby, el código de IA tiene 1,7 veces más bugs que el humano, con errores de lógica 1,75 veces más frecuentes y hallazgos de seguridad 1,57 veces más comunes. La nota de Quimby no informa la fecha de publicación de ese dato, así que no podemos confirmar que sea reciente.
Ahora bien, acá hay un detalle que conviene marcar. El paper de arXiv, que analizó 567 PRs de Claude Code entre febrero y abril de 2025, reporta un 83,77% de PRs de agentes mergeados contra 91,01% de PRs humanos. Son los mismos números, hasta el segundo decimal, que el análisis de Quimby atribuye a un estudio de 33.000 PRs. O es una coincidencia notable o se mezclaron atribuciones en el camino, y con lo que tenemos no se puede saber. Por eso conviene leer esa brecha como una referencia y no como una medición sobre 33.000 casos.
El paper aporta otros datos útiles. El 54,95% de los PRs de agentes mergeados entró sin cambios (58,53% en los humanos), y el 45,05% restante necesitó retoques: bugs (45,1%), documentación (27,4%), refactorización (25,7%) y estilo de código (22,1%). Los autores sostienen que los rechazos responden más al contexto del proyecto, como soluciones alternativas o el tamaño del PR, que a fallas propias del código de IA.
¿Por qué la revisión de código de agentes IA es la última línea de defensa?
Porque el CI, los linters y el formateo atrapan errores de tipeo y de sintaxis, y los agentes casi no los cometen. Lo que queda es código limpio con un supuesto equivocado. Eso solo lo detecta alguien que entienda el sistema, o una prueba que codifique ese supuesto. En su momento publicamos una comparativa entre Claude y Gemini 2.5; los modelos cambian rápido, así que leela como una referencia de ese momento y no como el estado actual.
El relevamiento 2026 de New Relic, citado en el análisis, muestra la paradoja. El 94% de los líderes de ingeniería califica el código de IA como mejor que el humano al momento del review. Sin embargo, el 78% de esos mismos encuestados reporta más incidentes una vez que se despliega, el 82% tuvo al menos una falla en producción vinculada a código de IA en seis meses y el 74% dice que al menos un cuarto de ese código necesita retrabajo importante dentro del año. Un diff prolijo, con nombres claros y comentarios útiles, se lee bien (y esa es justamente la trampa).
Además, el 62% de los equipos ya despliega código de IA sin verificación manual línea por línea, según el mismo relevamiento. La telemetría de Faros AI, citada también por Quimby, correlaciona la adopción de IA con 98% más PRs, 154% más grandes, 91% más tiempo de revisión y 31% más merges sin revisión. En el post original de Quimby aparece además que el 61,38% de los PRs de agentes de un estudio comparativo no tiene actividad de revisión registrada.
Addy Osmani lo resume en una frase que cita el análisis: “Code generation became cheap while understanding stayed expensive”. Generar código se abarató, entender lo que se generó sigue costando lo mismo.
¿Cuáles son los cuatro modos de falla de los pull requests de agentes y cómo se frenan?
Quimby agrupa los problemas recurrentes en cuatro modos que piden defensas distintas. Revisar un PR de agente como si detrás hubiera el razonamiento de una persona deja pasar tres de los cuatro, según el análisis resumido en dev.to.
| Modo de falla | Evidencia citada | Defensa propuesta |
|---|---|---|
| 1. El agente no ve el sistema entero | 23% de los PRs rechazados eran duplicados; 1,7 veces más bugs que el código humano (Stack Overflow) | Tests de contrato con Pact o Specmatic; reglas de arquitectura tipo ArchUnit |
| 2. Diffs prolijos, despliegues frágiles | 94% ve mejor calidad en el review, 78% reporta más incidentes (New Relic) | Tests de propiedades (Hypothesis, fast-check), canary, semantic diffing |
| 3. Colas de revisión que superan a los revisores | 98% más PRs, 154% más grandes, 91% más tiempo de revisión, 31% más merges sin revisión (Faros AI) | Humano con alcance acotado; auto-merge solo de cambios chicos |
| 4. Deriva de arquitectura | Según el post original de Quimby, cada cambio es razonable solo y el conjunto degrada el sistema | Reglas de arquitectura en CI, revisión semanal del diff de arquitectura, guardrails en cada build del agente |
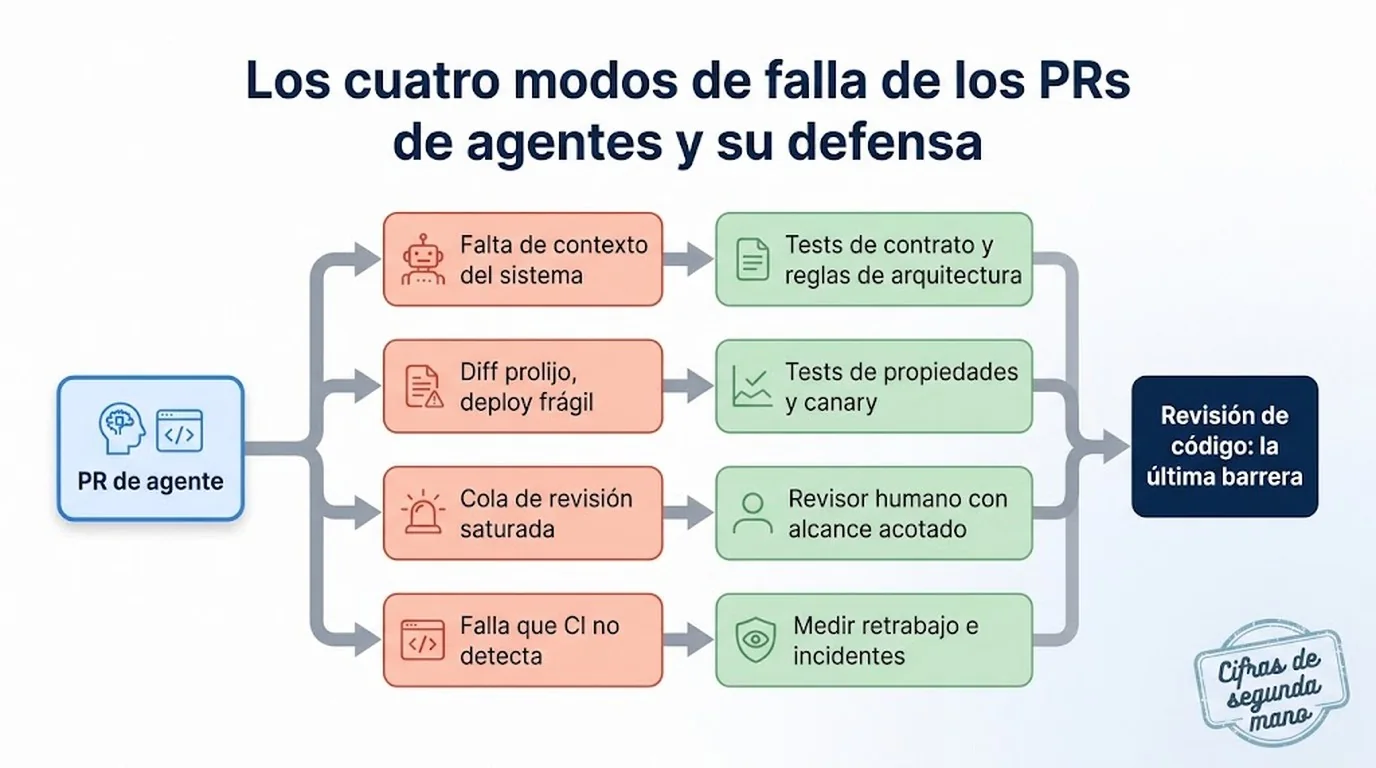
Sobre el cuarto modo, la nota de dev.to que resume el análisis no lo detalla: solo describe la clase de falla (código limpio con un supuesto equivocado que CI, linters y formateo no detectan). Lo que figura en la tabla viene del post original de Quimby, que lo llama deriva de arquitectura. En diferencias entre Claude y GPT-4o profundizamos sobre esto.
Escenario hipotético para ver cómo se combinan: un agente toma un issue, abre el PR, el CI queda en verde, el revisor ve un diff prolijo y aprueba en cinco minutos porque la cola tiene otros cuarenta, el cambio sale a producción, y dos semanas después aparece un incidente porque se renombró un campo que consumía otro servicio y ningún test lo tenía codificado.
¿Qué cambiar esta semana en el CI y en el proceso de revisión?
Los cambios que apunta el análisis tocan el CI, el despliegue y el entrenamiento de revisores. No pasan por escribir mejores prompts. La lista:
- Tests de contrato en el gate. Si no podés expresar el límite en un test, el agente tampoco lo va a ver.
- Tests de propiedades en lugar de tests de ejemplo. Los ejemplos le dan al agente pares exactos para memorizar; los invariantes te dan algo que verificar cuando hace algo que no predijiste.
- Canary antes del merge en cambios riesgosos. Que el tráfico real juzgue, con el radio de impacto contenido.
- Un humano con alcance definido. Auto-merge solo para cambios chicos y bien acotados; todo lo que cruza servicios o límites de arquitectura va a alguien que conozca el sistema.
- Medir retrabajo, no aceptación. Seguí incidentes, retrabajo y fallas en producción vinculadas a código de IA.
Dos ejemplos hipotéticos, para que puedas reproducirlos. Contrato: un consumidor espera que la respuesta tenga el campo total y el agente lo renombra a amount porque en el archivo que vio parecía más claro; los unit tests del servicio pasan, el test de contrato del consumidor falla en el CI. Propiedades: para una función de descuento, el invariante “el total nunca es negativo ni supera el subtotal” se prueba con Hypothesis sobre miles de entradas generadas, mientras que tres ejemplos fijos solo prueban esos tres casos.
Criterio práctico de verificación (propuesta editorial, no de las fuentes ni probada por nosotros): tomá los PRs mergeados de los últimos 90 días y separalos entre agente y humano, por etiqueta o por la marca de la descripción. Contá en cada grupo los reverts, los hotfixes y los incidentes asociados dentro de los 30 días del merge. Si el grupo de agentes sale peor, ajustá los gates; si sale igual o mejor, tu problema probablemente sea la cola de revisión y no la calidad del código. Sobre eso hablamos en comparativa entre GPT-5 y Claude.
¿Qué tan confiables son estos números y qué está confirmado?
Sirven como dirección, no como precisión. Las cifras llegan de segunda mano a través de Quimby y la nota que las resume lo reconoce: el autor no corrió estos gates sobre una población grande de PRs de agentes. Las encuestas de proveedores (New Relic, Stack Overflow, Faros) son autoinformadas.
Qué está respaldado por las fuentes
- Que el análisis de Quimby reporta 27,6% de PRs de agentes y 41% de código nuevo con IA (según Anthropic, citado).
- Que el paper de arXiv midió 83,77% de PRs de Claude Code mergeados y 54,95% sin cambios adicionales sobre 567 PRs en 157 proyectos.
- Que las defensas listadas (tests de contrato, de propiedades, canary) son las que propone el análisis.
Qué sigue sin confirmar
- La existencia y la muestra del estudio de 33.000 PRs, porque sus cifras coinciden con las del paper de 567 PRs.
- Los reportes originales de Anthropic, New Relic, Faros, Greptile y Stack Overflow, que no se recuperaron, y la fecha de publicación del dato de Stack Overflow.
- Que estas defensas funcionen a escala: nadie lo midió en las fuentes.
- Que el 27,6% describa tu repo: las fuentes no precisan cómo definen un “PR de agente”.
Qué no permiten concluir: que el código de agentes sea peor que el humano (la brecha de aceptación es chica y Greptile, citado por Quimby, ubica a Codex en 5-6% de retrabajo contra 10% humano), ni que se pueda frenar el volumen. Lo que sí permiten es decidir dónde poner a los revisores.
Errores comunes al revisar PRs de agentes
- Tomar la tasa de aceptación como medida de calidad. La brecha de 83,77% contra 91,01% parece inofensiva porque la falla ocurre después del merge. Medí incidentes y retrabajo.
- Dejar que el mismo agente revise su PR. El post de Quimby plantea que la IA que escribe no debería ser la que revisa; si usás una herramienta de revisión automática, que sea distinta y que haga una primera pasada, no la última.
- Aprobar porque el diff se lee bien. El 94% que califica mejor el código de IA en el review es exactamente el síntoma. Revisá supuestos y contratos, no prolijidad.
- Escribir solo tests de ejemplo. Un agente genera los casos que ya pasan. Sumá invariantes que no pueda memorizar.
- Usar auto-merge para todo. Limitalo a cambios chicos y acotados; lo que cruza servicios necesita un revisor que conozca el sistema.
Preguntas Frecuentes
¿Cómo se revisa un pull request generado por un agente de IA?
Se revisan supuestos y contratos, no solo el diff: qué APIs, servicios y reglas de arquitectura toca y si hay un test que los cubra. Un cambio chico y acotado puede pasar por un gate automático; el que cruza servicios necesita a alguien que conozca el sistema.
¿Por qué el código de IA pasa el code review y después falla en producción?
Porque los agentes escriben código que se ve correcto, pero no necesariamente se comporta bien con carga concurrente, cachés desactualizadas, fallas parciales de red o APIs de terceros que devuelven errores. Según New Relic, el 94% de los líderes lo califica mejor al revisarlo y el 78% reporta más incidentes en producción.
¿Se puede hacer auto-merge de pull requests de agentes?
Sí, para cambios chicos y bien acotados, que es donde los agentes funcionan mejor (cerca del 28% se mergea casi al instante, según el estudio MSR 2026 citado). Todo lo que cruza servicios o límites de arquitectura debería ir a un revisor humano.
¿Qué es un test de contrato?
Un test de contrato verifica que quien ofrece una API y quien la consume respeten el acuerdo entre ambos (campos, tipos, respuestas). Herramientas como Pact y Specmatic lo corren en el CI y atrapan roturas entre servicios que los unit tests no ven.
¿Qué es un test basado en propiedades?
Un test basado en propiedades define invariantes que el código debe cumplir para cualquier entrada, en lugar de pares fijos de entrada y salida. Hypothesis (Python) y fast-check (TypeScript) generan casos al azar y encuentran bordes que un agente no habría anticipado.
Conclusión
Si más de un cuarto de tus PRs lo escribe un agente, la revisión humana es el último control y tiene que apuntar a lo que el CI no ve: contratos, dependencias y arquitectura. Mi postura: no contrates más revisores a ciegas, ajustá qué revisan y qué se automatiza. Esta semana, poné tests de contrato en el gate, limitá el auto-merge a cambios chicos y armá el cruce de reverts e incidentes entre PRs de agentes y humanos de los últimos 90 días. Las cifras de las fuentes marcan una dirección, pero la decisión la tienen que respaldar los datos de tu repo.