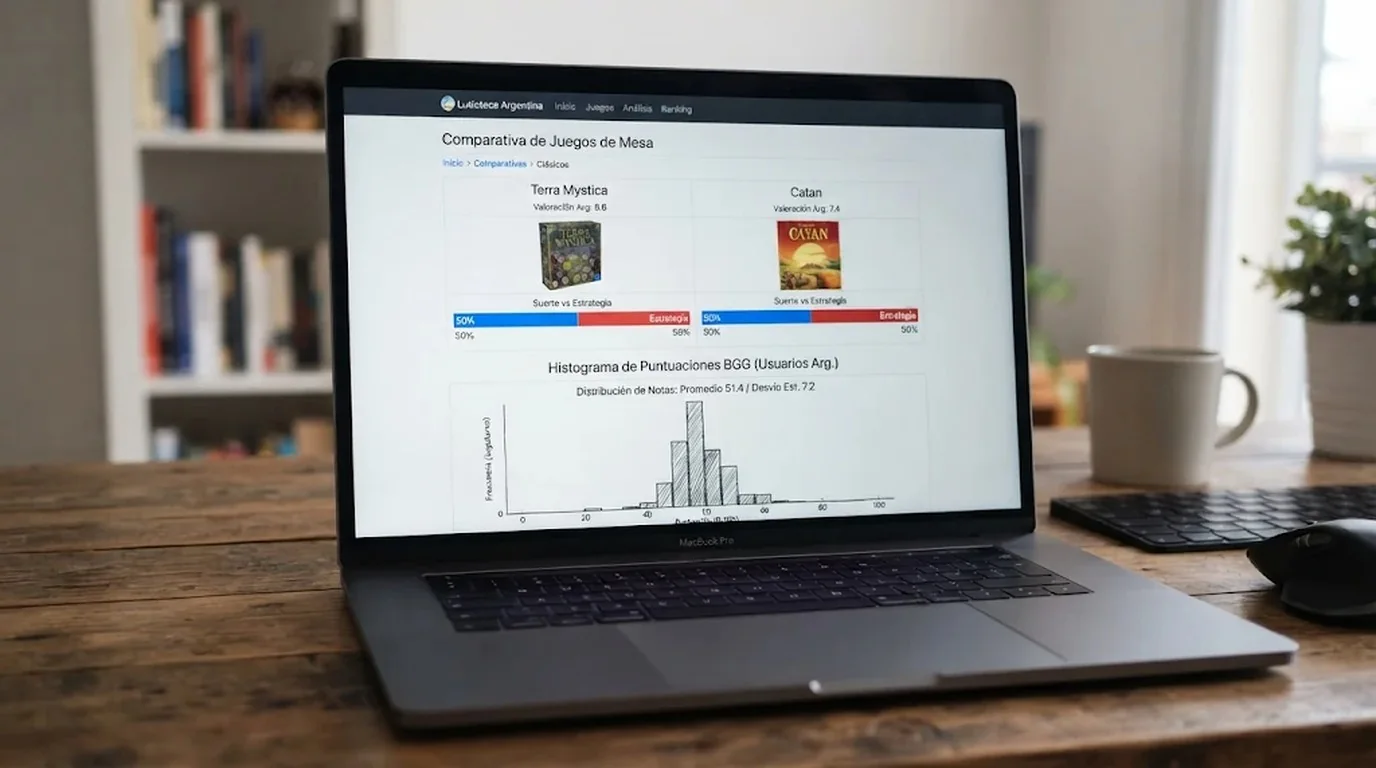
Un directorio de análisis de juegos de mesa llamado Tabletop Dev Labs se construyó con un pipeline en Python que reúne metadatos y reseñas de la comunidad, le pide a un modelo de lenguaje que los convierta en JSON y publica el resultado como sitio estático. Con las primeras 80 fichas generadas por Qwen 3.5:9B en una GPU de escritorio, casi todos los juegos quedaron con la misma nota: 50% suerte y 50% estrategia. El 21 de noviembre de 2026, el autor del proyecto publicó en dev.to el diagnóstico y la solución que aplicó: mover la inferencia a Gemini 3.5 Flash-Lite vía API y reprocesar los 99 títulos de la base.
Lo llamativo no es que un modelo chico se equivoque, sino dónde falló. Devolvía JSON válido, pros y contras razonables y un radar de cinco ejes coherente. Aun así, todos los valores numéricos se le iban al medio de la escala. Para cualquier proyecto que use un LLM para puntuar datos, ese es el punto que conviene mirar antes que la elección de proveedor.
En este artículo:
- ¿Qué es el sesgo de tendencia central y por qué el modelo local puntúa todo 50/50?
- Cómo funcionaba el pipeline
- ¿Cuánto cambiaron las puntuaciones al pasar a Gemini 3.5 Flash-Lite?
- El problema de fondo: comprimir un juicio en un número
- ¿Qué tan sólida es esta evidencia?
- ¿Cómo calibrar las puntuaciones numéricas que devuelve un LLM?
- ¿Conviene un modelo local o la API?
- Fuentes
¿Qué es el sesgo de tendencia central y por qué el modelo local puntúa todo 50/50?
El sesgo de tendencia central es la propensión de un modelo a devolver valores cercanos al centro de una escala cuando se le pide una nota numérica sobre un juicio ambiguo. En vez de separar los extremos, elige el punto medio, que interpreta como la respuesta más segura. No es un fallo de formato: el JSON sale bien y el texto es correcto; lo que se aplana es la dispersión de los números.
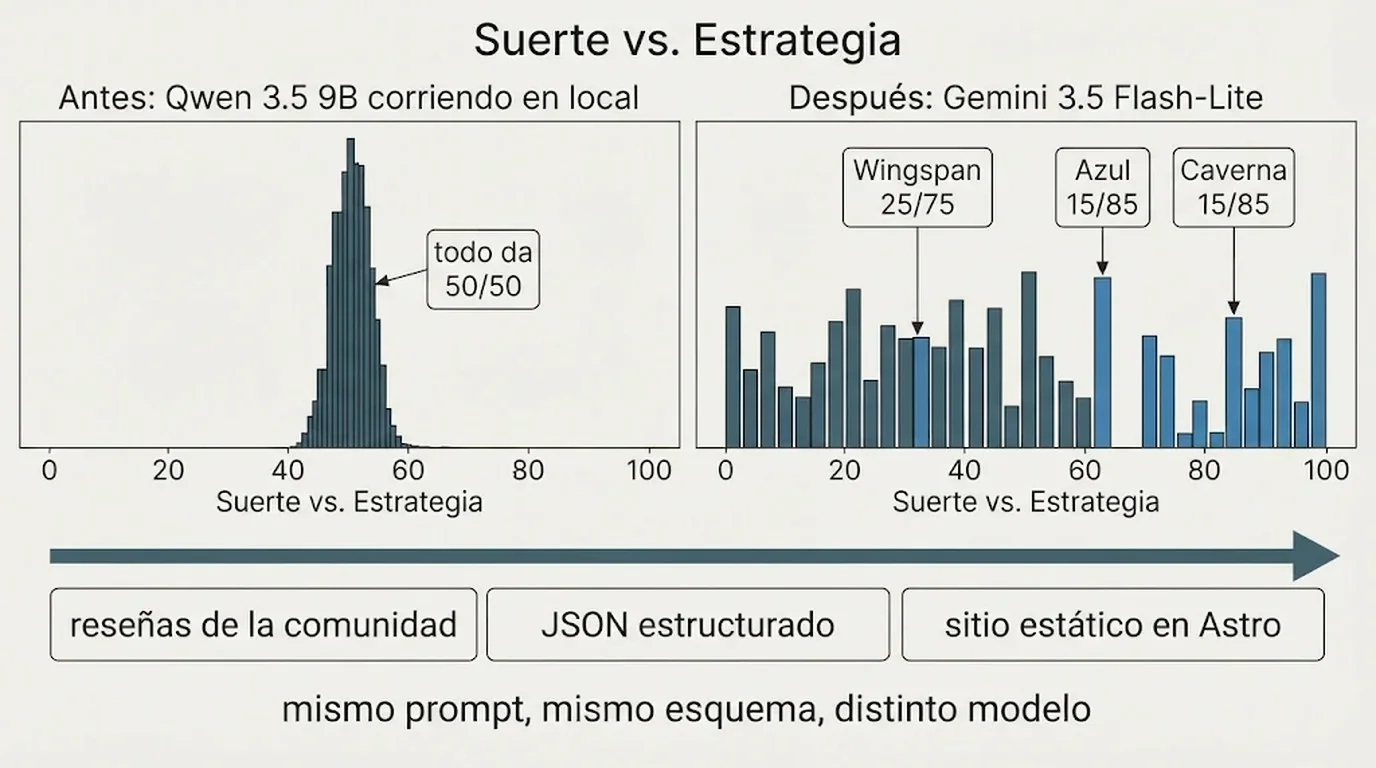
En Tabletop Dev Labs el campo comprometido era luck_vs_skill, un entero de 0 a 100 donde 0 sería estrategia pura y 100, azar puro. Según el relato del autor, Qwen 3.5:9B puntuó eurogames de azar casi nulo —como Caverna— en 50/50 o 45/55. Los juegos de dados y de push-your-luck, que deberían caer del otro lado del espectro, también quedaron rondando el 50/50. El modelo no distinguía un extremo del otro.
El artículo no ofrece una explicación interna de por qué ocurre: lo describe como un rasgo observado en modelos chicos y locales frente a tareas de scoring calibrado. Es una distinción importante. Hay una descripción del síntoma y del cambio de resultado, pero no un análisis de mecanismo.
Cómo funcionaba el pipeline
La arquitectura del proyecto, tal como la describe su autor, se sostiene en cuatro pasos y un objetivo explícito: mantener el hosting en cero pesos. Relacionado: todo lo que hay que saber de Gemini.
- Extracción de datos (Python): toma metadatos de cada juego y reseñas de la comunidad.
- Evaluación con LLM: convierte ese texto libre en un JSON estricto con pros y contras, una sección de «quién lo va a amar», las puntuaciones del radar de cinco ejes (Brain Burn, Setup Hassle, Friendship Destroyer, Party Vibe, Replayability) y el entero
luck_vs_skill. - Generación estática (Astro): arma en tiempo de build las páginas individuales
/games/[slug]/y las comparativas/compare/[game-a]-vs-[game-b]/. - Deploy: un push a GitHub dispara el build automático en Cloudflare Pages.
La consecuencia del 50/50 se ve mejor en el paso 3. Las páginas de comparación no muestran dos barras independientes: calculan el delta entre los puntajes de ambos juegos. Con Azul vs. Patchwork o Agricola vs. Caverna, si las dos fichas están en 50/50, las barras quedan idénticas y el veredicto automático pierde sentido. El problema no era estético, era estructural: el dato que alimentaba las páginas de comparación, las secciones de preguntas frecuentes y los resúmenes automáticos no contenía información.
¿Cuánto cambiaron las puntuaciones al pasar a Gemini 3.5 Flash-Lite?
El autor no intentó domar al modelo local con prompt engineering y optó por cambiar el backend de inferencia a la API de Gemini, en la variante Flash-Lite. Después reprocesó las 99 fichas. Los tres casos que publicó muestran el corrimiento:
| Juego | Antes (Qwen 3.5:9B) | Después (Gemini 3.5 Flash-Lite) |
|---|---|---|
| Wingspan | ~50% suerte / 50% estrategia | 25% / 75% |
| Azul | ~50% / 50% | 15% / 85% |
| Caverna | ~50% / 50% | 15% / 85% |
La explicación que da el autor es de lectura, no de matemática: el modelo vía API interpreta mejor las señales indirectas de las reseñas. Cuando los jugadores se quejan del «robo de cartas» o de la «mitigación de dados», eso implica un corrimiento concreto en el eje suerte-estrategia; cuando hablan de «optimización determinista» o «cero información oculta», el puntaje debería irse fuerte hacia la estrategia. El modelo local detectaba el tema pero no traducía la intensidad.
Un detalle de ingeniería que el autor señala como clave: como la generación de JSON está desacoplada del frontend en Astro, reprocesar los 99 juegos y reconstruir el sitio entero llevó una sola corrida por lote y un solo push. Esa idempotencia es la que permite corregir el scoring sin tocar la capa de presentación.
El problema de fondo: comprimir un juicio en un número
El caso de los juegos de mesa es una versión acotada de algo más general. Un ensayo publicado en febrero de 2026 en joonhee.kim, «The Missing Taste Model», describe el mismo patrón desde otro ángulo: cuando el juicio sobre una obra se colapsa en un único valor escalar, la optimización tiende a moverse hacia la aceptabilidad media y borra los extremos. Dos artefactos opuestos —uno que a todos parece correcto y otro que divide entre amores intensos y rechazos rápidos— pueden terminar con el mismo promedio.
No es lo mismo, claro. El ensayo habla de gusto y de generación creativa; el caso de Tabletop Dev Labs habla de una etiqueta numérica en un esquema JSON. Pero la lección operativa se superpone: si el sistema necesita distinguir, un solo número mal calibrado no alcanza, y conviene mirar la distribución antes de mirar el promedio. Profundizamos en esto en la guía sobre cómo integrar la API con Node.js.
¿Qué tan sólida es esta evidencia?
Es el testimonio de un desarrollador sobre su propio proyecto. No hay benchmark público, ni metodología reproducible, ni muestra de los prompts usados, ni evaluación a ciegas de los resultados. Los 99 juegos son un dominio acotado y las notas no tienen una verdad de referencia contra la cual medirlas: que Wingspan quede en 25/75 es más razonable que 50/50 según el criterio del autor, pero no es un dato verificable de forma independiente.
Hay dos ausencias que conviene registrar. Primero, el autor no prueba calibración con few-shot ni ranking por pares, y de hecho cierra su texto preguntando a los lectores cómo resolvieron el problema; no sabemos si el modelo local podía alcanzar una dispersión parecida con otra estrategia de prompting. Segundo, no hay cifras de costo ni de latencia de la API, algo relevante cuando se reprocesa un dataset completo. Todo esto queda sin confirmar.
¿Cómo calibrar las puntuaciones numéricas que devuelve un LLM?
Antes de publicar, revisá la distribución de las notas y no solo algunos casos sueltos. Si una porción grande de los valores cae en una banda angosta alrededor del centro de la escala, el problema está en el modelo o en el prompt, no en el diseño del sitio. El siguiente criterio de verificación es una propuesta editorial, no algo que el autor del caso haya medido.
- Separá extracción de scoring. Para datos duros (año, cantidad de jugadores, etiquetas) un modelo local de 8 o 9B rinde bien. Para puntajes comparativos donde importa la separación relativa, el propio autor sugiere modelos de API livianos.
- Mirá el histograma, no el promedio. Contá cuántos valores distintos aparecen y qué porcentaje se concentra en el tramo medio. Una tabla de frecuencias simple expone en un minuto lo que una revisión manual de fichas tarda horas.
- Usá casos canario. Incluí en el lote dos ítems con extremos conocidos —por ejemplo, un juego de azar puro y uno de información perfecta— y comprobá si caen donde corresponde. Si los dos aterrizan en el medio, la escala no está funcionando.
- Tené un plan B antes de migrar. Las alternativas que el autor enumera son calibración con few-shot, ranking por pares y cambio de modelo. Ninguna es gratis: las dos primeras requieren iteración, la tercera cambia el costo por token.
- Hacé el pipeline idempotente. Desacoplar la generación de JSON del frontend permite reprocesar el dataset completo en una corrida cuando cambies de modelo o de prompt.
¿Conviene un modelo local o la API?
Depende de qué tarea cumple el modelo dentro del pipeline. Para extraer hechos y armar estructuras, un modelo local chico es una opción razonable y sin costo por consulta. Para puntuar y ordenar un conjunto de datos donde la separación entre ítems es el producto, la evidencia del caso apunta a que un modelo de API liviano produce distribuciones más utilizables. Es una conclusión de un solo proyecto y conviene tratarla como hipótesis a probar en el dominio propio, no como regla general.
Para quien esté armando algo parecido, el paso más barato sigue siendo el primero: generar el lote, graficar la distribución y recién después decidir si el problema justifica cambiar de backend. Y si el proyecto va a vivir en producción con dominio propio, conviene resolver el hosting y el dominio en un proveedor local como Donweb, que permite mantener el sitio y la administración en el mismo lugar.
Fuentes
- Tabletop Dev Labs, «Why My Local LLM (Qwen 3.5 9B) Rated Every Board Game 50/50 — And How Switching to Gemini 3.5 Flash-Lite Fixed It», dev.to, 21 de noviembre de 2026: dev.to/tabletop_dev_labs.
- Joonhee Kim, «The Missing Taste Model», 27 de febrero de 2026: joonhee.kim.