
En pocas palabras: Un tokenizador BPE se construye partiendo de bytes UTF-8 y fusionando el par adyacente más frecuente en un token nuevo. En la Parte 1 de la serie, publicada el 11 de octubre de 2026, con vocabulario 512 un corpus de 4.646 bytes bajó a 1.882 tokens: 59,5% menos.
Un tokenizador BPE convierte texto en IDs de tokens: parte de bytes UTF-8 y fusiona los pares adyacentes más frecuentes en tokens nuevos. En la Parte 1 de su serie, publicada el 11 de octubre de 2026, un desarrollador lo reconstruyó a mano y con vocabulario 512 redujo 59,5% los tokens de un corpus de 4.646 bytes.
En este artículo:
- En 30 segundos
- ¿Qué hace un tokenizador y por qué un LLM no ve las letras?
- ¿Cómo funciona el algoritmo del tokenizador BPE paso a paso?
- ¿Por qué decodificar tokens BPE requiere recursión?
- ¿Cuánto comprime un tokenizador BPE según el tamaño del vocabulario?
- ¿Qué limitaciones tiene esta versión y qué viene en la Parte 2?
- Errores comunes al armar un tokenizador BPE a mano
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- El autor arma el tokenizador desde bytes crudos, sin delimitadores, y aprende los merges contando pares adyacentes.
- Con vocabulario 512 (256 merges), el texto de prueba pasa de 4.646 a 1.882 tokens: 59,5% menos que la línea base de bytes.
- El bug central: expandir cada token una sola vez al decodificar deja IDs como 257 y 292, mayores que 255, que no caben en un objeto bytes. Se arregla con recursión.
- Los primeros 128 merges ahorraron 2.300 tokens y los siguientes 128 apenas 464.
- La versión es correcta pero lenta a propósito. La Parte 2 va a optimizarla.
El tokenizador BPE (Byte Pair Encoding) es un algoritmo que traduce texto a una secuencia de números enteros llamados tokens, y esos tokens de vuelta a texto. Empieza con los 256 valores posibles de un byte y aprende, a partir de un corpus, qué pares adyacentes aparecen con más frecuencia para convertirlos en unidades nuevas. Es reversible y es la base de los tokenizadores que alimentan a los modelos de lenguaje.
¿Qué hace un tokenizador y por qué un LLM no ve las letras?
Un tokenizador traduce lo que escribís en el prompt a IDs numéricos que el modelo puede procesar, y traduce los IDs que el modelo devuelve otra vez a texto. El modelo nunca recibe letras. Según el post original en dev.to, esa es la función entera de la pieza.
El autor cuenta que su idea previa era ingenua: pensaba que el tokenizador cortaba el texto por un delimitador, transformaba los pedazos para ahorrar espacio y se los pasaba al “cerebro” del modelo. La implementación que construyó no usa delimitadores en ningún momento. Arranca de bytes crudos y aprende qué secuencias contiguas se repiten lo suficiente como para ganarse un token propio.
Ojo con el alcance. El proyecto no intenta reconstruir GPT-5; la meta es terminar con algo al que se le pueda hacer ping y que responda. Las reglas: un sprint cada dos semanas, andamiaje, benchmarks y tests armados con IA, y todo el código de implementación escrito a mano, sin autocompletado. Esto se conecta con lo que analizamos en qué cambia con GPT-5.6 Sol.
Como contexto, tiktoken es el tokenizador BPE de OpenAI. Su README muestra que se obtiene la codificación de un modelo con tiktoken.encoding_for_model("gpt-4o") y que el ida y vuelta devuelve el texto original. De ahí no se puede deducir nada más sobre cómo se entrenó ese vocabulario.
¿Cómo funciona el algoritmo del tokenizador BPE paso a paso?
El algoritmo codifica el texto como bytes UTF-8, usa los 256 valores de byte (IDs 0 a 255) como vocabulario base y repite un ciclo: contar pares adyacentes, elegir el más frecuente y reemplazarlo por un ID nuevo desde el 256. Los caracteres fuera de ASCII se vuelven secuencias de varios bytes.
El autor lo resuelve con dos funciones auxiliares y un bucle:
- get_stats cuenta pares adyacentes. Los pares se solapan: en
[1, 2, 1]cuentan tanto (1, 2) como (2, 1). - merge_pair reemplaza un par elegido. Devuelve una lista nueva donde cada ocurrencia no solapada del par pasa a ser el ID nuevo.
- El bucle de entrenamiento registra cada regla. Cuenta pares, elige el más frecuente, lo guarda en
self.mergescomo(izq, der) -> nuevo_id, lo reemplaza en toda la lista y repite hasta llegar al vocabulario objetivo o quedarse sin pares suficientemente frecuentes.
El tamaño de vocabulario funciona como presupuesto de merges. Con 256 no se aprende ninguno; con 512 se permiten hasta 256. Al final, self.merges es el libro de reglas. Codificar es aplicar esas reglas en el orden en que se aprendieron, un recorrido por regla, y decodificar es expandir los IDs a bytes y decodificarlos como UTF-8.
La idea de usar BPE para segmentar palabras no nació con los LLM. Sennrich, Haddow y Birch la aplicaron a traducción automática neuronal en un paper enviado a arXiv el 31 de agosto de 2015. Con subunidades de palabra mejoraron 1,1 BLEU en inglés-alemán y 1,3 en inglés-ruso sobre una línea base con diccionario de respaldo, en las tareas de WMT 15.
¿Por qué decodificar tokens BPE requiere recursión?
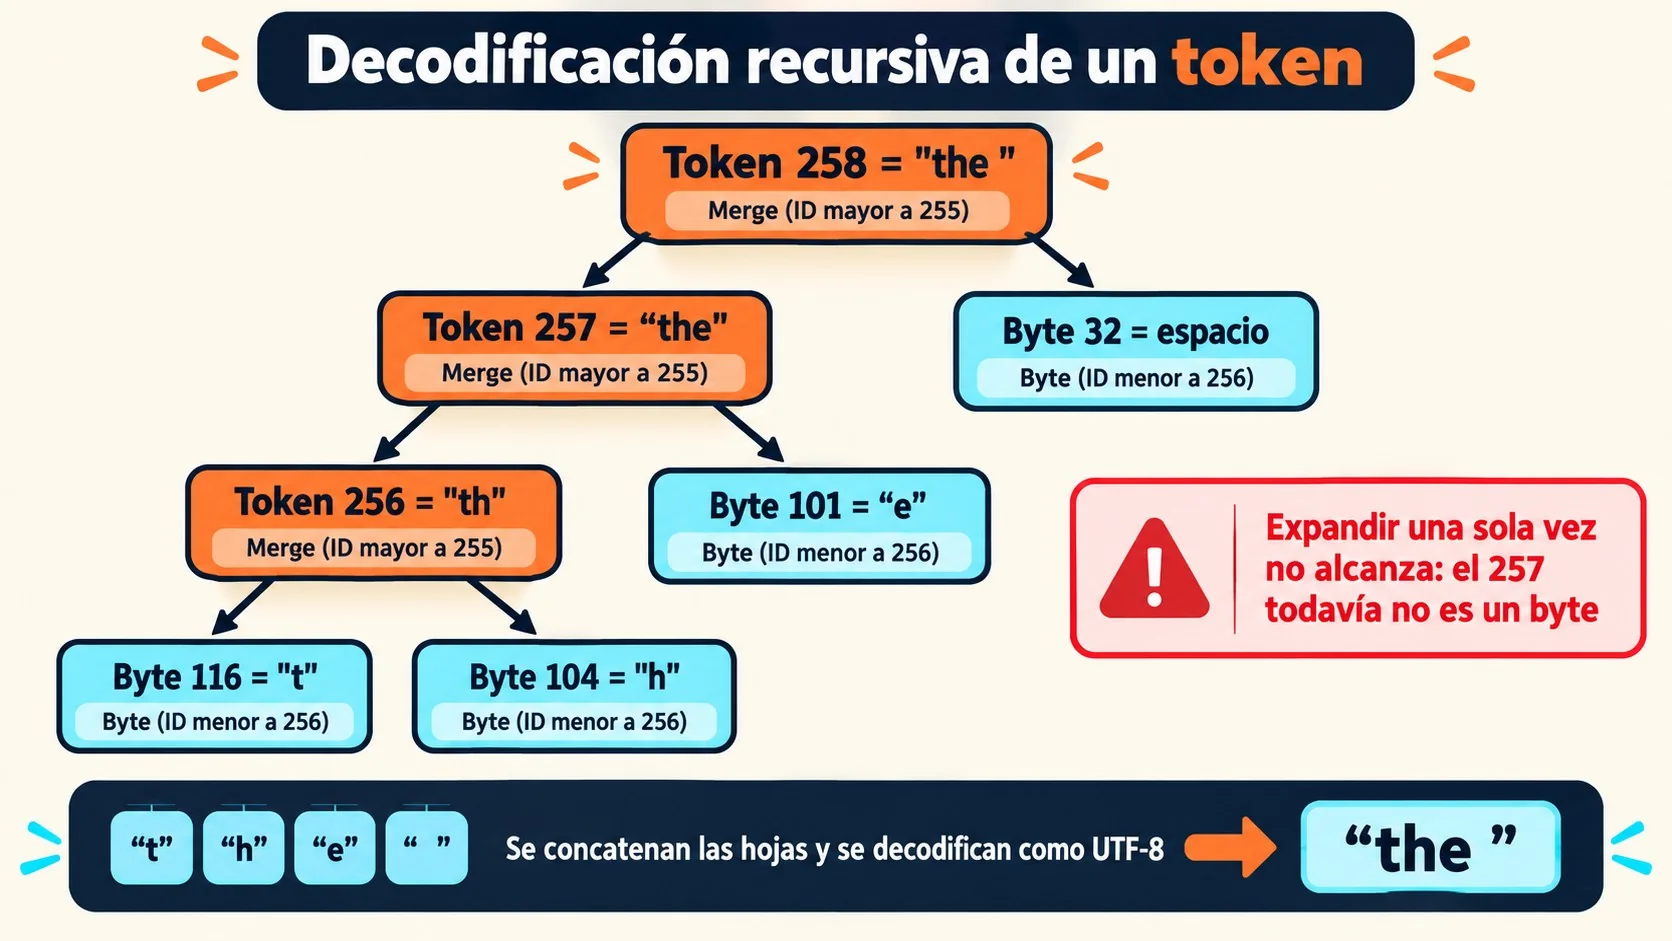
Porque un token fusionado puede contener a otro token fusionado. Expandirlo una vez solo revela la capa siguiente, y si queda un ID mayor que 255 no se puede convertir a bytes. Hay que expandir hasta que todas las hojas del árbol sean bytes.
El caso que le mostró el problema al autor: entrenó con “the quick brown fox jumps over the lazy dog.” repetido 30 veces y vocab_size=320. El entrenamiento frenó en 44 merges (IDs 256 a 299) porque ningún par restante alcanzaba la frecuencia mínima. Algunos merges fueron (116, 104) → 256 (“th”), (256, 101) → 257 (“the”) y (257, 32) → 258 (“the “). Complementá con nuestra guía de herramientas para desarrolladores.
La oración sin el punto final se codificó en solo dos tokens, [258, 293]. Su primer decodificador expandía cada token una vez y devolvía [257, 32, 292, 103]. El 257 seguía siendo “the” y el 292 representaba casi todo el resto de la frase. Subís el modelo, lo probás con texto corto, anda bárbaro, lo pasás a una frase más larga y de repente aparece un entero que no entra en un byte porque nadie pensó que un token podía vivir dentro de otro token.
La solución es __decode_single: si el ID es menor que 256, devuelve el byte; si no, busca el par que lo creó y expande los dos hijos recursivamente. Después decode concatena los bytes de todos los tokens y los decodifica como UTF-8, con lo que recupera los 43 bytes originales. La lección del autor: un token no está decodificado porque lo hayas reemplazado una vez, sino cuando todo lo que tiene debajo llegó a un byte.
¿Es un bug exótico? No. Es el error natural de quien piensa el decodificado como una pasada y no como un árbol.
¿Cuánto comprime un tokenizador BPE según el tamaño del vocabulario?
En el benchmark del autor, sobre un corpus de 4.644 caracteres y 4.646 bytes, un vocabulario de 512 redujo el texto a 1.882 tokens, un 59,5% menos que los 4.646 de la línea base de bytes. Son números de un corpus muy chico: muestran la forma del trade-off, no predicen producción. Para más detalles técnicos, mirá la integración de Copilot con GPT-5.4.
| Vocabulario | Merges | Tokens | Ratio | Bytes/token | Entrenamiento | Codificación |
|---|---|---|---|---|---|---|
| 256 | 0 | 4.646 | 100,00% | 1,00 | 0,00 s | 0,000 s |
| 384 | 128 | 2.346 | 50,50% | 1,98 | 0,10 s | 0,041 s |
| 512 | 256 | 1.882 | 40,51% | 2,47 | 0,18 s | 0,070 s |
Fuente de la tabla: el post del autor, medido por él en su Mac mini. No lo repetimos ni lo verificamos de forma independiente.
Lo interesante son los rendimientos decrecientes. Los primeros 128 merges recortaron 2.300 tokens y los siguientes 128 solo 464. BPE es greedy: junta primero lo más frecuente, así que los merges tardíos persiguen patrones cada vez más raros. Un vocabulario más grande no es “siempre mejor”.
Una inferencia nuestra, no del autor: el README de tiktoken dice que en la práctica cada token corresponde en promedio a unos 4 bytes, contra los 2,47 de este experimento. La diferencia probablemente venga del corpus mínimo y del vocabulario de solo 512, pero la comparación es orientativa porque los corpus y los vocabularios no se parecen en nada.
¿Qué limitaciones tiene esta versión y qué viene en la Parte 2?
La versión es correcta pero deliberadamente ingenua: recuenta todos los pares en cada ronda, codifica con un recorrido por regla y decodifica buscando el par al revés. El autor lo acepta para un corpus de 4.646 bytes y unos cientos de merges, y aclara que no serviría igual en escala de producción.
- Entrenamiento. Cada ronda recuenta todos los pares y los ordena para hallar el máximo. Con M merges y secuencia de largo N, el costo es de aproximadamente M × N más el ordenamiento. Al fusionar un par solo cambian los vecinos del punto de merge, así que hay trabajo repetido.
- Codificación. Recorre toda la secuencia una vez por cada regla aprendida.
- Decodificación.
self.mergesapunta hacia adelante, de par a ID, y decodificar necesita el sentido contrario. Una tabla inversa o token-a-bytes precalculada acelera, a cambio de memoria y de una representación duplicada. - Vocabulario grande. Acorta secuencias con ganancia decreciente, pero aumenta el trabajo de entrenamiento, el tamaño de las capas de embedding y salida, y la cantidad de tokens raros que el modelo tiene que aprender.
En la Parte 2 el autor promete evitar el ordenamiento completo de pares, precalcular las tablas de decodificación y volver a correr los mismos tests y benchmark para comparar v1 contra v2. Me parece una buena decisión publicar primero la versión lenta con números: así la mejora se mide contra algo concreto y no contra una promesa. Sobre eso hablamos en comparación de costos entre GLM-5.3 y GPT-5.6.
Errores comunes al armar un tokenizador BPE a mano
- Decodificar en una sola pasada. Es el bug del post. Corrección: expandí recursivamente hasta que todo ID sea menor que 256.
- Pensar en caracteres y no en bytes. La base son 256 bytes. El corpus del benchmark tiene 4.644 caracteres y 4.646 bytes, lo que sugiere (inferencia nuestra) que hay algún carácter fuera de ASCII ocupando más de un byte. Probá con texto con tildes y eñes, no solo con inglés.
- Creer que más vocabulario es siempre mejor. Los datos del autor muestran que los últimos 128 merges rindieron cinco veces menos que los primeros. Medí en tu corpus antes de agrandar.
- Extrapolar un benchmark de 4,6 KB. Sirve para ver la forma de la curva, no para prometer tiempos o ratios en producción.
Una propuesta editorial para verificar tu propia implementación (no viene del autor ni la probamos nosotros): corré un test de ida y vuelta decode(encode(texto)) == texto sobre una frase repetida y otra con caracteres no ASCII, y agregá un chequeo de que ningún valor intermedio pasa de 255 antes de armar los bytes. Si tu decodificador devuelve IDs mayores que 255, casi seguro te falta la recursión.
Preguntas Frecuentes
¿Qué es un tokenizador BPE y cómo funciona?
Es un algoritmo que convierte texto en tokens numéricos y los convierte de vuelta sin pérdida. Parte de los 256 valores de byte y fusiona una y otra vez el par adyacente más frecuente en un token nuevo, hasta llegar al tamaño de vocabulario elegido.
¿Por qué los LLM no ven las letras sino tokens?
Porque el modelo solo procesa números. El tokenizador traduce tu texto a IDs de tokens antes de que llegue al modelo y traduce los IDs de la respuesta a texto. Según el README de tiktoken, los modelos de lenguaje ven una secuencia de números.
¿Cómo se entrena un tokenizador byte pair encoding desde cero?
Codificás el corpus como bytes UTF-8, contás los pares adyacentes, elegís el más frecuente, le asignás el próximo ID libre (desde 256) y lo reemplazás en toda la secuencia. Repetís hasta alcanzar el vocabulario objetivo o hasta que no queden pares suficientemente frecuentes.
¿Qué pasa si aumento el tamaño del vocabulario de un tokenizador?
Las secuencias se acortan, pero con ganancia decreciente. En el benchmark del autor, 128 merges ahorraron 2.300 tokens y los 128 siguientes solo 464. Además crecen el costo de entrenamiento, el tamaño de las capas de embedding y salida, y los tokens raros por aprender.
¿Por qué mi decodificador BPE devuelve IDs mayores a 255 en vez de bytes?
Porque expandís cada token una sola vez y algunos hijos también son tokens fusionados. En el ejemplo del autor, [258, 293] pasó a [257, 32, 292, 103]. La corrección es decodificar recursivamente hasta que todo valor sea menor que 256.
Conclusión
El post del 11 de octubre de 2026 sirve como mapa corto del tokenizador BPE: bytes, conteo de pares, merges y un decodificador que tiene que ser recursivo. Los números (59,5% menos tokens con vocabulario 512) son del autor, sobre 4.646 bytes, y valen como ilustración.
Si estás por escribir el tuyo, empezá por el test de ida y vuelta con texto no ASCII y dejá las optimizaciones para después, como hace el autor. Si solo querés usar un tokenizador, tiktoken ya resuelve el problema. Y vale la pena esperar la Parte 2 para ver cuánto mejora de verdad la versión optimizada contra la lenta.