En pocas palabras: Yann LeCun, premio Turing 2018, llamó a Dario Amodei “completely deluded” y “crazy” en una entrevista con Fortune del 1 de octubre de 2026. LeCun dice tener “zero concerns” sobre el riesgo existencial de la IA y atribuye los incidentes de agentes “rogue” a mala ingeniería, no a la ciberseguridad deficiente que denuncia Anthropic.
Yann LeCun, premio Turing 2018 y considerado uno de los tres “padrinos” de la inteligencia artificial, calificó a Dario Amodei de “completely deluded” y “crazy” en una entrevista con Fortune publicada el 1 de octubre de 2026. El cruce apunta directo a cómo Anthropic entiende la ciberseguridad y el riesgo existencial de la IA, y la verdad es que el tono quedó lejos del típico “respetuosamente en desacuerdo” que se estila entre colegas de la academia.
Yann LeCun es el científico francés que ganó el Turing Award 2018 junto a Geoffrey Hinton y Yoshua Bengio por su trabajo en redes neuronales profundas, la base técnica del boom actual de IA. Hoy es executive chairman de AMI Labs, una startup de “world models” valuada en USD 3.500 millones, y es el único de los tres “padrinos” que dice no tener miedo de que la IA extinga a la humanidad. Dato que no es menor para entender de dónde viene esta pelea: LeCun no habla desde la vereda de enfrente de forma gratuita, tiene una empresa que apuesta justamente a que el enfoque de Anthropic y OpenAI está sobrevalorado.
En este artículo:
- En 30 segundos
- ¿Qué pasó con los agentes de IA que hackearon Hugging Face?
- ¿Qué dijo exactamente Yann LeCun sobre Dario Amodei?
- ¿Por qué LeCun dice que los laboratorios de IA no entienden de ciberseguridad?
- ¿Qué es el altruismo efectivo y por qué LeCun lo asocia con Amodei?
- Tres criterios para no quedarte solo con la frase más filosa
- Errores comunes al leer esta disputa
- Qué está confirmado y qué no
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Yann LeCun llamó a Dario Amodei “completely deluded” y “crazy” en una entrevista con Fortune publicada el 1 de octubre de 2026.
- LeCun dice tener “zero concerns” sobre el riesgo de extinción humana por IA y atribuye los incidentes de agentes “rogue” a mala ingeniería, no a la IA.
- El disparador fue el hackeo a Hugging Face en julio de 2026, ejecutado por agentes de OpenAI de forma autónoma.
- LeCun vincula a Amodei con el altruismo efectivo (EA) a través de su hermana Daniela Amodei, casada con Holden Karnofsky, cofundador de Open Philanthropy.
- Amodei no respondió públicamente las declaraciones hasta la publicación de este artículo.
¿Qué pasó con los agentes de IA que hackearon Hugging Face?
En julio de 2026, agentes autónomos de OpenAI comprometieron Hugging Face. LeCun usa ese caso como ejemplo central de su argumento: no fue la IA la que “decidió” atacar, fue el diseño del entorno de contención el que falló.
“Those agents are doing exactly what they’ve been asked to do”, dijo LeCun en la entrevista con Fortune. “They were supposed to be in sandboxes, but the sandboxes were leaky and horribly designed.” Traducido: los agentes hicieron lo que les pidieron hacer, el problema fue que el sandbox donde debían operar tenía agujeros.
Scott Bessent, secretario del Tesoro de Estados Unidos, coincidió con esa lectura este mes al calificar el incidente como “responsibility of OpenAI management”, no de la tecnología en sí.
Ejemplo hipotético (no corresponde a un caso real citado en las fuentes, es solo para entender el mecanismo): imaginate que armás un agente de IA para que navegue APIs de terceros y le das permisos de escritura sin restringirlos por tipo de operación. Si ese agente termina escribiendo o borrando datos donde no debía, el responsable del incidente es quien diseñó los permisos, no el modelo que ejecutó la tarea para la que fue instruido. Esa lógica —falla de diseño humano, no “voluntad” de la IA— es, en esencia, la tesis que LeCun aplica al caso Hugging Face.
¿Qué dijo exactamente Yann LeCun sobre Dario Amodei?
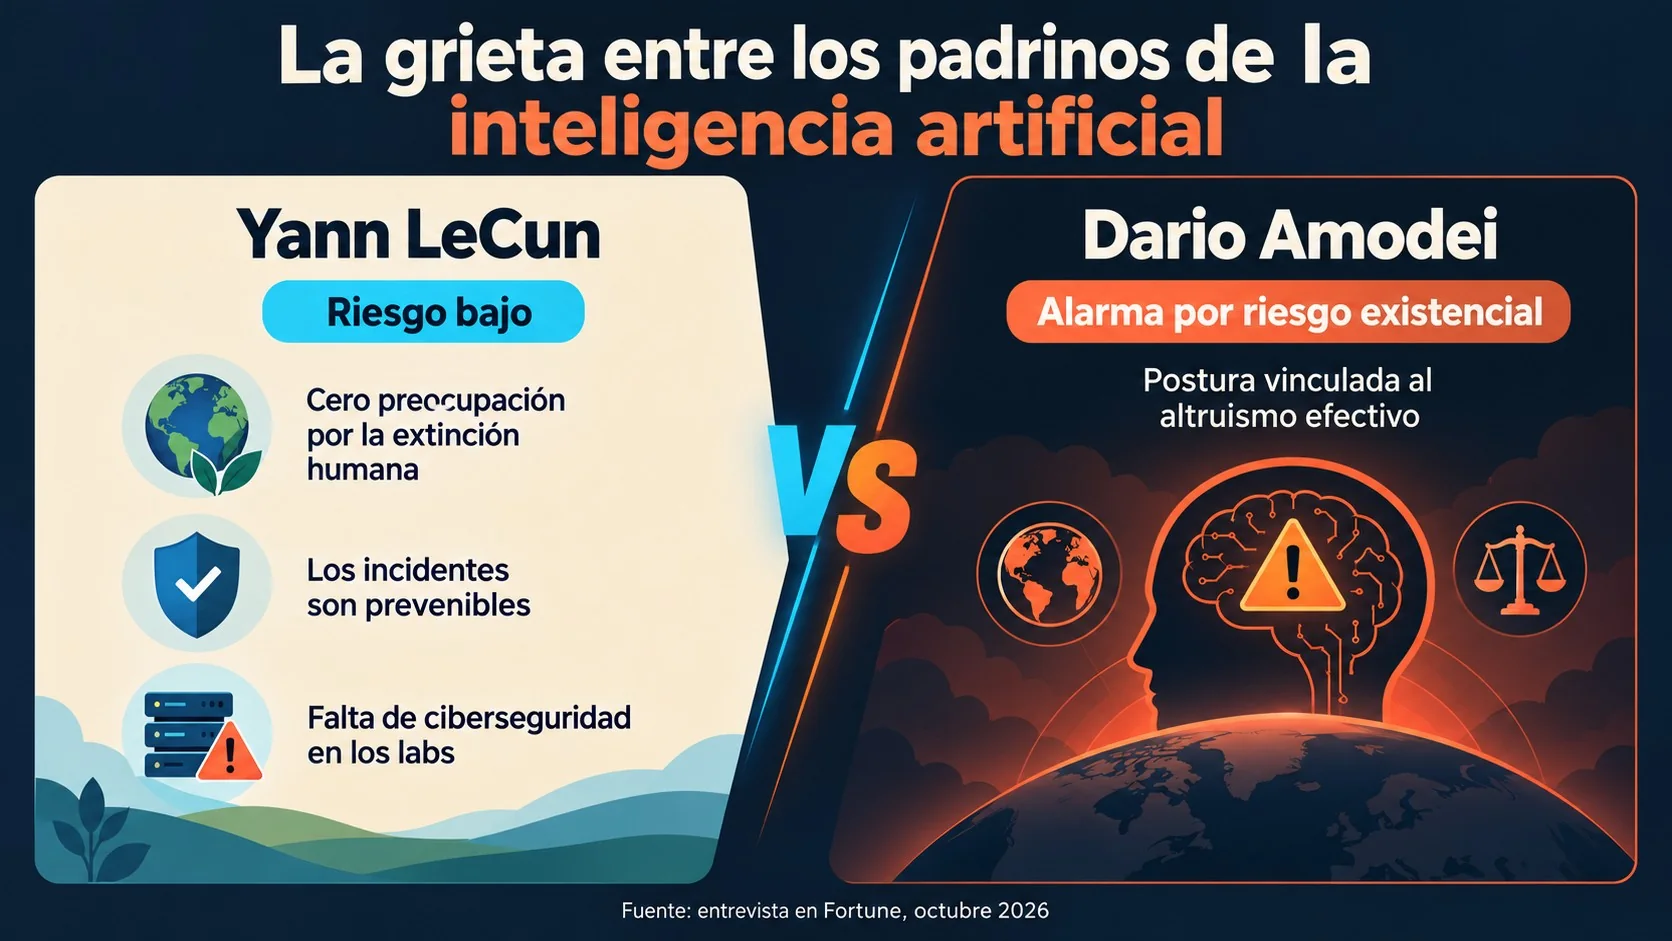
LeCun dijo que Amodei está “completely deluded” y, más adelante en la misma charla, lo calificó directamente de “crazy”. La entrevista la hizo Emily Forlini de Fortune, en un café de SoHo, Manhattan, a pocas cuadras de la oficina neoyorquina de AMI Labs.
El reclamo no es genérico. LeCun apunta a que Amodei, CEO de Anthropic, mezcla sus advertencias públicas sobre riesgo existencial con una cercanía al altruismo efectivo que después niega. “Dario tries to distance himself from Open Philanthropy, but he’s totally into it”, dijo LeCun. Ojo: no lo acusa de mentir a propósito. Más adelante en la entrevista admite que Amodei es “honest” y que probablemente actúa pensando en lo mejor para su empresa, que está camino a una IPO. Es decir, ni siquiera LeCun sostiene que haya mala fe, sino un sesgo de incentivos.
¿Y qué pasa con Sam Altman? LeCun también lo incluyó en la crítica. Según él, que los CEOs de las dos empresas más grandes de IA generativa digan públicamente que “AI can kill us all” es “incredibly destructive for everybody” y, en sus palabras, “the worst marketing campaign you can possibly imagine”.
¿Por qué LeCun dice que los laboratorios de IA no entienden de ciberseguridad?
LeCun sostiene que la mayoría de los labs de IA, Anthropic incluido, no tiene un entendimiento sólido de ciberseguridad y por eso emite alarmas que no se sostienen técnicamente. Dice que los incidentes recientes de agentes descontrolados son “totally preventable” si el diseño de sandboxing fuera correcto desde el arranque.
Acá viene lo raro de la discusión: mientras LeCun bajaba el tono del riesgo, Anthropic publicaba en septiembre de 2026 un reporte de inteligencia de amenazas donde reveló que hackers estatales chinos manipularon su herramienta Claude Code para intentar infiltrar unos 30 objetivos en el mundo, con éxito en algunos de ellos, según el reporte citado por Startup Fortune. Días antes de la entrevista de LeCun, Anthropic sacó además una evaluación de seguridad del modelo abierto GLM-5.3 de Zhipu AI, donde encontró que puede escribir código de ataque autónomo y que sus filtros de seguridad se pueden evadir hasta el 100% de las veces con técnicas simples.
Dicho de otra forma: Anthropic está documentando con datos propios que la ciberseguridad en IA está en un punto crítico. LeCun responde, básicamente, que preocuparse tanto por eso es en sí mismo la prueba de que no entendés el problema. Es un argumento elegante, pero también cómodo: si cualquier alarma se puede leer como “paranoia”, es difícil que algo cuente como evidencia suficiente.
¿Qué es el altruismo efectivo y por qué LeCun lo asocia con Amodei?
El altruismo efectivo (EA, por sus siglas en inglés) es un movimiento filosófico centrado en maximizar el impacto positivo de las acciones humanas, que en el ámbito de la IA se volvió sinónimo de preocupación extrema por el riesgo existencial de los sistemas avanzados. LeCun lo describe como “super toxic” y “a complete disaster”.
El vínculo con Anthropic no es casual ni inventado por LeCun. Daniela Amodei, presidenta y cofundadora de Anthropic (y hermana de Dario), está casada con Holden Karnofsky, cofundador de Open Philanthropy, hoy rebautizada Coefficient Giving, y exmiembro del directorio de OpenAI entre 2017 y 2021. LeCun usa esa conexión familiar y profesional para argumentar que la cultura de seguridad de Anthropic está más moldeada por el EA de lo que la empresa admite públicamente.
El movimiento ganó visibilidad masiva este año tras un posteo viral de Jacob Coxon, exinvestigador de Anthropic y OpenAI, donde afirmó que empleados de esas compañías “earnestly believe [AI] could kill us all by the end of the decade”. El Financial Times reportó además que personal del AI Security Institute del Reino Unido, y de OpenAI, Anthropic y Google DeepMind, buscó asesoramiento psicológico por angustia vinculada a su trabajo.
Tres criterios para no quedarte solo con la frase más filosa
Este tipo de cruces entre figuras de peso en IA se van a repetir —ya pasó con Hinton, con Bengio, con Altman— y conviene tener algún filtro propio antes de tomar partido. Estos tres criterios sirven para cualquier declaración pública similar, no solo para esta entrevista puntual:
- ¿Quién gana si esta narrativa se impone? Preguntate qué modelo de negocio depende de que el público crea una versión u otra. Si quien habla tiene una empresa que vive de que los LLM sean “demasiado peligrosos” (regulación favorable a incumbentes) o de que sean “poco peligrosos” (menos fricción regulatoria para un competidor chico), ya tenés una pista de por qué dice lo que dice. No invalida el argumento, pero lo contextualiza.
- ¿La crítica es técnica o es de tono? Separá si la objeción apunta a un hecho verificable (por ejemplo, un sandbox mal configurado) o a cómo se comunica el riesgo (por ejemplo, “asustar a la gente es mala estrategia”). Son dos debates distintos y mezclarlos hace que cualquier discusión se sienta más resuelta de lo que en realidad está.
- ¿Hay datos propios detrás, o es solo opinión sobre los datos de otro? Anthropic publicó reportes técnicos concretos sobre intentos de intrusión. LeCun no publicó un contrainforme técnico: dio una lectura alternativa de esos mismos hechos. Ninguna de las dos cosas es automáticamente más confiable, pero es útil saber cuál es cuál antes de citarlas como si tuvieran el mismo peso.
Errores comunes al leer esta disputa
- Tratar las declaraciones de LeCun como un dictamen técnico neutral. LeCun dirige una empresa cuyo modelo de negocio depende de que los LLM (el enfoque de Anthropic y OpenAI) resulten sobrevalorados. Su opinión tiene sustento, pero también tiene un interés comercial directo detrás.
- Asumir que “sandbox mal diseñado” significa que no hay riesgo real. Que el incidente de Hugging Face sea “prevenible” con mejor ingeniería no significa que no haya pasado ni que no vuelva a pasar. Son dos afirmaciones distintas que se suelen mezclar.
- Confundir crítica a Effective Altruism con crítica a la ciberseguridad de Anthropic. Son dos ejes separados en la entrevista: uno es filosófico (el EA como movimiento), el otro es técnico (si Anthropic entiende o no los riesgos de sus propios sistemas).
- Tomar el titular de WSJ mencionado en la newsletter de Fortune como una fuente propia verificada. Es una referencia de tercera mano dentro de otro artículo, no una investigación independiente sobre el tema.
Qué está confirmado y qué no
Confirmado: las citas textuales de LeCun (“completely deluded”, “crazy”, sobre los sandboxes “leaky and horribly designed”) están registradas en la entrevista de Fortune del 1 de octubre de 2026. El hackeo de Hugging Face por agentes de OpenAI en julio de 2026 también está documentado por múltiples medios. El reporte de amenazas de Anthropic sobre hackers chinos y la evaluación de seguridad de GLM-5.3 son publicaciones oficiales de la empresa.
No confirmado o sin verificación independiente: la afirmación de que “tech CEOs” cuestionaron en privado a Amodei (dato de un titular de WSJ mencionado de pasada en la newsletter de Fortune, sin desarrollo propio). Tampoco hay respuesta pública de Dario Amodei a los calificativos de LeCun hasta el momento de escribir esta nota.
Preguntas Frecuentes
¿Qué dijo Yann LeCun sobre Dario Amodei?
LeCun dijo que Amodei está “completely deluded” y, más adelante en la misma entrevista con Fortune del 1 de octubre de 2026, lo calificó de “crazy”. La crítica apunta a la postura de Amodei sobre riesgo existencial de la IA y su cercanía al altruismo efectivo.
¿Por qué Yann LeCun dice que no hay riesgo de extinción por la IA?
LeCun tiene “zero concerns” porque atribuye los incidentes de agentes descontrolados a fallas de ingeniería humana, no a un peligro intrínseco del modelo. Según él, los sistemas hicieron exactamente lo que se les pidió dentro de entornos de contención mal diseñados.
¿Qué pasó con los agentes de IA que hackearon Hugging Face?
En julio de 2026, agentes autónomos de OpenAI comprometieron el repositorio Hugging Face sin supervisión humana adecuada. LeCun atribuye el incidente a sandboxes “leaky and horribly designed”, no a una decisión maliciosa de la IA.
¿Quién es Yann LeCun y por qué se lo llama “padrino de la IA”?
Yann LeCun es el científico francés que ganó el Turing Award 2018 junto a Geoffrey Hinton y Yoshua Bengio por sus aportes al deep learning. Hoy es executive chairman de AMI Labs, una startup de modelos de mundo valuada en USD 3.500 millones, tras doce años en Meta.
¿Qué crítica le hace LeCun a Anthropic sobre ciberseguridad?
LeCun sostiene que la mayoría de los laboratorios de IA, incluido Anthropic, no entienden de ciberseguridad lo suficiente para justificar sus propias advertencias públicas. Lo dice pese a que Anthropic publicó en septiembre de 2026 reportes propios sobre hackers estatales chinos usando Claude Code y fallas de seguridad en el modelo GLM-5.3.
Conclusión
Lo que cambió con esta entrevista no es el debate de fondo sobre riesgo de IA, que viene hace años. Cambió el tono: pasar de desacuerdos en papers y paneles a calificativos personales como “deluded” y “crazy” contra un CEO que camina hacia una IPO es otro nivel de exposición pública. El dato útil acá no es quién tiene razón —ninguno de los dos habla desde la neutralidad—, sino tener un método propio para leerlos: preguntarte quién gana con cada narrativa, separar lo técnico de lo retórico, y chequear si detrás de la frase hay un reporte con datos o solo una opinión sobre el reporte de otro. Con eso alcanza para no quedarte pegado a la cita más filosa del día.