En pocas palabras: En 2026 el mapa de context engineering para agentes de IA se resume en cuatro principios que coinciden Anthropic, papers académicos y reportes de producción: pointers en vez de payloads, progressive disclosure, menos contexto pero relevante, y freshness automatizada para evitar que archivos como CLAUDE.md queden desactualizados y confundan al agente.
Cuatro principios de context engineering para agentes de IA se repiten en 2026 en fuentes independientes: Anthropic, papers académicos y reportes de producción. El consenso es que menos contexto por request mejora la precisión, no solo baja el costo. Un CLAUDE.md de 238 líneas cargado entero en cada request es el error típico que estos cuatro principios vienen a corregir.
El context engineering en agentes de IA es la disciplina que decide qué tokens entran en la ventana de contexto en cada turno de inferencia, a diferencia del prompt engineering, que fija instrucciones estáticas una sola vez. Incluye herramientas, archivos de memoria como CLAUDE.md, resultados de búsqueda y el historial de la conversación. La meta, según la guía de Anthropic sobre context engineering, es el set mínimo de tokens de alta señal.
En este artículo:
- En 30 segundos
- ¿Qué diferencia hay entre prompt engineering y context engineering?
- ¿Qué cuatro principios de context engineering para agentes de IA repiten las fuentes de 2026?
- ¿Por qué cargar todo el CLAUDE.md en cada request es un error?
- ¿Qué dice el estudio de ETH Zurich sobre los archivos de contexto (AGENTS.md)?
- ¿Cómo se ve “menos contexto, pero relevante” en números reales?
- ¿Cómo se estructura un repositorio que aplica los cuatro principios?
- ¿Cuál es la consecuencia práctica para equipos que mantienen agentes en producción?
- Errores comunes al diseñar el contexto de un agente
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Cuatro principios de 2026 se repiten en fuentes independientes: pointers no payloads, progressive disclosure, menos contexto pero relevante, y freshness automatizada.
- Un benchmark con GPT-5 y herramientas Dynamics 365 subió la itemización completa de gastos de 71.0% a 91.6% y bajó tokens de 1.48M a 553K, un 62.6% menos.
- El estudio de ETH Zurich sobre AGENTS.md encontró que los archivos de contexto no mejoran el resultado en SWE-bench de forma significativa (-0.5%, p=0.87) pero sí suben el costo de inferencia 20-23% (p<0.001).
- Un root CLAUDE.md puede pasar de 238 líneas a unas 80 si separás el mapa de navegación del contenido pesado.
- arXiv:2607.17598 muestra que un segundo nivel de routing en progressive disclosure nunca ayuda y a veces rompe la precisión.
¿Qué diferencia hay entre prompt engineering y context engineering?
El prompt engineering optimiza instrucciones fijas que escribís una sola vez. El context engineering administra, turno a turno, todo lo que entra en la ventana del modelo: historial, herramientas, documentos y resultados de búsquedas anteriores. Según Anthropic, esto se volvió crítico porque los agentes corren en loop y generan, en cada vuelta, más datos candidatos a entrar en el próximo prompt.
Ponele que tenés un agente de soporte que arrastra el historial completo de la charla con el cliente, más la base de conocimiento entera, más los logs del ticket anterior. En algún momento el modelo empieza a perder precisión en lo que lee al principio del prompt. Eso no es un bug de tu prompt. Es un problema de contexto.
El motivo técnico es la arquitectura transformer: cada token atiende a todos los demás, lo que genera relaciones n² para n tokens. Cuanto más larga la ventana, más se estira esa capacidad de atención, y el modelo entrena mayormente con secuencias cortas, así que tiene menos experiencia con dependencias de largo alcance. No es un precipicio abrupto, es una pendiente que vas bajando sin darte cuenta. Ya lo cubrimos antes en los cambios para usuarios Plus en 2026.
¿Qué cuatro principios de context engineering para agentes de IA repiten las fuentes de 2026?
Cuatro principios aparecen en guías de vendors, papers académicos y herramientas de producción sin que esas fuentes se hayan puesto de acuerdo entre sí: pointers no payloads, progressive disclosure, menos contexto pero relevante, y freshness como feature. Cada uno tiene evidencia propia de 2026 detrás, documentada en el mapa de contexto de agentes publicado en dev.to.
| Principio | Qué dice | Evidencia 2026 |
|---|---|---|
| Pointers, no payloads | Identificadores livianos en la ventana, el contenido pesado se carga cuando hace falta | Guía “just-in-time context” de Anthropic; los skills de Claude Code cargan solo name y description |
| Progressive disclosure | Revelar detalle por etapas, según la complejidad de la tarea | arXiv:2607.17598: un nivel de routing alcanza, un segundo nivel “nunca ayuda y a veces rompe la precisión” |
| Menos, pero relevante | Pasado un umbral, más contexto baja la precisión, no solo sube el costo | Benchmark de gastos hoteleros con GPT-5: itemización completa de 71.0% a 91.6% con 62.6% menos tokens; RepoGraph reporta +32.8% de ganancia relativa en 4 frameworks de SWE-Bench |
| Freshness es una feature | El contexto desactualizado no queda en silencio, desorienta activamente al agente | arXiv:2605.10990: la documentación vieja guía código, revisiones y reparaciones generadas |
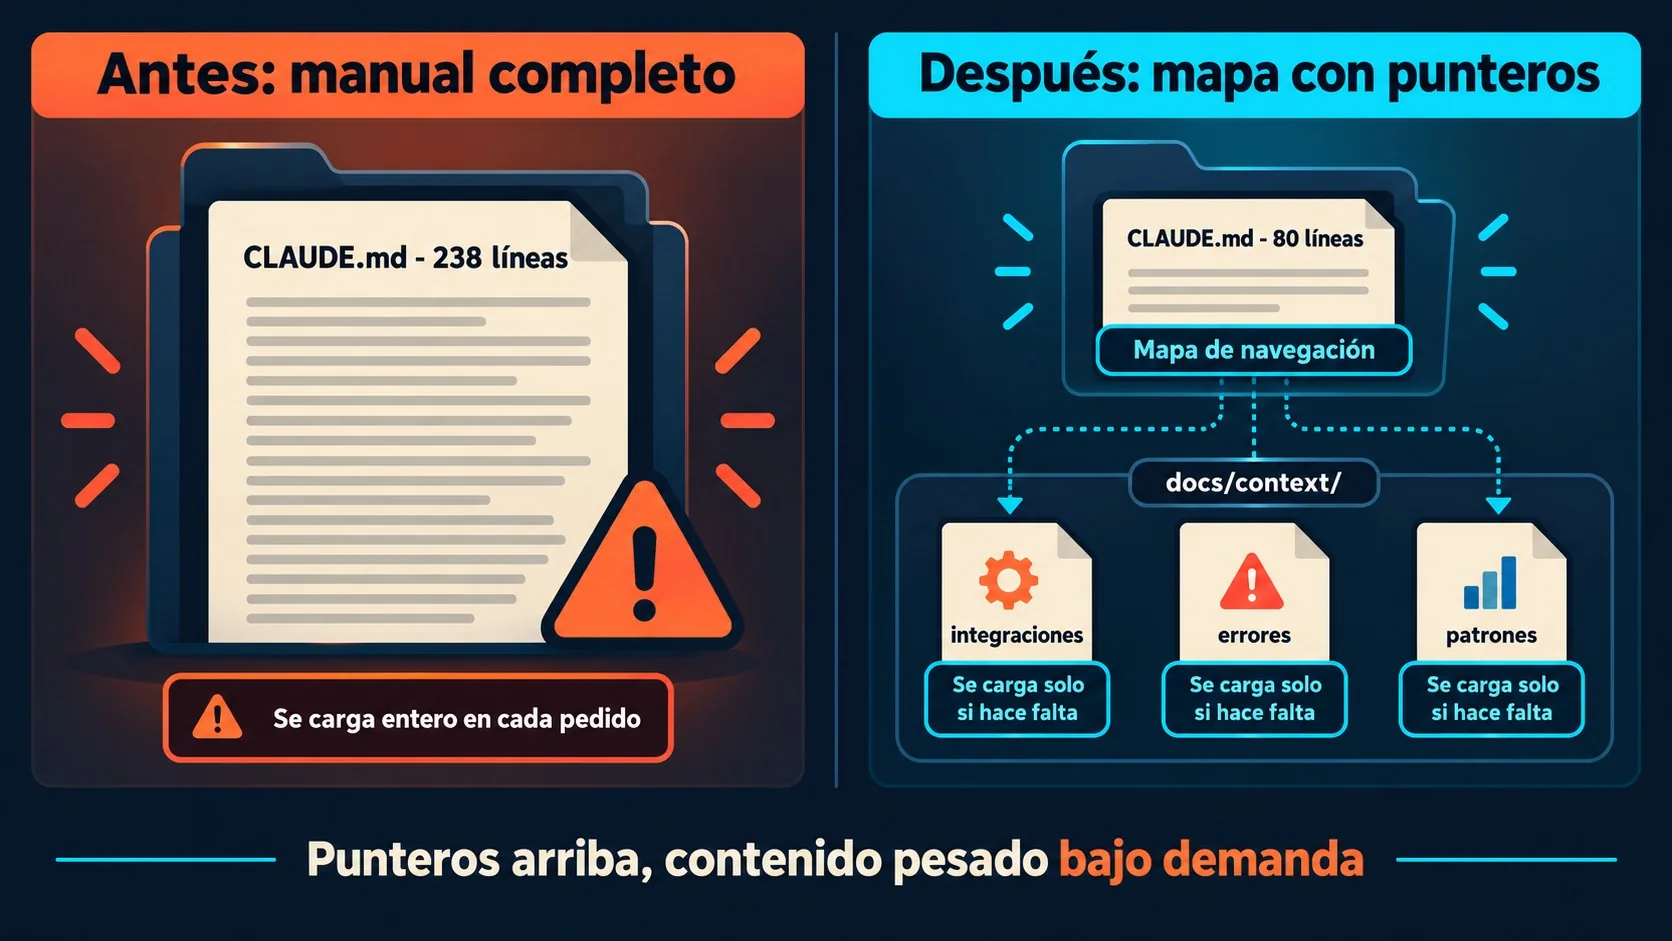
No son cuatro trucos sueltos. Son una sola idea mirada desde cuatro ángulos: la ventana de contexto tiene que guardar referencias y rutear al detalle, en vez de tragarse el repositorio entero.
¿Por qué cargar todo el CLAUDE.md en cada request es un error?
Cargar un CLAUDE.md completo en cada request genera dos fallas al mismo tiempo: bloat, cuando el agente arrastra esquemas y configuraciones de subsistemas que ni siquiera toca, y rot, cuando el archivo quedó desactualizado y empieza a mentirle. El caso documentado habla de un root CLAUDE.md de unas 238 líneas que se cargaba entero en cada request, sin importar la tarea.
Arreglás un test en un subsistema y, sin embargo, el agente igual arrastra esquemas, configs y notas de migración de tres vecinos que nunca va a tocar, porque nadie separó el mapa del contenido, y ese desperdicio de atención es exactamente lo que explica el context rot que mencionamos antes.
El rot es el otro lado de la moneda. Algunos ingenieros se olvidan de actualizar los archivos de contexto. Otros directamente nunca lo hacen. Los archivos se desalinean del código y, en vez de quedar neutros, empiezan a mentirle al agente de forma activa. Tema relacionado: nuestra guía completa de herramientas para desarrolladores.
¿Qué dice el estudio de ETH Zurich sobre los archivos de contexto (AGENTS.md)?
El paper Evaluating AGENTS.md de Gloaguen, Mündler-Sasahara, Müller, Raychev y Vechev (ETH Zurich, 2026) encontró que los archivos de contexto no mejoran de forma significativa la tasa de éxito de agentes de código, pero sí suben el costo de inferencia más de 20% en promedio. Los autores lo dicen sin rodeos en el abstract: “providing context files does not generally improve task success rates, while increasing inference cost by over 20% on average”.
Los números exactos: archivos generados por LLM movieron la tasa de resolución -0.5% en SWE-bench (p=0.87) y -2% en CTXbench (p=0.37), ambos sin significancia estadística. Los archivos escritos por desarrolladores hicieron +2.4% en promedio (p=0.038), mejor que los generados, pero sin ganancia absoluta significativa (p=0.21). El único efecto sólido en todo el estudio es el costo: 20-23% más caro (p<0.001).
¿Esto significa que escribir un CLAUDE.md es tiempo perdido? No exactamente. Significa que un archivo de contexto rara vez hace al agente más inteligente, pero confiablemente lo hace costar 20% más. El arreglo no es “escribir un mejor archivo”. Es dejar de pagar por cargar un payload que no necesitás, que es el principio número uno visto desde el lado escéptico.
¿Cómo se ve “menos contexto, pero relevante” en números reales?
En un benchmark de 50 tareas de gastos hoteleros con GPT-5 y herramientas de Dynamics 365, aplicar recency pruning más summarization subió la itemización completa de 71.0% a 91.6% mientras cortaba los tokens usados de 1.48 millones a 553 mil, una reducción de 62.6%. RepoGraph, por su parte, reporta un 32.8% de ganancia relativa promedio en cuatro frameworks de SWE-Bench.
La curva no es plana. La precisión sube, pica y después cae a medida que la ventana sigue creciendo, un patrón que arXiv:2606.29718 describe como context rot: el modelo incluso abandona la búsqueda antes de tiempo cuando el contexto es demasiado largo. Eso es lo que hace que “menos” no sea una concesión de calidad, sino una mejora de calidad.
¿Cómo se estructura un repositorio que aplica los cuatro principios?
Un repositorio que aplica los cuatro principios separa el mapa del contenido pesado, así: Lo explicamos a fondo en la integración de Copilot con el agente para Jira.
- CLAUDE.md raíz (pointer): mapa de navegación y niveles de complejidad de tarea, se carga en cada request pero apunta a unas 80 líneas en vez de 238.
- docs/context/integrations.md (payload): se carga solo para trabajo cross-service.
- docs/context/errors.md (payload): se carga solo durante un incidente.
- docs/context/systemPatterns.md (payload): se carga solo al agregar un componente nuevo.
- CLAUDE.md por subsistema (payload): se auto-carga cuando el agente edita esa carpeta específica.
Hay una capa económica debajo de todo esto. El prompt caching solo premia un prefijo estable (hasta 90% de descuento en los tokens cacheados), así que conviene dividir la ventana en dos zonas: una cabeza fija y cacheada con el system prompt, las reglas y un índice compacto de pointers, y una cola dinámica donde entran los payloads pesados según la tarea del momento. Mantenés el descuento completo sin inflar la base.
¿Cuál es la consecuencia práctica para equipos que mantienen agentes en producción?
La consecuencia práctica es que ya no hay que adivinar cuántas líneas debería tener un CLAUDE.md. Guía de vendors, papers académicos y herramientas de producción llegaron al mismo set de cuatro reglas por caminos independientes: pointers sobre payloads, disclosure por profundidad, menos pero relevante, y freshness como propiedad de primera clase.
Eso sí: un mapa delgado solo funciona si los archivos de detalle existen y no se pudrieron. La freshness no corre con buenas intenciones. Necesita automatización, algún gate que la fuerce, porque confiar en que el equipo se acuerde de actualizar la documentación es, en la práctica, la forma más rápida de volver a la rot.
Errores comunes al diseñar el contexto de un agente
- Confundir contexto completo con mejor contexto: cargar el repo entero “por las dudas” es justo el reflejo que los cuatro principios vienen a frenar. Cuanto más grande la ventana cargada sin filtro, más rápido llega el punto donde la precisión empieza a caer.
- Asumir que un archivo generado automáticamente mejora la precisión: el estudio de ETH Zurich mostró que los archivos generados por LLM no tienen efecto significativo en SWE-bench ni en CTXbench. Si vas a invertir tiempo, invertilo en curar el archivo a mano, no en generarlo.
- No automatizar la freshness: dejar que los archivos de contexto se desactualicen sin ningún chequeo en CI es la forma más común de pasar de bloat a rot sin darte cuenta.
- Tratar el system prompt como el único lugar de ajuste: optimizar solo el prompt mientras herramientas, memoria y documentos quedan sin curar deja la mayor parte del problema sin tocar.
Preguntas Frecuentes
¿Qué es el context rot en agentes de IA?
El context rot es la caída en la capacidad del modelo para recuperar información con precisión a medida que crece el número de tokens en la ventana de contexto. No es un fallo puntual: la precisión sube, pica en algún punto y después cae de forma gradual, según describe el estudio arXiv:2606.29718.
¿Por qué un CLAUDE.md muy largo empeora las respuestas del agente?
Un CLAUDE.md largo cargado entero en cada request reparte el presupuesto de atención del modelo entre información irrelevante, lo que diluye la señal que realmente necesita para la tarea actual. El caso documentado de un archivo de 238 líneas mostraba al agente arrastrando esquemas y configs de subsistemas que ni siquiera tocaba. Relacionado: cómo GitHub y Anthropic reescriben código con agentes.
¿Cuántas líneas debería tener un archivo CLAUDE.md?
No hay un número mágico universal, pero el ejemplo de referencia de 2026 propone pasar de un archivo de 238 líneas de payload a uno de unas 80 líneas de pointers, dejando el resto en archivos separados que se cargan solo cuando la tarea lo requiere.
¿Es verdad que los archivos de contexto no mejoran la precisión del agente?
Es verdad, según el estudio de ETH Zurich sobre AGENTS.md: el efecto en la tasa de éxito no fue significativo ni en SWE-bench (-0.5%, p=0.87) ni en CTXbench (-2%, p=0.37). El único efecto que sí fue sólido y consistente fue el aumento de costo de inferencia, entre 20% y 23% (p<0.001).
¿Cómo estructurar el contexto de un agente de IA en producción?
Separando pointers de payloads: un archivo raíz liviano que actúa como mapa y navega hacia documentos de detalle que se cargan solo bajo demanda, según la tarea o el subsistema que el agente esté tocando. Sumale un prefijo cacheado estable y un gate que mantenga esos documentos de detalle actualizados.
Conclusión
Lo que cambió en 2026 no es que aparecieron nuevos trucos para escribir CLAUDE.md. Lo que cambió es que dejó de ser una cuestión de gusto: Anthropic, ETH Zurich y varios papers de context engineering llegaron, por caminos separados, al mismo set de cuatro reglas. Si tu equipo mantiene agentes en producción, la tarea concreta es dejar de medir el archivo de contexto en líneas y empezar a medirlo en pointers versus payloads, con un mecanismo que detecte cuándo ese contenido se desactualizó. Lo demás, incluido el tamaño exacto del archivo, es un detalle de implementación.
Fuentes
- Anthropic – Effective context engineering for AI agents
- Agent Context in 2026: The Whole Map on One Page
- Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents? (ETH Zurich, arXiv:2602.11988)
- Is Progressive Disclosure All You Need for Long-Context Agents? (arXiv:2607.17598)
- Context rot: estudio sobre degradación de precisión en ventanas largas (arXiv:2606.29718)