En pocas palabras: Depende del uso: Claude Opus 4.5 (24 de noviembre de 2025) gana en código con 80,9% en SWE-bench Verified, mientras GPT-5.2 (11 de diciembre de 2025) lidera en razonamiento abstracto con 90,5% en ARC-AGI-1 y resulta más económico por token de entrada.
Claude Opus 4.5 de Anthropic y GPT-5.2 de OpenAI, lanzados a fines de 2025, se perfilaron entre los modelos de IA conversacional más comentados del momento. Claude lidera en código con 80,9% en SWE-bench Verified; GPT-5.2 gana en razonamiento abstracto con 90,5% en ARC-AGI-1 y sale más barato por token de entrada.
Claude es el asistente de inteligencia artificial que desarrolla Anthropic, disponible en versión web, apps móviles y API, con Claude Opus 4.5 como su modelo más potente desde noviembre de 2025. ChatGPT es el producto conversacional de OpenAI, construido sobre GPT-5.2 desde diciembre de 2025, con variantes Instant, Thinking y Pro según la profundidad de razonamiento que necesite cada tarea.
En este artículo:
- En 30 segundos
- ¿Qué modelos están comparando: Claude Opus 4.5 contra GPT-5.2?
- Claude vs ChatGPT 2026: ¿qué IA es mejor para programar?
- ¿Qué IA conviene para escribir y analizar documentos largos?
- ¿Qué IA tiene mejores funciones multimedia?
- ¿Qué IA es más rápida, Claude o ChatGPT?
- ¿Cuánto cuesta Claude y cuánto cuesta ChatGPT en 2026?
- ¿Cuándo conviene elegir Claude y cuándo ChatGPT?
- ¿Qué significa esto para empresas que operan en Latinoamérica?
- ¿Qué está confirmado y qué sigue pendiente?
- Errores comunes al comparar Claude y ChatGPT
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Claude Opus 4.5 (lanzado el 24 de noviembre de 2025) saca 80,9% en SWE-bench Verified, el primer modelo en superar el 80% en ese benchmark de código.
- GPT-5.2 (lanzado el 11 de diciembre de 2025) llega a 90,5% en ARC-AGI-1 y 100% en AIME 2025, liderando en razonamiento abstracto y matemática.
- Contexto: GPT-5.2 maneja 400.000 tokens de ventana, Claude Opus 4.5 llega a 200.000 tokens.
- Precio API: GPT-5.2 cuesta USD 1,75 por millón de tokens de entrada, Claude Opus 4.5 cuesta USD 5,00, según datos de llm-stats.
- Velocidad: según Artificial Analysis, GPT-5.2 (Xhigh) genera 79 tokens por segundo contra 49 de Claude Opus 4.5 (Reasoning).
¿Qué modelos están comparando: Claude Opus 4.5 contra GPT-5.2?
Esta comparativa enfrenta a Claude Opus 4.5, el modelo insignia de Anthropic que salió el 24 de noviembre de 2025, contra GPT-5.2, la versión de OpenAI que llegó el 11 de diciembre de 2025 según el análisis de llm-stats. Los dos comparten fecha de corte de conocimiento en agosto de 2025. La diferencia está en la filosofía detrás de cada uno.
GPT-5.2 apuesta por la autoverificación. Antes de entregar una respuesta, cruza el output contra un grafo de conocimiento destilado, lo que, según el análisis de llm-stats, reduce la desinformación en aproximadamente un tercio y agrega menos de 30 milisegundos de latencia. Claude Opus 4.5 va por otro lado: está pensado para agentes que corren horas, días o semanas sin perder el hilo, con herramientas de memoria persistente y edición automática de contexto.
Ambos ofrecen control sobre cuánto “piensan” antes de responder. GPT-5.2 lo hace con tres variantes separadas (Instant, Thinking, Pro), cada una con un perfil de cómputo distinto. Claude Opus 4.5 usa un parámetro de esfuerzo (Low, Medium, Maximum) dentro del mismo modelo: en Medium iguala el rendimiento de Sonnet 4.5 usando 76% menos tokens, y en Maximum lo supera por 4,3 puntos usando 48% menos tokens, de acuerdo con llm-stats.
Si buscás una versión más económica de Claude, Sonnet 4.5 sigue siendo la opción intermedia de Anthropic. Del lado de OpenAI, eso lo cubre GPT-5.2 Instant.
Claude vs ChatGPT 2026: ¿qué IA es mejor para programar?
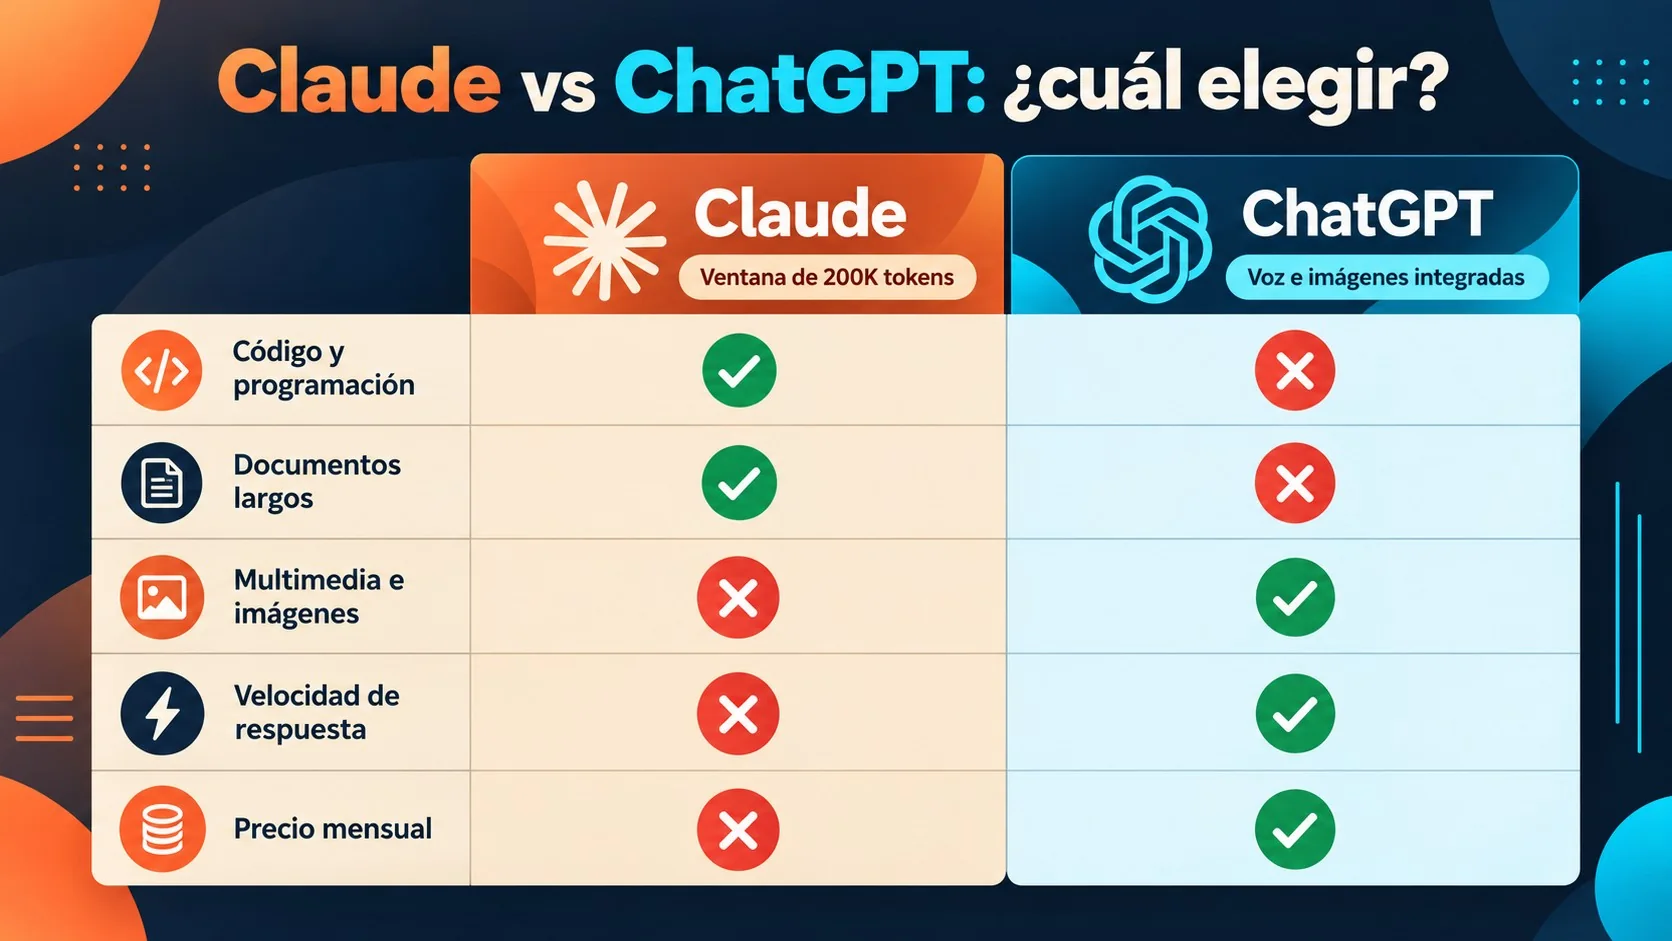
Claude Opus 4.5 gana en programación por un margen chico pero consistente: 80,9% en SWE-bench Verified contra 80,0% de GPT-5.2. La brecha se agranda en tareas de terminal, donde Claude llega a 59,3% en Terminal-Bench 2.0 frente al 47,6% de GPT-5.2, casi 12 puntos de diferencia según llm-stats.
El 80,9% en SWE-bench Verified significa que Claude resuelve 4 de cada 5 issues reales de GitHub cuando tiene el contexto completo del repositorio. No son ejercicios de juguete: son código de producción con dependencias complejas, suites de tests y cambios en varios archivos a la vez. En Aider Polyglot, Claude saca 89,4% y GPT-5.2 no tiene un valor publicado en esa tabla. En HumanEval están prácticamente empatados, con Claude en 84,9% y GPT-5.2 cerca del 85%. Ya lo cubrimos antes en la comparativa detallada entre Claude y GPT-4o.
¿Y si el proyecto mezcla código con matemática pesada o pruebas lógicas? Ahí GPT-5.2 recupera terreno. Saca 100% en AIME 2025 (el primer modelo en lograr un puntaje perfecto en esa prueba de matemática competitiva) y 93,2% en GPQA Diamond, que evalúa física, química y biología a nivel de posgrado. En ARC-AGI-2, que mide razonamiento sobre problemas nunca vistos, GPT-5.2 Pro saca 54,2% contra 37,6% de Claude, una diferencia de 16,6 puntos que importa si tu trabajo pasa por lógica abstracta y no solo por escribir funciones.
Dicho esto: si tu día a día es refactorizar código real, trabajar con terminal y mantener agentes de código corriendo por horas, Claude Opus 4.5 se lleva la ventaja.
¿Qué IA conviene para escribir y analizar documentos largos?
Para documentos muy extensos, GPT-5.2 tiene ventaja estructural: su ventana de contexto es de 400.000 tokens contra 200.000 de Claude Opus 4.5, y su output máximo llega a 128.000 tokens frente a los aproximadamente 64.000 de Claude, según llm-stats.
En la práctica, eso cambia qué entra entero en una sola consulta. Un informe de 500K tokens (varias presentaciones de balance, por ejemplo) entra en GPT-5.2 y no entra en Claude sin trocearlo. Un caso legal completo de 300K tokens, lo mismo. Pero una novela de 80K palabras (unos 100K tokens) entra en los dos sin problema.
El tema es que Claude no se queda ahí. Tiene una herramienta de memoria (todavía en beta) que le permite guardar y recuperar información más allá de la ventana de contexto inmediata, que interactúa con una carpeta local del usuario. Eso sirve para mantener el estado de un proyecto entre sesiones distintas, algo que un contexto grande por sí solo no resuelve. Suma también la edición de contexto, que limpia llamadas a herramientas viejas cuando la conversación se acerca al límite de tokens, dejando lo relevante. En cómo se compara Claude frente a GPT-5 profundizamos sobre esto.
La diferencia de fondo: GPT-5.2 te da contexto implícito, todo queda en la ventana. Claude te obliga a decidir qué persiste y qué no. Para redacción de textos largos con tono matizado y seguimiento fino de instrucciones complejas, muchos equipos siguen prefiriendo Claude. Para analizar un PDF de 300 páginas de una sola pasada, GPT-5.2 gana por capacidad bruta.
¿Qué IA tiene mejores funciones multimedia?
ChatGPT tiene un ecosistema multimodal más amplio que el de Claude. Claude, en cambio, se mantiene enfocado en texto, análisis de documentos y una función de “computer use” que le permite operar un escritorio de forma autónoma, con 66,3% de precisión en el benchmark OSWorld, para tareas agentivas.
¿Esto significa que Claude está atrasado en multimedia? No exactamente: es una decisión de producto. Anthropic apuesta a que el valor está en agentes que leen transcripciones de reuniones, extraen pendientes y los postean en Slack o Google Calendar, como muestra el propio sitio de Anthropic con un ejemplo de un agente que sigue reuniones toda la semana y avisa a los responsables dos días antes del próximo sync si algo quedó sin resolver.
Si tu flujo de trabajo necesita funciones multimedia integradas dentro del mismo chat, ChatGPT te va a resultar más cómodo. Si lo que necesitás es un agente que opere software, archivos y herramientas de oficina de forma autónoma, Claude tiene mejores piezas para armar eso.
¿Qué IA es más rápida, Claude o ChatGPT?
Depende de qué mires. Según Artificial Analysis, GPT-5.2 (Xhigh) genera 79 tokens por segundo contra 49 de Claude Opus 4.5 (Reasoning), pero Claude tiene menor tiempo hasta el primer token: 16,84 segundos contra 120,39 segundos de GPT-5.2 en esa configuración puntual.
Ojo que acá las fuentes no coinciden del todo, y vale la pena explicarlo en vez de ignorarlo. llm-stats reporta otros números: 187 tokens por segundo para GPT-5.2 contra 49 de Claude, con un tiempo al primer token de 12 segundos para GPT y de 2 a 4 segundos para Claude en condiciones típicas. La diferencia entre ambas mediciones probablemente viene de qué variante exacta se testeó (Xhigh no es lo mismo que Thinking ni que Instant) y de cuánto “pensó” el modelo antes de responder en cada prueba.
La lección práctica: cuando compares velocidad entre modelos, preguntate siempre qué variante y qué nivel de razonamiento estaban activos. Un benchmark que compara GPT-5.2 en modo Pro contra Claude en esfuerzo bajo no te dice nada útil sobre tu caso de uso real. Complementá con nuestro análisis de Claude contra Gemini.
En velocidad bruta de generación de texto, GPT-5.2 gana casi siempre. En latencia de arranque con razonamiento activado, Claude suele sentirse más ágil en el uso cotidiano.
¿Cuánto cuesta Claude y cuánto cuesta ChatGPT en 2026?
Por API, GPT-5.2 es más barato en los dos sentidos: USD 1,75 por millón de tokens de entrada y USD 14,00 por millón de salida, contra USD 5,00 y USD 25,00 de Claude Opus 4.5, según el desglose de llm-stats. Eso es 65% más barato en entrada y 44% más barato en salida.
| Concepto | GPT-5.2 | Claude Opus 4.5 |
|---|---|---|
| Lanzamiento | 11 dic. 2025 | 24 nov. 2025 |
| Ventana de contexto | 400.000 tokens | 200.000 tokens |
| Output máximo | 128.000 tokens | ~64.000 tokens |
| Precio input (por 1M) | USD 1,75 | USD 5,00 |
| Precio output (por 1M) | USD 14,00 | USD 25,00 |
| Cache hit (por 1M) | USD 0,175 | USD 0,50 |
| SWE-bench Verified | 80,0% | 80,9% |
| ARC-AGI-1 (Pro) | 90,5% | ~65% |
| AIME 2025 | 100% | ~94% |
Ahora bien, no todo se mide en precio por token. Hay un costo escondido en GPT-5.2: los tokens de razonamiento en modo Thinking o Pro se facturan como tokens de salida. Una tarea compleja puede mostrar 1.000 tokens de output visibles pero consumir 5.000 o más contando el razonamiento interno. En un caso de razonamiento pesado en modo Pro, llm-stats calcula que GPT-5.2 puede terminar costando entre USD 2 y 5 (o más) contra alrededor de USD 1,50 de Claude, justo lo contrario del patrón general.
Para uso personal, ambos ofrecen planes de suscripción mensuales con un costo fijo independiente del consumo por token. Ahí la diferencia de precio entre ambos se achica: lo que cambia es qué podés hacer con cada uno dentro de ese plan.
¿Cuándo conviene elegir Claude y cuándo ChatGPT?
¿Cuándo elegir Claude?
- Código complejo de largo alcance: si trabajás con repositorios grandes, terminal y refactors profundos, el margen de Claude en SWE-bench y Terminal-Bench se nota.
- Agentes que corren por días: la Memory Tool y la edición de contexto están pensadas justo para eso, no para una consulta suelta.
- Documentos con tono matizado: si necesitás que el modelo mantenga instrucciones complejas de estilo a lo largo de un texto largo, Claude suele seguir mejor la consigna.
- Multi-cloud: Claude está disponible vía API propia, AWS Bedrock y Google Vertex AI, lo que facilita integrarlo en infraestructura ya existente.
¿Cuándo elegir ChatGPT?
- Razonamiento matemático o abstracto: si tu trabajo pasa por pruebas lógicas, matemática avanzada o problemas de patrones nuevos, GPT-5.2 tiene ventaja clara en ARC-AGI y AIME.
- Documentos enormes de una sola pasada: con 400K tokens de contexto, entran expedientes legales completos o varios reportes financieros sin trocear.
- Funciones multimedia integradas: si necesitás funciones multimedia dentro del mismo chat, ChatGPT ofrece más opciones nativas.
- Volumen alto con presupuesto ajustado: para integraciones de API con mucho tráfico, el precio por token más bajo de GPT-5.2 pesa en la factura mensual.
¿Qué significa esto para empresas que operan en Latinoamérica?
Anthropic ya tiene un caso de despliegue corporativo grande: su alianza con Accenture para entrenar a 30.000 empleados en el uso de modelos Claude, el mayor despliegue de la empresa hasta ahora según llm-stats, enfocado en integrar agentes de IA en industrias reguladas.
Para un equipo en Argentina o la región, lo primero que hay que resolver no es cuál IA elegir, sino cómo pagarla: ambos servicios facturan en dólares y requieren tarjeta internacional o un proveedor local que intermedie el pago. Eso aplica tanto para los planes consumer de suscripción mensual como para el consumo de API, que se cobra según uso.
Si tu empresa ya corre infraestructura en AWS o Google Cloud, sumar Claude vía Bedrock o Vertex AI simplifica la facturación y el control de acceso porque queda dentro del mismo panel que ya usás. GPT-5.2, en cambio, se integra naturalmente si tu stack ya depende de Azure o de la API directa de OpenAI. Cubrimos ese tema en detalle en la rivalidad entre OpenAI y Anthropic.
¿Qué está confirmado y qué sigue pendiente?
Confirmado: las fechas de lanzamiento (Claude Opus 4.5 el 24 de noviembre de 2025, GPT-5.2 el 11 de diciembre de 2025), las ventanas de contexto, los precios de API y los benchmarks de SWE-bench, Terminal-Bench, ARC-AGI y AIME citados en este artículo, todos con fuente nombrada.
Pendiente: el propio Artificial Analysis marca su Intelligence Index para ambos modelos como “estimado, evaluación independiente por venir”. Eso significa que el ranking de inteligencia general todavía no tiene una medición externa cerrada, más allá de los benchmarks individuales que sí están publicados. Tampoco hay, al momento de esta nota, un modelo de Anthropic más nuevo que Opus 4.5 confirmado oficialmente, así que si viste rumores de una versión posterior, tomalos con pinzas hasta que Anthropic lo anuncie.
Errores comunes al comparar Claude y ChatGPT
- Mezclar precio de plan consumer con precio de API: pagar una suscripción mensual fija en ChatGPT Plus no tiene relación directa con lo que cuesta usar GPT-5.2 por API a USD 1,75 el millón de tokens. Son dos modelos de cobro distintos, y comparar uno contra el otro de la otra empresa te da una conclusión falsa.
- Asumir que más tokens por segundo significa respuesta más rápida siempre: en modo Pro o Thinking, el tiempo que el modelo pasa “razonando” antes de contestar puede pesar más que la velocidad de generación pura. Por eso GPT-5.2 puede tardar 120 segundos en el primer token en una configuración y 12 en otra.
- Comparar benchmarks sin fijarse en la variante testeada: GPT-5.2 Instant, Thinking y Pro rinden distinto. Claude con esfuerzo bajo no es lo mismo que Claude en Maximum. Si la tabla no aclara qué variante usó, el dato sirve poco.
- Pensar que el contexto más grande siempre gana: 400K tokens le ganan a 200K en capacidad bruta, pero Claude compensa con memoria persistente y edición de contexto, que resuelven un problema distinto (sesiones que duran semanas) y no uno que un contexto grande resuelva solo.
Preguntas Frecuentes
¿Qué IA es mejor, Claude o ChatGPT?
No hay un ganador único: Claude Opus 4.5 gana en programación y tareas de agente de largo plazo, GPT-5.2 gana en razonamiento abstracto, matemática y tamaño de contexto. La elección depende de si tu prioridad es código y agentes persistentes (Claude) o razonamiento puro y documentos enormes (GPT-5.2).
¿Cuál es más barato, Claude o ChatGPT?
Por API, GPT-5.2 es más barato: USD 1,75 por millón de tokens de entrada y USD 14,00 de salida, contra USD 5,00 y USD 25,00 de Claude Opus 4.5. En planes consumer, ambos ofrecen una suscripción mensual de costo fijo, así que ahí la diferencia de precio entre ambos se achica.
¿Claude es mejor que ChatGPT para programar?
Sí, con un margen chico pero real: Claude Opus 4.5 saca 80,9% en SWE-bench Verified contra 80,0% de GPT-5.2, y la diferencia se agranda a casi 12 puntos en tareas de terminal (59,3% contra 47,6% en Terminal-Bench 2.0). Para proyectos que mezclan código con matemática o lógica pura, GPT-5.2 recupera terreno.
¿Qué ventana de contexto tiene Claude comparada con ChatGPT?
Claude Opus 4.5 maneja 200.000 tokens de contexto, mientras que GPT-5.2 llega a 400.000 tokens, el doble. En output máximo la diferencia es similar: GPT-5.2 permite hasta 128.000 tokens de salida contra unos 64.000 de Claude.
¿Puedo usar Claude y ChatGPT a la vez?
Sí, no hay ninguna restricción técnica ni contractual que lo impida. Muchos equipos de desarrollo usan Claude para tareas de código y agentes, y ChatGPT para funciones multimedia integradas o análisis de documentos muy extensos, según lo que rinda mejor en cada caso puntual.
Conclusión
La pelea Claude vs ChatGPT 2026 no tiene un ganador absoluto, y cualquiera que te diga lo contrario probablemente no miró los benchmarks con cuidado. Claude Opus 4.5 se lleva programación, agentes de larga duración y tareas donde la memoria persistente importa más que el tamaño de la ventana. GPT-5.2 se lleva razonamiento abstracto, matemática pura, contexto masivo y, en la mayoría de los escenarios de API, el precio.
Si tu trabajo es escribir y mantener código en producción, probá Claude primero. Si necesitás procesar documentos enormes o resolver problemas de lógica que nunca viste antes, arrancá con GPT-5.2. Y si tu presupuesto lo permite, lo más razonable en 2026 es tener acceso a los dos y usar cada uno donde rinde: no hace falta jurarle fidelidad a una sola empresa de IA.