En pocas palabras: En septiembre de 2026 la IA empresarial pasó de piloto a infraestructura de plataforma: agentes como GPT-5.4 Pro y Claude 4.6 Opus ejecutan flujos completos de ventas, salud y legal sin supervisión constante, mientras Anthropic lanzó Claude Opus 5.5 y OpenAI presentó GPT-6 Sol y Luna, ambos a mitad de precio de sus predecesores.
En septiembre de 2026, las empresas dejaron de pilotear IA y empezaron a tratarla como infraestructura de plataforma: agentes autónomos como GPT-5.4 Pro y Claude 4.6 Opus ya ejecutan flujos completos de ventas, salud y legal sin supervisión constante, mientras Anthropic y OpenAI lanzaron modelos más nuevos y más baratos el 22 de septiembre de 2026.
Los agentes de IA para empresas son sistemas que ejecutan tareas de negocio de punta a punta sin que un humano intervenga en cada paso: leen datos, invocan APIs de CRM o ERP, escriben código, lo corrigen y entregan un resultado final. A diferencia de un chatbot, un agente mantiene memoria entre sesiones y coordina sub-agentes especializados para resolver un pedido complejo en minutos.
En este artículo:
- En 30 segundos
- ¿Qué cambió en la IA para empresas en septiembre de 2026?
- ¿Cómo funcionan los agentes autónomos de GPT-5.4 Pro y Claude Opus 4.6?
- ¿Qué resultados muestran salud, legal y retail con IA agéntica?
- ¿Qué límites y riesgos tiene la adopción de IA agéntica en empresas?
- ¿Cómo puede una empresa empezar a implementar estos agentes hoy?
- Errores comunes al implementar agentes de IA en empresas
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, con precio 20% menor y output 30% más rápido que Opus 5, según SiliconANGLE.
- Minutos después, OpenAI presentó GPT-6 Sol y Luna, a mitad de precio de sus predecesores GPT-5.6 con el mismo nombre.
- GPT-5.4 Pro (marzo 2026) puede lanzar hasta 12 agentes en paralelo con un algoritmo de consensus-scoring, según describe el reporte de dev.to.
- Un piloto de salud citado en esa nota reportó 27% menos visitas a urgencias y 15% más precisión diagnóstica usando un agente con memoria de contexto extendida.
- Una cadena de retail de moda sumó +12% en valor promedio de orden y bajó 22% el abandono de carrito con agentes que negocian el costo de envío en tiempo real.
¿Qué cambió en la IA para empresas en septiembre de 2026?
Lo que cambió es el lugar que ocupa la IA en el organigrama técnico. Según el outlook 2026 de Decision Digital citado en el reporte de dev.to, las empresas dejaron de preguntarse si conviene usar IA y ahora preguntan dónde encaja en la arquitectura: data fabric unificado, pipelines de CI/CD con MLflow o Vertex AI, y observabilidad con Prometheus y Grafana.
Si alguna vez armaste un notebook de Jupyter para un proof-of-concept y después lo tuviste que llevar a producción a las apuradas, sabés de qué se trata esta transición. La fuente resume el salto con una tabla que compara la etapa “piloto” con la etapa “plataforma”:
| Dimensión | Etapa piloto (2023-2024) | Etapa plataforma (2025-2026) | Impacto en el negocio |
|---|---|---|---|
| Estrategia de datos | Data lakes ad hoc por modelo | Data fabric empresarial con gobernanza unificada | Datos consistentes, iteración más rápida |
| Despliegue de modelos | Notebooks sueltos, builds manuales de Docker | Pipelines de CI/CD, registros de modelos (MLflow, Vertex AI) | Menos tiempo de reparación, releases reproducibles |
| Operación de IA | Monitoreo manual, alertas ocasionales | Observabilidad con Prometheus, Grafana y alertas guiadas por LLM | Ajuste proactivo de performance, menos caídas |
| Interacción humano-IA | Chatbots y FAQ estáticas | Agentes integrados al flujo de trabajo (Claude 4.6 Opus, GPT-5.4 Pro) | Más productividad, nuevas fuentes de ingreso |
Ojo con esto: la tabla es un resumen editorial de la fuente, no una medición independiente. Sirve como fotografía de tendencia, no como benchmark auditado.
¿Cómo funcionan los agentes autónomos de GPT-5.4 Pro y Claude Opus 4.6?
GPT-5.4 Pro y Claude 4.6 Opus funcionan como orquestadores que reparten una tarea entre sub-agentes especializados y devuelven un resultado consolidado. GPT-5.4 Pro puede lanzar hasta 12 agentes en paralelo con un algoritmo de consensus-scoring, mientras Claude 4.6 Opus mantiene memoria de proyecto completa con una ventana de contexto extendida, según el reporte de dev.to. Te puede servir nuestra cobertura de qué cambia con GPT-5.6 Sol para usuarios Plus.
Acá viene lo bueno: ambos modelos comparten un patrón. Ya no son asistentes que contestan preguntas, son trabajadores que leen y escriben en una base de datos compartida, invocan APIs externas de CRM o ERP, se auto-debuggean y guardan memoria que persiste días, no una sola conversación.
Cómo orquesta tareas Claude 4.6 Opus
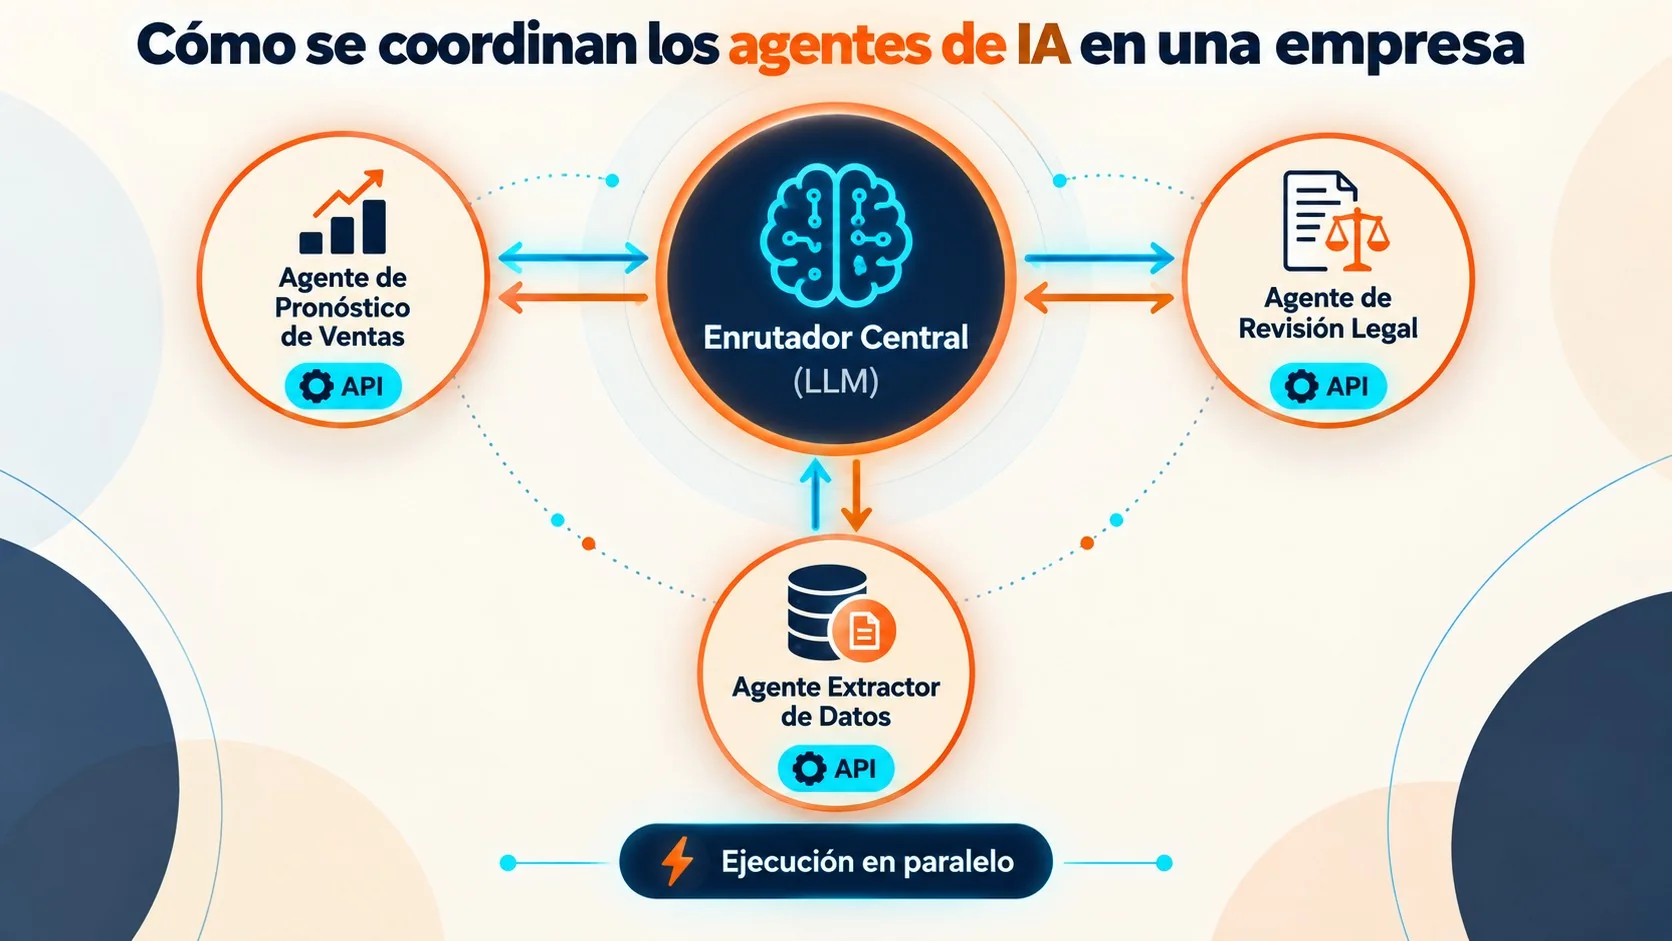
Claude 4.6 Opus divide un pedido en sub-agentes que corren en secuencia o en paralelo según la dependencia entre pasos. Ponele que un equipo de sales-ops pide “generá el forecast trimestral, reconcilialo con lo real del mes pasado y subí la planilla al drive compartido”. Detrás de eso, según describe la fuente, se activan un sub-agente de extracción de datos, uno de forecasting y uno de compliance, y el resultado final se compone en menos de un minuto (spoiler: cuando el flujo funciona bien, ni te enterás de cuántos pasos hubo en el medio).
Eso sí, la cifra que menciona la fuente sobre una “ventana de contexto de 2 billones de parámetros” es técnicamente confusa: el tamaño de contexto se mide en tokens, no en parámetros. Tomalo con pinzas, porque huele más a mezcla de conceptos de marketing que a un dato verificable.
Cómo reparte trabajo GPT-5.4 Pro
GPT-5.4 Pro define cada capacidad como una “tool” y las ejecuta en paralelo cuando el parámetro correspondiente está activado. El patrón que muestra la fuente es reproducible:
- Definís los sub-agentes como tools: por ejemplo sales_forecast, legal_review y data_extractor, cada uno con su propia descripción y esquema de entrada/salida.
- Activás la ejecución en paralelo: el orquestador reparte la consulta entre esas tools al mismo tiempo, en vez de encadenarlas una por una.
- Fusionás los resultados: un algoritmo de consensus-scoring junta las respuestas de cada tool en un solo JSON de salida.
GPT-5.4 llegó oficialmente el 5 de marzo de 2026 en variantes Thinking y Pro, ninguna disponible para usuarios free-tier, y el 17 de marzo se sumaron mini y nano, según confirma la entrada de Wikipedia sobre el modelo. OpenAI reportó una reducción del 33% en errores factuales frente a GPT-5.2, y en el benchmark OSWorld-Verified el modelo sacó 75%, contra 47.3% de GPT-5.2 y 72.4% de una persona promedio.
¿Y esto sigue siendo lo más nuevo? No. Cinco días antes de que se publicara el reporte que estamos analizando, Anthropic y OpenAI ya habían movido el tablero. Esto se conecta con lo que analizamos en nuestra guía de herramientas para desarrolladores.
| Modelo | Lanzamiento | Precio (input / output por millón de tokens) | Benchmark destacado |
|---|---|---|---|
| GPT-5.4 Pro | 5 de marzo de 2026 | No publicado en la fuente | 75% en OSWorld-Verified |
| Claude Opus 5.5 | 22 de septiembre de 2026 | USD 4 / USD 20 | 66.4% en Terminal-Bench 4.0 |
| GPT-6 Sol | 22 de septiembre de 2026 | USD 2 / USD 10 | 68.8% en DeepSWE v1.1 |
| GPT-6 Luna | 22 de septiembre de 2026 | USD 0,10 / USD 0,50 | 66.6% en DeepSWE v1.1 |
Claude Opus 5.5 iguala a Fable 5.1 en la mayoría de tareas y en AutomationBench pasó de 26.9% (Opus 5) a 40%, según el anuncio recogido por SiliconANGLE. Un tester completó una migración de código de 680.000 líneas en menos de un día, trabajo que Anthropic dijo que a un equipo de ingeniería le hubiese tomado semanas. Mario Rodríguez, Chief Product Officer de GitHub, señaló que en VS Code el modelo “resolvió más tareas de terminal que Opus 5 en menos de la mitad de los pasos”.
¿Qué resultados muestran salud, legal y retail con IA agéntica?
Los tres sectores que la fuente destaca con números concretos son salud, legal y retail, y en los tres el patrón se repite: un agente con memoria larga reemplaza varios pasos manuales y el resultado se mide en porcentaje de mejora sobre un piloto puntual, no sobre el mercado completo.
Salud: menos visitas a urgencias
Un piloto en un sistema de salud de Estados Unidos (sin nombre público en la fuente) reportó 27% menos visitas innecesarias a urgencias y 15% más precisión diagnóstica al usar un agente de triage con la memoria de contexto larga de Claude 4.6 para retener el historial longitudinal completo del paciente durante una sola interacción. El stack combina un data lake compatible con FHIR, un sandbox certificado HIPAA y dashboards de Prometheus y Grafana para alertas en tiempo real.
Legal: del contrato al redline en minutos
El flujo que describe la fuente es directo: el cliente sube un contrato en PDF, Claude 4.6 extrae cláusulas y marca los puntos de riesgo, GPT-5.4 Pro sugiere lenguaje alternativo y trae precedentes, y la versión final se manda a DocuSign para firma electrónica. La era del chatbot legal simple ya terminó, según señala Forbes en la nota que cita el reporte.
Retail: más ticket promedio, menos abandono
Una cadena de moda descripta como “líder” en la fuente (sin nombre propio) sumó +12% en valor promedio de orden y +18% en conversión de páginas curadas por IA, con agentes de GPT-5.4 Pro que personalizan combos de producto según historial de navegación, stock y restricciones de envío. El abandono de carrito bajó 22% gracias a la negociación en tiempo real del costo de envío, según ProphecyTech.
¿Qué límites y riesgos tiene la adopción de IA agéntica en empresas?
El riesgo principal no es que el modelo alucine, es que nadie audite lo que el agente hizo con permisos de escritura sobre sistemas críticos. PwC, en sus predicciones de negocio de IA para 2026 citadas en la fuente, plantea que el éxito depende más de la gobernanza que del puntaje bruto del modelo. Ya lo cubrimos antes en el nuevo agente de Copilot integrado con Jira.
La capa de gobernanza que se está armando tiene tres pilares concretos:
- Observabilidad del modelo: herramientas como LangChain Observability o mlflow-observability trackean latencia, uso de tokens y tasa de alucinación por request.
- Procedencia de datos: logs inmutables con Apache Iceberg registran qué porción de datos alimentó al modelo en cada momento, para auditorías en sectores regulados.
- Guardrails éticos: el endpoint de moderación de OpenAI y la API de red-team de Anthropic ya son requisito en pipelines de producción, según la fuente.
Ahora bien, hay algo que conviene separar con cuidado: qué está confirmado por las empresas y qué es proyección de un blog técnico.
Qué está confirmado y qué no
Confirmado: la fecha de lanzamiento de GPT-5.4 (5 de marzo de 2026), sus benchmarks publicados por OpenAI y confirmados por Wikipedia, y el lanzamiento de Claude Opus 5.5 y GPT-6 Sol/Luna el 22 de septiembre de 2026 con precios detallados por Anthropic y OpenAI, según recoge SiliconANGLE.
Pendiente de verificación independiente: las cifras de ROI en salud, legal y retail que cita el reporte de dev.to vienen de pilotos de vendor o notas de prensa sin nombre de empresa ni metodología pública. El estándar ISO/IEC 42001 para un “AI mesh” federado está en borrador, no adoptado. Y la disponibilidad de Claude Sonnet 5.5 y Haiku 5.5, que Anthropic anunció “para las próximas semanas”, todavía no tiene fecha fija.
¿Cómo puede una empresa empezar a implementar estos agentes hoy?
El primer paso es prototipar en chico, no comprar la plataforma completa. La fuente propone un checklist de cinco áreas con puntaje de 0 a 5 y una acción concreta a 30 días: data fabric y gobernanza (implementar un catálogo de datos como Amundsen), registro de modelos y CI/CD (integrar MLflow con GitOps), orquestación agéntica (prototipar un agente que llame a una sola API interna), observabilidad y seguridad (desplegar LangChain-Observability en un endpoint de prueba), y control de costos (alerta de presupuesto al 80% de uso del bundle de tokens).
Para una pyme, la receta más rápida que muestra la fuente usa herramientas no-code: Sobre eso hablamos en cómo GitHub y Anthropic reescriben código a Rust.
- Te sumás a un plan agéntico de Claude: el tier gratuito incluye 1 millón de tokens por mes.
- En Make.com agregás un módulo de Claude Opus: con el prompt “leé el PDF de la factura adjunta, extraé monto total, fecha de vencimiento y proveedor, y creá una fila nueva en Google Sheets”.
- Conectás el módulo a Google Drive y Google Sheets: para subir el PDF y guardar el resultado.
- Probás el flujo: queda un bot de procesamiento de facturas corriendo 24/7 sin que nadie lo mire.
Subís el prototipo, lo probás con datos reales de un proveedor, funciona bien en las primeras diez facturas, lo escalás a todo el departamento de compras y de repente aparece una factura con un formato distinto, el agente extrae mal el monto y nadie se entera hasta que cierra el mes contable: por eso la capa de observabilidad no es un lujo, es lo que evita que ese error llegue a producción sin que nadie lo vea.
Si tu empresa necesita alojar el data fabric o las APIs que consumen estos agentes con foco en cumplimiento de datos en Argentina, Donweb es una opción de hosting y cloud local para evaluar antes de mandar todo a un proveedor internacional sin pensarlo.
Errores comunes al implementar agentes de IA en empresas
- Confundir ventana de contexto con cantidad de parámetros: como en la cifra de “2 billones de parámetros de contexto” que circula sobre Claude 4.6, mezclar ambos conceptos genera expectativas que ningún modelo cumple.
- Tomar el caso de éxito de un vendor como benchmark general: el 27% de reducción de visitas a urgencias o el +12% de AOV en retail vienen de un piloto puntual, no de un estudio con metodología pública. Antes de prometerle ese número a tu directorio, pedí la fuente primaria.
- Comparar modelos que no midieron contra el mismo rival: OpenAI comparó Sol y Luna contra Fable 5.1 y Opus 5, no contra Opus 5.5 lanzado el mismo día. Armar un ranking propio con esos números sin aclarar la base de comparación es un error de lectura, no un dato.
- Dar permisos de escritura a un agente sin logging de procedencia: si el agente puede escribir en el CRM o el ERP sin que quede registro de qué dato usó para decidir, cualquier auditoría posterior se vuelve imposible.
Preguntas Frecuentes
¿Qué es un agente de IA para empresas?
Es un sistema de IA que ejecuta una tarea de negocio completa sin intervención humana en cada paso: lee datos, llama APIs externas, corrige su propio código y entrega un resultado final. Se diferencia de un chatbot en que mantiene memoria entre sesiones y puede coordinar sub-agentes especializados.
¿Cuánto cuesta usar Claude Opus 5.5 o GPT-6 Sol y Luna?
Claude Opus 5.5 cuesta USD 4 por millón de tokens de entrada y USD 20 de salida, un 40% menos que Opus 5 en una carga típica. GPT-6 Sol cuesta USD 2 y USD 10 por millón de tokens, y Luna baja a USD 0,10 y USD 0,50, según los precios publicados el 22 de septiembre de 2026.
¿Qué diferencia hay entre GPT-5.4 Pro y GPT-6 Sol o Luna?
GPT-5.4 Pro es el modelo de marzo de 2026 con orquestación de hasta 12 agentes en paralelo, mientras que Sol y Luna son modelos de septiembre de 2026 construidos sobre los métodos de entrenamiento de GPT-6 Astra, ajustados para costo y apuntados a coding recurrente (Sol) y tareas de alto volumen como resumen y extracción (Luna).
¿Es seguro dejar que un agente de IA opere sin supervisión en mi empresa?
No sin una capa de observabilidad y procedencia de datos. Anthropic reportó que los intentos de evadir los límites de contención en Opus 5.5 bajaron 85% frente a Opus 5, pero eso no reemplaza el logging de qué dato usó el agente para tomar cada decisión dentro de tu empresa.
¿Cómo puede una pyme empezar a usar IA agéntica hoy?
El camino más rápido es un prototipo chico: un plan agéntico gratuito de Claude con 1 millón de tokens mensuales conectado a Make.com para automatizar una sola tarea, como el procesamiento de facturas en PDF hacia Google Sheets, antes de escalar a un flujo con permisos de escritura sobre sistemas críticos.
Conclusión
Septiembre de 2026 dejó dos cosas claras. Primero, que la IA para empresas ya no se mide en pilotos sueltos sino en infraestructura versionada y gobernada, con GPT-5.4 Pro y Claude 4.6 Opus operando flujos completos de ventas, salud y legal. Segundo, que el ciclo de reemplazo de modelos se acortó tanto que un reporte publicado el 27 de septiembre ya describía como “lo último” a modelos que Anthropic y OpenAI habían superado cinco días antes con Claude Opus 5.5, GPT-6 Sol y GPT-6 Luna.
Para una empresa en Latinoamérica, la conclusión práctica no es correr a adoptar el modelo más nuevo. Es armar la capa de observabilidad y procedencia de datos antes de dar permisos de escritura a cualquier agente, y recién ahí decidir qué modelo conviene según el trabajo real, no según el benchmark que mejor le queda al vendor de turno.