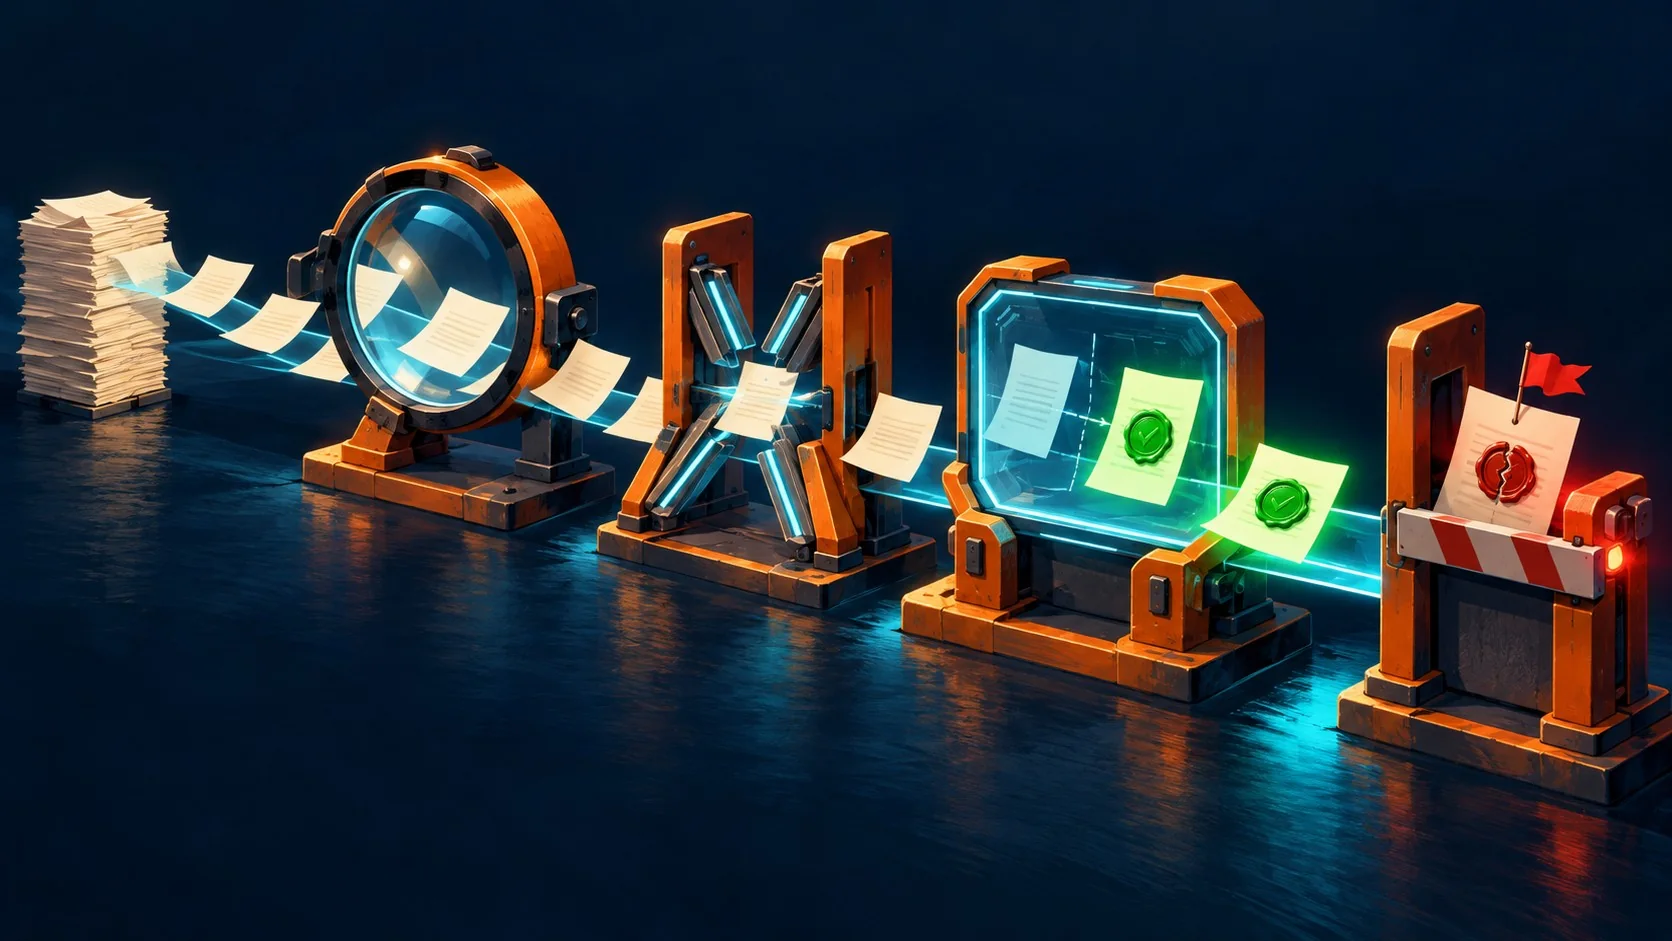
En pocas palabras: Se distinguen con una arquitectura de cuatro filtros —Retrieve, Constrain, Verify y Abstain— que exige citar cada afirmación con su fuente y verificarla antes de responder. Anthropic demostró que la Recuperación Contextual reduce fallas de recuperación hasta un 67% combinada con reranking, bajando la probabilidad de respuestas infundadas.
Armaste un sistema RAG, lo probaste con mil PDFs, respondía con una precisión que daba gusto. Lo escalaste a 15 millones de documentos y nada se rompió, no hay error en los logs, la latencia sigue bien. El problema es que las respuestas ahora están mal más seguido, y no hay forma de saber cuáles. Según un estudio de Stanford citado por Magesh et al. (Journal of Empirical Legal Studies, 2025), herramientas RAG legales comerciales de alta gama alucinaron en el 17-33% de los casos probados.
RAG (Retrieval-Augmented Generation) es una técnica que busca fragmentos de texto relevantes en una base de documentos y los agrega al prompt antes de que un modelo de lenguaje genere la respuesta. Las alucinaciones en RAG aparecen cuando el sistema recupera evidencia equivocada, ignora la correcta que sí tenía, o responde sin evidencia real, con una redacción tan fluida que es imposible distinguirla de una respuesta verdadera. Lo incómodo del asunto es que ninguno de esos tres caminos deja rastro técnico: el sistema sigue “funcionando” en el sentido de que responde rápido y sin tirar error, solo que a veces miente con total tranquilidad.
En este artículo:
- En 30 segundos
- ¿Cómo funciona RAG (Retrieval-Augmented Generation) en la práctica?
- ¿Por qué RAG falla de forma silenciosa cuando el corpus crece a millones de documentos?
- ¿Qué encontró el estudio de Stanford sobre alucinaciones en herramientas RAG legales?
- ¿Cómo redujo Anthropic la tasa de fallos de recuperación con Contextual Retrieval?
- ¿En qué consiste la arquitectura de cuatro “gates” para frenar alucinaciones?
- Ejemplo hipotético: cómo actuarían los cuatro gates ante la misma consulta
- ¿Cuándo conviene montar esta arquitectura y cuándo es gastar pólvora en chimangos?
- ¿Qué límites tiene esta propuesta y qué significa realmente “near-zero hallucination”?
- Qué está confirmado y qué no
- Errores comunes al construir un sistema RAG
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Stanford (Magesh et al., 2025) midió que herramientas RAG legales comerciales alucinan en 17-33% de los casos, incluso en productos pagos diseñados para ser confiables.
- El Contextual Retrieval de Anthropic (septiembre 2024) bajó la tasa de fallo de recuperación top-20 de 5.7% a 1.9%, una reducción del 67% combinando contexto, BM25 y reranking.
- El efecto “lost in the middle” (Liu et al., 2023) muestra que los modelos usan bien la info al principio y al final del contexto, pero ignoran lo que queda en el medio.
- Una arquitectura propuesta por un ingeniero en dev.to plantea cuatro filtros: Retrieve, Constrain, Verify y Abstain, cada uno apuntado a un tipo distinto de falla.
- Contextualizar chunks con Claude cuesta USD 1.02 por millón de tokens de documento, según cifras publicadas por Anthropic.
¿Cómo funciona RAG (Retrieval-Augmented Generation) en la práctica?
RAG parte la base de documentos en fragmentos de unos pocos cientos de tokens, los convierte en vectores con un modelo de embeddings y los guarda en una base vectorial. Cuando llega una consulta, el sistema busca los fragmentos más parecidos semánticamente y los pega al prompt antes de mandárselo al modelo generativo, según describe el anuncio oficial de Anthropic sobre Contextual Retrieval.
El punto débil de esa versión básica es que los embeddings capturan significado pero se pierden con coincidencias exactas. Si un usuario busca “código de error TS-999”, un embedding puede devolver contenido genérico sobre códigos de error y pasar por alto el string exacto. Para eso existe BM25, una función de ranking léxico más vieja que el embedding, que sigue siendo mejor en ese tipo de búsqueda literal. La trampa es pensar que alcanza con elegir “el mejor” de los dos: en la práctica el problema no se resuelve eligiendo, se resuelve combinando.
¿Por qué RAG falla de forma silenciosa cuando el corpus crece a millones de documentos?
RAG falla de forma silenciosa porque la respuesta sigue siendo fluida y convincente aunque esté mal: no hay stack trace, no hay error visible, solo una frase que suena cierta y no lo es. Hay tres caminos de falla que empeoran a medida que crece el corpus. En cómo Anthropic resuelve el problema del chunking profundizamos sobre esto.
El primero es que se recupera evidencia parecida pero equivocada. Con mil documentos puede haber un solo chunk sobre “ingresos del Q2”. Con 15 millones hay cuarenta mil fragmentos que mencionan ingresos, cientos de párrafos casi idénticos y una docena que parecen perfectos pero tienen el número mal.
El segundo es que la evidencia correcta sí está en el contexto, pero el modelo la ignora. A veces responde desde su memoria paramétrica en vez de leer el chunk que tiene delante, o el fragmento correcto queda enterrado en el medio de una ventana de contexto larga. Esto es el efecto “lost in the middle” que documentaron Liu et al. en 2023: los modelos usan bien lo que está al principio y al final del contexto, y se pierden lo del medio. Si metés 50 chunks, la respuesta que está en la posición 26 capaz ni se usa.
El tercero, y el más peligroso, es que no hay evidencia útil y el modelo contesta igual. ¿Qué hace un modelo entrenado para ser útil cuando no tiene con qué responder? Inventa. En un corpus de 15 millones de documentos, hay preguntas legítimas que simplemente no tienen respuesta buena en los datos, y un sistema sin opción de decir “no sé” no tiene otra salida que fabricar algo. Lo que me parece la parte más subestimada de todo esto: casi ningún equipo mide cuántas de sus preguntas entran en esta tercera categoría antes de lanzar el sistema a producción.
¿Qué encontró el estudio de Stanford sobre alucinaciones en herramientas RAG legales?
El RegLab de Stanford testeó herramientas RAG legales comerciales de alta gama, los productos pagos construidos específicamente para ser confiables, y encontró que alucinaban en entre el 17% y el 33% de los casos, según publicaron Magesh y su equipo en el Journal of Empirical Legal Studies (2025). Una de cada tres a una de cada seis respuestas, mal, en un rubro donde una respuesta mal te puede meter en un juicio. Sobre eso hablamos en agentes de IA reescribiendo código en Rust.
Ese número es específico de esos productos legales y de las tareas que les hicieron probar. No es una tasa universal que le va a pasar a cualquier sistema RAG. Lo que sí deja claro es qué tan difícil es este problema: RAG reduce las alucinaciones, no las elimina, y en un corpus de 15 millones de documentos el margen se achica salvo que cambies la arquitectura, no el modelo.
¿Cómo redujo Anthropic la tasa de fallos de recuperación con Contextual Retrieval?
Anthropic redujo la tasa de fallo de recuperación top-20 de 5.7% a 1.9% (una baja del 67%) combinando embeddings contextuales, BM25 contextual y reranking, según los resultados publicados en septiembre de 2024. La técnica consiste en agregarle a cada fragmento, antes de embeberlo, una frase corta generada por un modelo que lo ubica dentro de su documento de origen.
Un chunk que dice “los ingresos crecieron 3% respecto al trimestre anterior” no sirve de nada solo, porque no dice de qué empresa ni de qué trimestre habla. Contextual Retrieval lo convierte en algo como “este fragmento es de la 10-Q de ACME Corp del Q2 2026, en la sección de ingresos por cloud: los ingresos crecieron 3%…”. Ahora tanto el índice vectorial como el índice de palabras clave tienen ese contexto.
| Configuración | Tasa de fallo top-20 | Reducción |
|---|---|---|
| Base (chunks sin contexto) | 5.7% | — |
| + Embeddings contextuales | 3.7% | 35% |
| + BM25 contextual | 2.9% | 49% |
| + Reranking | 1.9% | 67% |
Ojo con esto: esos números son de la mejor configuración de embeddings que probó Anthropic (Gemini Text 004), no un promedio de todos los modelos testeados. Leelo como “los defaults están dejando mucho sobre la mesa”, no como “1.9% garantizado en tu corpus”. El costo de generar los chunks contextualizados con Claude es de USD 1.02 por millón de tokens de documento, usando prompt caching para que no sea prohibitivo.
¿En qué consiste la arquitectura de cuatro “gates” para frenar alucinaciones?
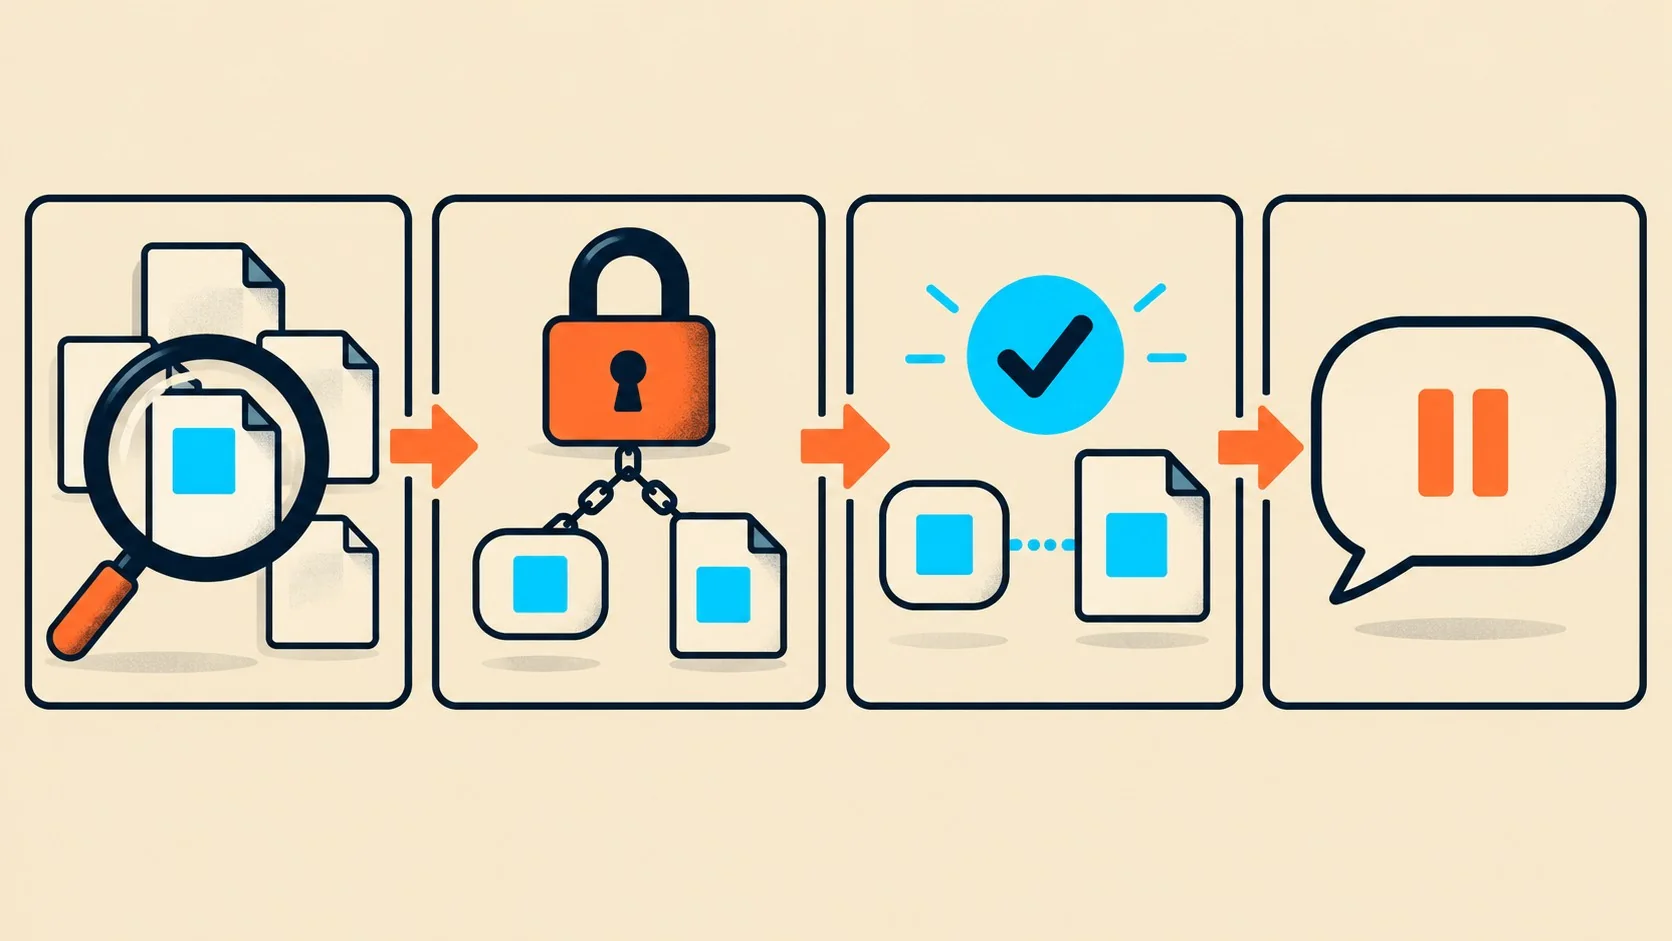
La arquitectura de cuatro gates propone cuatro filtros secuenciales (Retrieve, Constrain, Verify y Abstain), cada uno apuntado a atacar una falla distinta de las tres descritas arriba. La idea central, planteada en el artículo de dev.to que originó este análisis, es que no podés resolver esto con un prompt mejor. “Por favor respondé solo con el contexto dado y no inventes nada” es un deseo, no un control, y falla justo cuando más lo necesitás. Para más detalles técnicos, mirá comparativa entre Claude y Gemini 2.5.
- Retrieve: busca la evidencia correcta y deja probado que está ahí. Incluye deduplicar con MinHash y LSH antes de embeber (para no inflar el índice con boilerplate repetido), chunking con contexto previo, búsqueda híbrida dense + BM25 fusionada con Reciprocal Rank Fusion, y un reranker que vuelve a ordenar unos 150 candidatos sobre-recuperados.
- Constrain: obliga a que cada afirmación cite la evidencia de la que sale. Sin cita, sin oración.
- Verify: chequea de forma independiente que cada cita realmente respalde lo que dice la afirmación. No alcanza con que haya una cita, tiene que sostener el claim.
- Abstain: cuando el soporte es débil, el sistema dice “no pude verificar esto” en vez de adivinar.
Retrieve ataca la falla número uno (evidencia equivocada). Constrain ataca la número dos (evidencia correcta ignorada). Verify y Abstain, juntos, atacan la número tres, la más peligrosa: responder sin evidencia real.
Ejemplo hipotético: cómo actuarían los cuatro gates ante la misma consulta
Nota: lo que sigue es un ejemplo hipotético construido para ilustrar el mecanismo, no un caso real ni una prueba realizada por nadie. Sirve para ver la diferencia entre un pipeline con gates y uno sin ellos, aplicando la lógica descrita en las fuentes citadas arriba.
Imaginemos un corpus interno de políticas de una empresa ficticia, con 15 millones de fragmentos de manuales, contratos y actas. Un empleado pregunta: “¿Cuántos días de licencia por paternidad corresponden en la sucursal de Córdoba?”
Sin gates: el retriever trae un chunk sobre licencias que menciona “Córdoba” de pasada en otro contexto (un acta de una reunión ahí, no una política de licencias) y el modelo, presionado a responder algo útil, combina ese fragmento con conocimiento general sobre licencias en Argentina. La respuesta suena específica y segura. Nadie puede saber, sin ir a buscar el documento original, si el número está bien.
Con el Gate 1 (Retrieve): la búsqueda híbrida (dense + BM25) encuentra tanto el concepto “licencia por paternidad” como el token exacto “Córdoba”, y el reranking prioriza el chunk que efectivamente proviene del convenio colectivo de esa sucursal, no el acta.
Con el Gate 2 (Constrain): la respuesta no puede afirmar un número de días sin citar el fragmento exacto de donde lo sacó. Si el sistema solo encontró un fragmento genérico sobre licencias sin especificar sucursal, no puede escribir la oración con el dato puntual de Córdoba.
Con el Gate 3 (Verify): un paso independiente relee el fragmento citado y confirma que efectivamente dice “Córdoba” y ese número de días, no otra sucursal o un número aproximado.
Con el Gate 4 (Abstain): si en algún punto de la cadena el soporte queda débil (por ejemplo, el convenio de Córdoba no está en el corpus, solo el de Buenos Aires), el sistema responde algo como “no encontré la política específica de Córdoba, encontré la de Buenos Aires: ¿querés que te muestre esa?” en vez de asumir que son iguales.
La diferencia entre los dos escenarios no es de redacción, es de qué pasa cuando no hay dato: uno inventa con total soltura, el otro admite el límite.
¿Cuándo conviene montar esta arquitectura y cuándo es gastar pólvora en chimangos?
No todo sistema RAG necesita las cuatro gates completas. Armar deduplicación con MinHash, contextualizar chunks, correr reranking y agregar un paso de verificación independiente tiene costo de desarrollo, latencia extra y plata en tokens. Tiene sentido pensarlo en función de dos variables, cruzando lo que muestran las fuentes citadas: el tamaño del corpus y el costo de una respuesta mal.
- Corpus chico (debajo de las ~200.000 tokens que menciona Anthropic) y dominio de bajo riesgo: probablemente ni necesitás RAG. Metele todo el contexto directo en el prompt con prompt caching y ahorrate la arquitectura entera.
- Corpus mediano (decenas de miles a un millón de documentos) y dominio de riesgo medio: ahí Contextual Retrieval + reranking (Gate 1) ya rinde la mayor parte de la mejora, según la tabla de Anthropic. Agregar Constrain y Verify completos puede ser más esfuerzo del que el caso de uso justifica.
- Corpus grande (millones de documentos) y dominio de alto riesgo (legal, salud, finanzas, cualquier cosa donde una respuesta mal tenga consecuencia real): ahí es donde el dato de Stanford pesa. Si herramientas pagas y especializadas alucinan 17-33% de las veces, un sistema casero sin Verify ni Abstain va a estar peor, no mejor. En ese escenario, las cuatro gates dejan de ser un lujo de ingeniería y pasan a ser el costo de entrada.
El criterio más simple, si tenés que elegir uno solo: preguntate qué pasa el día que el sistema responde mal con total confianza. Si la respuesta es “un empleado pierde cinco minutos”, no te hace falta Verify. Si la respuesta es “alguien toma una decisión legal, médica o financiera con ese dato”, necesitás como mínimo la opción de abstenerse, aunque no llegues a montar las cuatro capas completas.
¿Qué límites tiene esta propuesta y qué significa realmente “near-zero hallucination”?
“Near-zero hallucination” no significa cero errores: es un objetivo de diseño donde casi ninguna afirmación sin respaldo le llega al usuario, porque el sistema convierte lo que hubiera sido una alucinación en un honesto “no pude verificarlo”. Algunas van a pasar el filtro de todas formas, ningún verificador es perfecto, pero la meta es que sea raro y observable, no que nunca pase.
El autor del artículo original en dev.to lo deja claro: la parte de retrieval y escala a 15 millones de documentos es una arquitectura basada en investigación publicada, no un producto que haya benchmarkeado él mismo a ese tamaño. Cada número de esa sección sale de un paper citado. Lo único que probó personalmente, con un set chico y etiquetado a mano, fue que verificar el soporte de cada claim y permitir que el sistema se abstenga reduce las respuestas confiadas y equivocadas. ¿Es suficiente ese testeo para decir que la arquitectura entera funciona a escala real? No, y el propio autor lo reconoce. Esa honestidad sobre los límites del propio testeo es, en nuestra lectura, lo más valioso del planteo original: es más fácil vender “lo resolví” que admitir “esto es lo que sé con certeza y esto es lo que todavía es hipótesis”.
Qué está confirmado y qué no
- Confirmado: Anthropic publicó en septiembre de 2024 que Contextual Retrieval combinado con reranking reduce el fallo de recuperación top-20 en 67% (de 5.7% a 1.9%).
- Confirmado: Stanford, vía Magesh et al. (2025), midió alucinaciones de entre 17% y 33% en herramientas RAG legales comerciales.
- Confirmado: el efecto “lost in the middle” (Liu et al., 2023) es un fenómeno medido, no una teoría.
- No confirmado / pendiente: que la arquitectura de cuatro gates completa reduzca alucinaciones a niveles “near-zero” en un corpus real de 15 millones de documentos. El propio autor no la probó a esa escala.
- No confirmado / pendiente: qué tan bien generaliza el testeo chico de Verify + Abstain a otros dominios fuera del set etiquetado que usó el autor.
Errores comunes al construir un sistema RAG
- Confiar en que un modelo más grande resuelve el problema. El estudio de Stanford probó productos legales enterprise, construidos específicamente para ser confiables, y siguieron alucinando. El problema es de arquitectura de recuperación, no de tamaño del modelo.
- No deduplicar el corpus antes de embeber. A escala, un mismo disclaimer repetido en 200 mil páginas infla el índice, distorsiona el ranking por frecuencia y hace que la búsqueda devuelva diez copias del mismo chunk en vez de diversidad real.
- Confundir “citar una fuente” con “estar respaldado por esa fuente”. Un modelo puede citar un documento que no dice lo que la respuesta afirma. Sin un paso de Verify independiente, esa cita es decorativa.
- No darle al sistema la opción de abstenerse. Si el sistema siempre tiene que dar una respuesta, va a inventar una cuando no encuentre evidencia. Permitir un “no lo sé” calibrado no es una falla del producto, es la única forma honesta de evitar la mentira segura.
- Montar las cuatro gates sin medir primero si las necesitás. Como se ve en los criterios de decisión de más arriba, para un corpus chico de bajo riesgo esto puede ser complejidad que no se justifica. Agregar capas sin saber qué falla específica atacan es, como dice la fuente original, “cargo-cultear complejidad”.
Preguntas Frecuentes
¿Por qué RAG sigue alucinando aunque tenga muchos documentos?
RAG sigue alucinando porque más documentos significan más fragmentos parecidos que pueden confundir al retriever, más oportunidades de que la evidencia correcta quede enterrada en el medio del contexto, y más preguntas legítimas sin respuesta buena en los datos. Stanford midió esto en herramientas legales comerciales y encontró alucinaciones de 17-33%, un número que muestra que agrandar el corpus no arregla el problema por sí solo. Complementá con cómo se compara Claude frente a GPT-4o.
¿Qué es el Contextual Retrieval de Anthropic?
Contextual Retrieval es una técnica que Anthropic publicó en septiembre de 2024 para agregarle a cada fragmento de texto una frase corta que lo ubica dentro de su documento original, antes de embeberlo y antes de indexarlo con BM25. Combinada con reranking, bajó el fallo de recuperación top-20 de 5.7% a 1.9%, una reducción del 67%.
¿Cómo se puede evitar que una IA invente respuestas en RAG?
Se puede reducir, no eliminar del todo, forzando que cada afirmación cite una fuente específica, verificando de forma independiente que esa fuente realmente respalde lo que dice la afirmación, y permitiendo que el sistema responda “no pude verificar esto” cuando el soporte es débil. Un prompt que pide “no inventes” no alcanza porque falla justo cuando la evidencia es mala o está incompleta.
¿Qué es el efecto lost in the middle en modelos de lenguaje?
Es un fenómeno que documentaron Liu et al. en 2023: los modelos de lenguaje usan bien la información que está al principio y al final de su ventana de contexto, pero tienden a ignorar lo que queda en el medio. Si metés 50 fragmentos en el contexto, el que está en la posición 26 corre riesgo real de no usarse nunca.
¿Cómo verificar que una respuesta generada por IA esté basada en fuentes reales?
Un criterio práctico es chequear, afirmación por afirmación, que el fragmento citado contenga literalmente la información que la respuesta dice que contiene, y no solo un tema relacionado. Esto se puede automatizar con un paso de verificación independiente del modelo que generó la respuesta original, pero también se puede hacer a mano revisando la fuente citada antes de confiar en el dato. Esto es una propuesta de método, no algo probado con datos propios.
¿Toda empresa necesita las cuatro gates completas para usar RAG de forma segura?
No. Depende del tamaño del corpus y de qué tan grave sea una respuesta equivocada. Para un corpus chico de bajo riesgo, meter todo en el contexto con prompt caching puede ser suficiente. Para un corpus grande en un dominio donde un error tiene consecuencias reales (legal, salud, finanzas), el dato de Stanford sobre herramientas comerciales que alucinan 17-33% de las veces sugiere que, como mínimo, conviene sumar la opción de abstenerse antes de confiar ciegamente en el sistema.
Conclusión
Lo que cambia con este análisis no es la tecnología de RAG en sí, sino la forma de pensarla: dejar de tratarla como un problema de mejor prompt o modelo más grande, y empezar a tratarla como un problema de arquitectura con filtros explícitos. Los datos de Anthropic sobre Contextual Retrieval son reales y medibles (67% menos fallos de recuperación), y el estudio de Stanford sobre herramientas legales (17-33% de alucinación) es la prueba de que esto no se resuelve solo. La arquitectura de cuatro gates es una propuesta razonada, no un producto probado a escala de 15 millones de documentos, y esa distinción importa: no es lo mismo “está publicado en un paper” que “lo probé en mi sistema”. Si estás armando o evaluando un sistema RAG, lo accionable es simple y no requiere comprar nada nuevo: medí tu tasa de fallo de recuperación con y sin contexto agregado a los chunks, cruzá eso con cuánto te cuesta realmente una respuesta mal en tu caso de uso (como vimos en los criterios de decisión de arriba), y recién ahí decidí cuántas de las cuatro capas te justifican. En casi todos los escenarios, agregarle al sistema la opción de decir “no sé” es la inversión más barata y con mejor retorno de toda la lista.