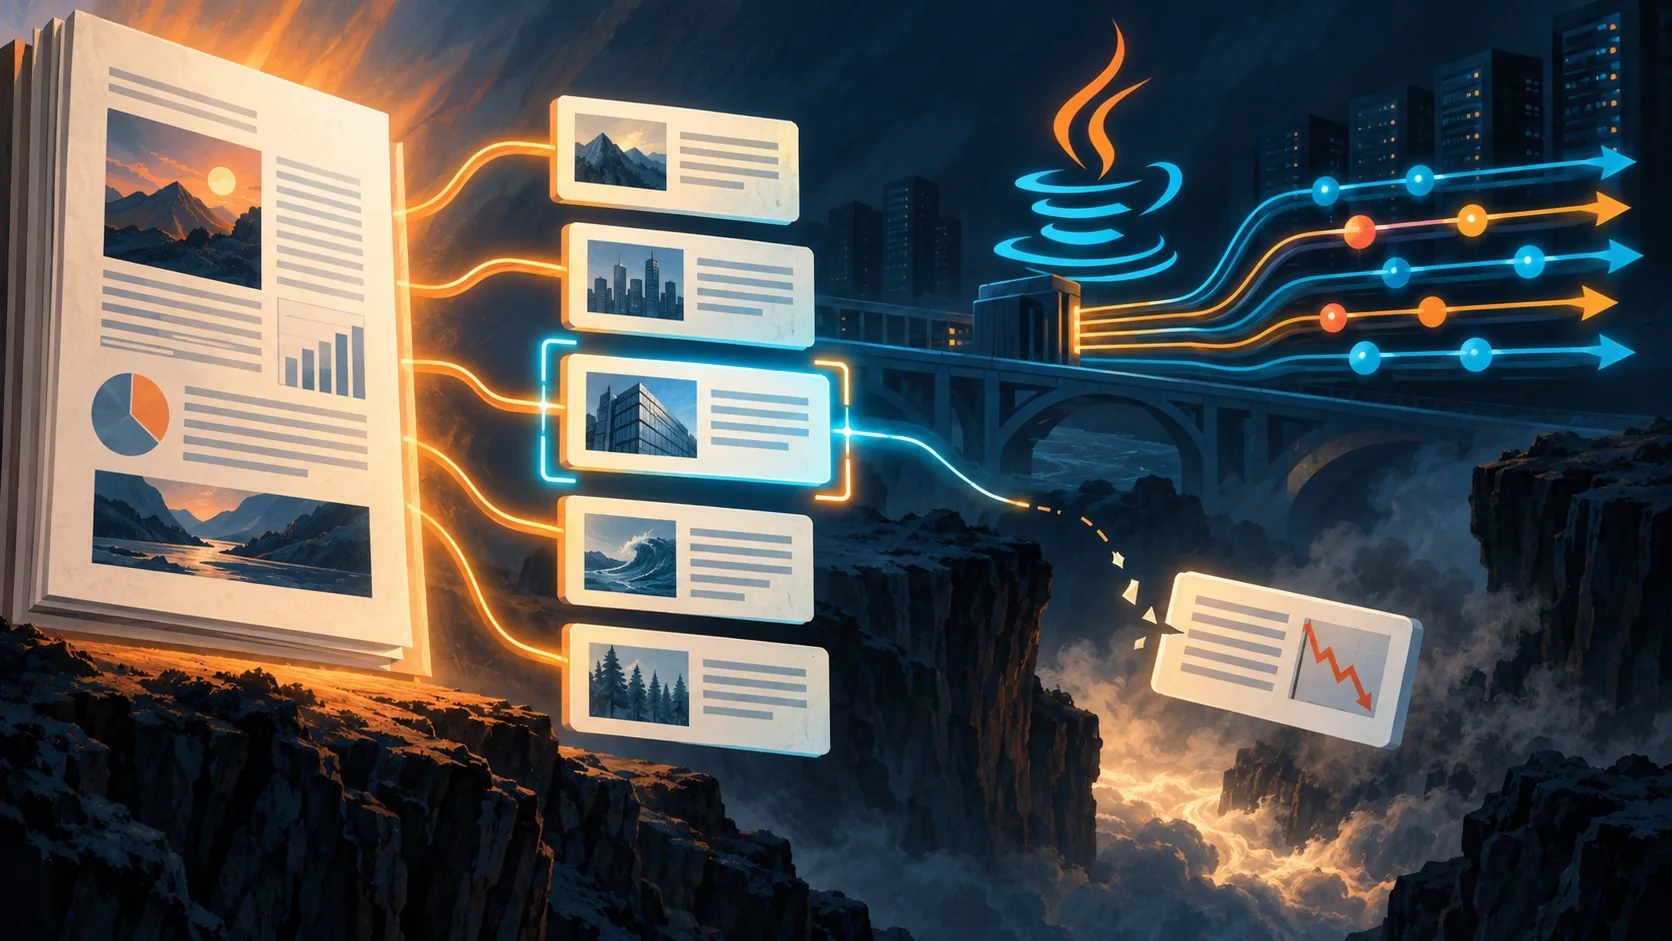
Contextual Retrieval de Anthropic reduce en un 49% las fallas de recuperación en sistemas RAG al combinar embeddings contextuales con BM25, según el paper técnico oficial de Anthropic. Un artículo publicado en dev.to muestra cómo implementarlo en Java con Spring AI y Virtual Threads, usando Claude 3.5 Sonnet y prompt caching para que la ingesta no te cueste una fortuna.
Contextual retrieval RAG es una técnica que antepone un resumen generado por un LLM a cada fragmento de texto antes de indexarlo, tanto en la búsqueda vectorial como en BM25. La desarrolló Anthropic para resolver el problema de los chunks que pierden contexto al dividir documentos largos. La lógica de fondo, si la pensás un segundo, es la misma que aplicás cuando le mandás un mensaje a alguien sin dar contexto: “aprobado” no dice nada si no sabés qué se aprobó. El objetivo es que cada fragmento se entienda solo, sin depender del resto del documento.
En este artículo:
- En 30 segundos
- ¿Por qué el chunking tradicional falla en los sistemas RAG?
- ¿Qué es el Contextual Retrieval de Anthropic?
- Ejemplo hipotético: cómo se vería esto en una base de tickets de soporte
- ¿Cómo funciona el prompt caching para abaratar el enriquecimiento de chunks?
- ¿Qué ventaja aportan los Virtual Threads de Java frente al procesamiento secuencial?
- ¿Cómo se implementa Contextual Retrieval con Spring AI (DocumentTransformer)?
- ¿Qué mejora concreta logra combinar embeddings contextuales con BM25?
- ¿Cuándo conviene implementar Contextual Retrieval (y cuándo no)?
- Errores comunes al implementar contextual retrieval RAG
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Contextual Retrieval reduce el 49% de fallas de recuperación en RAG al combinar embeddings contextuales con BM25 contextual, según Anthropic.
- Con reranking sumado, esa reducción llega al 67%, según el mismo estudio.
- El costo de contextualizar un millón de tokens de documento es de USD 1,02 usando prompt caching.
- Un artículo de dev.to muestra cómo implementarlo en Java con Spring AI, Virtual Threads y Claude 3.5 Sonnet.
- Las queries que buscan códigos exactos (como “Error code TS-999”) las resuelve mejor BM25 que los embeddings semánticos solos.
¿Por qué el chunking tradicional falla en los sistemas RAG?
El chunking tradicional falla porque divide documentos por límites arbitrarios de tokens u overlaps fijos, sin considerar el significado del texto. El resultado son fragmentos huérfanos que no tienen ninguna referencia a de qué documento vienen ni a qué contexto pertenecen.
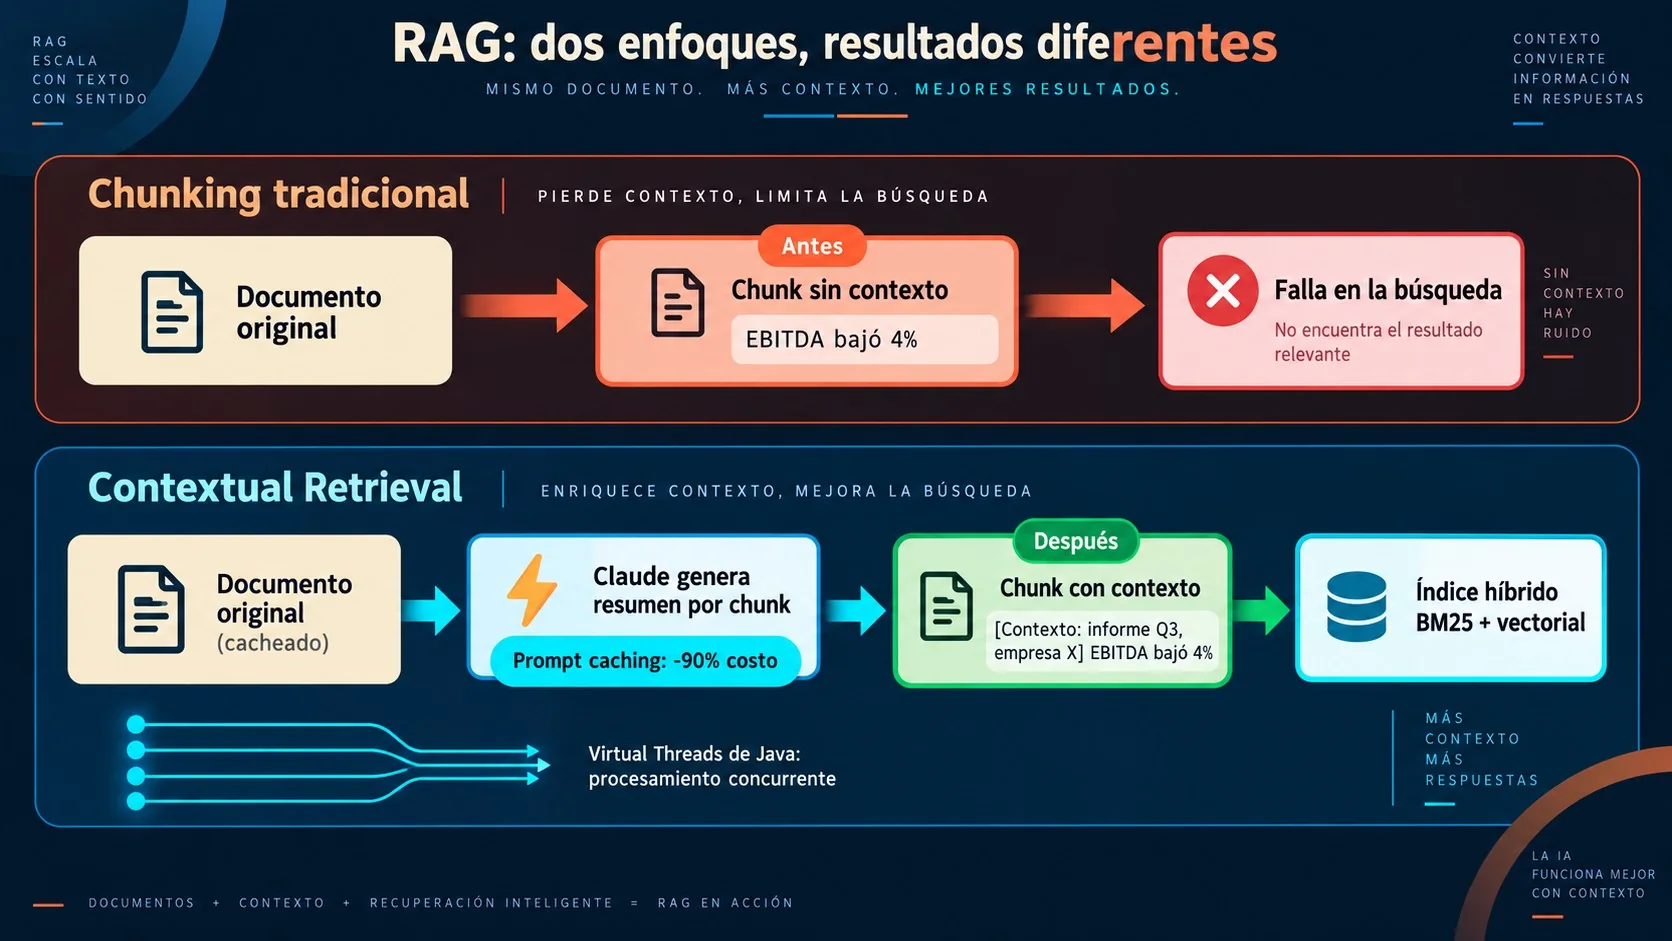
Ponele que tenés una base de filings financieros y tu splitter te devuelve un chunk que dice “EBITDA dropped 4%”. Ese fragmento, tal como lo describe el artículo técnico de dev.to, no tiene metadata que indique de qué empresa se trata ni de qué trimestre fiscal habla. Si alguien pregunta “¿cómo le fue a ACME Corp en el segundo trimestre?”, el sistema de retrieval puede no encontrar ese chunk, o peor, encontrarlo y no saber que corresponde a la pregunta.
Anthropic documenta el mismo problema con un ejemplo casi idéntico en su publicación técnica: un chunk que dice “The company’s revenue grew by 3% over the previous quarter” no sirve de nada si no sabés qué compañía ni qué período. El chunking naive, dice la fuente de dev.to, provoca que más de la mitad de las queries de retrieval en producción pierdan contexto crítico. Es el tipo de bug silencioso que no rompe nada visible, solo te devuelve respuestas mediocres y nadie entiende por qué. Ninguna alarma se dispara, el sistema “funciona”, solo que mal.
¿Qué es el Contextual Retrieval de Anthropic?
Contextual Retrieval es una técnica de preprocesamiento que antepone un resumen generado por LLM a cada chunk antes de embeddearlo y antes de crear el índice BM25, según define Anthropic en su documentación oficial. En vez de indexar el texto crudo, indexás el texto crudo más un párrafo corto que lo sitúa dentro del documento completo.
El formato que propone el artículo de dev.to es directo: [Context: {resumen}]\n\n{texto_original}. Anthropic usa un prompt parecido con Claude 3 Haiku que pide “un contexto breve y sucinto para situar este chunk dentro del documento completo, con el propósito de mejorar la recuperación por búsqueda”. El resultado, según la fuente oficial, suele tener entre 50 y 100 tokens.
Volviendo al ejemplo del filing de ACME Corp: el chunk original “The company’s revenue grew by 3% over the previous quarter” se transforma en algo como “This chunk is from an SEC filing on ACME corp’s performance in Q2 2023; the previous quarter’s revenue was $314 million. The company’s revenue grew by 3% over the previous quarter.” Ahora el chunk se entiende solo, sin depender de nada más. Te puede servir nuestra cobertura de cómo Anthropic reescribió código a Rust.
Ejemplo hipotético: cómo se vería esto en una base de tickets de soporte
Ejemplo hipotético, no basado en datos reales de ningún cliente ni implementación: imaginá una empresa con una base de conocimiento interna de miles de artículos de troubleshooting para su plataforma de facturación. Un splitter naive parte un artículo largo y te deja este chunk suelto: “El error se soluciona reiniciando el servicio en el nodo secundario y limpiando la cola de reintentos.” Sin más contexto, ese texto podría aplicar a cualquiera de las decenas de servicios que tiene la plataforma.
Ahora supongamos que un usuario de soporte busca: “cómo soluciono el error de sincronización con la pasarela de pago”. Un embedding semántico puede acercarse al tema general (“errores”, “sincronización”) pero no tiene garantía de traer justo ese chunk entre miles de fragmentos similares sobre “reiniciar servicios”. Y BM25 solo, por su lado, no tiene ningún término léxico que conecte ese chunk con “pasarela de pago”, porque esas palabras no aparecen en el texto original.
Si ese mismo chunk se contextualiza antes de indexarlo, quedaría algo así: “[Context: Este fragmento pertenece al artículo de troubleshooting del módulo de facturación, en la sección sobre errores de sincronización con la pasarela de pago] El error se soluciona reiniciando el servicio en el nodo secundario y limpiando la cola de reintentos.” Con ese agregado, BM25 ahora tiene el match léxico exacto de “sincronización” y “pasarela de pago”, y el embedding tiene más señal semántica sobre a qué módulo pertenece el fragmento. Es exactamente el mecanismo que describe Anthropic con su ejemplo de ACME Corp, aplicado a un dominio distinto para que se entienda dónde pega el problema en la práctica.
¿Cómo funciona el prompt caching para abaratar el enriquecimiento de chunks?
El prompt caching de Anthropic permite cachear el documento padre una sola vez y reutilizarlo en todas las llamadas de enriquecimiento posteriores, con un descuento de hasta 90% en el costo de esos tokens de entrada. Sin esto, contextualizar miles de chunks contra un LLM sería carísimo.
El artículo de dev.to lo dice sin vueltas: reenviar el documento padre completo en cada llamada de anotación de chunk “quema miles de tokens de entrada y funde tu presupuesto de RAG” (bankrupts your RAG budget, en el original). La solución que propone es cachear el documento padre para que todas las llamadas de enriquecimiento lean ese contexto grande desde caché.
Anthropic publica un número concreto en su paper técnico: asumiendo chunks de 800 tokens, documentos de 8.000 tokens, 50 tokens de instrucciones de contexto y 100 tokens de contexto generado por chunk, el costo único de contextualizar es de USD 1,02 por millón de tokens de documento. No es gratis, pero está lejos de fundir ningún presupuesto.
El caching acá no es un detalle técnico menor, es la pieza que hace viable económicamente correr Contextual Retrieval sobre una base de conocimiento de millones de tokens. Sin caching, la misma idea existe en papel pero nadie la corre en producción.
¿Qué ventaja aportan los Virtual Threads de Java frente al procesamiento secuencial?
Los Virtual Threads permiten lanzar concurrencia masiva de llamadas a un LLM sin la complejidad mental de Reactive Streams, según los key takeaways del artículo de dev.to. Cada chunk se procesa en su propio hilo virtual, no bloqueante, y todos corren en paralelo. Más contexto en comparativa entre Claude y Gemini 2.5.
¿Por qué importa esto? Porque procesar chunks secuencialmente contra un LLM convierte el pipeline de ingesta de documentos en un cuello de botella operativo de varias horas, dice la fuente. Pensá en un documento grande partido en miles de chunks: si cada llamada a Claude tarda uno o dos segundos y las hacés una por una, la ingesta completa se te va a la noche. Con Virtual Threads, las lanzás todas casi al mismo tiempo y esperás a que terminen.
Los Virtual Threads son un tipo de hilo liviano introducido en Java (Project Loom) que no consume un thread del sistema operativo por cada tarea, así que podés crear miles sin agotar recursos. En el código del artículo, Executors.newVirtualThreadPerTaskExecutor() es el que arma ese pool sin límite práctico. Nada de configurar un thread pool con un tamaño fijo y rezar para que alcance.
¿Cómo se implementa Contextual Retrieval con Spring AI (DocumentTransformer)?
Se implementa con una clase que implementa la interfaz DocumentTransformer de Spring AI, fanea las llamadas de enriquecimiento por Virtual Threads y arma cada prompt con el documento padre y el chunk específico. El artículo de dev.to muestra el código completo de esta clase, bautizada ContextualTransformer.
La lógica, resumida, es esta:
- Un ChatModel configurado para Claude 3.5 Sonnet hace de motor de contextualización, invocado una vez por chunk.
- Un executor de Virtual Threads sin límite (
newVirtualThreadPerTaskExecutor()) recibe una tarea por cada chunk del documento. - El prompt envuelve el documento completo en una etiqueta
<document>y el fragmento puntual en<chunk>, pidiendo “situar este chunk dentro del documento padre en 2-3 oraciones concisas”. - Cada future se resuelve con
Future::joiny el texto contextualizado se concatena antes del texto original del chunk.
El detalle que hace funcionar esto sin romper el budget es que el prompt caching queda habilitado sobre el documento padre. Cada llamada individual, aunque manda el documento entero como parte del prompt, lee ese contenido grande desde caché a un 80-90% de descuento, según describe el artículo de dev.to. Sin ese caching, el fan-out por Virtual Threads sería rápido pero carísimo: estarías paralelizando el gasto, no ahorrándolo. Complementá con análisis de Claude frente a GPT-4o.
Después de generar el texto contextualizado, el pipeline formatea el chunk como [Context: {resumen}]\n\n{texto_original} antes de mandarlo al modelo de embeddings y de tokenizarlo para BM25. Ahí es donde entra PgVector: el artículo propone consultar el vector store usando la API de búsqueda híbrida de Spring AI, para capturar tanto similitud semántica como anclas léxicas exactas.
¿Qué mejora concreta logra combinar embeddings contextuales con BM25?
Combinar Contextual Embeddings con Contextual BM25 reduce la tasa de fallas de recuperación en el top-20 de 5,7% a 2,9%, una mejora del 49%, según los experimentos publicados por Anthropic en su artículo técnico. Usando solo Contextual Embeddings, sin BM25, la reducción es del 35% (de 5,7% a 3,7%). Si además sumás un paso de reranking sobre los resultados, la reducción llega al 67%, según el mismo estudio.
Anthropic probó esto en distintos dominios: código, ficción, papers de ArXiv y papers científicos, evaluando la combinación de embeddings con la config de mejor desempeño (Gemini Text 004) recuperando los 20 chunks principales. La mejora se dio en todas las combinaciones de embedding y fuente que evaluaron, no en un caso aislado.
| Método | Tasa de falla top-20 | Reducción vs. baseline |
|---|---|---|
| RAG tradicional (baseline) | 5,7% | — |
| Contextual Embeddings solo | 3,7% | 35% |
| Contextual Embeddings + Contextual BM25 | 2,9% | 49% |
| Contextual Retrieval + Reranking | Menor a 2,9% | 67% |
El punto es que BM25 no es un accesorio decorativo acá. Anthropic pone un ejemplo claro: si un usuario busca “Error code TS-999” en una base de soporte técnico, un modelo de embeddings puede encontrar contenido sobre códigos de error en general, pero fallar en el match exacto. BM25 encuentra ese string específico. La combinación de ambos, con el contexto agregado a cada chunk, es lo que explica el salto del 35% al 49% en la reducción de fallas, y es la misma dinámica que se ve en el ejemplo hipotético de la pasarela de pago más arriba: el embedding aporta el “de qué se trata”, BM25 aporta el “con estas palabras exactas”.
¿Cuándo conviene implementar Contextual Retrieval (y cuándo no)?
Antes de meterte a programar la clase ContextualTransformer, vale la pena chequear si tu caso realmente lo necesita. Algunos criterios para decidir, apoyados en lo que documentan las propias fuentes:
- Tamaño de tu base de conocimiento. Si es menor a 200.000 tokens (unas 500 páginas), Anthropic directamente recomienda meter todo el corpus en el prompt con caching y ahorrarte el RAG. Contextual Retrieval empieza a justificarse recién cuando tu corpus no entra en una ventana de contexto.
- Tipo de queries que recibís. Si tus usuarios buscan identificadores exactos, códigos de error, nombres de producto o cifras puntuales (como en el ejemplo “TS-999”), la parte de BM25 contextual te va a aportar más que si solo usaras embeddings. Si las preguntas son más abiertas y conceptuales, ya con Contextual Embeddings solo capturás buena parte de la mejora (35%).
- Tu stack tecnológico. Si ya trabajás en Java con Spring, el patrón que propone dev.to con Virtual Threads es prácticamente plug-and-play. Si tu pipeline de ingesta está en otro lenguaje, la lógica de fondo (cachear el documento padre, fanear llamadas en paralelo) se traslada igual, pero vas a tener que resolver la concurrencia con las herramientas de tu propio ecosistema.
- Frecuencia de actualización del corpus. El costo de USD 1,02 por millón de tokens es bajo, pero se paga cada vez que reprocesás documentos. Si tu base cambia poco, es un gasto de una sola vez. Si se actualiza todos los días, ese costo (y la latencia de contextualización) se vuelve recurrente y hay que planificarlo.
- Corré tus propios evals. El 49% de mejora que reporta Anthropic es un promedio sobre varios dominios (código, ficción, papers). No hay garantía de que tu corpus específico se comporte igual: la única forma de saberlo es medir recall antes y después con tus propias queries reales.
Errores comunes al implementar contextual retrieval RAG
- Reenviar el documento completo sin cachear. Si mandás el parent document entero en cada llamada de contextualización sin habilitar prompt caching, el costo se multiplica por la cantidad de chunks. Es el error que el artículo de dev.to señala como el que “funde tu presupuesto de RAG”.
- Procesar chunks uno por uno. Sin concurrencia, la ingesta de un documento grande se transforma en un proceso de horas. Acá los Virtual Threads (o cualquier mecanismo de concurrencia equivalente) no son un lujo, son necesarios.
- Confiar solo en embeddings semánticos. Si tu caso de uso tiene queries con identificadores exactos, códigos de error o términos técnicos puntuales, dejar de lado BM25 te va a costar recall. La combinación de ambos es la que da el 49% de mejora, no cada técnica por separado.
- Usar prompts de contextualización genéricos cuando el dominio lo pide. Anthropic aclara que un prompt genérico funciona bien en la mayoría de los casos, pero adaptar el prompt a tu dominio (agregando un glosario de términos, por ejemplo) puede mejorar aún más el resultado.
Preguntas Frecuentes
¿Qué es Contextual Retrieval de Anthropic?
Es una técnica de preprocesamiento en RAG que antepone un resumen generado por LLM a cada chunk antes de indexarlo, tanto para embeddings como para BM25, según define Anthropic en su publicación técnica. Reduce el 49% de fallas de recuperación en el top-20 chunks comparado con RAG tradicional. Sobre eso hablamos en cómo se compara GPT-5 con Claude.
¿Por qué el chunking tradicional falla en RAG?
El chunking tradicional divide documentos por límites arbitrarios de tokens, generando fragmentos que pierden referencia al documento original. Según el artículo de dev.to, esto provoca que más de la mitad de las queries de retrieval en producción pierdan contexto crítico.
¿Cómo funciona el prompt caching de Anthropic?
El prompt caching permite cachear contenido frecuente (como un documento padre) entre llamadas a la API, reduciendo latencia más de 2 veces y costos hasta 90%, según Anthropic. Esto hace viable económicamente contextualizar miles de chunks sin reenviar el documento completo cada vez.
¿Qué son los Virtual Threads en Java?
Los Virtual Threads son hilos livianos de Java que no consumen un thread del sistema operativo por tarea, permitiendo crear miles de forma concurrente. En el contexto de RAG, se usan para lanzar múltiples llamadas a un LLM en paralelo sin la complejidad de Reactive Streams, según el artículo técnico de dev.to.
¿Contextual Retrieval reemplaza a BM25 o a los embeddings?
No, los combina. Contextual Retrieval mejora tanto la búsqueda por embeddings (Contextual Embeddings) como la búsqueda léxica por BM25 (Contextual BM25), y Anthropic reporta que usar ambos juntos da mejor resultado (49% de reducción de fallas) que usar cualquiera por separado (35% con embeddings solos).
Conclusión
Contextual Retrieval no es una idea nueva de 2026, Anthropic la documentó como técnica en su blog de ingeniería, pero la implementación con Spring AI y Virtual Threads que circula en dev.to sí es un aporte concreto para quien trabaja con Java y necesita meter esto en producción sin escribir un pipeline reactivo desde cero.
Si tenés una base de conocimiento chica, menor a 200.000 tokens según el propio criterio de Anthropic, ni siquiera necesitás RAG: metés todo en el prompt con caching y listo. Pero si tu corpus crece, contextualizar cada chunk antes de indexarlo deja de ser un nice-to-have. Lo que hay que evaluar en tu caso puntual, siguiendo los criterios de decisión que repasamos arriba, es si el costo de USD 1,02 por millón de tokens de documento, más la latencia de contextualización, se justifica frente a la mejora de recall que vas a medir con tus propias queries. Nadie más que vos puede correr ese eval.
Si estás armando esta infraestructura y necesitás un servidor donde correr tu vector store o tu pipeline de ingesta, un VPS con recursos dedicados en donweb.com te evita el dolor de cabeza de compartir CPU con otros procesos justo cuando estás faneando cientos de llamadas concurrentes a un LLM.