En pocas palabras: Combinar DeepSeek (deepseek-v4-flash) con Jev (typesafe/jev-1.13) para verificar afirmaciones subió la precisión de 96,6% (un solo modelo) a 98,4% sobre 62 casos reales, con un costo total de USD 0,0018, aunque un caso falso todavía logra pasar el filtro combinado.
Un desarrollador que vende guías en Gumroad sumó un segundo verificador de afirmaciones con IA a su flujo de publicación y probó la combinación contra 62 casos reales. El dato interesante no es tanto el número final (98,4%) sino qué tipo de error comete cada modelo por separado, porque ahí está la razón real para no confiarle esta tarea a un solo verificador.
La verificación de afirmaciones con IA consiste en comparar automáticamente lo que dice una descripción de producto contra el contenido real que describe, para detectar exageraciones o datos inventados antes de que lleguen al público. Acá se usan dos arquitecturas distintas: una que razona en lenguaje natural y otra que devuelve una probabilidad numérica. Esa diferencia de diseño, más que el promedio final, es lo que vale la pena entender si estás pensando en armar algo parecido.
En este artículo:
- En 30 segundos
- ¿Qué problema busca resolver este sistema antes de publicar?
- ¿Cómo se armó el test con 62 casos reales?
- ¿Qué resultados dio cada verificador de IA por separado?
- ¿Por qué combinar DeepSeek con Jev mejora los resultados?
- Ejemplo hipotético: cómo se vería un caso límite en otro rubro
- Criterios para decidir si te conviene combinar dos verificadores
- ¿Qué límites tiene todavía el sistema combinado?
- ¿Cuánto tarda y cuánto cuesta verificar afirmaciones con IA?
- ¿Qué es Jev y cómo funciona un claim checker con IA?
- Errores comunes al armar un sistema de verificación de afirmaciones con IA
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un vendedor de Gumroad probó DeepSeek (deepseek-v4-flash) y Jev (typesafe/jev-1.13) sobre 62 casos reales de descripciones de productos.
- DeepSeek solo: 96,6% de precisión, pero se quedó sin responder 3 veces y dejó pasar 2 afirmaciones falsas.
- Jev solo, con umbral de 0,5: 93,5% de precisión, pero dejó pasar 4 afirmaciones falsas.
- Combinando ambos con una regla simple, la precisión sube a 98,4% con un solo error en 62 casos.
- Jev cuesta USD 0,0018 en total por los 62 chequeos y responde con mediana de 0,31 segundos, contra 20,6 segundos de DeepSeek.
¿Qué problema busca resolver este sistema antes de publicar?
El problema de fondo es simple: si una página de producto dice que la guía cubre X y la guía no cubre X, alguien va a pedir reembolso. El autor de este experimento tiene una tienda en Gumroad y, antes de publicar cualquier descripción de producto o post, la pasa por un chequeo automático que compara el texto de venta contra el contenido real del archivo.
Durante un tiempo ese chequeo fue un solo modelo de lenguaje leyendo la fuente y respondiendo PASS o FAIL. Funcionaba, la mayoría de las veces. Y ahí está el problema: “la mayoría de las veces” no alcanza cuando cada falso positivo es un cliente que se siente estafado. Por eso sumó un segundo verificador, Jev, un clasificador chico disponible en OpenRouter, y corrió los dos contra un set de prueba armado a mano.
¿Cómo se armó el test con 62 casos reales?
El set de prueba tiene 62 casos construidos con archivos reales de productos de Gumroad y posts propios de dev.to: 22 casos con una afirmación verdadera sobre su fuente y 40 con una afirmación que se pasaba de rosca. Las etiquetas correctas salen de cómo se armó cada caso, no de una opinión posterior, así que no hay margen para discutir la respuesta correcta.
Cada caso pasó por los dos verificadores por separado y después se puntuó. DeepSeek recibió la fuente y la afirmación como prompt de chat, con instrucción de responder PASS o FAIL. Jev devuelve algo distinto: una probabilidad de que la afirmación esté respaldada por la fuente, no un veredicto binario. Relacionado: comparando el desempeño de Google frente a Deepseek.
Esa diferencia de diseño —veredicto de texto contra número de confianza— termina siendo la clave de todo el experimento, y también la clave de cómo conviene combinarlos.
¿Qué resultados dio cada verificador de IA por separado?
DeepSeek, usado como chat, acertó en 96,6% de los casos que sí respondió, pero se quedó sin contestar 3 veces. Jev, con el umbral estándar en 0,5, respondió siempre pero con más falsos positivos: 93,5% de precisión. Subiendo el umbral de Jev a 0,9 la precisión sube a 98,4%, aunque a costa de un falso negativo.
| Verificador | TP | FP | TN | FN | Sin respuesta | Precisión | Tiempo medio |
|---|---|---|---|---|---|---|---|
| DeepSeek (chat) | 22 | 2 | 35 | 0 | 3 | 96,6% | 21,5 s |
| Jev, umbral ≥0,5 | 22 | 4 | 36 | 0 | 0 | 93,5% | 0,35 s |
| Jev, umbral ≥0,9 | 21 | 0 | 40 | 1 | 0 | 98,4% | 0,35 s |
| Ambos combinados | 22 | 1 | 39 | 0 | 0 | 98,4% | – |
El dato que más importa acá es el FP (falso positivo): una afirmación falsa que el verificador dejó pasar como buena. Ese es el error que le cuesta plata al vendedor, no la precisión general.
¿Por qué combinar DeepSeek con Jev mejora los resultados?
Cada modelo se equivoca en casos distintos, y esa es toda la explicación. DeepSeek dejó pasar 2 afirmaciones falsas: una era la de una guía de precios de vacaciones familiares que prometía “ahorrar al menos £25”, cifra que no aparece en ningún lado del contenido real. DeepSeek dijo PASS. Jev le puso 0,13, un fail bastante claro.
Del otro lado, Jev con umbral 0,5 dejó pasar 4 afirmaciones falsas. Tres eran resúmenes de producto que exageraban un poco, como decir que una guía cubre “cada contraseña, token y certificado” cuando la fuente nunca menciona tokens ni certificados. DeepSeek falló las tres, y hasta citó textualmente la parte que estaba mal.
Tiene sentido si pensás en cómo está construido cada uno: un clasificador numérico como Jev aprende patrones de similitud semántica, así que una frase que “suena” a lo que dice la fuente puede puntuar alto aunque agregue algo que no está. Un modelo de chat, en cambio, puede leer el temario completo y notar que “tokens” y “certificados” simplemente no figuran en ningún lado. Son dos formas distintas de leer, y por eso fallan en lugares distintos.
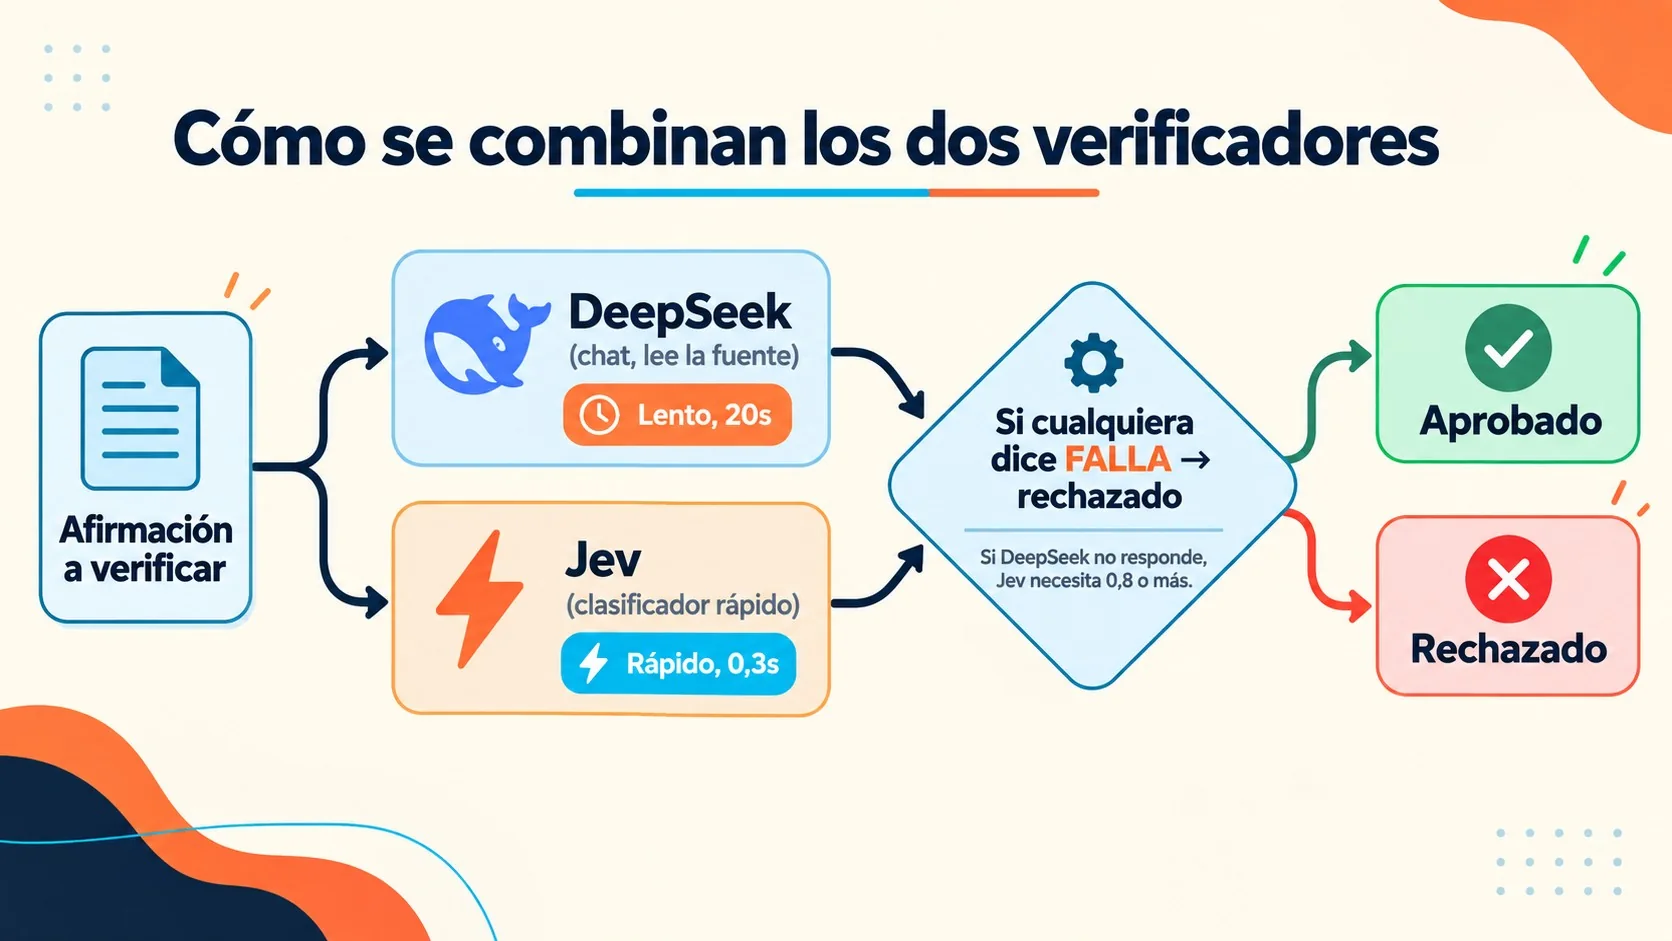
La regla que quedó activa es esta: si cualquiera de los dos dice FAIL, el caso falla. Y si DeepSeek se queda mudo, Jev solo necesita un puntaje de 0,8 o más para pasar. Con esa regla combinada, 61 de los 62 casos quedaron bien clasificados. Complementá con en nuestro análisis entre Openai y Deepseek.
¿Y por qué DeepSeek se quedó callado en tres ocasiones? Porque las tres eran afirmaciones falsas, justamente los casos donde más falta una respuesta clara. Jev, en cambio, falló los tres con puntajes entre 0,02 y 0,13, sin dudar. El silencio del modelo lento coincidió, casualmente o no, con el tipo de caso más difícil de sostener.
Ejemplo hipotético: cómo se vería un caso límite en otro rubro
Nota: lo que sigue es un ejemplo hipotético para ilustrar la lógica del criterio, no un caso real del estudio.
Pensemos en una tienda de cursos online que vende un curso básico de planillas de cálculo. La descripción dice que el curso “te deja preparado para rendir cualquier certificación internacional del rubro”, pero el contenido real cubre solo fórmulas y tablas dinámicas de nivel introductorio. Un modelo de chat que puede leer el temario completo probablemente marque FAIL, porque la certificación internacional no aparece en ningún módulo. Un clasificador numérico como Jev, en cambio, podría quedar en una zona intermedia —ni un 0,1 clarísimo ni un 0,9 seguro— porque la frase usa un vocabulario parecido al del curso sin ser una cifra inventada que dispare una alarma obvia, como sí pasó con el “ahorrá £25” del caso real.
Ese es exactamente el tipo de situación donde, según el criterio que arma el propio autor del experimento, conviene no confiarle la decisión a un solo número: si el clasificador da un puntaje ambiguo, la lectura completa del modelo de chat es la que desempata.
Criterios para decidir si te conviene combinar dos verificadores
Con los datos de este test se pueden sacar algunos criterios prácticos para decidir qué arquitectura usar en un flujo propio, sin necesidad de repetir el experimento entero:
- Si el error caro es el falso positivo (una afirmación falsa que se publica), no alcanza con medir precisión general: hay que mirar específicamente cuántos FP deja cada verificador, como en la tabla de arriba.
- Si necesitás velocidad y volumen y podés tolerar que se cuelen algunas generalizaciones exageradas, un clasificador numérico solo, con umbral alto (0,8-0,9), es una opción razonable y muchísimo más barata.
- Si el contenido tiene cifras concretas (precios, porcentajes, promesas de ahorro), un modelo de chat que lee el texto completo detecta mejor los números inventados que un clasificador de similitud semántica.
- Si un modelo se queda sin responder, tratarlo como aprobación automática es un error: en este test, los tres silencios de DeepSeek eran justamente los tres casos falsos. Conviene exigirle al segundo verificador un umbral más alto en esos casos, no menos.
- Nunca ajustes el umbral mirando el mismo set con el que lo mediste. Si el corte “perfecto” cae justo en el medio de dos casos límite, como el 0,65 de este experimento, lo más probable es que esté sobreajustado a esos 62 casos y no diga nada sobre el próximo.
¿Qué límites tiene todavía el sistema combinado?
Un caso de 62 sigue pasando sin detectarse: la descripción de un post propio del autor que afirma más de lo que el post realmente dice. DeepSeek le dio PASS y Jev le puso 0,63, apenas por encima del umbral de 0,5 que se usa para no fallar. Es un vacío conocido y el autor no lo esconde.
Ahora bien, si movía el umbral de fallo de Jev a 0,65, el score pasaba a 62 de 62. Tentador, sí. Pero 0,65 cae justo en un hueco diminuto entre un caso falso puntuado 0,63 y un caso verdadero puntuado 0,69. Elegir ese número específico es ajustar el modelo a estos 62 casos puntuales, no probar nada sobre el caso 63.
Por eso los umbrales se quedan donde estaban: falla por debajo de 0,5, pasa solo con Jev si llega a 0,8. La idea es revisar de nuevo cuando se acumulen unos 100 chequeos reales de publicaciones en vivo, algo bastante más representativo que un set armado por el propio autor.
¿Cuánto tarda y cuánto cuesta verificar afirmaciones con IA?
Jev cuesta USD 0,0018 en total por los 62 chequeos, no por chequeo individual. Su mediana de respuesta es 0,31 segundos, con el 90% de los casos bajo 0,39 segundos y el más lento en 1,58 segundos. DeepSeek, entre los casos que sí respondió, tuvo mediana de 20,6 segundos, 90% bajo 26,9 segundos y hasta 31,4 segundos en el peor caso. Ya lo cubrimos antes en los costos reales de desplegar DeepSeek-V3.
La diferencia de velocidad no es un detalle menor si pensás en un flujo de publicación con volumen. Subís el archivo, esperás la verificación, revisás si hace falta corregir algo y publicás. Si esa espera son 20 segundos por chequeo en vez de 0,3, la fricción se nota, sobre todo cuando el proceso corre varias veces por cada producto antes de dar el visto bueno final.
¿Qué es Jev y cómo funciona un claim checker con IA?
Jev (typesafe/jev-1.13) es un clasificador chico disponible en OpenRouter diseñado específicamente para evaluar si una afirmación está respaldada por un texto fuente, y devuelve un número de probabilidad en vez de un veredicto de texto. Un claim checker con inteligencia artificial funciona comparando un enunciado contra un documento de referencia y estimando qué tan sostenida está esa afirmación por lo que el documento dice.
La diferencia con un chat genérico como DeepSeek es de diseño: Jev fue entrenado puntualmente para esta tarea, es más liviano, responde con probabilidad continua y no necesita razonar en lenguaje natural para dar un resultado. Eso explica por qué es tan rápido y tan barato, aunque también por qué solo, sin un segundo chequeo de contexto, deja pasar generalizaciones que un modelo de razonamiento sí detecta.
Errores comunes al armar un sistema de verificación de afirmaciones con IA
- Confiar en un solo verificador porque “funciona la mayoría de las veces”. El caso de las £25 de ahorro muestra que un modelo de chat puede aprobar una cifra inventada sin dudarlo. Un segundo verificador con arquitectura distinta atrapa lo que al primero se le escapa.
- Ajustar el umbral para que el set de prueba dé perfecto. Mover el corte a 0,65 para lograr 62 de 62 es sobreajustar a un dataset armado por vos mismo. No prueba nada sobre casos futuros, solo maquilla el resultado actual.
- Ignorar los “sin respuesta” como si fueran neutros. Cuando DeepSeek se quedó mudo tres veces, las tres eran afirmaciones falsas. Tratar un silencio como aprobación automática es un error caro.
- No medir el costo real por chequeo. Un modelo de chat puede parecer “gratis” hasta que corre miles de veces. Comparar USD 0,0018 contra el costo de DeepSeek en volumen cambia la decisión de arquitectura.
Preguntas Frecuentes
¿Este approach sirve si no vendo en Gumroad ni uso OpenRouter?
La lógica del experimento no depende de esas herramientas puntuales: sirve para cualquier flujo donde un texto de venta o de marketing describa un contenido que existe en algún lado (un curso, un producto físico, un servicio). Lo que hay que replicar es la idea de dos arquitecturas distintas —una que lee en profundidad y otra que puntúa rápido— y una regla de desempate, no el proveedor específico.
¿Qué pasa si solo puedo pagar por un verificador?
Según los números del test, un solo verificador siempre deja pasar algún tipo de error: el chat se cuelga en casos difíciles y el clasificador numérico aprueba generalizaciones exageradas. Si el presupuesto obliga a elegir uno solo, tiene sentido priorizar el que atrapa el error más caro para tu negocio: si te preocupan más las cifras inventadas, un modelo de chat; si te preocupan más las exageraciones vagas y necesitás volumen, un clasificador con umbral alto.
¿Cómo elijo el umbral si armo algo parecido para mi propio contenido?
La fuente da una pista clara: no lo elijas mirando el mismo set con el que lo mediste, porque terminás ajustando el número a coincidencias del dataset y no a un criterio real. Una alternativa más honesta es fijar un umbral conservador de entrada (como el 0,8 de este caso) y revisarlo recién cuando tengas un volumen considerable de casos reales acumulados, no de prueba.
Conclusión
Lo que muestra este experimento con 62 casos es que un solo verificador de afirmaciones con IA, sea un chat que razona o un clasificador numérico, deja pasar un tipo específico de error. Combinar los dos con una regla simple (si uno falla, falla; y si el modelo lento se queda mudo, el rápido necesita un puntaje alto para aprobar) bajó los falsos positivos a uno solo en 62 casos, con un costo total de menos de un centavo de dólar.
Si estás armando un flujo de moderación o verificación de contenido, la lección práctica no es “usá Jev” o “usá DeepSeek”, sino mapear antes dónde falla cada tipo de arquitectura: números inventados versus generalizaciones que suenan razonables. Y ojo con la tentación de ajustar el umbral hasta que el dataset de prueba dé perfecto: eso no te dice nada sobre el próximo caso real que te va a tocar.