
En pocas palabras: No es que Claude olvide: el 17 de septiembre de 2026, Anton Dziatkovskii documentó casos donde negaba charlas que sí estaban archivadas en su historial. La memoria falla en encontrar sesiones ya guardadas, no en almacenarlas.
Anton Dziatkovskii, desarrollador que indexa todas sus sesiones de Claude en un “segundo cerebro” personal, documentó el 17 de septiembre de 2026 en un posteo en dev.to varios casos donde Claude no recuerda conversaciones que él da por discutidas: le decía “esto ya lo hablamos” y el modelo contestaba “no, no lo hicimos”, aunque la charla seguía guardada en su archivo.
La memoria de Claude es una función de Anthropic que guarda una síntesis de conversaciones anteriores para que el asistente mantenga contexto entre sesiones sin que el usuario repita información. Anthropic la lanzó para cuentas pagas Max y Pro en claude.ai. No corre en Claude Code ni en la API: ahí cada llamada empieza sin historial, salvo que el propio desarrollador lo construya aparte.
En este artículo:
- En 30 segundos
- ¿Por qué Claude no recuerda conversaciones que vos creés que sí discutieron?
- ¿Claude tiene memoria entre chats? Así funciona la función oficial de Anthropic
- ¿Qué límites tiene la memoria de Claude Code y la API?
- ¿Qué es clawrush, el proyecto que audita la memoria de Claude?
- ¿Qué hacer si tu propio sistema de memoria con Claude pierde información?
- ¿Qué está confirmado y qué es hipótesis en este caso?
- Errores comunes al pensar que Claude “olvidó” algo
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Anton Dziatkovskii publicó el 17 de septiembre de 2026 un relato sobre casos donde Claude negó conversaciones previas que sí estaban archivadas en su sistema personal.
- El problema no es “olvido”: la sesión existía guardada pero no se reindexó ni se relinkeó, según el diagnóstico del propio autor.
- La memoria nativa de Claude, que Anthropic lanzó para cuentas Max y Pro, guarda una síntesis de charlas anteriores, no la transcripción completa.
- Claude Code y la API de Claude no tienen memoria nativa entre sesiones: cada llamada arranca en blanco.
- Dziatkovskii armó clawrush, un proyecto público en GitHub que audita cuándo Claude dice “no discutimos esto” para mapear fallas de recall.
¿Por qué Claude no recuerda conversaciones que vos creés que sí discutieron?
Claude dice que no discutió algo cuando la información existe pero el sistema que la busca no la encuentra, no porque el modelo la haya borrado. Dziatkovskii lo describe en el longread de clawrush: la conversación sigue en el archivo, simplemente no aparece cuando se la busca. En criollo: el dato está, pero algo en la cadena de indexado no lo conecta con la pregunta nueva.
Ponele que hace un mes le pediste a Claude que te arme una estrategia de precios, y ahora le preguntás si se acuerda de lo que armaron juntos. Si esa sesión vive en un sistema externo que vos mismo montaste (como el “segundo cerebro” de Dziatkovskii) y no se reindexó bien, Claude va a responder que nunca hablaron del tema.
¿Es un bug de Claude? No necesariamente. Puede ser un problema del pipeline que vos armaste para guardar y buscar esas conversaciones, algo que Anthropic ni siquiera controla.
¿Claude tiene memoria entre chats? Así funciona la función oficial de Anthropic
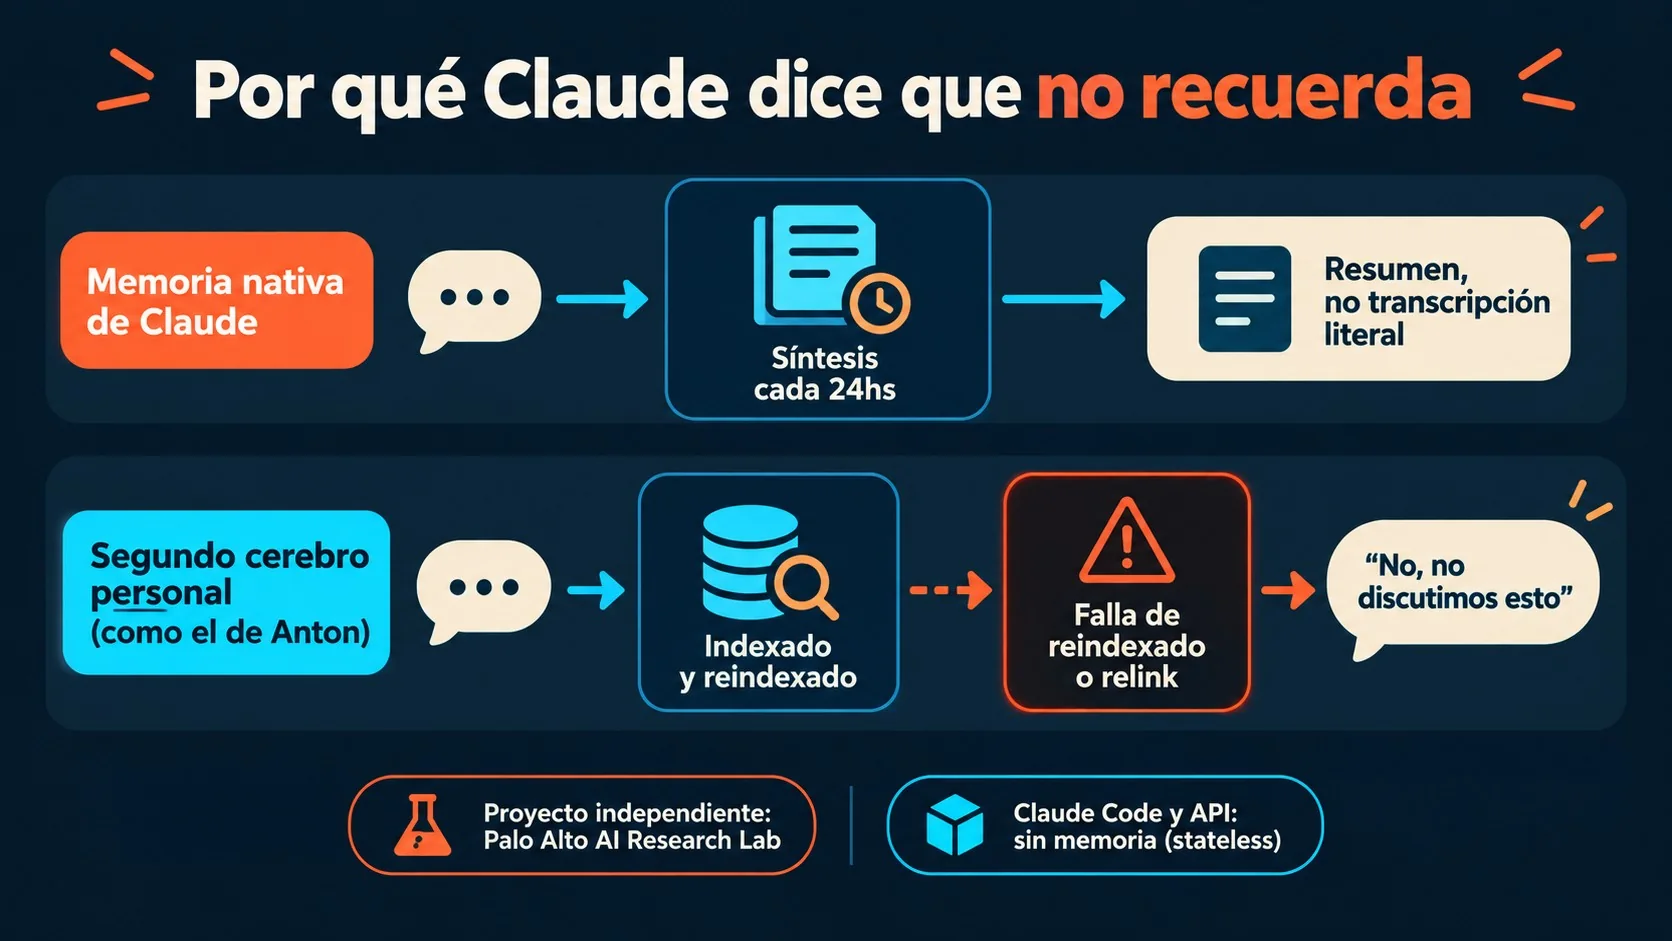
Sí, Claude tiene memoria entre chats para usuarios pagos, pero guarda un resumen editado de tus charlas anteriores, no una copia palabra por palabra. Anthropic la presentó según el reporte de Yahoo Tech y CNET, primero para suscriptores Max y después para Pro. La empresa explicó que la función busca que Claude “aprenda tu contexto profesional y tus patrones de trabajo”, sin conservar cada palabra textual.
- Ver qué recuerda Claude: podés revisar exactamente qué guardó de conversaciones pasadas.
- Activar o desactivar la memoria: es opcional, según indica Anthropic.
- Borrar memorias puntuales: podés eliminar un dato específico sin resetear todo.
- Chat de incógnito: para conversaciones que no querés que queden guardadas.
- Memoria por proyecto: lo que Claude recuerda en un proyecto no se mezcla con otro.
Anthropic también sumó importación y exportación de memorias entre Claude, ChatGPT y Gemini, aunque la propia página de soporte aclara que la función sigue en desarrollo activo y que las memorias importadas podrían no incorporarse a las conversaciones. Ese resumen editado, y no la transcripción cruda, es justo el punto flaco que terminó reportando Dziatkovskii. Sobre eso hablamos en si querés repasar los fundamentos de Claude.
¿Qué límites tiene la memoria de Claude Code y la API?
La memoria de Claude no existe en Claude Code ni en las llamadas a la API: esas dos vías son stateless, cada request arranca sin ningún historial previo. Esto importa porque cualquiera que use Claude Code para un proyecto largo tiene que armar su propio sistema de memoria, ya sean archivos de contexto o una base vectorial, si quiere que el agente recuerde decisiones de sesiones anteriores.
Acá está la clave de todo el caso. El “segundo cerebro” de Dziatkovskii no es la memoria nativa de Anthropic. Es un sistema propio, que él mismo indexa, para guardar sesiones de Claude fuera de cualquier función oficial. Cuando ese sistema casero falla, el problema es de su pipeline, no necesariamente de Anthropic.
Si laburás todos los días con Claude Code, sabés que cada sesión nueva es una hoja en blanco.
¿Qué es clawrush, el proyecto que audita la memoria de Claude?
Clawrush es un proyecto público en GitHub, bajo el nombre github.com/tonydzi/clawrush, donde Dziatkovskii, junto con su “cofundador sintético” llamado Mycroft y bajo el paraguas de Palo Alto AI Research Lab, documenta los problemas reales que encuentra usando agentes de IA. La entrada del 17 de septiembre de 2026, tanto el longread como el devlog en paralelo, plantea auditar cada vez que él le reprocha a Claude “esto lo discutimos” y el modelo contesta que no.
La regla que proponen, traducida del original en inglés, es simple: nunca confiar en un sistema de memoria que no fue auditado contra las propias quejas del usuario. La lógica detrás es que cada “no, no lo hicimos” de Claude funciona como un reporte de bug que el usuario ya escribió solo, en el momento exacto donde falló el recall. Lo explicamos a fondo en a la hora de elegir entre Sonnet y Opus.
Todavía no corrieron el chequeo completo. El propio longread aclara que, a la fecha de publicación, ni la auditoría de recall ni el chequeo del indexador de código se ejecutaron todavía. Es una idea documentada en desarrollo, no una herramienta terminada ni un servicio disponible para terceros.
¿Qué hacer si tu propio sistema de memoria con Claude pierde información?
Si indexás tus propias conversaciones con Claude fuera de la memoria nativa de Anthropic, la responsabilidad de que ese archivo funcione es tuya. El caso de Dziatkovskii sirve de aviso: guardar todo no sirve de nada si el sistema de búsqueda no encuentra lo que guardaste, subís cientos de sesiones, las archivás con cuidado, confiás en que están ahí para siempre y un día el buscador simplemente no las conecta con la pregunta que le hacés.
- Revisá el pipeline de reindexado: confirmá que cada sesión nueva quede vinculada al índice general, no solo guardada como archivo suelto.
- No asumas que la memoria nativa cubre tu caso: si trabajás con Claude Code, la API o herramientas de terceros, esa memoria oficial de Anthropic no aplica.
- Armá tu propia auditoría periódica: buscá en tu historial las veces que dijiste “esto ya lo hablamos” y comprobá si el sistema lo encuentra.
- Guardá metadata, no solo texto: fecha, tema y proyecto ayudan a que el buscador relacione sesiones aunque las palabras exactas cambien.
Ninguna de estas prácticas está confirmada por Anthropic como parte de su producto. Son recomendaciones prácticas para quien arma un sistema propio, como hace Dziatkovskii.
¿Qué está confirmado y qué es hipótesis en este caso?
Está confirmado que Anthropic lanzó memoria para Claude en cuentas Max y después Pro, con controles para ver, activar, desactivar y borrar memorias, según el reporte de Yahoo Tech y CNET. También está documentado que esa memoria guarda un resumen, no un registro literal, y que Claude Code y la API funcionan sin estado entre llamadas. Relacionado: como vimos con las skills de Claude Code.
Lo que no está confirmado por Anthropic es el diagnóstico de Dziatkovskii sobre reindexado y relinkeo: es su hipótesis personal, construida sobre su propio sistema externo, no una declaración oficial sobre fallas del modelo. Tampoco hay cifras públicas de cuántos casos de “no discutimos esto” detectó en total; el posteo original habla de “varios casos”, sin número exacto. Y el chequeo automatizado que promete clawrush, según el propio longread, todavía no se ejecutó ni una vez.
Errores comunes al pensar que Claude “olvidó” algo
- Confundir memoria nativa con un archivo propio: si armaste tu propio indexador, el problema de recall es tuyo, no de la función de memoria de Anthropic.
- Esperar que Claude Code o la API recuerden algo sin pasárselo de nuevo: son stateless, hay que reinyectar contexto en cada sesión.
- Asumir que memoria significa transcripción completa: es una síntesis editada, así que una pregunta muy puntual sobre un detalle menor puede fallar.
- Pensar que borrar memoria en claude.ai borra tu sistema externo: son bases distintas, cada una con su propia lógica de indexado.
Preguntas Frecuentes
¿Por qué Claude dice que no discutimos algo que sí hablamos antes?
Porque la información existe pero el sistema que la busca no la encontró, no porque el modelo la haya borrado a propósito. Esto pasa sobre todo cuando el usuario guarda las conversaciones en un sistema propio, como el “segundo cerebro” de Anton Dziatkovskii, y ese sistema no reindexó bien la sesión. Cobertura relacionada: un caso similar de límites en la memoria de Claude.
¿Cómo funciona la memoria de Claude en 2026?
La memoria de Claude, disponible para cuentas Max y Pro, guarda un resumen de conversaciones anteriores para dar contexto sin que repitas información, según el anuncio de Anthropic recogido por Yahoo Tech y CNET. Podés ver qué recordó, desactivarla, borrar memorias puntuales o usar un chat de incógnito.
¿La memoria de Claude guarda las conversaciones completas o un resumen?
Guarda un resumen, no la transcripción literal palabra por palabra. Por eso, si le pedís a Claude que recuerde un detalle muy específico de una charla vieja, puede devolverte algo vago o directamente no encontrarlo. Esto se conecta con lo que analizamos en en integraciones como la de Make.com.
¿Claude Code o la API de Claude tienen memoria entre sesiones?
No. Tanto Claude Code como la API son stateless: cada sesión o request arranca sin historial previo, salvo que el propio desarrollador construya un sistema externo para guardar y reinyectar contexto.
¿Cómo puedo auditar qué recuerda Claude sobre mis conversaciones?
Podés revisar en la configuración de claude.ai qué memorias guardó el sistema oficial, o replicar el enfoque de Dziatkovskii con clawrush: buscar en tu propio historial cada vez que dijiste “esto ya lo hablamos” y comprobar si el sistema lo encuentra o no.
Conclusión
El caso de Dziatkovskii no prueba que Claude tenga un problema de memoria a nivel modelo. Prueba algo más específico y, para cualquiera que use IA para trabajo real, más útil: que guardar conversaciones no alcanza si el sistema de búsqueda detrás no está auditado. La memoria oficial de Anthropic resuelve una parte del problema (el resumen entre chats en claude.ai) pero no cubre Claude Code ni la API, que son justamente donde más gente arma flujos de trabajo largos.
Si vos indexás tus propias sesiones de Claude, el criterio práctico es simple: no confíes en que “está guardado” significa “se puede encontrar”. Probalo. Buscá vos mismo los momentos donde le dijiste a Claude “esto ya lo hablamos” y fijate si el sistema responde bien. Eso es, en el fondo, lo único nuevo que aporta clawrush: convertir tu propio enojo en un test, todavía sin terminar de ejecutar.