En pocas palabras: Cloudflare lanzó el 1 de octubre de 2026 los modelos Clef y Clef-flash, open source bajo licencia Apache 2.0, que lideran el Jev Decision Index: clasifican dominios en 2.2 segundos frente a los 4.7s de gpt-oss-120b, con latencia mediana de 209.3ms contra 524.1ms de Jev.
Cloudflare lanzó Clef y Clef-flash, dos modelos de decisión open source que compiten de lleno con Jev de Typesafe AI. Clef lidera el Jev Decision Index, clasifica dominios en 2.2 segundos (contra 4.7s de gpt-oss-120b) y Cloudflare lo liberó en Hugging Face bajo licencia Apache 2.0. Lo que a mí me interesa de este lanzamiento no son tanto los números —son benchmarks del propio fabricante, hay que leerlos con esa salvedad siempre presente— sino la categoría que confirma: decisiones estructuradas separadas de la generación de texto, como pieza independiente de un workflow agéntico.
Clef modelo de decisión es la familia de modelos de IA que Cloudflare presentó el 1 de octubre de 2026 para tomar decisiones estructuradas y acotadas (por ejemplo, clasificar la urgencia de un ticket o qué equipo debe atenderlo) en vez de generar texto libre como hace un LLM tradicional. A diferencia de Jev, Clef tiene codificador de visión y ventana de contexto de 64k tokens, y corre hosteado en Workers AI.
En este artículo:
- En 30 segundos
- ¿Qué es un modelo de decisión y en qué se diferencia de un LLM?
- ¿Cómo funciona Clef técnicamente?
- ¿Qué resultados muestran los benchmarks de Clef frente a Jev y otros modelos?
- ¿Qué ventajas de latencia ofrece Clef frente a los LLM generales?
- ¿Cómo es la nueva plataforma de fine-tuning con RL de Cloudflare?
- ¿Cómo empezar a usar Clef en Workers AI o Hugging Face?
- ¿Qué todavía no está confirmado sobre Clef?
- Errores comunes al evaluar Clef
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Cloudflare presentó Clef y Clef-flash, según el anuncio oficial del 1 de octubre de 2026, modelos que devuelven decisiones con probabilidades en vez de texto libre.
- Clef lidera el Jev Decision Index y gana en latencia mediana (209.3ms) frente a Jev (524.1ms).
- En Threat Intelligence, Cloudflare clasificó dominios en 2.2s con Clef contra 4.7s de gpt-oss-120b, con más categorías devueltas.
- Los modelos son open source en Hugging Face bajo Apache 2.0 y compatibles con la API de Jev.
- Cloudflare abre un servicio de fine-tuning con RL, hoy vía equipo FDE, con una plataforma self-serve planeada a futuro.
¿Qué es un modelo de decisión y en qué se diferencia de un LLM?
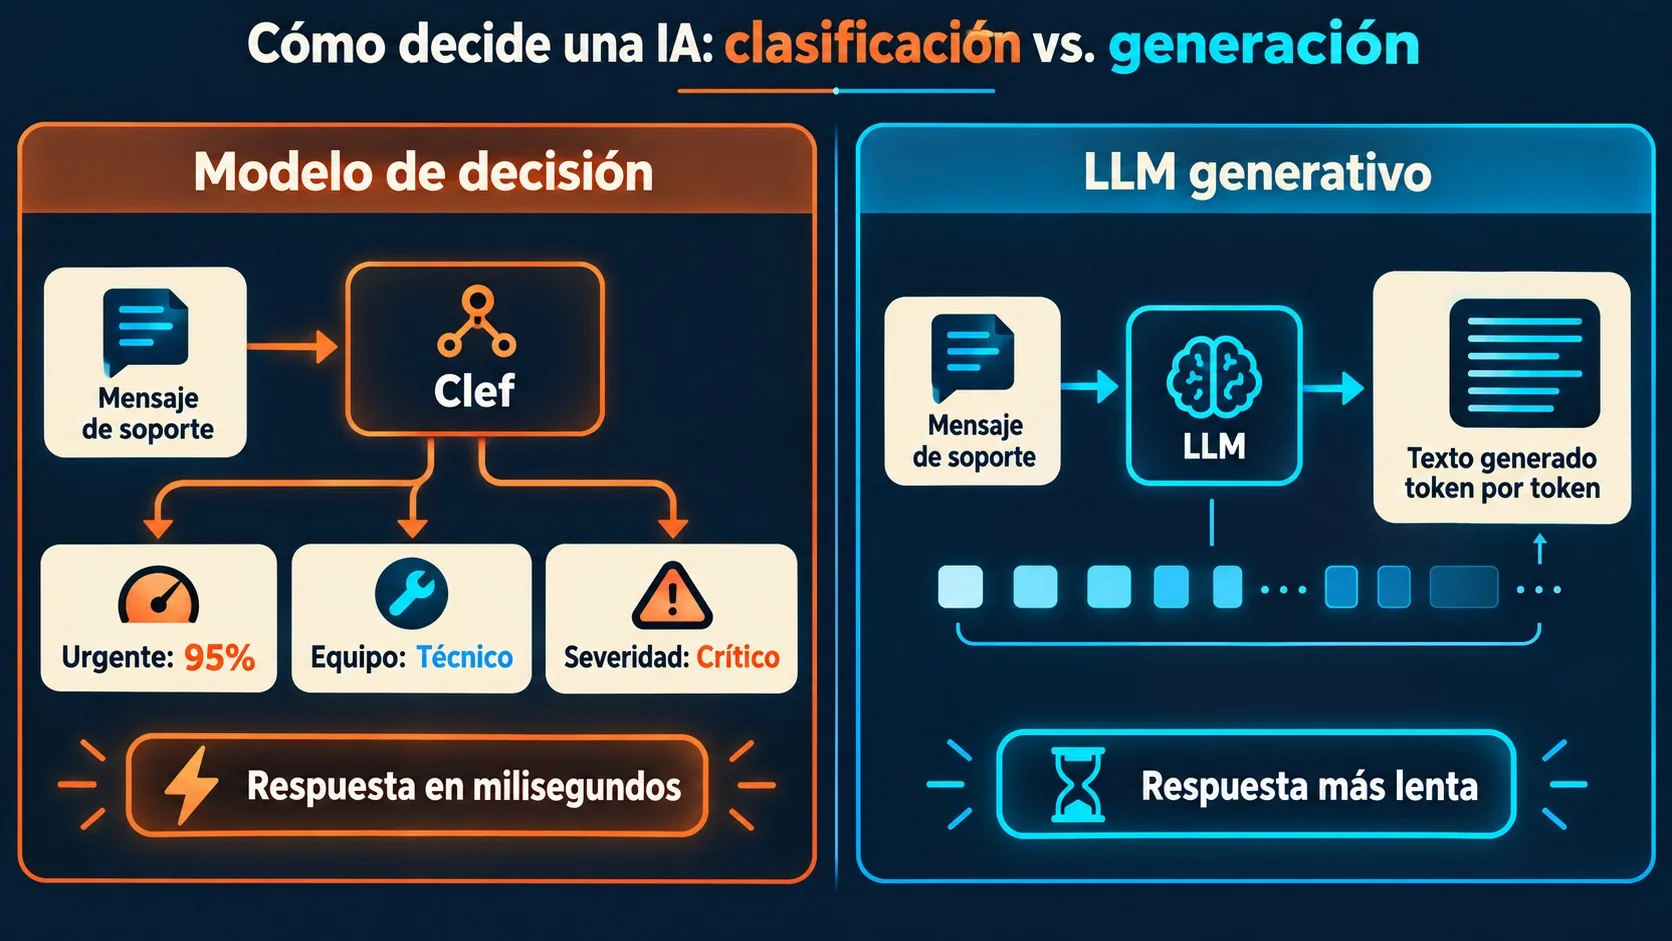
Un modelo de decisión toma inputs (un mensaje, una imagen, el HTML de una web) y devuelve respuestas tipadas con probabilidades, no párrafos de texto. Ponele que le pasás a Clef el ticket de un cliente que dice “el checkout está fallando hace una hora para todos”. El modelo responde con un booleano de urgencia, elige el equipo correcto entre opciones predefinidas y asigna un score de severidad, todo en milisegundos.
Acá está la diferencia real con un LLM, y es la que más importa a la hora de decidir qué usar: un modelo como GPT o Claude es no determinista por diseño. Le pedís lo mismo dos veces y la redacción puede variar, puede sumar texto de más, puede desviarse del formato esperado si el prompt no es lo bastante estricto. Sirve para razonar, escribir y encadenar tool calls en workflows agénticos abiertos, donde justamente querés flexibilidad. Un modelo de decisión, en cambio, trabaja sobre un esquema cerrado de opciones válidas y siempre devuelve el mismo tipo de salida. Los clasificadores ya existían hace años, nada nuevo bajo el sol ahí. Lo que cambió es que Jev, el System One model de Typesafe AI, empezó a empaquetar esta idea como categoría propia hace unas semanas, y Cloudflare entró a competir directo con Clef. Te puede servir nuestra cobertura de cómo funcionan los modelos de razonamiento.
Ejemplo hipotético: cuándo conviene un modelo de decisión y cuándo no
Nota: el siguiente es un ejemplo ilustrativo armado para explicar el concepto, no un caso real reportado por Cloudflare ni por ninguna empresa.
Imaginemos una tienda online que recibe 3.000 mensajes de soporte por día. Hoy un LLM genérico lee cada mensaje y escribe una respuesta completa (texto, tono, posible resolución) antes de decidir a qué equipo lo manda. Eso implica generar de más solo para extraer una clasificación.
Si en cambio se pusiera un modelo de decisión delante, el flujo cambiaría así: primero el modelo de decisión clasifica (urgente/no urgente, equipo, severidad) en milisegundos y sin generar texto; recién después, solo si hace falta responder al cliente, entra un LLM a redactar. La ganancia no es solo de velocidad: es evitar que un modelo “creativo” tenga que inventar una clasificación como subproducto de escribir un párrafo, cuando lo único que necesitás ahí es un número y una etiqueta.
El límite de este enfoque aparece en los casos ambiguos: un ticket que mezcla una queja de facturación con un bug técnico puede caer en una sola categoría del esquema cuando en realidad necesita dos. Ningún benchmark genérico te avisa eso de antemano; solo lo ves corriendo tus propios tickets reales contra el modelo.
¿Cómo funciona Clef técnicamente?
Clef usa Qwen3.8-27B como backbone congelado y Clef-flash usa Qwen3.5-9B, ambos post-entrenados con adapters low-rank de rank 256 en vez de reentrenar el modelo completo. Durante la inferencia hace una única pasada prefill (sin generar texto token por token) y después puntúa en paralelo las opciones válidas del esquema.
El tema es que esto lo hace no autoregresivo: no hay texto intermedio que generar, así que la latencia baja fuerte. Tiene sentido si lo pensás así: un LLM autoregresivo genera palabra por palabra, cada una condicionada a la anterior; un modelo de decisión salta ese paso entero porque no necesita “escribir” nada, solo puntuar opciones que ya existen de antemano. El entrenamiento combina cross-entropy con label smoothing para los esquemas válidos, más una pérdida Brier para calibrar bien las probabilidades (que un 85% signifique de verdad 85%, no un número tirado al azar). Cloudflare sumó además un método propio llamado RLCD, Reinforcement Learning for Calibrated Decisions, que da crédito parcial a elecciones ordinales cercanas, premia los outputs completamente precisos y aplica una penalización de referencia para que el modelo no se desvíe de la distribución original. El origen de todo esto viene de experimentos previos con DiffusionGemma, apoyados en trabajo independiente de Matt Mastracci sobre inferencia en vLLM, aunque Clef terminó usando Qwen como base en vez de DiffusionGemma.
¿Qué resultados muestran los benchmarks de Clef frente a Jev y otros modelos?
En el Jev Decision Index, Clef gana en la mayoría de los benchmarks clave reportados por Cloudflare, con ventajas notables en BANKING77 (94.20 contra 79.74 de Jev) y en clasificación de electrodomésticos, donde Clef-flash llega a 97.73 contra 52.27 de Jev. Ojo con esto: son benchmarks que publicó el propio Cloudflare, no una auditoría independiente. Vale la misma regla que aplicamos a cualquier benchmark de fabricante: sirve para ubicar al modelo en un rango, no para tomar la decisión de migración por vos.
| Benchmark | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev 9B | Laya |
|---|---|---|---|---|---|---|
| BFCL (case exact) | 98.47 | 98.76 | 95.75 | 96.52 | 94.51 | 38.13 |
| ToolRet (nDCG@10) | 69.19 | 66.43 | 65.28 | 61.21 | 64.26 | 12.69 |
| API-Bank (accuracy) | 91.93 | 93.11 | 88.19 | 83.66 | 56.30 | 11.41 |
| Home appliances (case exact) | 82.95 | 97.73 | 52.27 | 42.05 | 25.00 | 0.00 |
| When2Call (accuracy) | 72.37 | 65.58 | 80.97 | 75.44 | 49.62 | 11.94 |
| BANKING77 (macro-F1) | 94.20 | 90.93 | 79.74 | 74.28 | 84.83 | 14.29 |
| CLINC150+OOS (macro-F1) | 97.43 | 66.77 | 89.27 | 83.49 | 79.03 | 3.19 |
| PhishNChips (accuracy) | 79.60 | 75.05 | 62.55 | 85.35 | 50.75 | 50.15 |
¿Y qué pasó cuando corrieron el eval suite propio de Typesafe, el que diseñó el equipo detrás de Jev? Clef ganó en 3 de 4 áreas (invoice processing, customer service y security incidents), pero perdió en agent trace observability, donde Jev sacó 71.6 contra 68.5 de Clef y 69.8 de Clef-flash. No es un barrido total, hay matices, y ese dato en particular —perder justo en el eval ajeno, no en el propio— es el que yo miraría con más atención antes de sacar conclusiones triunfalistas. Lo explicamos a fondo en comparativa entre Claude Sonnet y Opus.
¿Qué ventajas de latencia ofrece Clef frente a los LLM generales?
Clef clasifica un dominio web completo en 2.2 segundos, incluyendo fetch y render de la página, contra 4.7 segundos de gpt-oss-120b en el mismo workflow de Threat Intelligence de Cloudflare. Esa diferencia no es un detalle menor: Clef devolvió varias categorías por dominio (por ejemplo, 95% de probabilidad de ser web de moda, 85% ecommerce, menos de 1% phishing), mientras que el LLM general solo devolvió dos clasificaciones.
Generalizá ese ahorro a cualquier decisión programática dentro de un workflow agéntico y entendés por qué Cloudflare apuesta a meter Clef en el hot path, combinado con un LLM que después ejecuta la acción. La lógica de fondo es simple: cuanto más repetitiva y acotada sea la decisión, menos sentido tiene pagarle a un LLM generalista por ella.
| Métrica | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev-9B | Laya |
|---|---|---|---|---|---|---|
| Latencia mediana (ms) | 209.3 | 38.8 | 524.1 | 84.4 | 51.4 | 5.8 |
| Latencia p95 (ms) | 238.6 | 122.4 | 536.0 | 211.2 | 187.9 | 222.5 |
Laya gana en velocidad pura, pero mirá la tabla de benchmarks de arriba: sacrifica calidad de forma brutal (3.19 en CLINC150+OOS contra 97.43 de Clef). Rápido y malo tampoco sirve.
¿Cómo es la nueva plataforma de fine-tuning con RL de Cloudflare?
Hoy el fine-tuning de Clef funciona como servicio hands-on con el equipo FDE (forward-deployed engineer) de Cloudflare, no como producto self-serve todavía. Internamente, Cloudflare ya lo usa para triage de Trust & Safety, soporte técnico y clasificación de bots buenos o malos, apoyándose en más de 15 años de datos de red etiquetados. Sobre eso hablamos en cómo aislar tu modelo autohospedado.
El plan declarado es construir, a partir de esa experiencia con clientes reales, una plataforma self-serve para capturar datos, entrenar y redesplegar el modelo propio, todo dentro de Cloudflare. Fine-tunear siempre implica un trade-off: ganás precisión en tu dominio específico, perdés algo de performance general. La pregunta que yo me haría antes de pedir ese fine-tuning hands-on es si realmente tenés volumen e historial propio suficiente para justificarlo —sin un dataset etiquetado decente, afinar un modelo puede salir más caro que quedarte con el genérico. Si tu empresa ya corre infraestructura en la nube (sea en Workers AI o en servidores propios vía proveedores como donweb.com), esto importa porque define si te conviene un modelo genérico o uno afinado a tu caso.
¿Cómo empezar a usar Clef en Workers AI o Hugging Face?
Para arrancar hoy, pegás un POST a @cf/cloudflare/clef en la API de Workers AI con tu estado (el texto del ticket) y un esquema de preguntas tipadas. Clef devuelve respuestas de tipo booleano, elección múltiple o score, con probabilidades asociadas a cada una, y es compatible con la API de Jev, así que migrar código existente no debería llevarte más que cambiar el endpoint.
- Vía Workers AI: llamás directo al modelo hosteado con tu Account ID y token de autenticación de Cloudflare.
- Vía Hugging Face: descargás los pesos abiertos bajo licencia Apache 2.0 y corrés Clef o Clef-flash en tu propia infraestructura.
- Vía documentación oficial: Cloudflare publicó guías de desarrollador y un sitio de demo con el benchmark en vivo del Jev Decision Index.
La garantía enterprise que ofrece Cloudflare es que no leen, no guardan ni entrenan con tus requests o responses, salvo que decidas usar el servicio de fine-tuning (ahí sí entregás datos para el entrenamiento específico).
¿Qué todavía no está confirmado sobre Clef?
Lo confirmado hasta acá viene directo del anuncio oficial de Cloudflare: los modelos existen, están hosteados en Workers AI, son open source en Hugging Face y compatibles con la API de Jev. Lo que todavía queda en el aire es otra historia, y conviene separarla bien de lo confirmado antes de tomar cualquier decisión técnica.
- La plataforma self-serve de fine-tuning no está disponible. Hoy solo se accede vía el equipo FDE de Cloudflare, con atención personalizada.
- Los benchmarks son pruebas propias de Cloudflare. No hay auditoría independiente publicada que valide esos números frente a Jev o Laya.
- El eval suite de Typesafe mostró resultados mixtos. Clef ganó en 3 de 4 áreas, pero perdió en agent trace observability frente a Jev.
Mi criterio práctico, antes de migrar un workflow crítico a Clef, sería este: corré tu propio set de casos reales (no el benchmark de nadie) contra Clef y tu modelo actual, en paralelo, durante al menos una semana, y compará tasas de error específicamente en las categorías que a vos te importan —no en el promedio general. Un benchmark genérico no te dice si Clef clasifica bien justo los tickets raros que te rompen el soporte los viernes a la tarde, ni si confunde categorías que para tu negocio son críticas aunque para Cloudflare sean un caso de borde menor.
Errores comunes al evaluar Clef
- Comparar solo por velocidad. Laya es el más rápido de la tabla, pero su calidad en benchmarks como CLINC150+OOS es prácticamente nula. Latencia sin precisión no sirve para nada.
- Asumir que Clef reemplaza al LLM entero. Clef decide, no ejecuta ni redacta. Seguís necesitando un LLM (o lógica propia) para la acción que viene después de la decisión.
- Tomar los benchmarks de Cloudflare como verdad absoluta. Son evaluaciones propias, con sus criterios propios. Habría que ver cómo se comporta Clef con tus datos reales antes de decidir una migración completa.
- Confundir Clef-flash con una versión “liviana” sin trade-offs. Es más rápido, pero en algunos benchmarks (CLINC150+OOS, por ejemplo) pierde bastante precisión frente a Clef.
- Ignorar el resultado del eval ajeno. El propio eval suite de Typesafe le dio la victoria a Jev en agent trace observability. Si tu caso de uso se parece más a ese escenario que a los otros tres, el resultado general no te aplica igual.
Preguntas Frecuentes
¿Qué es Clef de Cloudflare?
Es un modelo de decisión que Cloudflare lanzó el 1 de octubre de 2026: devuelve clasificaciones tipadas con probabilidades en vez de texto libre. Viene en dos tamaños, Clef y Clef-flash, hosteados en Workers AI y disponibles también como pesos abiertos en Hugging Face. En las novedades de GitHub Copilot profundizamos sobre otra pieza de este mismo movimiento hacia modelos especializados.
¿En qué se diferencia un modelo de decisión de un LLM?
Un modelo de decisión devuelve un esquema fijo de opciones con probabilidades asociadas, siempre el mismo tipo de salida para el mismo esquema. Un LLM genera texto abierto y no determinista, pensado para razonar y encadenar tool calls en tareas agénticas sin un esquema cerrado de antemano. En la práctica, uno complementa al otro: no son competidores directos, salvo que estés usando un LLM solo para clasificar, que es justo el caso donde Clef tiene sentido como reemplazo.
¿Cómo funciona el fine-tuning con RL de Clef?
Hoy funciona como servicio hands-on con el equipo de forward-deployed engineers de Cloudflare, que ayuda a afinar Clef con datos propios del cliente. Cloudflare planea después convertirlo en una plataforma self-serve para capturar datos, entrenar y redesplegar el modelo sin intervención manual. Mientras no exista esa versión self-serve, conviene pensarlo como un servicio de consultoría más que como un producto de autogestión.
¿Clef es de código abierto y dónde se descarga?
Sí, Cloudflare liberó Clef y Clef-flash bajo licencia Apache 2.0 en Hugging Face, para correrlos en tu propia infraestructura. También podés usarlos sin instalar nada vía la API de Workers AI con el endpoint @cf/cloudflare/clef.
¿Qué tan rápido es Clef comparado con otros modelos?
Clef tiene una latencia mediana de 209.3ms y Clef-flash de 38.8ms, contra 524.1ms de Jev, según los benchmarks publicados por Cloudflare. En el caso real de clasificación de dominios de Threat Intelligence, Clef tardó 2.2 segundos contra 4.7 segundos de gpt-oss-120b para la misma tarea. Esos números son del fabricante, así que el ejercicio sano es replicarlos con tu propia carga antes de confiar en ellos a ciegas.
Conclusión
Cloudflare entró a la categoría de modelos de decisión con Clef y lo hizo con números que, al menos en sus propios benchmarks, superan a Jev en latencia y en la mayoría de los benchmarks de calidad. La jugada inteligente es la compatibilidad de API: migrar de Jev a Clef no debería requerir reescribir tu código, solo cambiar el endpoint. Lo que todavía falta es la plataforma self-serve de fine-tuning, que hoy depende de un equipo humano de Cloudflare trabajando caso por caso. Si tenés un workflow agéntico con decisiones repetitivas (triage de tickets, clasificación de dominios, moderación de contenido), vale la pena correr tus propios casos contra Clef antes de migrar nada en producción, prestando especial atención a las categorías de borde que el benchmark general no cubre. El benchmark del fabricante es un punto de partida, no la última palabra.