
En pocas palabras: FlashProve, lanzado por Anthropic el 2 de noviembre de 2026, usa pruebas zkSNARK para demostrar criptográficamente que una respuesta salió del modelo exacto solicitado. Con una GPU H100 genera 110 tokens/segundo en Llama 4 Maverick (400B parámetros) y es código abierto bajo licencia Apache 2.0.
Anthropic publicó el 2 de noviembre un sistema llamado FlashProve que usa pruebas criptográficas zkSNARK para demostrar que una respuesta de IA salió del modelo específico que el usuario pidió, y no de uno sustituido por costos o manipulado por un atacante. Con una GPU H100, genera pruebas a 110 tokens/segundo sobre Llama 4 Maverick (400B parámetros).
La inferencia demostrable (provable inference) es una técnica criptográfica que permite a un proveedor de IA comprometerse con un modelo específico y después probar, matemáticamente, que cada respuesta salió de ese modelo exacto. La desarrolló el equipo de investigación de Anthropic y la publicó como código abierto bajo licencia Apache 2.0.
En este artículo:
- En 30 segundos
- ¿Qué problema de confianza busca resolver la inferencia demostrable?
- ¿Qué es FlashProve y cómo funciona el zkSNARK detrás del sistema?
- ¿Qué resultados de rendimiento mostró Anthropic con Llama 4 Maverick?
- ¿Qué limita hoy a la inferencia demostrable y qué falta resolver?
- ¿Para qué casos de uso reales sirve la inferencia demostrable?
- ¿Conviene pensar en esto hoy? Criterios para decidir
- ¿Qué artefactos liberó Anthropic y bajo qué licencia?
- Errores comunes al interpretar la inferencia demostrable
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Anthropic lanzó FlashProve el 2 de noviembre de 2026, un sistema de inferencia demostrable basado en zkSNARK, según el paper técnico de Anthropic.
- Con Llama 4 Maverick (400B parámetros, cuantizado a 4 bits), una sola GPU H100 genera pruebas a ~110 tokens/segundo.
- Cada prueba pesa ~19 MB por cada 1.024 tokens y verificarla toma entre 17 y 21 segundos sin GPU, según detalla Infobae.
- El costo computacional es de 70 a 95 veces el tiempo de GPU que usa vLLM para correr el mismo modelo.
- El sistema solo soporta contextos de hasta 1.024 tokens y exige arquitectura de mixtura de expertos, lejos todavía de una conversación real.
¿Qué problema de confianza busca resolver la inferencia demostrable?
El problema es simple de explicar y bastante incómodo de digerir: hoy, cuando le hablás a un chatbot, no tenés ninguna forma técnica de confirmar que la respuesta vino del modelo que elegiste. Podría venir de uno más barato que un servicio de routing metió por abajo para ahorrar costos, o peor, de un atacante que alteró el stream de tokens mientras se hacía pasar por el modelo original. Y la calidad de la respuesta, sola, no te dice nada: un modelo degradado también puede sonar convincente.
Anthropic va más allá en su propio informe y plantea un escenario todavía más inquietante: a medida que los modelos se vuelven capaces de operar y desplegarse a sí mismos, un sistema más avanzado podría correr en lugar del modelo autorizado y presentarse como la versión más débil, justamente para evitar los clasificadores de seguridad que aplicarían sobre él. Juzgar solo por la calidad de la respuesta no alcanza para detectar nada de esto.
Ejemplo hipotético (a modo ilustrativo, no es un caso real reportado): imaginemos una empresa de software que contrata un modelo frontera para revisar su código antes de un lanzamiento, y paga por el modelo “premium” bajo la promesa de que es el que mejor detecta vulnerabilidades. Si el proveedor (o un intermediario de routing) redirige esa consulta a una versión más barata para ahorrar cómputo en horas pico, hoy esa empresa no tiene cómo enterarse: el informe sale igual, con buena redacción, y nadie avisa que cambió el motor. Con un esquema de inferencia demostrable, la empresa podría exigir el certificado zkSNARK junto con cada respuesta y verificar, en segundos y sin acceso a los pesos del modelo, que efectivamente fue el modelo contratado el que generó ese análisis. Si el proveedor sustituyó el modelo, la verificación simplemente falla.
Ese es, en esencia, el tipo de brecha que FlashProve intenta cerrar: no mejora la calidad de las respuestas, pero permite auditar quién las produjo realmente. Sobre el costo de correr inferencia a escala ya hablamos en el ranking de APIs de inferencia más rápidas, y acá el trade-off es parecido: más seguridad, pero no gratis.
¿Qué es FlashProve y cómo funciona el zkSNARK detrás del sistema?
FlashProve es el prototipo de código abierto que Anthropic construyó para implementar inferencia demostrable usando un zkSNARK (zero-knowledge succinct argument of knowledge), un tipo de prueba criptográfica corta y rápida de verificar que no revela información secreta sobre el sistema que la genera.
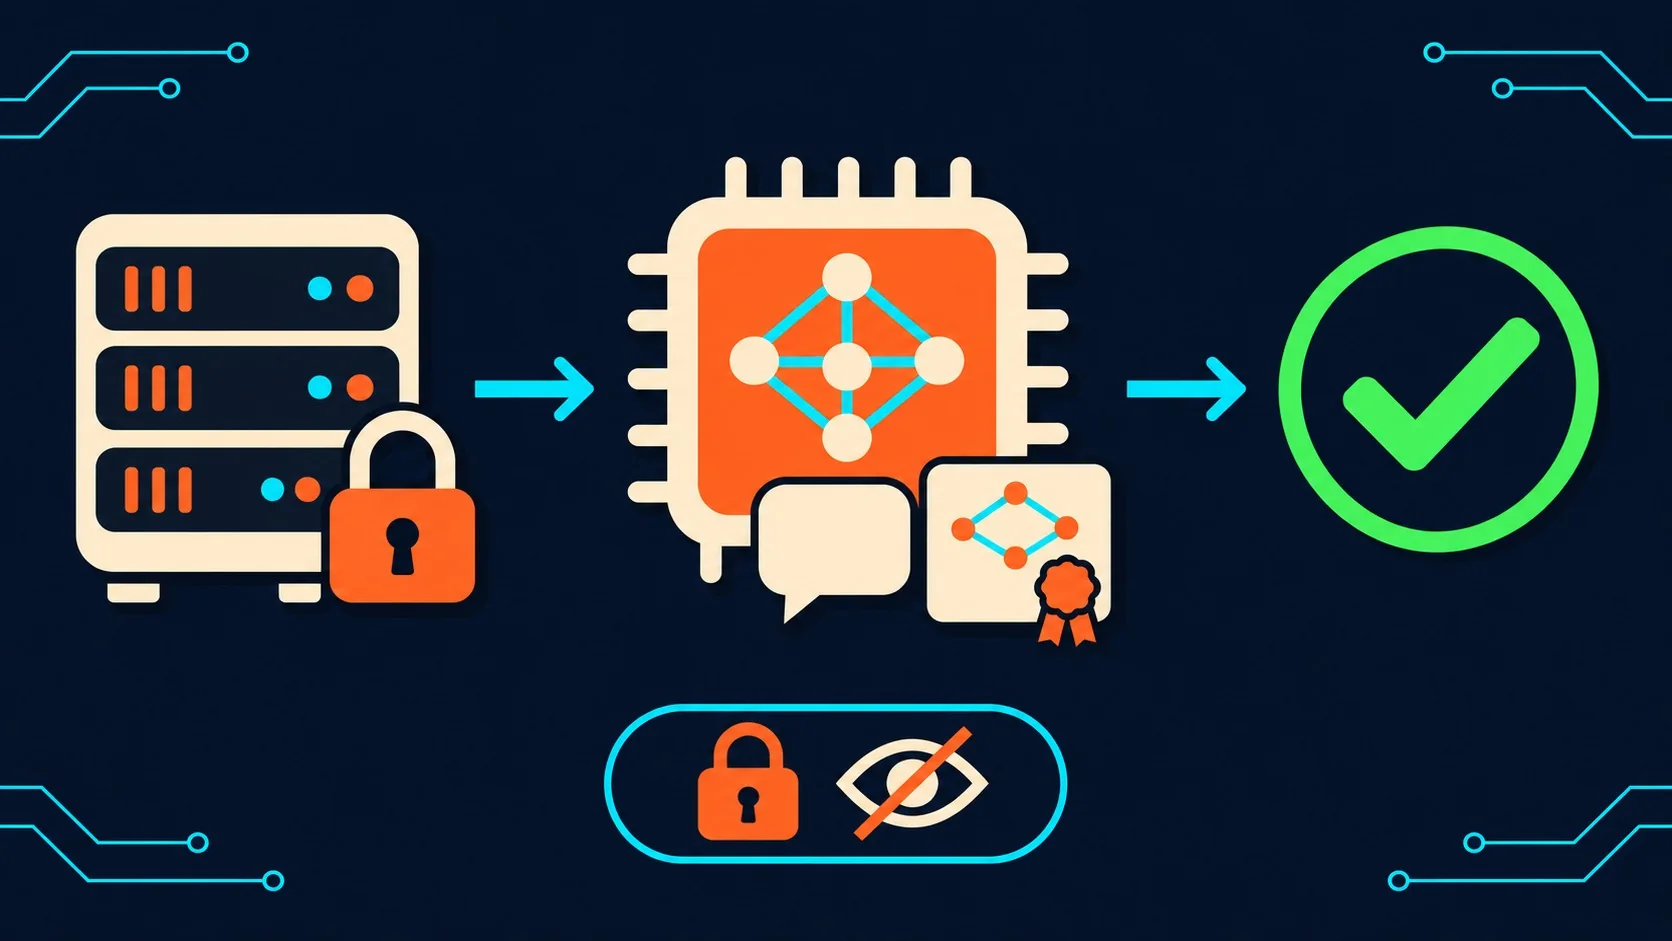
El funcionamiento tiene dos pasos. Primero, el proveedor del modelo publica una “huella” (commitment) de sus pesos, es decir, de los parámetros internos que definen cómo responde el modelo, sin exponer esos parámetros. Después, por cada respuesta que genera, adjunta una prueba matemática de que esa respuesta específica salió del modelo comprometido con esa huella.
¿Y quién puede verificar esa prueba? Cualquiera que tenga la huella, la pregunta original y la respuesta. No necesitás conocer los pesos del modelo ni tener una infraestructura de cómputo cara. Si la respuesta no vino del modelo comprometido, la verificación falla, punto.
Dicho de otra forma, y para que quede más claro: el zkSNARK funciona como un sello de lacre matemático. No podés abrir la carta para ver lo que hay adentro (los pesos quedan ocultos), pero sí podés comprobar que el sello corresponde exactamente a ese remitente y no a otro. Lo que hace atractivo a este tipo de prueba para este caso puntual es la combinación de dos propiedades: es “zero-knowledge” (no filtra nada sobre los pesos del modelo) y es “succinct” (verificarla es exponencialmente más rápido que la computación original que prueba).
¿Qué resultados de rendimiento mostró Anthropic con Llama 4 Maverick?
Con Llama 4 Maverick (400B parámetros, mixtura de expertos, cuantizado a 4 bits), una sola GPU H100 generó pruebas a aproximadamente 110 tokens por segundo, con un tamaño de prueba de ~19 MB por request de 1.024 tokens. En la llegada de Claude a nuevas regiones de AWS profundizamos sobre la logística de infraestructura detrás de este tipo de despliegues.
Esos 110 tokens/segundo representan entre 70 y 95 veces el tiempo de GPU que necesita vLLM (la biblioteca abierta más usada para correr inferencia) para procesar los mismos textos. Es un sobrecosto gigante, no hay vuelta que darle. Verificar cada prueba, en cambio, tarda 17 segundos en un procesador de 24 hilos o 21 segundos en uno solo, sin necesidad de tarjeta gráfica.
La preparación inicial del modelo (el paso de generar la huella criptográfica) tarda unos 39 minutos y sirve para unos 16 millones de solicitudes antes de tener que repetirse. Para ubicar estos números en contexto, así se comparan los sistemas que menciona el propio reporte de Anthropic:
| Sistema | Velocidad de prueba | Contexto probado | Código publicado |
|---|---|---|---|
| vLLM (sin prueba criptográfica) | Referencia base, sin overhead de zkSNARK | N/A | Sí |
| FlashProve (Anthropic) | ~110 tokens/s en H100 (70-95x vLLM) | Hasta 1.024 tokens | Sí, Apache 2.0 |
| Attestable | 53-77 tokens/s (modelo distinto) | No especificado en la fuente | No publicado |
| VerInf | 14,3 horas para 1.000 tokens (mismo modelo) | ~1.000 tokens | No especificado en la fuente |
Ordenado así se ve más claro el salto: FlashProve no es apenas “un poco más rápido” que lo anterior, es órdenes de magnitud más rápido que VerInf. Dicho eso, comparado con Attestable —que no publicó código, así que tomalo con pinzas— la diferencia de velocidad es mucho menos dramática; la ventaja ahí está más en la apertura del sistema (código, demostraciones Lean, licencia permisiva) que en una mejora bestial de performance.
¿Qué limita hoy a la inferencia demostrable y qué falta resolver?
FlashProve es un reporte de progreso intermedio, no una agenda de investigación terminada, según aclara el propio paper de Anthropic. Hay varias limitaciones que la empresa reconoce de entrada y que conviene tener presentes antes de pensar en esto como algo listo para producción.
- Contextos cortos: el sistema solo maneja hasta 1.024 tokens, muy lejos de las conversaciones reales que suelen tener miles de tokens de contexto.
- Arquitectura obligatoria: exige que el modelo sea de tipo mixtura de expertos, donde solo se activa una parte de la red por token. No sirve para cualquier arquitectura.
- Determinismo requerido: la prueba cubre una versión con aritmética de números enteros y decodificación determinista. Una respuesta generada con coma flotante o muestreo aleatorio puede no coincidir con lo que la prueba certifica.
- Arquitectura visible: el sistema oculta los pesos del modelo, pero no su arquitectura. Si alguien quiere ocultar también cómo está armado el modelo, esto no lo resuelve.
- Fuga de tiempos: Anthropic advierte que medir cuánto tarda en generarse una prueba podría filtrar información sobre los pesos, un riesgo que dejaron afuera de esta versión a propósito.
Hay un detalle interesante en cómo se construyó todo esto: según el propio reporte, Claude contribuyó a optimizar buena parte del sistema, pero el equipo reconoce que el modelo “a menudo toma decisiones difíciles de evaluar, especialmente en sistemas grandes y complejos”. Por eso escribieron demostraciones formales en Lean (un lenguaje de verificación matemática) para las garantías de seguridad claves, de forma que un humano pueda auditar los enunciados de más alto nivel sin tener que revisar cada línea de código que optimizó el modelo. Es casi un reconocimiento implícito de un problema más general: cuando dejás que una IA optimice su propia infraestructura de seguridad, necesitás otra capa (humana o formal) que controle lo que hizo.
¿Para qué casos de uso reales sirve la inferencia demostrable?
Anthropic señala cuatro aplicaciones concretas para este tipo de prueba criptográfica, todas ligadas a un mismo problema de fondo: saber con certeza qué modelo generó qué respuesta. Lo explicamos a fondo en la frontera eficiente en optimización de inferencia.
- Pacing regulatorio: algunos esquemas de regulación de IA proponen monitorear cómo se usa el hardware de cómputo, por ejemplo exigiendo que ciertos recursos se dediquen solo a inferencia y no a entrenar modelos nuevos en secreto. Con zkSNARK, un regulador puede pedir certificados que prueben que las solicitudes de un período se generaron con el modelo declarado, sin necesitar acceso a la infraestructura del proveedor.
- Detección de manipulación: si un atacante compromete un servidor de inferencia para exfiltrar pesos o entregar respuestas maliciosas, necesitaría producir pruebas válidas para el modelo esperado, algo que no podría hacer sin los pesos reales.
- Procedencia de texto: permite demostrar que un análisis específico (digamos, un escaneo de vulnerabilidades de seguridad, como en el ejemplo hipotético de más arriba) se hizo con un modelo puntual, algo que ni publicar los logs de chat garantiza, porque esos logs se podrían generar con un modelo degradado y hacerlos pasar por otra cosa.
- Auditorías independientes: evaluadores externos pueden confirmar que el modelo que están probando antes del lanzamiento es el mismo que después se sirve al público.
Vale la aclaración: estos usos son propuestas de aplicación que plantea el propio paper, no implementaciones ya funcionando en producción. Hay una brecha todavía grande entre “esto es posible técnicamente” y “esto ya lo usa un regulador real”.
¿Conviene pensar en esto hoy? Criterios para decidir
Dado el estado actual del sistema (overhead de 70-95x, tope de 1.024 tokens, solo mixtura de expertos), tiene sentido preguntarse en qué casos esto ya es relevante y en cuáles todavía no. Algunos criterios prácticos, derivados directamente de los números que publicó Anthropic:
- Si necesitás verificar en tiempo real cada respuesta de un chatbot masivo: no, todavía no. El overhead de cómputo y el límite de contexto lo hacen inviable para ese volumen.
- Si tu caso es una auditoría puntual o por lotes (por ejemplo, certificar que X análisis de seguridad se hizo con el modelo Y): el costo de 70-95x puede justificarse, porque no es algo que se repite por cada interacción de usuario, sino por evento puntual.
- Si tu modelo no es de arquitectura mixtura de expertos: FlashProve, en su forma actual, directamente no aplica.
- Si tus conversaciones superan ampliamente los 1.024 tokens: el sistema no cubre ese escenario todavía; haría falta extender el protocolo a contextos más largos, algo que el propio paper deja planteado como trabajo futuro, no resuelto.
¿Qué artefactos liberó Anthropic y bajo qué licencia?
Anthropic publicó cinco artefactos junto con el anuncio, todos bajo licencia Apache 2.0, lo que significa que cualquiera puede usar, modificar y redistribuir el código sin restricciones mayores.
- El blog post: el documento que resume el sistema y sus aplicaciones potenciales.
- Un reporte técnico completo: con los detalles de implementación del sistema.
- Una especificación de protocolo: escrita, según aclara el propio equipo, por Claude.
- Código ejecutable: incluye un “prover” (generador de pruebas) y dos verificadores, uno rápido en C++ y otro formalmente correcto escrito en Lean.
- Pruebas formales en Lean: con un visualizador interactivo de los teoremas para facilitar la auditoría de las garantías matemáticas.
El código C++ rápido no tiene garantía formal de corrección, pero coincidió con el verificador en Lean en todas las pruebas que corrió el equipo, algo que al menos da una señal de consistencia práctica.
Errores comunes al interpretar la inferencia demostrable
- Pensar que esto ya está listo para producción: es un prototipo de investigación con un límite de 1.024 tokens de contexto. Una conversación real de varios miles de tokens queda completamente afuera del alcance actual.
- Confundir “ocultar los pesos” con “ocultar todo el modelo”: FlashProve protege los parámetros internos, pero la arquitectura del modelo queda visible. Si alguien necesita confidencialidad total, esto no la da.
- Ignorar el costo computacional real: generar una prueba cuesta entre 70 y 95 veces más tiempo de GPU que correr el modelo de forma normal. Para cualquier aplicación a escala masiva, ese overhead hoy es prohibitivo.
- Asumir que esto reemplaza otros mecanismos de seguridad: el propio informe aclara que esto complementa, no sustituye, otras formas de verificar qué modelo generó una respuesta.
Preguntas Frecuentes
¿Qué es FlashProve de Anthropic?
FlashProve es un sistema de código abierto que Anthropic publicó el 2 de noviembre de 2026 para implementar inferencia demostrable usando pruebas criptográficas zkSNARK. Permite a un proveedor de IA probar que una respuesta específica salió del modelo que declara, sin revelar los pesos internos de ese modelo. Esto se conecta con lo que analizamos en correr modelos de 70B en hardware de consumo.
¿Cómo se puede probar que una respuesta de IA vino de un modelo específico?
El proveedor publica primero una huella criptográfica de los pesos del modelo y después adjunta, junto a cada respuesta, una prueba matemática corta de que esa respuesta salió del modelo comprometido con esa huella. Cualquiera con la huella, la pregunta y la respuesta puede verificar la prueba sin conocer los pesos reales.
¿Qué es un zkSNARK y para qué sirve en IA?
Un zkSNARK (zero-knowledge succinct argument of knowledge) es una prueba criptográfica corta que convence a un verificador de que una computación se ejecutó correctamente, sin revelar información sobre esa computación más allá de su corrección. En IA, sirve para probar qué modelo generó una respuesta sin exponer sus pesos internos.
¿Por qué Anthropic lanzó un sistema de inferencia demostrable?
Anthropic lo desarrolló para cumplir un objetivo público de su Frontier Safety Roadmap, que exigía un prototipo de inferencia demostrable para septiembre de 2026. Según el paper, la motivación incluye detectar servidores comprometidos, dar garantías a clientes de servicios de terceros y aportar herramientas de auditoría a reguladores.
¿Cuánto tarda en generarse una prueba criptográfica de inferencia?
Con una GPU H100 y el modelo Llama 4 Maverick cuantizado a 4 bits, FlashProve genera pruebas a aproximadamente 110 tokens por segundo, lo que equivale a entre 70 y 95 veces el tiempo de GPU que usa vLLM para la misma tarea. Verificar esa prueba después toma entre 17 y 21 segundos sin necesidad de GPU.
Conclusión
Lo que Anthropic mostró con FlashProve es que la inferencia demostrable dejó de ser pura teoría criptográfica y pasó a tener un prototipo funcional, medible y con código abierto. Eso sí: el salto de “funciona con 110 tokens/segundo en un benchmark controlado de 1.024 tokens” a “esto corre en producción con conversaciones reales” todavía es grande, y el propio equipo lo reconoce al llamarlo progreso intermedio.
Para quien evalúa si esto le sirve hoy, el criterio práctico sigue siendo el mismo que repasamos más arriba: fijate si tu caso de uso necesita contextos cortos, modelos de mixtura de expertos y tolerancia a un sobrecosto de cómputo de entre 70 y 95 veces. Si tu escenario es auditoría puntual o verificación de cumplimiento regulatorio en lotes acotados, el costo puede justificarse. Si pensás en verificar cada respuesta de un chatbot masivo en tiempo real, con el estado actual del sistema, no da los números.
El hecho de que todo el código, las demostraciones en Lean y el reporte técnico estén bajo licencia Apache 2.0 abre la puerta a que otros equipos (académicos, empresas de seguridad, incluso otros laboratorios) tomen esta base y la optimicen. Habrá que ver quién la lleva a producción primero, y si para entonces el límite de 1.024 tokens sigue siendo el techo o alguien encuentra la forma de estirarlo.