
Un desarrollador publicó el 13 de septiembre de 2026 sus notas sobre migrar preprompts de 35kb desde Claude Opus hacia un modelo self-hosted corriendo en Ollama. El hallazgo central: ese tamaño de prompt consume el 14% de una ventana de contexto de 65k tokens antes de que el agente escriba una sola línea, y el sistema empieza a repetir llamadas a herramientas en menos de tres minutos. Vale la pena leerlo con un poco de distancia: son las notas de una sola persona, en una sola máquina, no un paper revisado por pares.
En este artículo:
- En 30 segundos
- ¿Por qué migrar prompts a Ollama en vez de quedarte con Claude Opus?
- ¿Qué pasó al correr un preprompt de 35kb en Ollama?
- ¿Cuáles son las señales de que el modelo se quedó sin contexto?
- ¿Qué cambios de diseño de prompt funcionan en modelos self-hosted?
- ¿Qué se pierde al dejar de depender de los context windows grandes de los frontier providers?
- ¿Te conviene migrar? Tres criterios antes de lanzarte
- Qué está confirmado y qué no
- Errores comunes al migrar prompts de Claude Opus a Ollama
- Preguntas Frecuentes
- Conclusión
- Fuentes
En 30 segundos
- Un prompt de 35kb consume el 14% de una ventana de contexto de 65k tokens en el hardware usado por el autor (AMD Ryzen AI MAX+ 395, 128GB de RAM, 32GB reservados al sistema operativo)
- El agente entra en “thrashing” (relee archivos ya procesados, repite tool calls) en menos de tres minutos según las notas publicadas
- La solución que propone el autor es dividir los preprompts en unidades de un solo objetivo, lo que llama SOP o Single Objective Prompting
- opencode exige declarar agentes en la carpeta
~/.config/opencode/agentsen vez de tirar todo el contexto en un preprompt monolítico - El caso se conoce en medio de la disputa entre OpenAI y el matemático Tristan Buckmaster por la solución al problema de Navier-Stokes, que el autor usa como argumento de desconfianza hacia los frontier providers
Migrar prompts a Ollama es el proceso de adaptar instrucciones extensas para agentes de IA, escritas originalmente para modelos frontier como Claude Opus o GPT, para que corran en un modelo de pesos abiertos alojado en hardware propio. La motivación suele ser privacidad: evitar que las sesiones de trabajo pasen por la infraestructura de OpenAI o Anthropic. El costo es rediseñar el prompt entero por ventanas de contexto mucho más chicas, y ese costo es el que muchas guías sobre “IA local” prefieren no mencionar hasta que ya invertiste el fin de semana.
¿Por qué migrar prompts a Ollama en vez de quedarte con Claude Opus?
La razón principal que da el autor de las notas es proteger la metadata de sus sesiones, no solo sus datos. Sostiene que las intuiciones que aplica para resolver problemas difíciles con un agente son, en sí mismas, información valiosa que no quiere ver en manos de un proveedor externo. Es una idea incómoda pero no descabellada: si tu forma de armar prompts es buena, esa forma también es propiedad intelectual, aunque nunca hayas pensado en ella así.
El disparador puntual fue la disputa que estalló a comienzos de septiembre entre OpenAI y el matemático Tristan Buckmaster. Según la cobertura de The Verge publicada el 8 de septiembre de 2026, OpenAI anunció que había resuelto el problema de Navier-Stokes, uno de los siete Problemas del Milenio con premio de un millón de dólares, usando un modelo interno más potente que GPT-6 Astra corriendo 10.000 agentes en paralelo. La empresa empezó a entrenar ese modelo el 28 de agosto.
Un día antes del anuncio, Buckmaster, de la NYU, había publicado hallazgos sobre un problema relacionado junto con Levent Alpöge, investigador de Anthropic. Buckmaster afirma que había estado volcando todos sus borradores en sesiones de Codex durante todo el proyecto y le preguntó directamente a OpenAI si el modelo había tenido acceso a esas sesiones. Le dijeron que no se habían consultado datos de usuario para resolver el problema, pero cuando repreguntó si el modelo se había entrenado con esos datos, no obtuvo respuesta.
OpenAI salió a aclarar la situación con una frase que quedó pegada al caso: “si bien es poco probable, no podemos descartar que datos desidentificados derivados del uso de nuestros productos hayan ayudado a mejorar nuestros modelos”. Sébastien Bubeck, del equipo técnico de OpenAI, agregó que no vieron el trabajo de Buckmaster y Alpöge hasta que se publicó, y que las pruebas difieren en los resultados exactos. Buckmaster respondió en Mastodon que la propia OpenAI estaba “admitiendo abiertamente que usaron datos de entrenamiento de un período posterior a que encontráramos nuestro resultado”. Notá algo: ninguna de las dos partes dijo algo verificable en un sentido u otro. “No podemos descartarlo” no es una confesión, es una empresa cubriéndose legalmente. Pero tampoco es una negación, y ese vacío es exactamente lo que el autor de las notas usa como justificación para irse a hardware propio. Te puede servir nuestra cobertura de montar tu propio entorno de IA local.
¿Qué pasó al correr un preprompt de 35kb en Ollama?
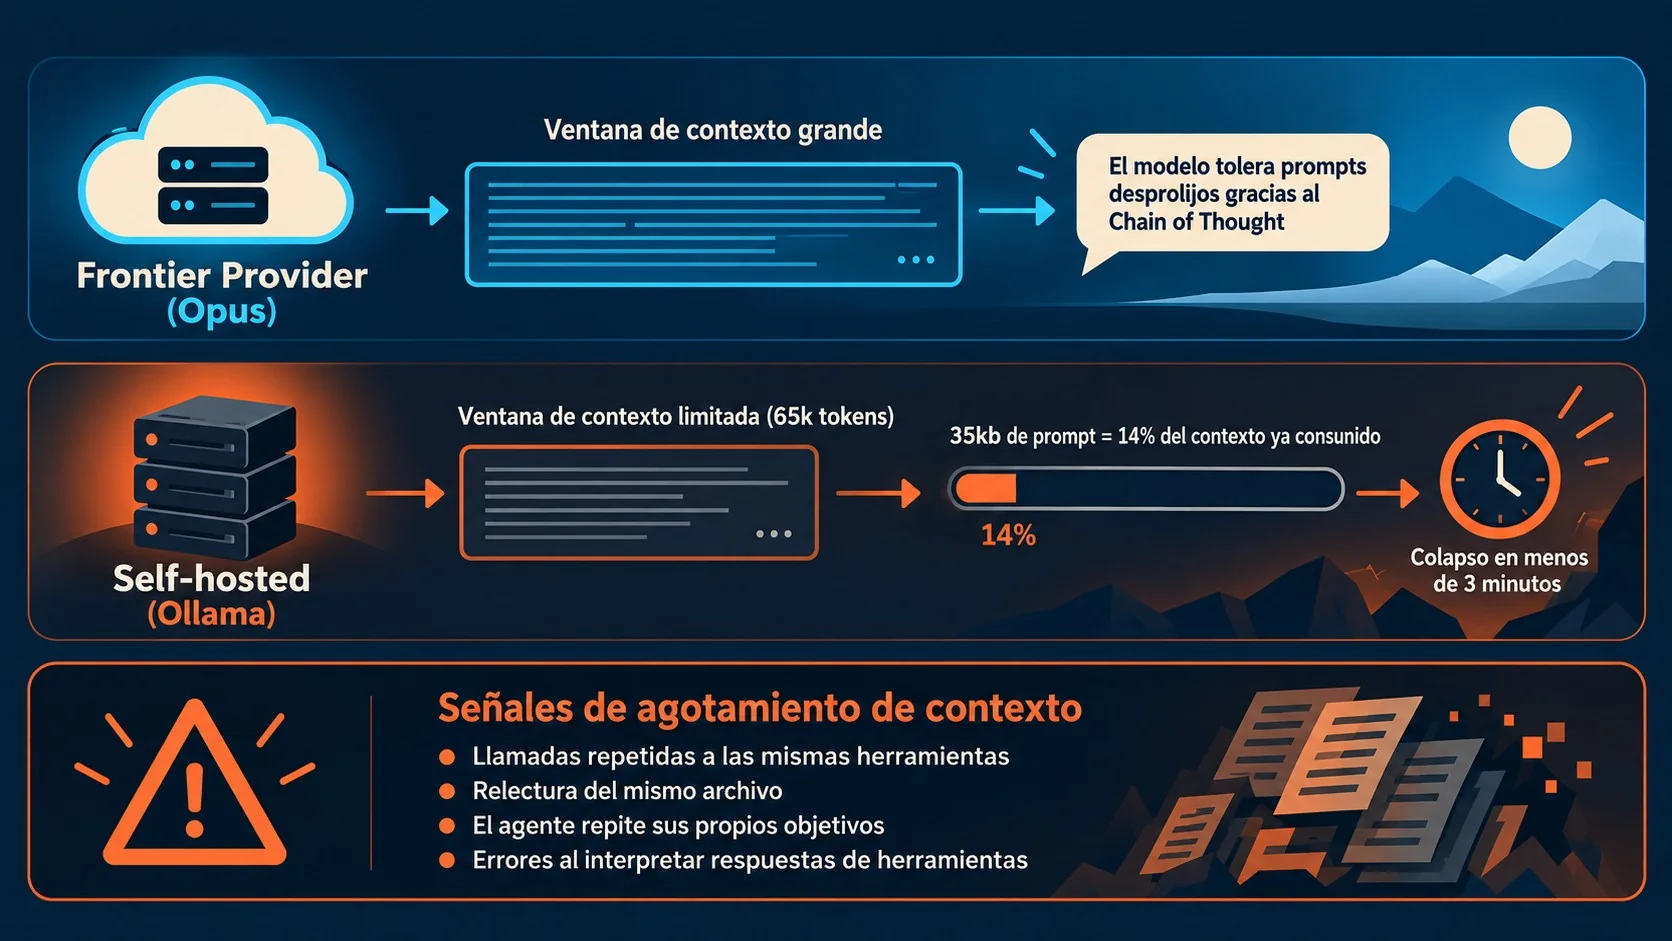
Se rompió. En el hardware del autor, un AMD Ryzen AI MAX+ 395 con 128GB de RAM total (32GB para el sistema operativo y el resto para inferencia), la ventana de contexto máxima del modelo self-hosted quedó en 65.000 tokens. Un preprompt de 35kb consume el 14% de esa ventana apenas arranca la sesión, antes de sumar el historial de la conversación.
¿Y qué hizo el agente con ese margen tan angosto? Empezó a dudar de sus propias instrucciones con llamadas a herramientas innecesarias, releer archivos que ya había leído y reescribir trabajo que ya estaba terminado. El autor compara la situación con tener que briefear a alguien que se reinicia cada noventa segundos: el agente ejecuta la última instrucción sin memoria de las quince anteriores. Todo esto pasó en menos de tres minutos de uso continuo.
El problema no es el modelo en sí, según las notas. Es que los sistemas self-hosted, con contextos mucho más chicos que los de los frontier providers, no toleran preprompts pensados para ventanas de cientos de miles de tokens. Tiene sentido si lo pensás como un problema de proporción, no de calidad: un modelo de 27B parámetros con 65k tokens de contexto no es “peor” que Opus, está resolviendo un problema distinto con una fracción de la memoria de trabajo.
Ejemplo hipotético: cómo se vería aplicar SOP en la práctica
Este ejemplo es ilustrativo, no forma parte de las notas originales del autor. Imaginemos un preprompt típico de 40kb que combina tres tareas en un solo agente: revisar código en busca de vulnerabilidades, escribir tests de regresión y actualizar la documentación técnica. En un frontier provider con ventana de 200k tokens, ese combo funciona sin fricción porque sobra espacio para que el modelo mantenga las tres tareas en mente a la vez.
Aplicado a un modelo self-hosted con 65k tokens de contexto, siguiendo la lógica de SOP que describe el autor, ese mismo trabajo se partiría en tres agentes declarados por separado en ~/.config/opencode/agents: uno para auditoría de seguridad, otro para generación de tests, otro para documentación. Cada uno arranca su propia sesión, lee solo los archivos que necesita para su objetivo puntual, y no carga en memoria las instrucciones de las otras dos tareas. El costo es obvio: perdés la coherencia de que un solo agente vea el problema completo. La ganancia, según la lógica del autor, es que cada sesión individual tiene margen de sobra dentro de los 65k tokens y no entra en thrashing.
Si tu preprompt actual mezcla más de un objetivo en un solo bloque de instrucciones, ese es el primer lugar por donde cortar antes de migrar, no después de que falle.
¿Cuáles son las señales de que el modelo se quedó sin contexto?
Hay cinco señales concretas que el autor recomienda monitorear en los logs para detectar cuándo un agente self-hosted se quedó sin contexto útil. Las llama “failure signals” y todas apuntan a lo mismo: el agente perdió la noción de qué ya hizo. Esto se conecta con lo que analizamos en correr un agente local sin depender de la nube.
- Llamadas a herramientas idénticas consecutivas. El agente ejecuta el mismo tool call dos o más veces seguidas sin que haya cambiado nada en el estado.
- Lecturas repetidas del mismo archivo. Vuelve a abrir un archivo que ya procesó en el mismo turno o en el anterior.
- El agente repite sus propios objetivos. Reformula la tarea que ya tenía clara, como si la estuviera descubriendo de nuevo.
- Fallos de parseo en las respuestas de tool calls. El autor lo compara con un caño roto en medio de una cena: mete tanta data cruda en el contexto que arruina la sesión entera.
- Muchos turnos con pocos cambios reales de archivos. El conteo de idas y vueltas sube sin que el trabajo avance.
Si ves dos o tres de estas señales juntas, no es un modelo “tonto”. Es un contexto saturado, y la solución no es cambiar de modelo, es cambiar de prompt.
¿Qué cambios de diseño de prompt funcionan en modelos self-hosted?
El ajuste principal que propone el autor es lo que llama SOP, Single Objective Prompting: partir un preprompt gigante en unidades chicas, cada una con un solo objetivo y su resolución, en vez de un documento único que intenta cubrir quince escenarios a la vez.
Ojo con esto: si venías usando Claude Code y le pasabas archivos sueltos como preprompt improvisado, esa costumbre no sobrevive la migración. opencode necesita agentes declarados de forma explícita, guardados en ~/.config/opencode/agents, y hay que familiarizarse con su sistema de permisos antes de tirar nada a producción.
Otros ajustes concretos que menciona el autor:
- Ajustar manualmente el context length en Ollama. Los valores por defecto vienen extremadamente chicos y hay que subirlos a mano.
- Loguear el estado de la sesión a disco. Así el agente puede hacer handoffs más frecuentes y releer solo la porción que necesita, no todo el historial.
- Reducir la cantidad de tool calls por paso agéntico. Cada llamada de más es contexto que se pierde.
- Cambiar negaciones por directivas positivas. En vez de “no hagas X”, escribir “solo hacé Y”. El modelo chico procesa mejor una instrucción directa que una prohibición.
Nada de esto es magia. Subís el prompt, lo probás, se rompe, lo partís en pedazos más chicos, ajustás el context length, volvés a probar, y recién ahí empieza a comportarse como el agente que tenías en Claude Opus, aunque nunca del todo igual. Y ahí está el punto que las notas originales minimizan un poco: este proceso tiene un costo de tiempo real, de prueba y error, que no es gratis aunque el hardware ya lo tengas pago. Sobre eso hablamos en bajar drásticamente los costos de API.
¿Qué se pierde al dejar de depender de los context windows grandes de los frontier providers?
Se pierde margen para el Chain of Thought, que es lo que compensa un prompt mal escrito. El autor plantea que gran parte de lo que la gente atribuye a “el modelo mejoró” en realidad es la ventana de contexto gigante haciendo el trabajo pesado: le da al modelo lugar para razonar, explorar alternativas y corregirse antes de responder, aunque el usuario nunca vea ese proceso completo porque Anthropic y OpenAI solo entregan resúmenes del razonamiento interno.
¿Y qué se gana a cambio? Lo que el autor llama TCO, Total Custody of Output: control total sobre dónde vive la sesión y quién puede leerla. Es la contracara directa del caso Navier-Stokes: con hardware propio, no hay forma de que un tercero entrene sobre tus transcripts porque nunca salen de tu máquina. Dicho eso, vale la pregunta incómoda que el texto original no se hace: ¿cuánta gente necesita realmente ese nivel de custodia? Si tu trabajo no es un problema matemático de un millón de dólares ni información que alguien pagaría por robar, el cálculo cambia bastante.
Si vas a armar esta infraestructura vos mismo, la lógica es la misma que para cualquier otro servicio autohospedado: necesitás hardware dedicado o, como mínimo, un servidor donde controlás quién accede a los datos, algo que en donweb.com se resuelve con VPS pensados para cargas de este tipo.
¿Te conviene migrar? Tres criterios antes de lanzarte
Antes de pasar el fin de semana reescribiendo preprompts, conviene hacerse tres preguntas concretas. No son parte de las notas originales del autor, es una forma de ordenar la decisión con lo que sí sabemos por las fuentes disponibles:
- ¿Qué tan sensible es lo que estás procesando? Si trabajás con información que le importaría a un competidor, un cliente con cláusula de confidencialidad, o un hallazgo que todavía no publicaste, el riesgo que describe el caso Navier-Stokes es relevante para vos. Si tu uso diario es debugging rutinario, el riesgo teórico probablemente no justifica el costo de reingeniería.
- ¿Tenés margen para rediseñar el prompt, no solo para correrlo? Migrar no es cambiar una URL de API. Según las notas del autor, implica partir preprompts en unidades de un solo objetivo, declarar agentes formalmente y ajustar el context length a mano. Si no tenés tiempo para ese trabajo de fondo, vas a terminar con un agente que thrashea y una sensación de que “el modelo local es malo” cuando el problema es el diseño del prompt.
- ¿El hardware que tenés soporta el contexto que necesitás? El caso documentado usa una máquina con 128GB de RAM y aun así el límite práctico quedó en 65k tokens. Si tu setup es más modesto, la ventana va a ser todavía más chica, y el punto de quiebre para prompts largos llega antes.
Si las tres respuestas apuntan hacia “sí, me importa, tengo tiempo, tengo el hardware”, migrar tiene sentido. Si alguna falla, probablemente te convenga seguir en un frontier provider y aceptar el riesgo que describe el caso Buckmaster, que sigue siendo una disputa sin resolución clara.
Qué está confirmado y qué no
Está confirmado, porque figura en las notas publicadas por el autor, que un preprompt de 35kb consume el 14% de una ventana de 65k tokens en su hardware específico y que el thrashing apareció en menos de tres minutos. También está confirmado, según The Verge, que OpenAI anunció la solución a Navier-Stokes el 8 de septiembre de 2026 y que reconoció no poder descartar el uso de datos desidentificados de usuarios en el entrenamiento del modelo.
No está confirmado si estos resultados se replican en otro hardware, con otro modelo abliterated de 27B parámetros, o con otra versión de Ollama. Tampoco hay una medición independiente de cuánto mejora el rendimiento aplicando el SOP que propone el autor: son sus notas de un primer pase de experimentos, no un benchmark controlado. Y sobre el caso Navier-Stokes, tampoco hay una resolución: OpenAI dice que no accedió a datos específicos de usuario, Buckmaster sostiene que la propia respuesta de OpenAI es sospechosa, y ninguna de las dos partes aportó evidencia técnica verificable en público. Conviene leer todo el episodio como una disputa abierta, no como un caso cerrado de robo de propiedad intelectual.
Errores comunes al migrar prompts de Claude Opus a Ollama
- Copiar y pegar el preprompt sin tocarlo. Un documento pensado para un contexto de cientos de miles de tokens no entra sano en una ventana de 65k. Hay que partirlo antes de probarlo, no después de que falle.
- Dejar el context length de Ollama en el valor por defecto. Viene chico a propósito y hay que subirlo a mano antes de correr cualquier agente serio.
- No monitorear las señales de saturación de contexto. Si no revisás los logs buscando tool calls repetidos o lecturas duplicadas de archivos, te enterás del problema cuando ya perdiste media hora de trabajo del agente.
- Asumir que un modelo abliterated de 27B rinde igual que Opus. Sirve para evitar rechazos de seguridad en tareas legítimas de cybersecurity, pero el tamaño del modelo y del contexto son otra liga.
Preguntas Frecuentes
¿Por qué un prompt que funciona en Claude falla en Ollama?
Falla porque la ventana de contexto de un modelo self-hosted suele ser mucho más chica que la de los frontier providers. En el caso documentado, un prompt de 35kb consumía el 14% de una ventana de 65k tokens antes de procesar nada, y eso hacía que el agente perdiera de vista instrucciones anteriores. Lo explicamos a fondo en rutear prompts sin depender de otro modelo.
¿Cómo configurar el context window en Ollama?
El context length de Ollama hay que ajustarlo manualmente, porque el valor por defecto viene muy por debajo de lo necesario para agentes con preprompts extensos. Según las notas del autor, no tocar este parámetro es una de las causas principales de thrashing en sesiones largas.
¿Qué es un modelo abliterated y para qué sirve?
Un modelo abliterated es una versión de un modelo open weight a la que se le removieron los filtros de rechazo por defecto, lo que evita que se niegue a responder consultas legítimas de cybersecurity o pentesting. El autor de las notas lo usa específicamente para evitar los rechazos de seguridad que dice encontrar en Claude Opus y GPT.
¿Cómo evitar que un agente self-hosted repita llamadas a herramientas?
Reduciendo la cantidad de tool calls por paso agéntico y reemplazando instrucciones negativas por directivas positivas, según recomienda el autor de las notas. También ayuda loguear el estado de la sesión a disco para que el agente relea solo la porción de contexto que necesita, en vez de todo el historial acumulado.
¿Vale la pena migrar de Claude u OpenAI a un LLM autohospedado por privacidad?
Depende de qué tan sensible sea tu trabajo y cuánto estés dispuesto a rediseñar tus prompts. El caso de Navier-Stokes, donde OpenAI admitió que no puede descartar el uso de datos desidentificados de usuarios en el entrenamiento de sus modelos, es el argumento de fondo que usa el autor para justificar el esfuerzo de migrar, aunque implique perder potencia y ventana de contexto. Si tu trabajo no maneja información que le interese a un tercero, probablemente el costo de migrar supere el beneficio.
Conclusión
Migrar prompts a Ollama no es un cambio de proveedor, es rediseñar cómo pensás un agente. Los datos del autor son puntuales, de un solo experimento en un hardware específico, pero el patrón que describe (preprompts gordos que saturan contextos chicos y generan thrashing en minutos) es lo que cualquiera que intente este camino se va a topar tarde o temprano.
Si tu prioridad es privacidad y estás dispuesto a partir tus preprompts en unidades de un solo objetivo, ajustar el context length a mano y loguear el estado de sesión a disco, el camino existe y está documentado. Si lo que necesitás es la potencia bruta y la ventana de contexto gigante de un frontier provider, la disputa entre OpenAI y Buckmaster por Navier-Stokes es el recordatorio de qué estás poniendo en juego a cambio, aunque conviene no perder de vista que esa disputa todavía no tiene un veredicto claro para ningún lado.